Python 实战 | 巨潮资讯网公告批量采集工具(GUI 界面 + 多线程下载 + 日历选日期)
本文记录从零开发一个上市公司公告批量采集桌面工具的完整过程:接口分析、爬虫核心、多线程并发下载、tkinter 参数界面(含自研日历控件)、断点续传。文末附完整源码。
一、写在前面获取方式:https://pay.ldxp.cn/item/d57lru
做投资研究、财报分析时,经常需要批量下载上市公司的年报、季报、业绩预告等公告 PDF。巨潮资讯网(cninfo.com.cn)是证监会指定的法定信息披露平台,沪、深、北交易所的公告都能在这里查到。
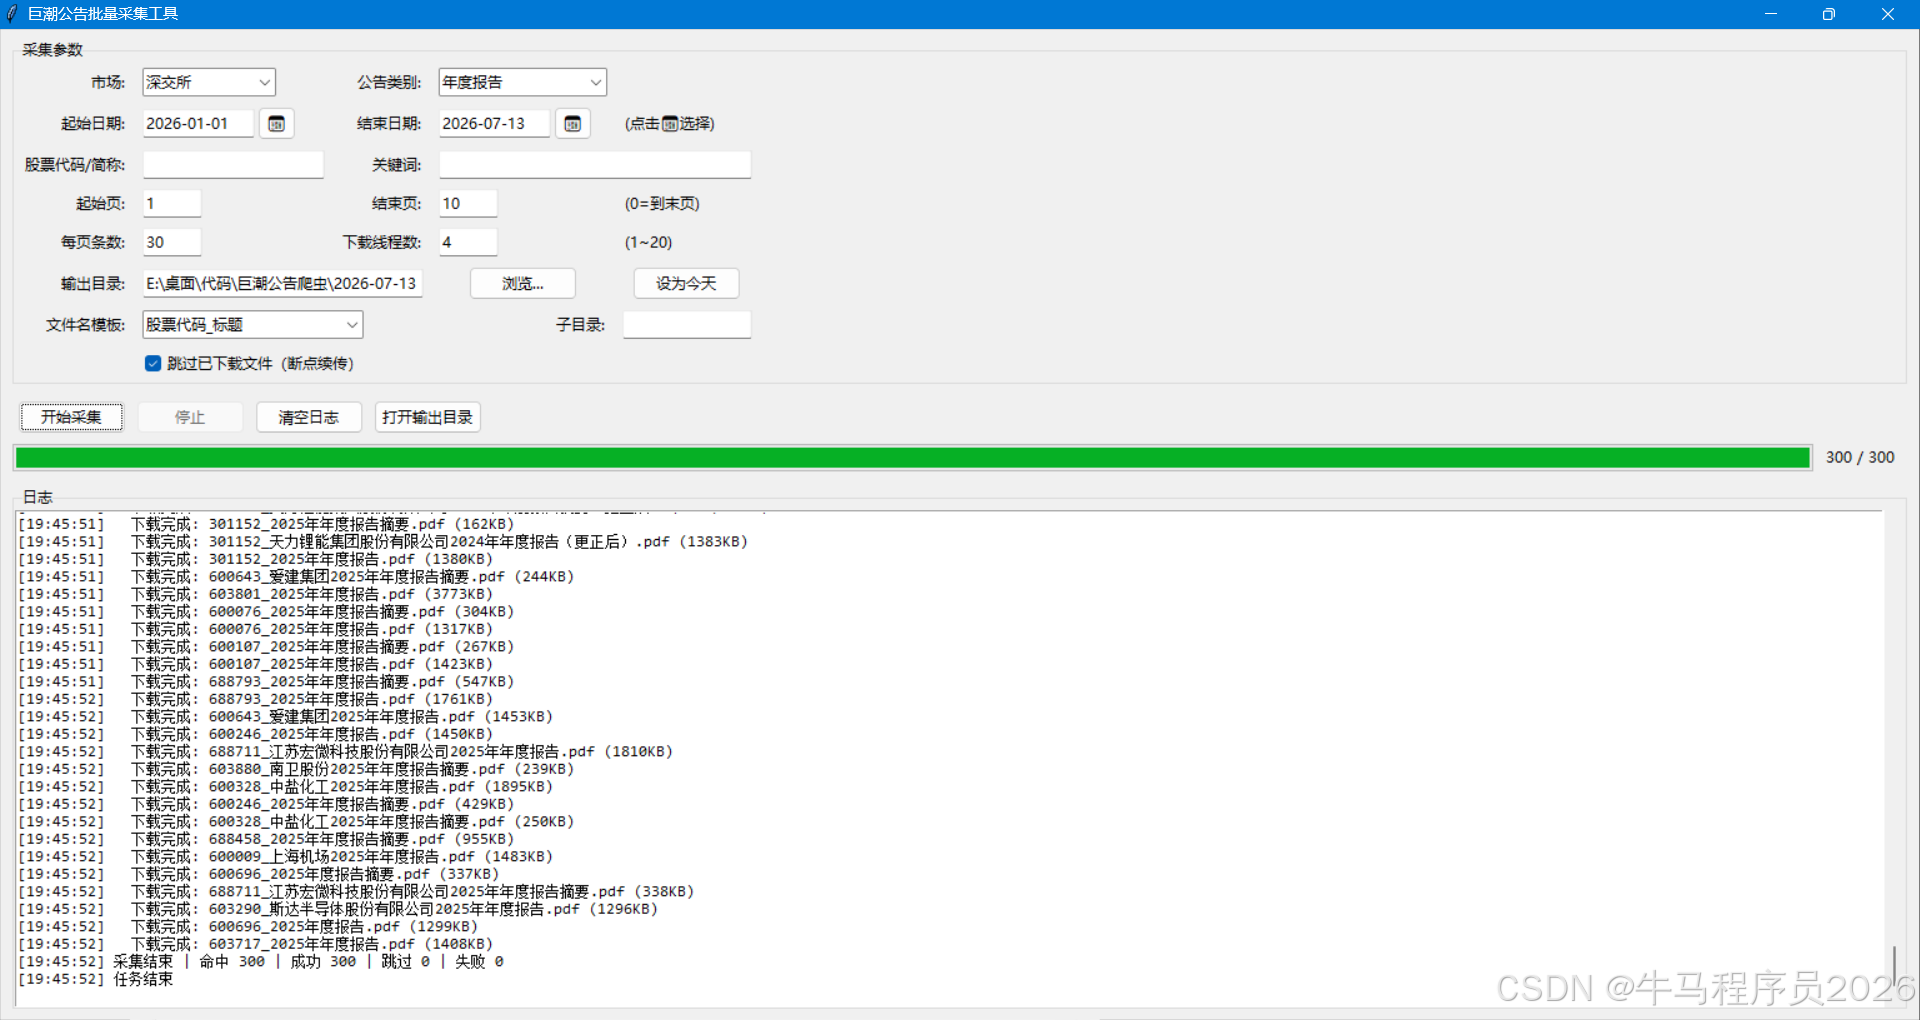
手动一篇篇下载太低效,于是我写了个带图形界面的批量采集工具,主要能力:
- ✅ 按市场(深交所/上交所/北交所)、公告类别、日期范围、股票、关键词检索
- ✅ 自动翻页,支持指定页码范围
- ✅ 多线程并发下载,4 线程实测 6 个 PDF 仅 0.5 秒
- ✅ 日历控件选择日期,告别手敲 YYYY-MM-DD
- ✅ 断点续传(跳过已下载文件)
- ✅ 进度条 + 实时日志
- ✅ 默认按当天日期建目录存放
- ✅ 参数自动保存,下次打开即用
- ✅ 同时支持 GUI 和命令行两种运行方式
先看最终效果(参数界面):
二、接口分析
2.1 公告查询接口
打开巨潮资讯网的公告检索页,F12 抓包能看到,列表数据来自一个 POST 接口:
POST http://www.cninfo.com.cn/new/hisAnnouncement/query
Content-Type: application/x-www-form-urlencoded
关键请求参数(form data):
| pageNum | 页码 | 1 |
| pageSize | 每页条数 | 30 |
| column | 市场 | szse / sse / bse |
| tabName | 固定 | fulltext |
| category | 公告类别 | category_ndbg_szsh(年报) |
| stock | 股票 | 600438,gssh0600438 |
| searchkey | 关键词 | 增发 |
| seDate | 日期范围 | 2026-01-01~2026-07-13 |
| isHLtitle | 高亮 | true |
返回的 JSON 结构:
{
"totalRecordNum": 44,
"announcements": [
{
"secCode": "600438",
"secName": "通威股份",
"announcementId": "1225372847",
"announcementTitle": "通威股份2025年年度报告",
"shortTitle": "通威股份2025年年度报告",
"announcementTime": 1781625600000,
"adjunctUrl": "finalpage/2026-06-17/1225372847.PDF",
"adjunctType": "PDF"
}
]
}
几个要点:
- announcementTime 是毫秒级时间戳
- adjunctUrl 是 PDF 的相对路径,拼上 http://static.cninfo.com.cn/ 就是下载地址
- totalRecordNum 用于计算总页数
2.2 必备的请求头
巨潮对请求头有一定校验,缺 Referer、User-Agent 或 X-Requested-With 可能拿不到数据。完整的请求头:
DEFAULT_HEADERS = {
"Accept": "*/*",
"Content-Type": "application/x-www-form-urlencoded; charset=UTF-8",
"Origin": "http://www.cninfo.com.cn",
"Referer": "http://www.cninfo.com.cn/new/commonUrl/pageOfSearch?url=disclosure/list/search",
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) …",
"X-Requested-With": "XMLHttpRequest",
}
2.3 股票代码 → orgId 解析
stock 参数需要 代码,orgId 格式(如 600438,gssh0600438),但用户通常只记得代码或简称。所以额外调一个站内搜索接口自动解析:
POST http://www.cninfo.com.cn/new/information/topSearch/query
keyWord=通威 maxNum=10
返回的 stockList[0] 里就有 code 和 orgId,用户输入「通威」或「600438」都能自动转换。
三、爬虫核心设计
把整个爬虫封装成 CninfoCrawler 类,职责清晰:查询、下载、线程控制分离。
3.1 参数集合 CrawlParams
用一个数据类集中管理所有采集参数,避免函数签名一长串:
class CrawlParams:
def __init__(self, **kw):
self.column = kw.get("column", "szse") # 市场
self.category = kw.get("category", "") # 公告类别
self.stock = kw.get("stock", "") # "code,orgId"
self.searchkey = kw.get("searchkey", "") # 关键词
self.se_date = kw.get("se_date", "") # "起~止"
self.page_start = int(kw.get("page_start", 1))
self.page_end = int(kw.get("page_end", 0)) # 0=到末页
self.page_size = int(kw.get("page_size", 30))
self.output_dir = kw.get("output_dir", ".")
self.name_template = kw.get("name_template", "{secCode}_{title}")
self.skip_existing = kw.get("skip_existing", True)
self.threads = max(1, int(kw.get("threads", 4))) # 并发数
3.2 单页查询(带重试)
网络请求难免失败,加了 3 次指数退避重试:
def query_page(self, params, page_num):
post_data = {
"pageNum": str(page_num),
"pageSize": str(params.page_size),
"column": params.column,
"tabName": "fulltext",
"category": params.category,
"stock": params.stock,
"searchkey": params.searchkey,
"seDate": params.se_date,
"isHLtitle": "true",
}
for attempt in range(1, self.max_retry + 1):
if self.stop_event.is_set(): # 支持随时停止
return [], 0
try:
resp = self.session.post(QUERY_URL, data=post_data, timeout=self.timeout)
resp.raise_for_status()
payload = resp.json()
return payload.get("announcements") or [], int(payload.get("totalRecordNum") or 0)
except Exception as e:
time.sleep(1.5 * attempt) # 退避
raise RuntimeError(f"查询第 {page_num} 页失败")
3.3 单文件下载(流式 + 原子写入)
PDF 可能几十 MB,用流式下载避免内存暴涨。关键是先写临时文件,成功后原子替换,防止中断产生半截文件:
def download_pdf(self, url, save_path):
for attempt in range(1, self.max_retry + 1):
if self.stop_event.is_set():
return False
try:
resp = self.session.get(url, timeout=self.timeout, stream=True)
if resp.status_code != 200:
time.sleep(1.5 * attempt)
continue
tmp_path = save_path + ".part"
with open(tmp_path, "wb") as f:
for chunk in resp.iter_content(chunk_size=65536):
if self.stop_event.is_set(): # 下载中也能停
os.remove(tmp_path)
return False
if chunk:
f.write(chunk)
os.replace(tmp_path, save_path) # 原子替换
return True
except Exception:
time.sleep(1.5 * attempt)
return False
四、多线程并发下载(重点)
这是性能的关键优化。原版串行下载 6 个 PDF 要 2~3 秒,改成 4 线程并发后只要 0.5 秒。
4.1 两阶段架构
下载前必须先知道有哪些任务,所以拆成两阶段:
阶段一(查询):逐页调接口 → 收集所有待下载任务到列表
阶段二(下载):ThreadPoolExecutor 并发执行所有任务
这样进度条的分母才准确(知道总数才能算百分比),也方便统一调度。
def crawl(self, params, on_log=None, on_progress=None):
# ———- 阶段一:逐页查询,收集任务 ———-
tasks = []
page = page_start
while not self.stop_event.is_set() and (page_end is None or page <= page_end):
anns = self.query_page(params, page)[0]
if not anns:
break
for ann in anns:
# … 计算 save_path,判断是否跳过 …
tasks.append({
"down_url": PDF_BASE + ann["adjunctUrl"],
"save_path": save_path,
"title": title,
})
page += 1
# ———- 阶段二:多线程并发下载 ———-
stat = {"total": len(tasks), "downloaded": 0, "skipped": 0, "failed": 0}
done_lock = threading.Lock()
done = 0
def _do_download(task):
nonlocal done
if self.stop_event.is_set():
return
ok = self.download_pdf(task["down_url"], task["save_path"])
with done_lock: # 线程安全更新
done += 1
if ok:
stat["downloaded"] += 1
else:
stat["failed"] += 1
if on_progress:
on_progress(done, len(tasks), task["title"])
with ThreadPoolExecutor(max_workers=params.threads) as pool:
for task in tasks:
pool.submit(_do_download, task)
# with 块结束自动等待所有任务完成
4.2 线程安全要点
多线程下,stat 字典和 done 计数器是共享资源,必须加锁:
done_lock = threading.Lock()
with done_lock:
done += 1
stat["downloaded"] += 1
不加锁的话,多个线程同时 done += 1 会丢失更新(读-改-写不是原子的),进度条会卡住或回退。
4.3 并发数选择
- 不是越多越好:太多线程会被服务器限流,反而触发重试
- 经验值 4~8 个比较稳,工具里默认 4,可在界面调到 1~20
- ThreadPoolExecutor 是线程池(非进程池),适合这种 I/O 密集型任务(下载主要是等网络)
五、tkinter 图形界面
5.1 整体布局
用 ttk.LabelFrame 做参数表单,grid 布局对齐标签和控件,下方放操作按钮、进度条、日志区:
class CrawlerApp(tk.Tk):
def __init__(self):
super().__init__()
self.title("巨潮公告批量采集工具")
self.geometry("760×780")
# 参数表单 / 操作按钮 / 进度条 / 日志区
5.2 自研日历控件(无第三方依赖)
tkinter 没有内置日期选择器,tkcalendar 又要额外安装。这里用标准库 calendar + ttk 自己撸了一个,零依赖。
思路是两个类配合:
CalendarPopup:弹出式月历窗口
class CalendarPopup(tk.Toplevel):
def __init__(self, parent, initial_date=None, on_select=None):
super().__init__(parent)
self.on_select = on_select
self.transient(parent)
self.grab_set() # 模态窗口
# 顶部:< 月份标题 >
# 中部:星期表头 + 日期网格(用 calendar.monthdayscalendar 生成)
# 底部:今天 / 清空 / 取消
def _draw_days(self):
cal = calendar.Calendar(firstweekday=0) # 周一为首
weeks = cal.monthdayscalendar(self.view_year, self.view_month)
for r, week in enumerate(weeks):
for c, d in enumerate(week):
if d: # 非空日期才画按钮
btn = ttk.Button(self.days_frame, text=str(d),
command=lambda dd=d: self._pick(dd))
btn.grid(row=r, column=c)
calendar.monthdayscalendar(year, month) 返回的是按周分组的二维列表,例如:
[[0, 0, 0, 0, 1, 2, 3], # 第一周(0 表示上月末尾)
[4, 5, 6, 7, 8, 9, 10],
...]
遍历这个列表就能把日期画成 7 列网格,0 的位置留空。点击按钮回调返回 YYYY-MM-DD 字符串。
DateEntry:输入框 + 📅 按钮的组合控件
class DateEntry(ttk.Frame):
def __init__(self, master, **kw):
super().__init__(master)
self.var = tk.StringVar()
self.entry = ttk.Entry(self, textvariable=self.var, width=12)
self.entry.pack(side="left")
self.btn = ttk.Button(self, text="📅", width=3, command=self._popup)
self.btn.pack(side="left", padx=(2, 0))
def _popup(self):
win = CalendarPopup(self, self.var.get(), on_select=self._on_pick)
self.wait_window(win) # 阻塞直到日历关闭
def _on_pick(self, val):
self.var.set(val)
效果:点 📅 弹出月历 → 选日期 → 自动回填输入框。还支持「今天」一键选当日、「清空」清除、「<」「>」翻月。
5.3 默认目录 = 当天日期
每次采集的 PDF 默认存到 项目根目录/2026-07-13/ 这样的当天日期子目录,方便按天归档:
def default_output_dir(base=""):
if not base:
base = os.path.dirname(os.path.abspath(__file__))
return os.path.join(base, date.today().strftime("%Y-%m-%d"))
有个坑:配置文件会持久化上次用的目录。如果周一设了目录,周二再打开还是周一的目录。所以加载配置时强制重置 output_dir 为当天,不沿用历史值:
def load_config(self):
defaults = {... "output_dir": default_output_dir() ...}
defaults.update(saved) # 应用历史值
defaults["output_dir"] = default_output_dir() # 但目录强制重置为当天
return defaults
def save_config(self):
data = self._collect_values()
data.pop("output_dir", None) # 目录不持久化
界面还放了个「设为今天」按钮,随时一键重置。
5.4 线程安全的界面更新
重点:tkinter 不是线程安全的,工作线程不能直接操作界面控件,否则会崩溃或死锁。正确做法是用 after 把更新调度到主线程:
def _log(self, msg, level="info"):
line = f"[{ts}] {msg}\\n"
def append():
self.log_text.configure(state="normal")
self.log_text.insert("end", line)
self.log_text.see("end")
self.log_text.configure(state="disabled")
self.after(0, append) # 主线程执行
进度更新同理:
def _set_progress(self, done, total, name):
def upd():
self.progress["maximum"] = total
self.progress["value"] = min(done, total)
self.progress_label.config(text=f"{done} / {total}")
self.after(0, upd) # 主线程执行
爬虫在后台线程跑,通过 on_log / on_progress 回调通知界面,界面再用 after 转回主线程刷新——这是 tkinter 多线程的标准模式。
5.5 开始/停止控制
启动时开一个 daemon 线程跑爬虫,主线程继续响应界面(否则界面会卡死):
def _start(self):
self.crawler = CninfoCrawler()
self.crawler.reset_stop()
self.worker = threading.Thread(target=self._run_crawl, args=(params,), daemon=True)
self.worker.start()
停止靠 stop_event(threading.Event):
def _stop(self):
self.crawler.stop() # 设置 stop_event
爬虫主循环每次迭代都检查 stop_event.is_set(),下载循环里也检查,所以能在任意时刻干净地停下,不会留下半截文件。
六、文件名规范
6.1 模板化命名
支持 6 种命名模板,用 str.format 渲染:
NAME_TEMPLATES = {
"股票代码_标题": "{secCode}_{title}",
"股票代码_日期_标题": "{secCode}_{date}_{title}",
"日期_股票代码_标题": "{date}_{secCode}_{title}",
"股票代码": "{secCode}",
"简称_标题": "{secName}_{title}",
"日期_简称_标题": "{date}_{secName}_{title}",
}
def build_filename(template, ann):
fields = {
"secCode": ann.get("secCode"),
"secName": ann.get("secName"),
"title": ann.get("shortTitle"),
"date": format_time(ann.get("announcementTime")), # 毫秒→YYYY-MM-DD
}
return sanitize_filename(template.format(**fields))
6.2 非法字符清洗
公告标题里常有 /、:、? 等 Windows 文件名非法字符,必须清洗:
_INVALID_CHARS = re.compile(r'[\\\\/:*?"<>|\\r\\n\\t]')
def sanitize_filename(name, max_len=120):
name = _INVALID_CHARS.sub("_", name) # 替换为下划线
name = re.sub(r"\\s+", " ", name).strip()
if len(name) > max_len: # 限制长度
name = name[:max_len].rstrip()
return name or "untitled"
6.3 同名冲突处理
不同公司可能发同名公告(比如都叫「2025年年度报告」)。如果文件已存在但不是同一公告(announcementId 不同),就追加 ID 防覆盖:
if os.path.exists(save_path) and not _same_announcement(save_path, ann_id):
save_path = os.path.join(save_dir, f"{base_name}_{ann_id}.pdf")
七、断点续传
勾选「跳过已下载文件」后,已存在的 PDF 直接跳过不重复下载,适合大批量采集中断后继续:
if params.skip_existing and os.path.exists(save_path):
stat["skipped"] += 1
continue
配合原子写入(.part 临时文件 + os.replace),即使下载中途断电,也不会留下损坏的半个 PDF 被误判为「已下载」。
八、命令行模式
服务器没图形界面时,可用命令行模式无界面运行:
python app.py –cli \\
–column szse \\
–category category_ndbg_szsh \\
–date 2026-01-01~2026-07-13 \\
–page-end 0 \\
–threads 4 \\
–output ./pdfs
参数说明:
| –column | 市场 szse/sse/bse | szse |
| –category | 类别代码,留空=全部 | 空 |
| –stock | 股票代码或简称 | 空 |
| –searchkey | 关键词 | 空 |
| –date | 日期范围 YYYY-MM-DD~YYYY-MM-DD | 空 |
| –page-start | 起始页 | 1 |
| –page-end | 结束页,0=到末页 | 0 |
| –page-size | 每页条数 | 30 |
| –threads | 下载线程数 | 4 |
| –output | 输出目录,默认当天日期子目录 | 当天 |
| –no-skip | 不跳过已下载 | 默认跳过 |
九、踩过的坑
变量复用覆盖:原版脚本 data 变量同时用作请求参数和响应 JSON,第二次循环就崩了。改成 post_data 和 payload 分离。
只抓单页:原版 pageNum 写死为 2,根本没翻页逻辑。改成先查首页拿 totalRecordNum 算总页数,再循环到末页。
无状态码校验:原版 requests.get 后直接 response.content,404 也当成功存。加了 raise_for_status() 和 status_code 判断。
tkinter 跨线程崩溃:工作线程直接 log_text.insert() 会崩,必须用 self.after(0, …) 转主线程。
配置持久化导致目录不更新:output_dir 存进配置后,第二天打开还是昨天的目录。改成每次启动强制重置为当天。
并发不加锁丢进度:done += 1 在多线程下会丢更新,进度条卡住。加了 threading.Lock。
十、效果验证
实测抓取深交所 2026-06-01 至 2026-07-13 的年度报告:
[info] 开始采集 | 市场=szse 类别=category_ndbg_szsh 并发=4
[info] 命中公告共 44 条,约 8 页
[info] 已查询第 1 页(6 条)
[info] 查询完成 | 待下载 6 | 并发线程 4
[info] 启动 4 个下载线程…
[info] 下载完成: 301383_2024年年度报告(更正后).pdf (1599KB)
[info] 下载完成: 688017_2025年年度报告(更正后).pdf (1693KB)
[info] 下载完成: 301383_2023年年度报告(更正后).pdf (1581KB)
[info] 下载完成: 301383_2025年年度报告(更正后).pdf (1549KB)
[info] 下载完成: 000963_2025年年度报告(英文版).pdf (2362KB)
[info] 下载完成: 300777_2025年年度报告(更正后).pdf (1030KB)
[info] 采集结束 | 命中 6 | 成功 6 | 跳过 0 | 失败 0
STAT: {'total': 6, 'downloaded': 6, 'skipped': 0, 'failed': 0}
耗时: 0.5s
6 个 PDF 全部下载成功,文件魔数 %PDF- 校验通过,都是有效 PDF。4 线程并发 0.5 秒搞定。
十一、完整源码
完整代码已整理为单文件 app.py(约 700 行),结构如下:
app.py
├── 常量与预设 # 接口地址、请求头、市场/类别/模板字典
├── 工具函数 # 文件名清洗、时间戳转换、默认目录
├── CalendarPopup # 日历弹窗控件(纯 tkinter)
├── DateEntry # 日期输入组合控件
├── CrawlParams # 采集参数集合
├── CninfoCrawler # 爬虫核心(查询+下载+多线程)
├── CrawlerApp # tkinter 图形界面
├── run_cli() # 命令行入口
└── main() # 启动入口
运行方式:
# 图形界面
python app.py
# 命令行
python app.py –cli –column szse –category category_ndbg_szsh –date 2026-01-01~2026-07-13
依赖仅需 requests(标准库 tkinter 不用装):
pip install requests
十二、总结
这个工具的核心技术点:
| 接口请求 | requests + Session 复用连接 |
| 翻页 | 首页取 totalRecordNum 算总页数,循环到末页 |
| 重试 | 3 次指数退避(1.5×attempt 秒) |
| 下载 | 流式 iter_content + .part 临时文件 + os.replace 原子替换 |
| 并发 | ThreadPoolExecutor + threading.Lock 线程安全 |
| 界面 | tkinter + ttk,after 调度主线程更新 |
| 日期选择 | 自研 CalendarPopup + DateEntry(标准库 calendar) |
| 断点续传 | skip_existing 跳过已存在文件 |
| 配置持久化 | json 读写,output_dir 每次重置为当天 |
几个值得强调的设计:
希望对需要批量采集公告的朋友有帮助。完整源码可按文中结构实现,也可在理解思路后按自己的需求改造。
免责声明:本文仅作技术学习交流,爬取数据请遵守网站 robots 协议与服务条款,控制请求频率,勿用于商业用途。数据版权归原作者所有。