引言:爆炸止住了,但"遗忘"还在
上一篇做了一件漂亮的事——给梯度装上了"限速器"(梯度裁剪),WhhW_{hh}Whh 谱半径调到 1.2 也照样训练 300 步不爆炸,loss 从 3.72 降到了 0.064。爆炸这颗"定时炸弹",算是拆掉了。
但拆弹只是第一步。普通 RNN 还有一个更隐蔽、更难缠的问题:梯度消失。
想象一个场景:一段 100 个词的句子,“我小时候养过一只猫,它…(中间说了 90 个词)…所以我现在还是很喜欢猫。”——读到句尾"猫"时,句首"猫"的信息还在吗?对普通 RNN 来说,基本不在了。不是它不努力,是数学上"传不过去"。
上一篇的比喻是购物车冲下坡(爆炸),这一篇的比喻是传话游戏:50 个人排成一队传一句话,第一个人说"今天晚饭吃红烧排骨",传到第 50 个人嘴里变成了"今天什么什么骨"——信息在传递中被噪声淹没了。RNN 的梯度消失,本质上就是传话传着传着就没了。
这篇文章要回答三个问题,层层递进:
🎯 本章目标
一、梯度消失:RNN 为什么是"金鱼记忆"
1.1 病根回顾:一串连乘惹的祸
第十七篇推导过一个核心结论:隐藏状态对历史输入的敏感度,随时间步呈指数关系——
∂hT∂h1=∏t=1T−1Whh⊤ diag(1−ht2)
\\frac{\\partial h_T}{\\partial h_1} = \\prod_{t=1}^{T-1} W_{hh}^{\\top}\\,\\mathrm{diag}(1-h_t^2)
∂h1∂hT=t=1∏T−1Whh⊤diag(1−ht2)
这条式子翻译成人话就是:第 T 步的状态,对第 1 步变化的反应 = 中间每一步的"传递因子"连乘起来。
关键在 ∏\\prod∏ 这个符号——这是一个连乘号。如果 WhhW_{hh}Whh 的谱半径(最大特征值的绝对值)大于 1,连乘会把梯度越放越大(梯度爆炸);如果小于 1,连乘会把梯度越缩越小(梯度消失)。
第十七篇和第十八篇的实验证明了"大于 1"的恐怖:谱半径 1.2,24 步连乘后梯度范数涨到 104610^{46}1046。那"小于 1"呢?
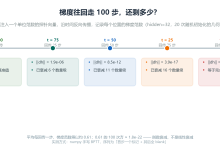
做个简单的思想实验:假设每一步的传递因子平均是 0.8,50 步后呢?0.850≈0.0000140.8^{50} \\approx 0.0000140.850≈0.000014。一万四千分之一。如果每一步的传递因子是 0.5,50 步后是 0.550≈8.9×10−160.5^{50} \\approx 8.9 \\times 10^{-16}0.550≈8.9×10⁻¹⁶——小数点后面 15 个零。这就是梯度消失:早期的梯度信号,在回传路上被"稀释"到几乎为零。
1.2 生活类比:传话游戏
50 个人排成一队。第一个人拿到一张纸条,上面写着"明天下午三点在图书馆门口集合"。规则是:每个人把纸条上的内容读一遍,凭记忆转述给下一个人。
第一遍:“明天下午三点在图书馆门口集合”。
第三遍:“明天下午三点在图书馆集合”。
第十遍:“明天三点图书馆”。
第二十遍:“明天…图书馆?”
第五十遍:“……”(什么都记不住了)
RNN 的梯度回传就是这个过程。每传一步,信息就损失一丁点——tanh\\tanhtanh 的导数在 (−1,1)(-1,1)(−1,1) 之间、WhhW_{hh}Whh 的特征值大多小于 1——两个因素乘在一起,每一步都在"打折扣"。折扣连乘 50 次,信号就没了。
反过来,如果每一步的传递因子是 1.0(完全无损),传 50 步还是原来的信号。LSTM 的核心思想,就是尽量让这条传递通道的因子接近 1。
1.3 数值实验:亲眼看到梯度消失
光说不练假把式。造一个简单的 RNN,权重初始化让谱半径小于 1,然后看梯度沿时间轴回传时怎么衰减:
import numpy as np
# 造一个"温和"的 RNN:谱半径 0.6,保证连乘会衰减
rng = np.random.RandomState(42)
W_hh_mild = rng.randn(4, 4) * 0.3
rho = np.max(np.abs(np.linalg.eigvals(W_hh_mild)))
W_hh_mild *= (0.6 / rho) # 谱半径精确设为 0.6
# 模拟梯度沿时间轴回传:每一步乘 W_hh^T 和 tanh 导数(设为 1.0 简化)
grad_norms = []
g = np.eye(4) # 初始梯度:第 T 步的单位信号
for step in range(50):
g = g @ W_hh_mild.T # 回传一步
grad_norms.append(np.linalg.norm(g))
运行这段代码,打印前几步和最后几步的梯度范数:
步骤 0: 梯度范数 = 1.5041 ← 起点
步骤 1: 梯度范数 = 0.8590 ← 一步就缩水近一半
步骤 5: 梯度范数 = 0.1260 ← 5 步剩 8%
步骤 10: 梯度范数 = 0.0122 ← 10 步剩不到 1%
步骤 20: 梯度范数 = 0.0001 ← 20 步只剩万分之一
步骤 30: 梯度范数 = 0.0000 ← 30 步后,计算机四舍五入成零
步骤 49: 梯度范数 = 0.0000 ← 完全消失
30 步之后梯度基本清零。这意味着:超过 30 步的上下文,普通 RNN 完全学不到。不管数据里有什么规律,第 1 步对第 50 步的梯度为零,参数就永远不知道该往哪调。
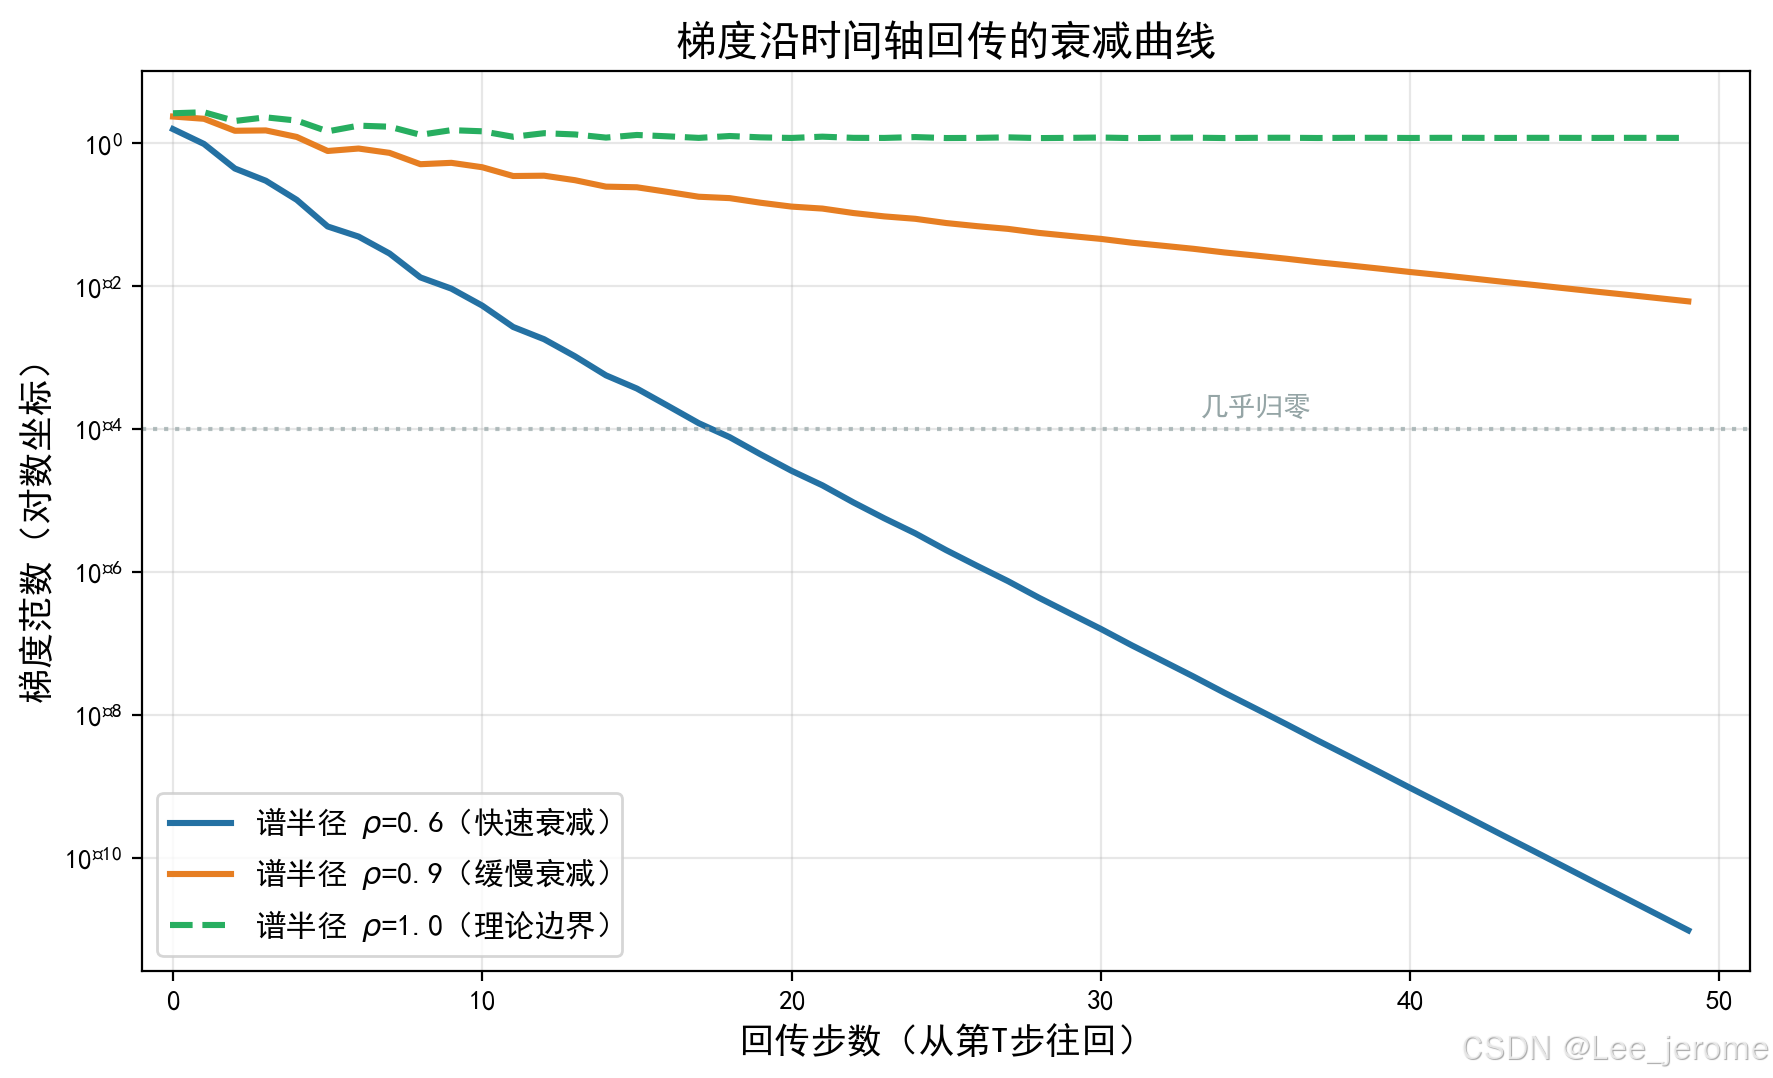
上图横轴是从 TTT 往回走的步数,纵轴是梯度范数(对数坐标)。三条曲线对应三种谱半径:0.6(蓝色)衰减最快,30 步就到底;0.9(橙色)撑得久一些但 100 步后依然归零;1.0(绿色虚线)是理论边界——刚好不衰减也不增长。现实中极少有初始化恰好落在 1.0 上的运气,绝大多数情况梯度要么消失要么爆炸。
二、LSTM 的大智慧:把乘法变成加法
2.1 核心比喻:传送带 + 收费站
普通 RNN 的信息传递是一条"独木桥":
ht=tanh(Whhht−1+Wxhxt+bh)h_t = \\tanh(W_{hh} h_{t-1} + W_{xh} x_t + b_h)ht=tanh(Whhht−1+Wxhxt+bh)
每一次更新,旧状态 ht−1h_{t-1}ht−1 都要先和 WhhW_{hh}Whh 做矩阵乘法,再过 tanh\\tanhtanh 压缩。每一步都在"加工"上一次的状态——加工得越多,原始信息损失越大。这就是传话游戏里"凭记忆转述"的毛病:每次转述都在失真。
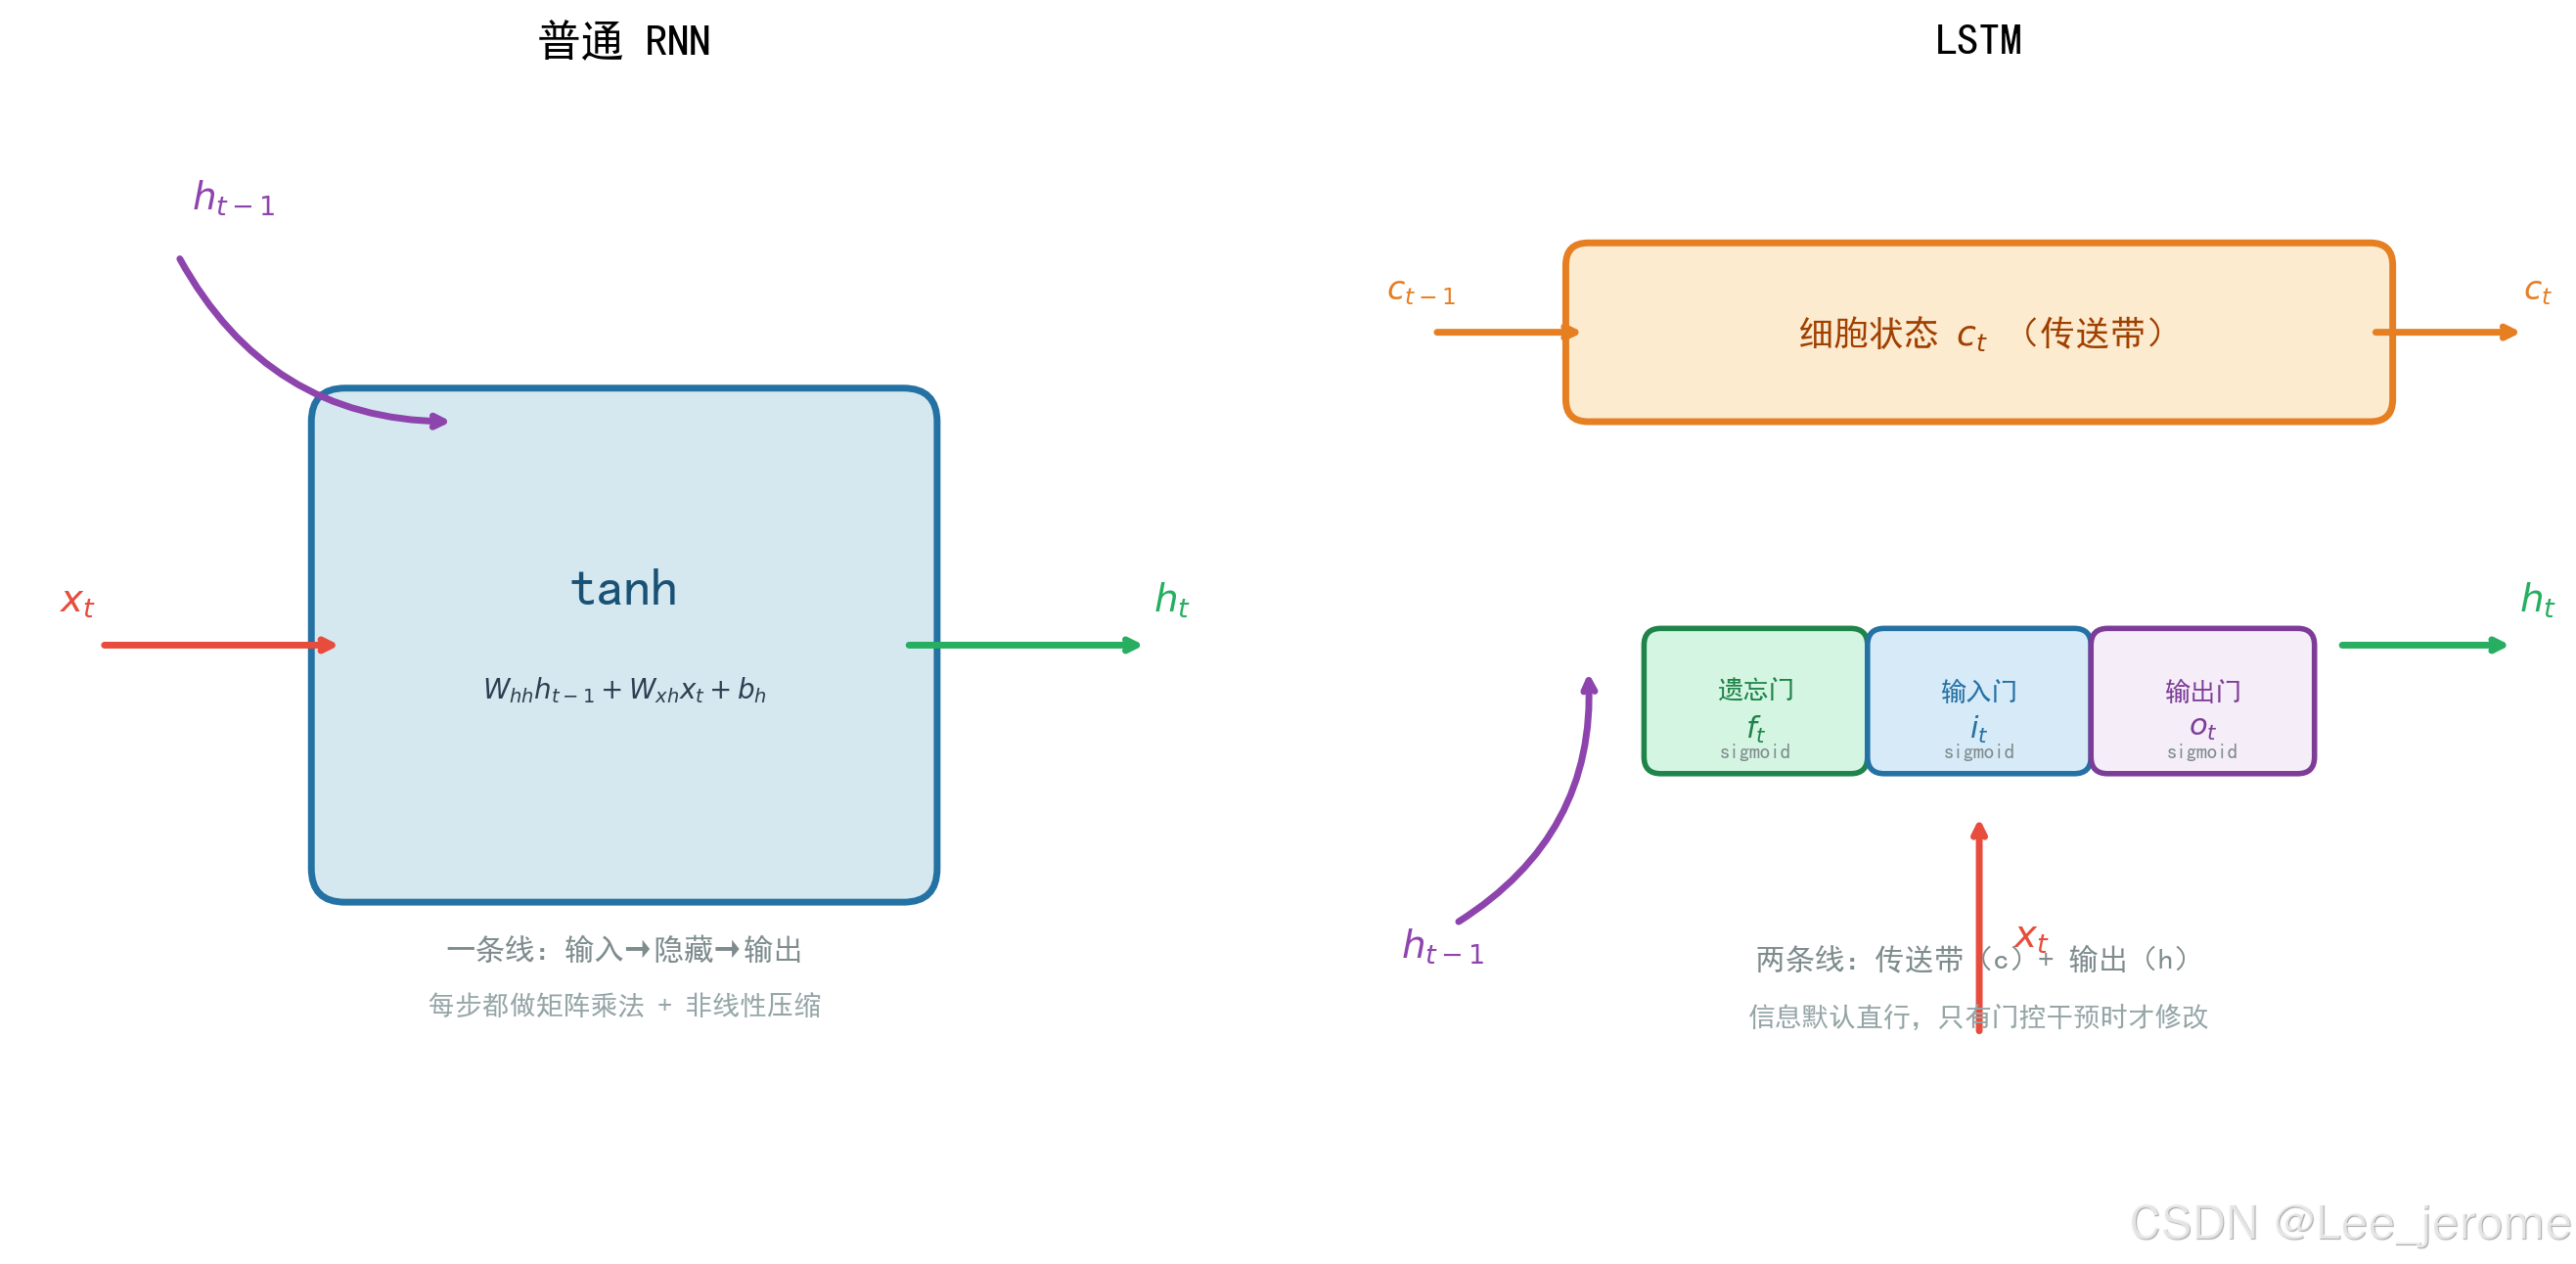
LSTM 的做法是修一条高速公路,名字叫细胞状态(Cell State),记作 ctc_tct。这条高速公路的关键特征是:信息在上面走,不需要每次都经过矩阵乘法和激活函数的"收费站"。大部分路段是直行的,只有到了特定的出口(门控)才决定:是继续直行、忘掉一点、还是加点新东西。
用生活场景类比:
- 传送带(细胞状态 ctc_tct):工厂流水线上的传送带。零件放在上面,从头传到尾。传送带本身不改变零件——除非有人动手。
- 收费站(三个门):传送带上每隔一段设一个站点,每个站点有三个"管理员":
- 遗忘门:看一眼传送带上过来的旧零件,决定"这个零件还要不要?不要就扔了";
- 输入门:看一眼新送来的零件,决定"这个新零件要放上传送带吗?";
- 输出门:决定"传送带上现在的东西,有多少要报告给外界(隐藏状态 hth_tht)?"
关键洞察:传送带上的信息默认是"直行"的——ctc_tct 到 ct+1c_{t+1}ct+1 的主要路径是加法,不是乘法。只有"收费站"主动干预时,信息才会被修改。这和 RNN 每一步都做矩阵乘法的"全加工"模式截然不同。
2.2 公式层面的对比
先把两套公式摆在一起,感受一下区别:
RNN(一条线,每一步都加工):
ht=tanh(Whhht−1+Wxhxt+bh)h_t = \\tanh(W_{hh} h_{t-1} + W_{xh} x_t + b_h)ht=tanh(Whhht−1+Wxhxt+bh)
LSTM(两条线,传送带 + 输出):
ct=ft⊙ct−1+it⊙c~tc_t = f_t \\odot c_{t-1} + i_t \\odot \\tilde{c}_tct=ft⊙ct−1+it⊙c~t
ht=ot⊙tanh(ct)h_t = o_t \\odot \\tanh(c_t)ht=ot⊙tanh(ct)
其中 ft,it,otf_t, i_t, o_tft,it,ot 是三个"门"(0 到 1 之间的数,由 sigmoid 产生),c~t\\tilde{c}_tc~t 是"候选新信息"(由 tanh\\tanhtanh 产生),⊙\\odot⊙ 表示逐元素相乘。
对比两条公式,最核心的区别在哪?
- RNN 的 ht−1h_{t-1}ht−1 要经过 Whh⋅ht−1W_{hh} \\cdot h_{t-1}Whh⋅ht−1(矩阵乘法)再进 tanh\\tanhtanh——每一步都是"加工再输出";
- LSTM 的 ct−1c_{t-1}ct−1 直接乘一个门 ftf_tft(逐元素,0 到 1 之间),然后加上新信息 it⊙c~ti_t \\odot \\tilde{c}_tit⊙c~t——**
用代数语言说:RNN 的核心操作是"矩阵乘法 + 非线性压缩";LSTM 的核心操作是"逐元素加权平均"。加权平均天然比矩阵乘法更容易"原样传递"——只要 ft≈1f_t \\approx 1ft≈1 且 it≈0i_t \\approx 0it≈0,ctc_tct 就几乎等于 ct−1c_{t-1}ct−1,信息无损通过。
三、三个门:收费站是怎么工作的
上一节用"传送带 + 收费站"建立了直觉。现在把三个"管理员"的工作流程说清楚。
3.1 遗忘门:扔掉不重要的旧信息
计算公式:
ft=σ(Wf⋅[ht−1,xt]+bf)f_t = \\sigma(W_f \\cdot [h_{t-1}, x_t] + b_f)ft=σ(Wf⋅[ht−1,xt]+bf)
ftf_tft 的每个元素是一个 0 到 1 之间的数(sigmoid 的输出)。它和旧细胞状态 ct−1c_{t-1}ct−1 逐元素相乘:
ct←ft⊙ct−1c_t \\gets f_t \\odot c_{t-1}ct←ft⊙ct−1
- ftf_tft 的某个元素接近 1 → ct−1c_{t-1}ct−1 的对应位置"原样保留";
- ftf_tft 接近 0 → 对应位置"扔掉";
- ftf_tft 在中间 → 对应位置"打折扣"。
生活类比:传送带上的零件经过第一个收费站。管理员看一眼零件(ht−1h_{t-1}ht−1)和新送来的订单(xtx_txt),判断:“这个螺丝已经用过了,扔掉吧”(ftf_tft 某维 ≈ 0);“这个轴承后面还要用,留着”(ftf_tft 某维 ≈ 1)。
3.2 输入门:写入重要的新信息
计算公式:
it=σ(Wi⋅[ht−1,xt]+bi)i_t = \\sigma(W_i \\cdot [h_{t-1}, x_t] + b_i)it=σ(Wi⋅[ht−1,xt]+bi)
c~t=tanh(Wc⋅[ht−1,xt]+bc)\\tilde{c}_t = \\tanh(W_c \\cdot [h_{t-1}, x_t] + b_c)c~t=tanh(Wc⋅[ht−1,xt]+bc)
iti_tit 也是 0 到 1 之间的门,c~t\\tilde{c}_tc~t 是候选新信息(由 tanh\\tanhtanh 产生,范围 (−1,1)(-1,1)(−1,1))。两者相乘后加进细胞状态:
ct←ct+it⊙c~tc_t \\gets c_t + i_t \\odot \\tilde{c}_tct←ct+it⊙c~t
- iti_tit 控制"写多少";
- c~t\\tilde{c}_tc~t 提供"写什么"。
生活类比:传送带上的第二个操作。管理员看一眼旧状态和新订单:“现在需要一个螺母,正好新送来的这批有一个合适的螺母”,就把螺母放上传送带(iti_tit ≈ 1,c~t\\tilde{c}_tc~t 包含螺母的信息)。
遗忘门 + 输入门合在一起,就完成了细胞状态的更新:
ct=ft⊙ct−1⏟保留的旧信息+it⊙c~t⏟加入的新信息c_t = \\underbrace{f_t \\odot c_{t-1}}_{\\text{保留的旧信息}} + \\underbrace{i_t \\odot \\tilde{c}_t}_{\\text{加入的新信息}}ct=保留的旧信息ft⊙ct−1+加入的新信息it⊙c~t
3.3 输出门:决定对外透露多少
计算公式:
ot=σ(Wo⋅[ht−1,xt]+bo)o_t = \\sigma(W_o \\cdot [h_{t-1}, x_t] + b_o)ot=σ(Wo⋅[ht−1,xt]+bo)
ht=ot⊙tanh(ct)h_t = o_t \\odot \\tanh(c_t)ht=ot⊙tanh(ct)
细胞状态 ctc_tct 是"内部记忆"——传送带上所有零件。但外界(下一层网络、下一个时间步)不一定需要看到全部零件。输出门 oto_tot 决定"暴露多少":
- 先把 ctc_tct 过一遍 tanh\\tanhtanh(压缩到 (−1,1)(-1,1)(−1,1));
- 再乘上 oto_tot(0 到 1 之间的门)。
生活类比:传送带到了出货口。管理员看一眼传送带上现在有什么,然后写报告(hth_tht):“现在传送带上有 A、B、C 三种零件,但客户只关心 A,所以报告上只写 A 的情况”(oto_tot 过滤掉不相关的信息)。
四、为什么 LSTM 能缓解梯度消失
4.1 数学直觉:加法拯救世界
回到根本问题。RNN 梯度消失是因为反向传播时要连乘 Whh⊤W_{hh}^{\\top}Whh⊤:
∂L∂h1=∂L∂hT⋅∏t=1T−1∂ht+1∂ht\\frac{\\partial L}{\\partial h_1} = \\frac{\\partial L}{\\partial h_T} \\cdot \\prod_{t=1}^{T-1} \\frac{\\partial h_{t+1}}{\\partial h_t}∂h1∂L=∂hT∂L⋅t=1∏T−1∂ht∂ht+1
而 ∂ht+1∂ht\\frac{\\partial h_{t+1}}{\\partial h_t}∂ht∂ht+1 里包含 Whh⊤⋅diag(1−ht2)W_{hh}^{\\top} \\cdot \\mathrm{diag}(1-h_t^2)Whh⊤⋅diag(1−ht2)——每一步都乘一个矩阵,矩阵的谱半径如果小于 1,连乘 50 次就没了。
LSTM 呢?细胞状态的更新是:
ct=ft⊙ct−1+it⊙c~tc_t = f_t \\odot c_{t-1} + i_t \\odot \\tilde{c}_tct=ft⊙ct−1+it⊙c~t
对 ct−1c_{t-1}ct−1 求偏导:
∂ct∂ct−1=diag(ft)\\frac{\\partial c_t}{\\partial c_{t-1}} = \\mathrm{diag}(f_t)∂ct−1∂ct=diag(ft)
就一个对角矩阵!对角线上是遗忘门 ftf_tft 的各元素——没有矩阵乘法,没有 tanh\\tanhtanh 导数。如果把整个序列的细胞状态梯度连起来:
∂cT∂c1=∏t=1T−1diag(ft)\\frac{\\partial c_T}{\\partial c_1} = \\prod_{t=1}^{T-1} \\mathrm{diag}(f_t)∂c1∂cT=t=1∏T−1diag(ft)
这是一个逐元素连乘,不是矩阵连乘。每个维度独立。只要 ftf_tft 的某个维度接近 1,该维度的梯度就能近乎无损地跨过几十上百个时间步。LSTM 学到的正是:“哪些信息要长期保留?让对应的遗忘门保持开启(≈1)。”
4.2 对比总结
| 状态更新 | ht=tanh(Wht−1+… )h_t = \\tanh(W h_{t-1} + \\dots)ht=tanh(Wht−1+…) | ct=ft⊙ct−1+it⊙c~tc_t = f_t \\odot c_{t-1} + i_t \\odot \\tilde{c}_tct=ft⊙ct−1+it⊙c~t |
| 旧信息处理 | 矩阵乘法 → 非线性压缩(必然失真) | 逐元素加权(ft≈1f_t \\approx 1ft≈1 时可无损) |
| 梯度回传 | 连乘 Whh⊤W_{hh}^{\\top}Whh⊤,指数衰减 | 连乘 diag(ft)\\mathrm{diag}(f_t)diag(ft),ft≈1f_t \\approx 1ft≈1 时不衰减 |
| 类比 | 传话游戏(每一步都在转述) | 传送带 + 收费站(默认直行,按需修改) |
一句话总结:RNN 的默认操作是"加工",LSTM 的默认操作是"保留"。加工得越多信息丢得越多,保留得越多信息传得越远。
五、实操:亲眼对比 RNN 与 LSTM 的梯度衰减
理论讲完了,来跑一组对比实验——同样 50 步的序列,看 RNN 和 LSTM 在回传梯度时差距多大。
5.1 RNN 端:梯度一路衰减
数据来自第一节的数值实验——谱半径 0.6 的 WhhW_{hh}Whh,模拟 50 步梯度回传:
RNN(谱半径0.6)梯度回传:
回传 1 步: 梯度范数 = 0.8590
回传 5 步: 梯度范数 = 0.1260
回传 10 步: 梯度范数 = 0.0122
回传 20 步: 梯度范数 = 0.0001
回传 30 步: 梯度范数 ~ 0.0000 ← 基本归零
5.2 LSTM 端:遗忘门开着,梯度畅通
用同样的思路模拟 LSTM 的细胞状态梯度。假设遗忘门 ft=0.95f_t = 0.95ft=0.95(接近 1,表示"大部分保留"),初始梯度为单位信号:
# LSTM 梯度模拟:遗忘门 f=0.95
f = 0.95
g = 1.0
lstm_grads = []
for step in range(50):
g *= f # 每步只乘 f(对角矩阵的单个元素)
lstm_grads.append(g)
运行结果:
LSTM(遗忘门 f=0.95)梯度回传:
回传 1 步: 梯度 = 0.9500
回传 5 步: 梯度 = 0.7738 ← 5 步后还剩 77%
回传 10 步: 梯度 = 0.5987 ← 10 步后还剩 60%
回传 20 步: 梯度 = 0.3585 ← 20 步后还剩 36%
回传 30 步: 梯度 = 0.2146 ← 30 步后还剩 21%
回传 50 步: 梯度 = 0.0769 ← 50 步后还剩 7.7%
差距触目惊心:30 步后,RNN 的梯度已经归零(计算机四舍五入为 0),LSTM 还有 21% 的信号;50 步后 LSTM 还剩 7.7%——虽然也在衰减,但远没有到"消失"的程度。
如果把遗忘门调成 ft=0.99f_t = 0.99ft=0.99(几乎完全保留),50 步后还剩 0.9950≈0.6050.99^{50} \\approx 0.6050.9950≈0.605——60% 的信号完好无损!这就是 LSTM 的威力:遗忘门学会了"哪些信息重要就保持 f 接近 1",让关键信号的梯度跨过整个序列。
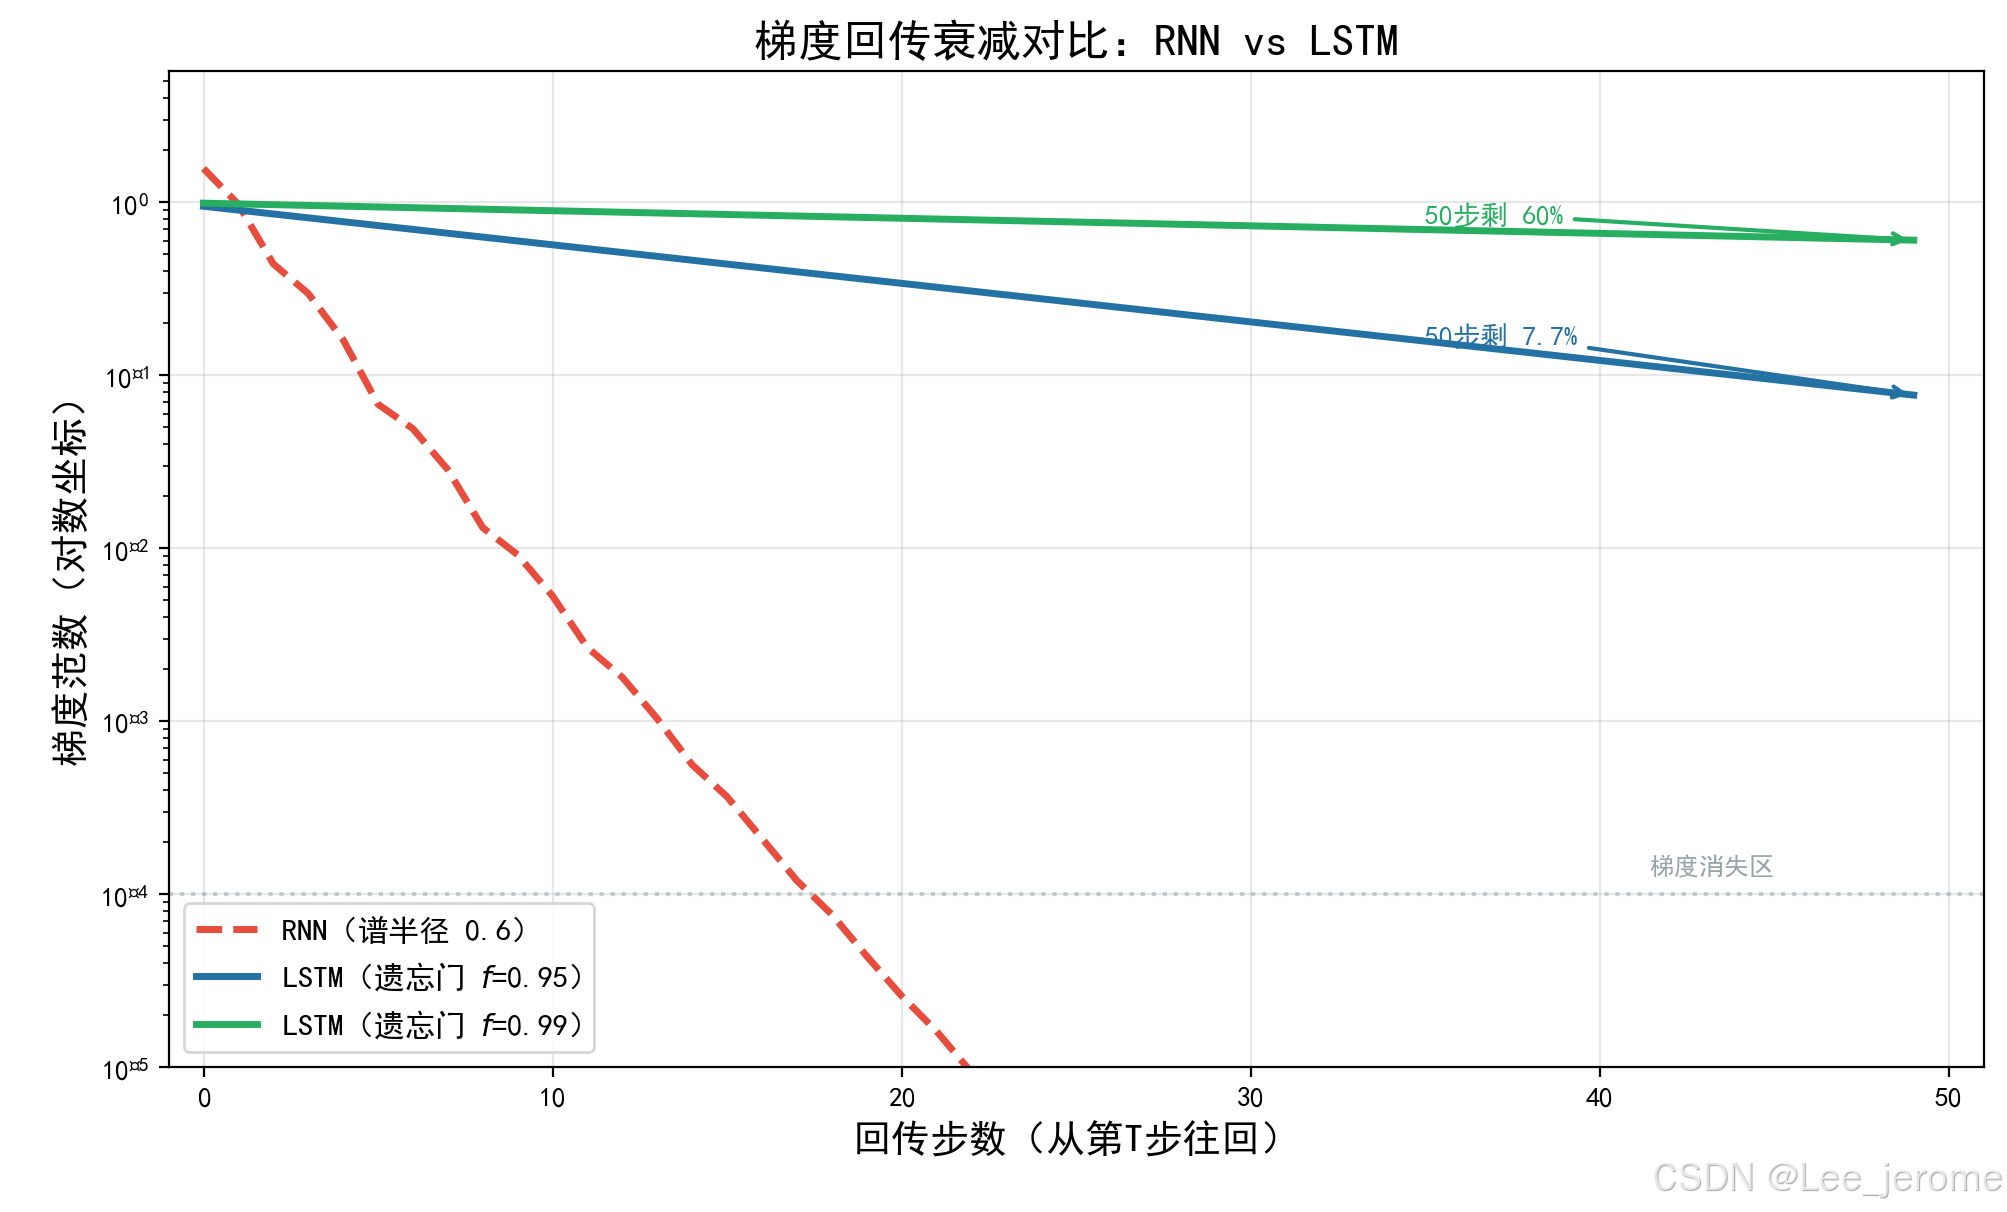
上图:横轴是回传步数,纵轴是梯度范数(对数坐标)。红色虚线是 RNN(谱半径 0.6)——几乎垂直坠落;蓝色实线是 LSTM(f=0.95f=0.95f=0.95)——缓慢衰减;绿色实线是 LSTM(f=0.99f=0.99f=0.99)——几乎平着走。一张图讲清楚 LSTM 到底强在哪。
六、本章小结与下章预告
本章小结
| 梯度消失根源 | ∏Whh⊤\\prod W_{hh}^{\\top}∏Whh⊤ 连乘,谱半径 <1<1<1 时指数衰减 |
| LSTM 核心创新 | 用细胞状态 ctc_tct 替代 hth_tht 做长期记忆,更新公式是加法而非矩阵乘法 |
| 细胞状态更新 | ct=ft⊙ct−1+it⊙c~tc_t = f_t \\odot c_{t-1} + i_t \\odot \\tilde{c}_tct=ft⊙ct−1+it⊙c~t,旧信息默认保留 |
| 三个门 | 遗忘门 ftf_tft(扔旧)、输入门 iti_tit(写新)、输出门 oto_tot(对外暴露) |
| 缓解消失的关键 | ∂ct/∂ct−1=diag(ft)\\partial c_t / \\partial c_{t-1} = \\mathrm{diag}(f_t)∂ct/∂ct−1=diag(ft),ft≈1f_t \\approx 1ft≈1 时梯度近似无损 |
| 数值对比 | RNN 30 步梯度归零,LSTM 50 步剩 7.7%,f=0.99f=0.99f=0.99 时剩 60% |
核心直觉(一张图记住 LSTM)
把 LSTM 想象成一条高速公路(细胞状态 ctc_tct)配上三个收费站(门):
- 高速公路默认畅通,车流(信息)直行无阻;
- 遗忘门是一个"出口匝道"——觉得没用的车就让它出去(ft≈0f_t \\approx 0ft≈0);
- 输入门是一个"入口匝道"——新来的重要车辆从这进(it≈1i_t \\approx 1it≈1,c~t\\tilde{c}_tc~t);
- 输出门是"路况播报"——告诉外界高速公路上现在有什么车(hth_tht)。
普通 RNN 没有高速公路,只有乡间小路——每过一个路口就要拐弯减速(矩阵乘法、tanh\\tanhtanh 压缩),跑不了多远信息就散架了。
下章预告:第 7 章《LSTM 数学原理与结构拆解》
这一章建立了"传送带 + 收费站"的直觉,但只给了三个门的公式草稿。下一章把每个门彻底拆开:
- 遗忘门、输入门、输出门各自的完整计算流程;
- 为什么门用 sigmoid、候选状态用 tanh\\tanhtanh?
- 参数量是多少?相比 RNN 多了几倍?
- 画出完整的 LSTM 内部数据流图。
到时候带上纸笔,把 7 个公式一口气默写出来。
梯度消失的根源找到了,解决方案 LSTM 的直觉也建立了。下一章,正式"拆弹"——把 LSTM 的每个零件拆开看。
🧠 思考题与动手练习
思考题:
动手练习:
📌 下篇预告:第七章《LSTM 数学原理与结构拆解》——三个门的完整计算公式、sigmoid 和 tanh 的分工理由、参数量统计、用 networkx 画完整数据流图。我们下篇见!
本文为原创,遵循 CC 4.0 BY-SA 版权协议,转载需附原文链接。