目录
- 前言
- 一、为什么AI工程化是生产落地刚需?(客观概率推演)
-
- 1.1 多步骤Agent天然存在误差叠加问题
- 1.2 算法与工程化从来不是割裂的两条线
- 二、四大工程化支柱完整落地方案
-
- 支柱一:质量保障支柱|给每一次迭代装上“量化标尺”,变更风险可控可回滚
-
- 核心定位
- 1.1 分层评测基线 Golden Set——AI效果的唯一度量衡
- 1.2 CI/CD自动化回归流水线——守住上线准入门槛
- 1.3 分阶段灰度发布+自动熔断风控——上线风险分层隔离
- 1.4 配套底层校验:知识库数据质量基线
- 1.5 Prompt工程化管理——把"提示词手艺"变成"版本化资产"
- 支柱二:运行时韧性支柱|抹平大模型概率不确定性,输出标准化稳定API
-
- 核心定位
- 2.1 LLM统一网关+混合调度架构——企业AI流量的统一交通枢纽
- 2.2 多层安全护栏(输入前置拦截+输出后置校验)——全链路风险防火墙
- 2.3 结构化输出强制约束+多级容错兜底
- 支柱三:全链路可观测支柱|撕碎AI黑盒,每一次调用可追溯、可归因、可复盘
-
- 核心定位
- 3.1 四层完整监控指标体系
- 3.2 全链路Trace追踪与工具选型
- 3.3 精细化成本管控闭环
- 3.4 告警收敛+自动化自愈
- 支柱四:持续进化支柱|搭建业务数据驱动的AI质量飞轮,驱动系统持续自我进化
-
- 核心定位
- 4.1 人机协同反馈闭环 Human-in-the-Loop——样本活水源头
- 4.2 Agent三阶段质量飞轮(源自 Google Cloud MLOps 实践框架)
- 4.3 知识库自动化巡检与动态治理
- Multi-Agent多智能体协作——2026年不可忽视的架构升级
-
- 核心协作模式
- 行业标准化协议(2025-2026)
- 主流开源框架对比
- 三、四大支柱总览速查表
- 四、企业落地必备三大底层底座(上层四大支柱的承载根基)
-
- 4.1 数据工程底座(RAG效果的根本来源)
- 4.2 MLOps/LLMOps模型全生命周期管理
- 4.3 基础设施+国产化适配底座
-
- 基础设施底座
- 💡 国产化落地适配要点(国内开发者重点关注)
- 五、企业落地高频踩坑清单(收藏备用)
- 六、新手落地阶段路线图(含建议周期与资源投入)
- 七、总结
- 互动交流
前言
💡 行业现状:2026年智能体、企业RAG落地加速,但MIT 2025调研显示95%企业AI项目达不到业务预期,其中93%卡在POC到生产的最后一公里。
跑通Demo只需要优秀算法;做成可持续商用产品,必须靠完整工程化底座。 绝大多数团队本末倒置:把全部资源砸在调参、追SOTA、打磨Prompt,却忽略一条行业铁律: 算法定义AI的能力天花板,工程化守住AI的商用生命线。
模型再强,也只是实验室里一次性的惊艳演示;一套可控、可观测、能自我进化的AI工程体系,才是企业长期不可复制的核心壁垒——算法负责"冲上限",工程化负责"托底盘"。
本文结合多年一线AI落地实践,完整拆解AI应用(智能体/RAG知识库)从Demo走向规模化生产的四大工程化支柱,覆盖评测、网关、可观测、迭代全链路实战方法论,同时补充底层支撑底座、落地避坑清单与分阶段实施路线,适合大模型研发、AI架构师、MLOps工程师、技术负责人阅读。 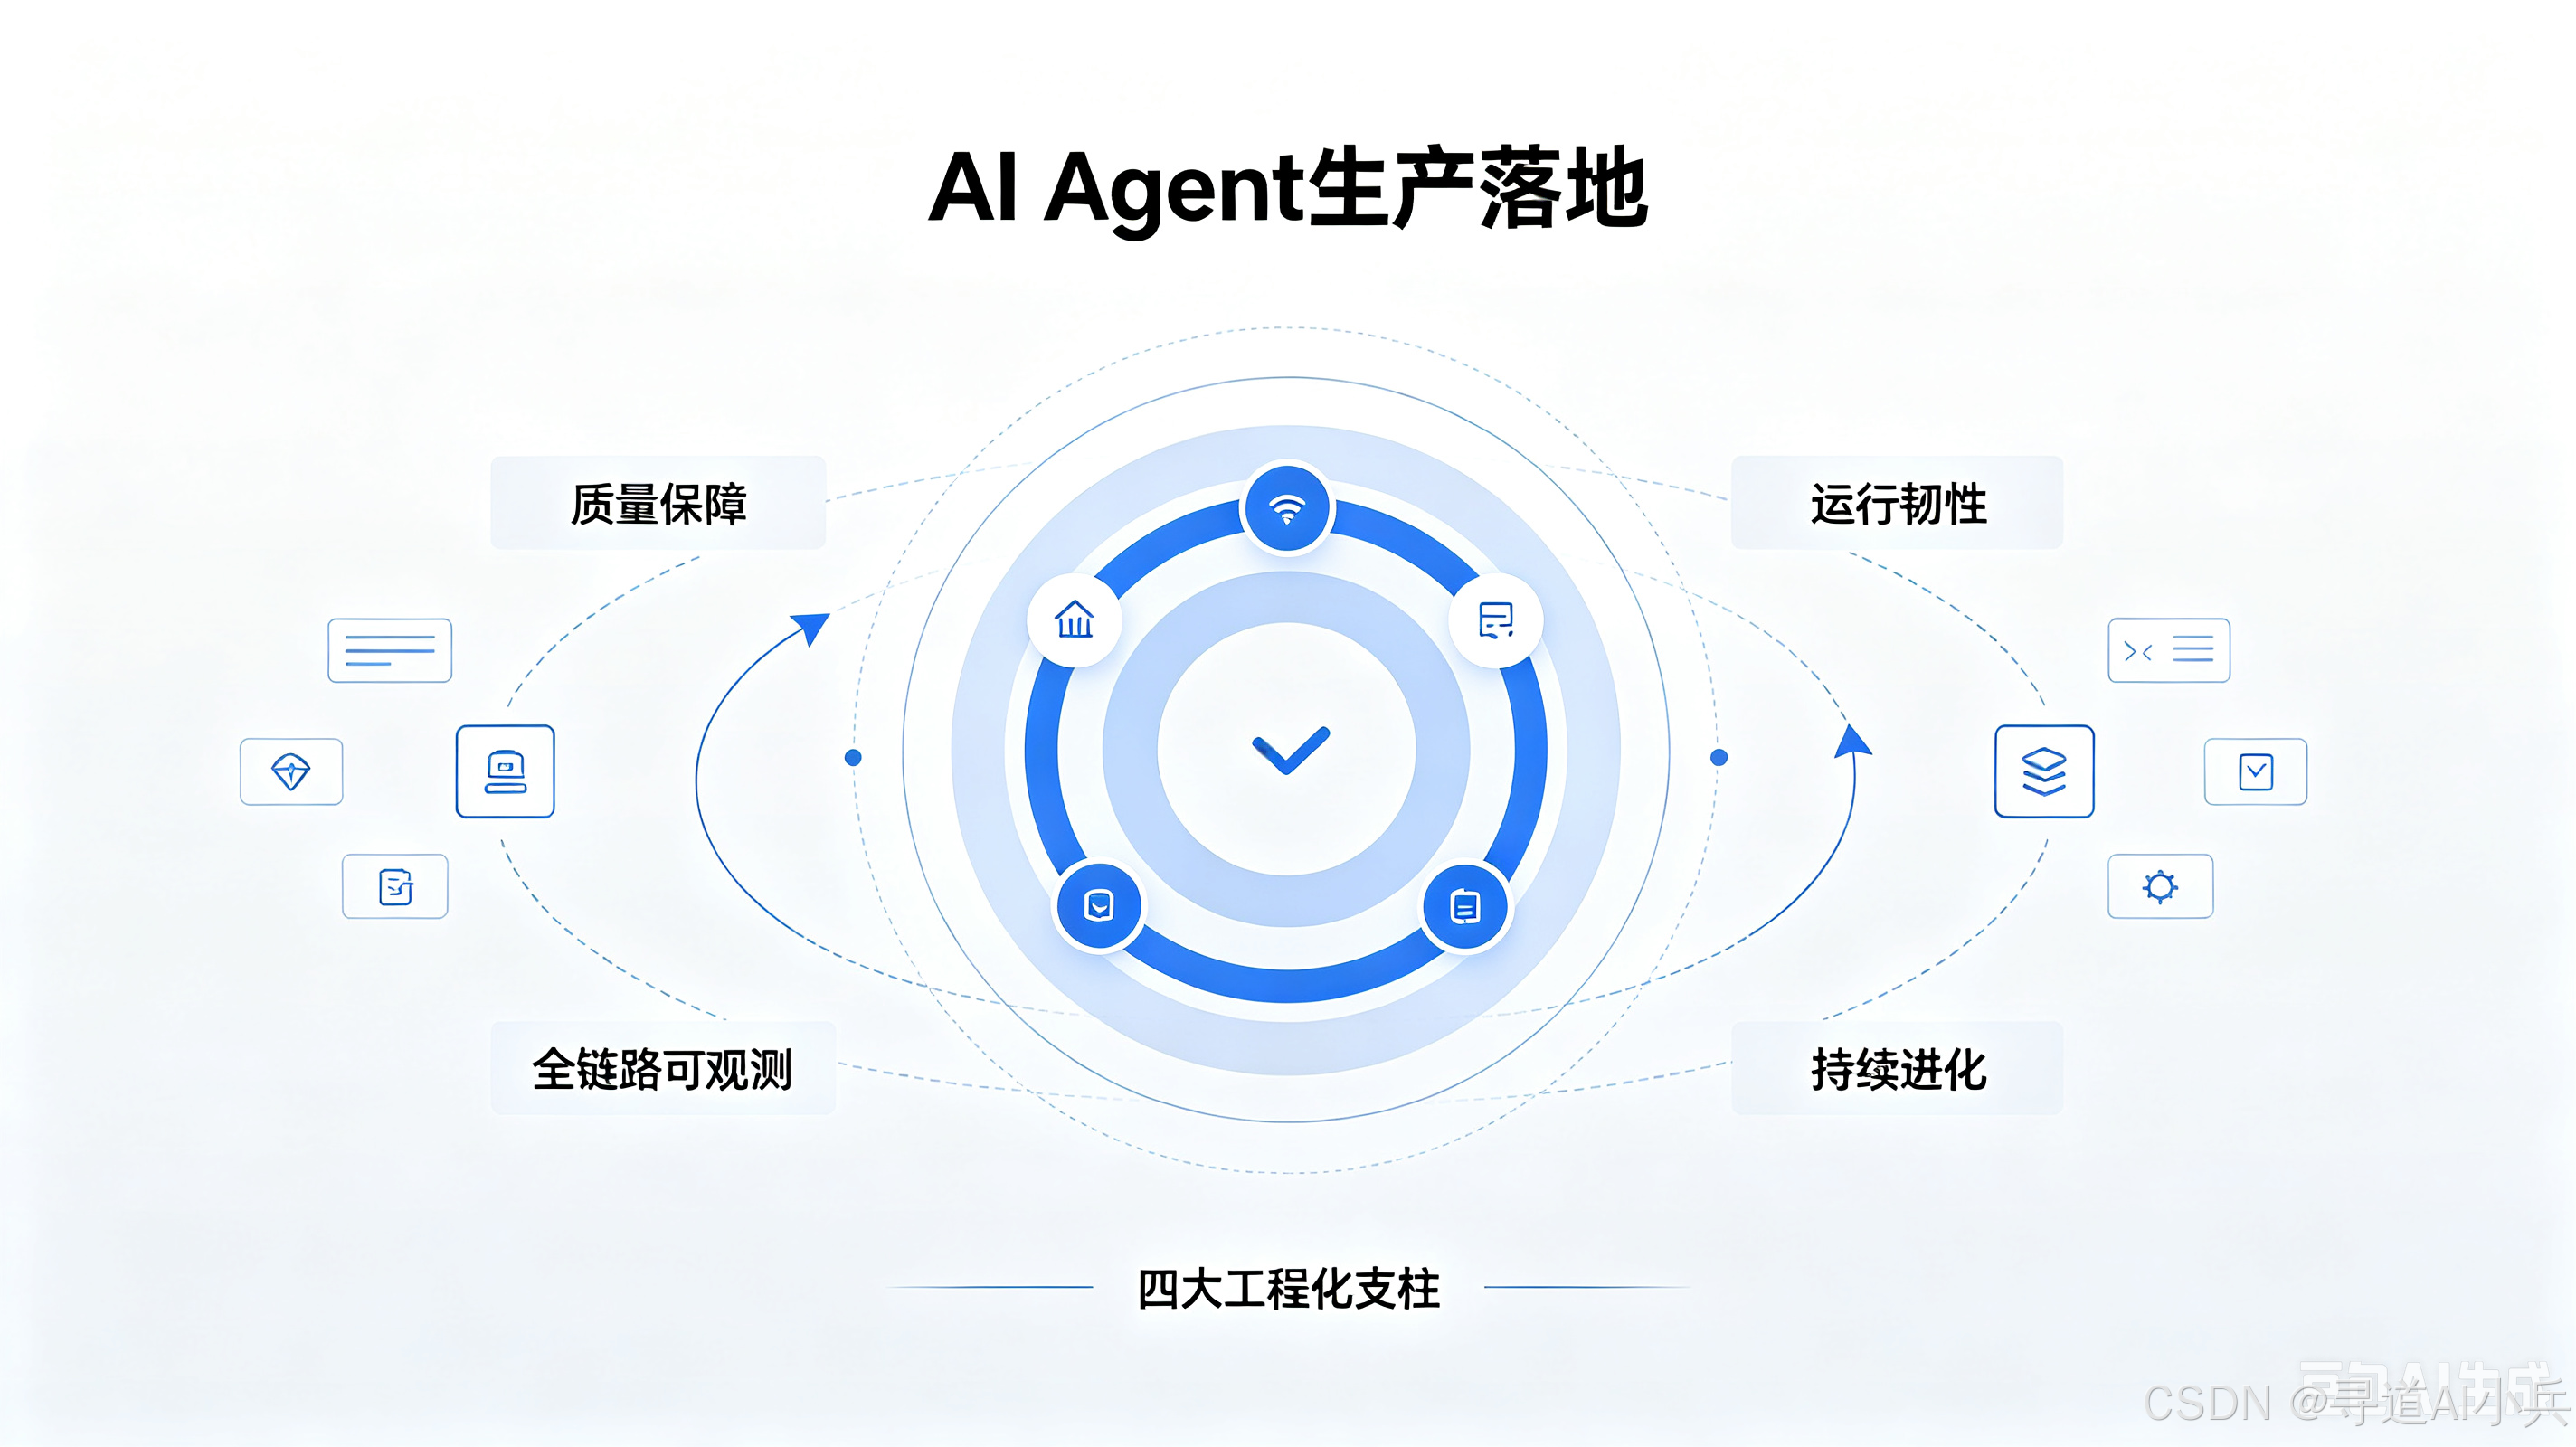
一、为什么AI工程化是生产落地刚需?(客观概率推演)
1.1 多步骤Agent天然存在误差叠加问题
Agent链路由查询改写、RAG检索、工具调用、LLM推理、格式校验等多节点依次串联。 假设无重试、无中间自校验、无步骤间异常捕获、无异常分支,单节点成功率95%(行业理想水平),任务整体成功率会指数级衰减:
| 5步 | 77% |
| 10步 | 59% |
| 20步 | 36% |
即便把单节点可靠性拉高至99%,20步串联链路整体成功率仅82%。
⚠️ 关键区分:上文讨论的是“单次请求完整走完链路的成功率”,与“系统可用性SLA(如99.9%)”是两个不同维度。生产级99.9%可用性指服务正常响应请求的时间占比,允许单次失败后通过重试、降级、兜底最终返回正确结果。算法只能优化单步准确率,却无力阻断误差链式放大;工程化体系的核心价值,正是通过重试、校验、降级、分流等机制斩断误差叠加链条,把概率不稳定的大模型封装成确定性服务——既托住单次请求的成功率,更守住系统级的可用性。
1.2 算法与工程化从来不是割裂的两条线
行业普遍存在认知误区:算法团队只管效果,工程团队只管部署上线。 站在落地实践视角,RAG检索优化、动态模型路由、结构化输出约束、全链路安全防护,全都属于算法工程一体化领域。 任何脱离工程约束的算法设计,都是纸上谈兵——做算法之初,就要同步考量延迟、成本、合规、并发、容灾等生产约束。
轻量化单轮FAQ或许能靠极简流程勉强上线,但面向复杂多轮Agent、高并发企业核心业务,工程化体系不是锦上添花的加分项,而是决定AI业务生死的准入门票。
二、四大工程化支柱完整落地方案
支柱一:质量保障支柱|给每一次迭代装上“量化标尺”,变更风险可控可回滚
核心定位
彻底告别“凭体感评判效果”的野蛮开发模式,搭建一套标准化评测、自动化回归、分阶段灰度发布的质量闭环。 核心价值:让效果好坏有数据作证,线上劣化有退路可走。
1.1 分层评测基线 Golden Set——AI效果的唯一度量衡
通用公开Benchmark只能筛选基础模型,无法适配企业专属业务场景。真正能衡量业务效果的标尺,必须自建分层Golden评测集:
- 检索维度:Recall@K、MRR、重复文档命中率、空召回占比
- 模型能力维度:业务解决率、幻觉发生率、多轮对话一致性
- 安全合规维度:违规输出率、提示词注入拦截成功率
- 性能维度:P95/P99响应延迟、并发QPS、单次Token消耗
🛠️ 行业主流评测框架选型参考:
| RAGAS | RAG端到端评测 | Faithfulness、Context Relevance、Answer Relevance |
| DeepEval | 通用LLM评测 | 支持14+指标,CI/CD集成友好 |
| TruLens | RAG反馈闭环 | 应用内实时评估与追踪 |
| LangSmith | 全生命周期管理 | LangChain生态,评测+监控+标注一体化 |
| Garak | 安全对抗评测 | 注入、越狱、幻觉专项探测 |
| PromptBench | Prompt鲁棒性评测 | 对抗扰动、跨模型迁移测试 |
选型建议:RAG场景优先RAGAS+TruLens;安全评测选Garak;全链路选LangSmith。评测框架的输出直接对接下方CI/CD流水线,形成自动化闭环。
✅ 落地铁则:评测集强制版本化管理,任何代码、Prompt、知识库、路由策略变更,都必须自动对比基线,输出量化差异报告,不达标禁止提测上线。 💡 规模建议:初期(L1-L2阶段)先建 200-500 条核心场景评测集跑通 CI 流水线;成熟期(L4-L5阶段)逐步扩充至 2000+ 条全覆盖评测集,覆盖长尾与对抗场景。
1.2 CI/CD自动化回归流水线——守住上线准入门槛
将全域评测深度嵌入代码提交、配置变更CI流水线,一旦指标劣化直接阻断上线:
1.3 分阶段灰度发布+自动熔断风控——上线风险分层隔离
标准上线流水线:离线全量评测 → 影子并行验证 → 小流量金丝雀灰度 → 分层用户放量 → 全量上线,配套秒级一键回滚能力。
1.4 配套底层校验:知识库数据质量基线
行业共识:RAG体系70%效果问题,根源不在模型,而在知识库脏数据。上线前置强制巡检:自动识别重复文档、过期信息、残缺切片、未脱敏涉密内容,从源头减少幻觉。
1.5 Prompt工程化管理——把"提示词手艺"变成"版本化资产"
Prompt 是 LLM 应用的核心逻辑载体,其重要性不亚于代码。但绝大多数团队仍以"复制粘贴+手工调参"管理 Prompt,导致迭代不可追溯、效果退化无法回滚。
支柱二:运行时韧性支柱|抹平大模型概率不确定性,输出标准化稳定API
核心定位
大模型天生是概率生成器:相同输入输出不稳定、格式错乱、偶发幻觉、第三方厂商API随时故障。韧性体系通过统一网关、多层安全护栏、强制结构化约束,向上游业务屏蔽所有底层波动。 核心价值:把不可控的概率模型,封装成对上游业务方完全透明的标准化稳定服务。
2.1 LLM统一网关+混合调度架构——企业AI流量的统一交通枢纽
在业务应用与各类大模型之间架设独立网关层,彻底消除单一厂商依赖风险,补齐企业生产必备管控能力:
🛠️ LLM网关开源/商业方案选型参考:
| LiteLLM | 开源 | 100+模型统一代理,负载均衡,花费追踪 | 中小团队快速接入多模型 |
| One API | 开源 | 轻量级多模型分发,国产模型适配好 | 国内开发者,私有化部署 |
| Portkey | 商业/开源 | 生产级网关,内置缓存/限流/监控 | 规模化SaaS业务 |
| Kong AI Gateway | 开源 | 企业级API网关+AI插件 | 已有Kong网关的企业 |
| Cloudflare AI Gateway | SaaS | 全球边缘加速,自动缓存 | 全球化业务,低延迟需求 |
| 自研方案 | 自建 | 基于OpenAI兼容协议+NGINX+Lua插件 | 政企强合规,完全自主可控 |
2.2 多层安全护栏(输入前置拦截+输出后置校验)——全链路风险防火墙
🛡️ 安全设计基线:OWASP Top 10 for LLM Applications(2025版) 安全护栏的设计应完整覆盖 OWASP 定义的十大LLM安全威胁:LLM01 Prompt注入、LLM02 不安全输出处理、LLM03 训练数据投毒、LLM04 模型拒绝服务、LLM05 供应链漏洞、LLM06 敏感信息泄露、LLM07 不安全插件设计、LLM08 过度代理、LLM09 过度依赖、LLM10 模型窃取。以下护栏体系对标上述威胁类别,确保无盲区覆盖。
安全护栏不篡改模型推理逻辑,在请求流转全链路设置多层关卡,覆盖隐私、攻击、权限、行业强监管需求:
2.3 结构化输出强制约束+多级容错兜底
针对模型输出格式混乱、字段缺失痛点,以JSON Schema强约束为核心,配套多层容错方案:
支柱三:全链路可观测支柱|撕碎AI黑盒,每一次调用可追溯、可归因、可复盘
核心定位
AI落地最大运维痛点:出现幻觉、回答错误、延迟突增、成本失控时,无法定位根因——分不清是知识库、检索、路由还是模型问题。全链路可观测体系搭建四层监控+全链路Trace追踪,实现会话一键回放、故障精准定位。 核心价值:让AI每一步动作透明可见,故障根因无处藏匿。
3.1 四层完整监控指标体系
3.2 全链路Trace追踪与工具选型
完整记录单次会话全流程:用户提问→查询改写→检索召回→LLM推理→工具调用→最终输出,留存每一步输入输出、耗时、参数,支持会话完整回放复现线上问题。
⚠️ 落地避坑提醒:大规模线上业务必须配置Trace数据生命周期自动清理策略,避免存储成本无限膨胀。
3.3 精细化成本管控闭环
只统计Token消耗远远不足以控制成本,搭建多维度成本管控体系:
💰 成本优化策略矩阵(六大杠杆,按实施难度排序):
| 语义缓存(Semantic Cache) | 30-60% | ⭐ | FAQ、高频重复查询 |
| Prompt压缩(LLMLingua/TokenBuffer) | 20-40% | ⭐⭐ | 长文档RAG、多轮对话 |
| 小模型替代(GPT-4o-mini→Qwen-7B) | 50-80% | ⭐⭐ | 分类、提取、摘要等原子任务 |
| 批处理异步化 | 30-50% | ⭐⭐ | 离线评测、日志分析、数据清洗 |
| 模型蒸馏(Teacher→Student) | 60-90% | ⭐⭐⭐ | 高频专用任务,可接受轻微精度损失 |
| 投机解码(Speculative Decoding) | 延迟↓50-70% | ⭐⭐⭐ | 高并发流式输出场景 |
建议按"先缓存→后压缩→再小模型→最后蒸馏"的顺序渐进式降本,每一阶段量化验证不损害核心业务指标。
3.4 告警收敛+自动化自愈
监控不只是采集指标,更要实现问题自动处置: 分级告警推送机制(P2-P1-P0三级):P2(轻微波动)→ 企业微信/钉钉/飞书群消息通知;P1(严重故障)→ On-call工程师电话通知,5分钟未确认自动升级;P0(致命故障)→ 自动触发熔断回滚并同步通知技术负责人。配套自动化自愈动作:延迟突增自动扩容网关、模型报错切换备用节点、向量索引异常触发重建。
支柱四:持续进化支柱|搭建业务数据驱动的AI质量飞轮,驱动系统持续自我进化
核心定位
绝大多数AI系统上线即停滞,反馈与优化链路完全割裂,准确率持续下滑、用户信任流失。持续进化支柱打通线上反馈、运行故障、知识库更新全闭环,让系统从真实业务数据中持续自我迭代。 核心价值:把每一次线上真实交互,转化为AI持续进化的训练养分。
4.1 人机协同反馈闭环 Human-in-the-Loop——样本活水源头
同步采集正负向两类会话样本,配套人工清洗流程过滤脏数据:
4.2 Agent三阶段质量飞轮(源自 Google Cloud MLOps 实践框架)
形成持续运转的循环迭代链路,杜绝零散、无规划的碎片化优化:
4.3 知识库自动化巡检与动态治理
RAG效果高度依赖知识库新鲜度,搭建常态化自动化巡检流水线:
Multi-Agent多智能体协作——2026年不可忽视的架构升级
2026年,AI应用正在从"单Agent全能"走向"多Agent分工协作"。当业务复杂度跨越某个阈值(如需要并行处理多数据源、多工具链协同、多角色博弈验证),单Agent架构的局限开始凸显——上下文窗口拥挤、指令冲突、单点故障。Multi-Agent协作成为必然选择。
核心协作模式
行业标准化协议(2025-2026)
| MCP | Model Context Protocol(Anthropic) | Agent与外部工具/数据源的统一连接协议 |
| A2A | Agent-to-Agent Protocol(Google) | Agent间互通协作的标准化通信协议 |
| AG-UI | Agent-User Interaction Protocol(CopilotKit) | Agent与用户界面交互协议 |
主流开源框架对比
| LangGraph | 状态图驱动,可控性强 | 复杂多步骤Agent流程 |
| CrewAI | 角色定义清晰,上手快 | 内容创作、研究报告类任务 |
| AutoGen(微软) | 对话驱动,多Agent自然交互 | 需要Agent间动态协商的场景 |
| Dify | 低代码可视化编排 | 非开发人员参与Agent搭建 |
| MetaGPT | SOP驱动,模拟软件公司 | 代码生成、项目规划类任务 |
⚠️ 落地提醒:Multi-Agent不是银弹。每增加一个Agent,链路复杂度、延迟、Token成本都线性增长。建议先精简单Agent到极致,只在单Agent确实无法覆盖时才引入多Agent架构。判断标准:单Agent上下文占用>80%、工具调用>5类、或需要独立角色博弈验证时才拆分。
三、四大支柱总览速查表
| 质量保障支柱 | 迭代效果可量化、变更风险全隔离 | 分层Golden评测基线、Prompt工程化管理、CI自动化回归、分阶段灰度发布、知识库数据巡检 | 凭主观体感上线、效果退化无法感知、线上故障无法快速回滚 | L1 无评测→L2 有评测集→L3 CI自动化→L4 灰度+熔断→L5 全自动飞轮 |
| 运行时韧性支柱 | 抹平模型不确定性,提供稳定标准化服务 | LLM统一网关混合调度、OWASP LLM安全护栏、结构化输出约束、多级容灾降级、语义缓存 | 模型输出随机不稳定、单一厂商API故障全线瘫痪、隐私合规泄露、下游解析报错 | L1 直连API→L2 单模型封装→L3 多模型路由→L4 多层安全护栏→L5 全自动容灾自愈 |
| 全链路可观测支柱 | 撕碎AI黑盒,故障根因快速定位 | 四层指标监控、全链路Trace追踪、多维度成本拆分、告警收敛+自愈联动 | AI流程全黑盒、问题无从排查、成本无管控、资源瓶颈无法提前预警 | L1 无监控→L2 基础延迟/QPS→L3 全链路Trace→L4 成本分拆→L5 告警自愈自动化 |
| 持续进化支柱 | 业务流量驱动系统持续自我优化 | 正负向人机反馈闭环、三阶段质量飞轮、知识库自动化巡检 | 上线后系统静态僵化、缺少真实业务迭代数据源、知识库信息陈旧失效 | L1 无反馈→L2 人工收集反馈→L3 自动沉淀样本→L4 离线评测闭环→L5 在线质量飞轮 |
四、企业落地必备三大底层底座(上层四大支柱的承载根基)
四大支柱是AI上层业务运行体系,想要完整落地,必须先搭建底层支撑底座,否则所有工程化能力都是空中楼阁。
4.1 数据工程底座(RAG效果的根本来源)
4.2 MLOps/LLMOps模型全生命周期管理
💡 LLMOps vs 传统MLOps:传统MLOps聚焦训练-部署-监控流水线,重点关注模型精度和特征漂移;LLMOps还需额外管理 Prompt版本、非确定性输出质量、在线人类反馈(RLHF)、Token成本——这是一套新的工程范式。
4.3 基础设施+国产化适配底座
基础设施底座
K8s容器弹性扩缩容、同步/异步任务队列隔离、跨可用区容灾备份;跨角色协作规范、AI上线准入门禁、项目ROI量化评估体系。
💡 国产化落地适配要点(国内开发者重点关注)
国内政企项目普遍强制数据不出内网,整套工程体系必须适配国产软硬件栈:
五、企业落地高频踩坑清单(收藏备用)
六、新手落地阶段路线图(含建议周期与资源投入)
💡 阅读提示:下表给出"精益托管"与"全自建/政企"双轨团队配置。2026 年大量 AI SaaS 工具(LangFuse Cloud、Pinecone Serverless、LiteLLM Cloud、Dify Cloud 等)已成熟,小团队可借助托管服务跳过大量基础设施建设,将人力集中在核心业务逻辑上。团队规模数字指总人数,非专职角色数——小团队中一人多岗是常态。
| POC验证 | 1-2人(全栈工程师兼算法),依赖 OpenAI API / 通义千问 API + LangChain/LlamaIndex 快速搭建 | 同左(此阶段尚无必要自建基础设施) | 2-4周 | 基础RAG服务、业务可行性报告 | 核心场景端到端跑通,关键指标达到业务最低可接受阈值 |
| 小规模内测 | 2-3人(1全栈+1评测/安全,或1人兼任),评测用 RAGAS + LangFuse Cloud,安全用 LLM Guard 开源库 | 3-5人(+评测工程师+安全工程师),需自行搭建评测流水线与私有化护栏 | 1-2月 | 评测基线Golden Set(50-200条)、安全护栏、影子验证模式 | 评测体系就绪、安全拦截率>95%、内部用户问题解决率>80%且NPS≥30 |
| 正式生产上线 | 3-5人(+1后端/SRE),网关用 LiteLLM Cloud/One API,监控用 LangFuse Cloud,向量库用 Pinecone/Qdrant Cloud | 5-8人(+SRE+网关工程师+向量库DBA),所有组件私有化部署 | 2-4月 | LLM网关、全链路Trace、灰度发布体系、限流缓存 | 金丝雀灰度验证通过、P99延迟<业务SLA、熔断机制就绪 |
| 规模化迭代 | 5-8人(全栈×2+评测+安全+后端/SRE),持续借助托管工具链,人力投入到模型微调与质量飞轮 | 8-12人(全职能团队),完整自建LLMOps流水线+GPU集群运维 | 持续优化 | 质量飞轮闭环、知识库自动化巡检、完整LLMOps | 数据飞轮运转、月迭代至少2轮、成本/效果持续优化 |
⚠️ 关键现实:以上"精益路线"人数是 2026 年依托成熟 AI 基础设施可实现的最小配置。若公司总技术团队不足 5 人,建议将 POC-内测-上线三个阶段压缩在一个季度内完成,优先用托管服务承接流量,待业务验证 PMF 后再逐步自建替代。小团队的核心原则:能用 SaaS 的绝不自建,能复用的绝不重写,人力砸在业务壁垒上,不砸在基础设施上。
💡 常见误判:很多团队按"2周POC→直接上线"的节奏推进,跳过了内测阶段的安全护栏和评测基线建设,上线后故障频发。每一阶段的准入标准比时间更重要——宁可推迟,不可裸奔。
七、总结
很多研发团队陷入思维误区:只要拥有顶尖大模型、精巧Prompt、基础RAG能力,就能稳定落地商用AI。 走过上百家企业AI落地项目后,能清晰看到一条分水岭:短期Demo比拼算法效果,长期商业化比拼工程化底盘。
没有工程化体系的团队依靠主观感受判断迭代好坏,而你通过自动化评测流水线直接拿到量化对比数据; 传统做法因单一模型厂商API宕机导致全线停服,而你的LLM网关秒级切换备用线路,业务无感; 缺乏反馈闭环的团队人工逐条梳理差评优化模型,而你的质量飞轮自动完成样本采集、评测、迭代全闭环。
算法定义AI的能力天花板,工程化守住AI的商用生命线。
算法决定AI能飞多高,工程化决定AI能飞多久。商业落地场景下,长久稳定、合规可控、低成本可持续,远比单次惊艳的演示效果更有价值。
互动交流
本文结合一线落地实践,完整梳理大模型Agent/RAG从实验室Demo到规模化生产的整套AI工程化体系,覆盖评测、网关、监控、迭代全链路实战方法论。 如果你在企业落地RAG/智能体时遇到稳定性差、成本失控、迭代效果退化、合规难落地等问题,欢迎在评论区交流你的项目场景; 需要四大支柱架构简图、CI评测流水线伪代码、LLM网关配置示例的朋友可以留言,我后续补充配套实战代码篇。
🎯 更多专栏系列文章可以查看博客主页📑 👍 若文章对你有所触动,恳请点赞 ⭐ 关注 ⭐ 收藏