文章目录
- ELFK + kafka 架构部署
-
- 架构简介
- kafka简介
- Kafka 如何工作
- Kafka 概念及基本术语
- Kafka 的 KRaft( Kafka Raft )模式
- 集群部署
-
- 添加解析
- 三台主机安装 JDK 环境
- 三台主机安装 Kafka
- 三台主机 Kafka 配置文件修改
- Kafka 集群初始化
-
- server6 节点生成储目录唯一的 UUID
- 三台主机用该 uuid 格式化 kafka 存储目录
- 三台节点启动 Kafka
- Kafka 集群可用性验证
-
- Kafka 集群任意节点创建 Topic
- Kafka 集群任意节点查看 Topic
- Kafka 集群任意节点生产者测试
- Kafka 集群任意节点查看主题
- Kafka 集群任意节点查看 topic 详细信息
- Filebeat 配置文件修改
-
- Kafka 集群任意节点消费者测试
- Logstash 消费 Topic 消息
ELFK + kafka 架构部署
架构简介
E(Elasticsearch)、L(Logstash)、F(FIlebeat)、K(Kibana)
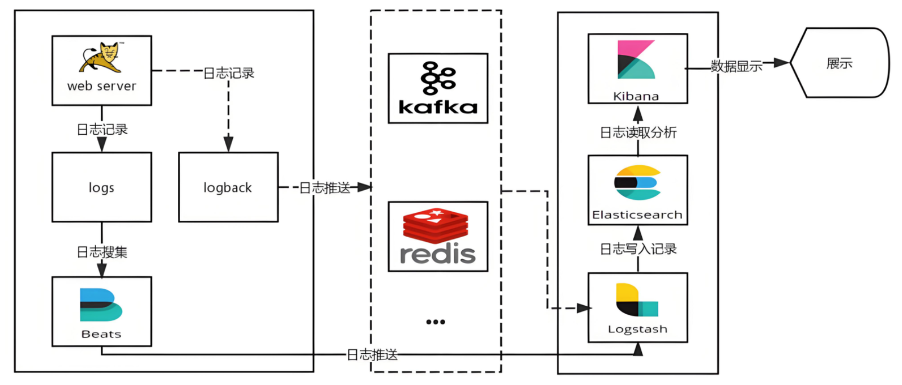
流程示意图:
业务服务器日志 → Filebeat(采集)→ Logstash(处理)→ Elasticsearch(存储/检索)→ Kibana(可视化)
-
定位:轻量级日志采集工具(Beats 家族成员),部署在日志产生的服务器上。
-
核心作用:
- 实时监控指定日志文件(如应用日志、系统日志、Nginx 日志等),支持日志轮转、多文件匹配。
- 轻量低耗(资源占用远低于 Logstash),适合在生产服务器批量部署。
- 将采集到的日志初步整理后,发送到 Logstash(用于复杂处理)或直接发送到 Elasticsearch(简单场景)。
-
定位:日志过滤与转换引擎,是 ELFK 中的 “数据加工厂”。
-
核心作用:
- 接收 Filebeat 发送的原始日志,进行结构化处理(如解析非 JSON 日志、提取关键字段)。
- 支持数据清洗(过滤无用字段、脱敏敏感信息)、格式转换(如统一时间戳格式)、数据 enrichment(关联外部数据)。
- 将处理后的结构化日志转发到 Elasticsearch 存储。
-
定位:分布式全文搜索引擎,负责日志的存储、索引与快速检索。
-
核心作用:
- 以 JSON 格式存储结构化日志,通过分片和副本机制实现高可用与高吞吐。
- 基于倒排索引支持秒级全文检索,可按关键词、时间范围、字段条件快速筛选日志。
- 支持水平扩展,通过增加节点提升存储容量和检索性能。
-
定位:Elasticsearch 的可视化前端工具,提供日志分析与展示界面。
-
核心作用:
- 通过 Web 界面连接 Elasticsearch,支持日志实时查询、筛选、导出。
- 提供丰富的可视化组件(如折线图、柱状图、饼图、仪表盘),可自定义监控面板(如系统错误率、接口访问量趋势)。
- 支持创建告警规则,当日志中出现异常模式(如错误日志激增)时触发告警。
在 ELFK 架构中加入 Kafka 后,通过 Kafka 作为日志传输的中间缓冲层,解决高并发场景下日志峰值冲击、组件解耦、异步处理等问题,使架构更稳定、可扩展。
流程示意图:
Filebeat(采集)→ Kafka(缓冲)→ Logstash(处理)→ Elasticsearch(存储)→ Kibana(可视化)
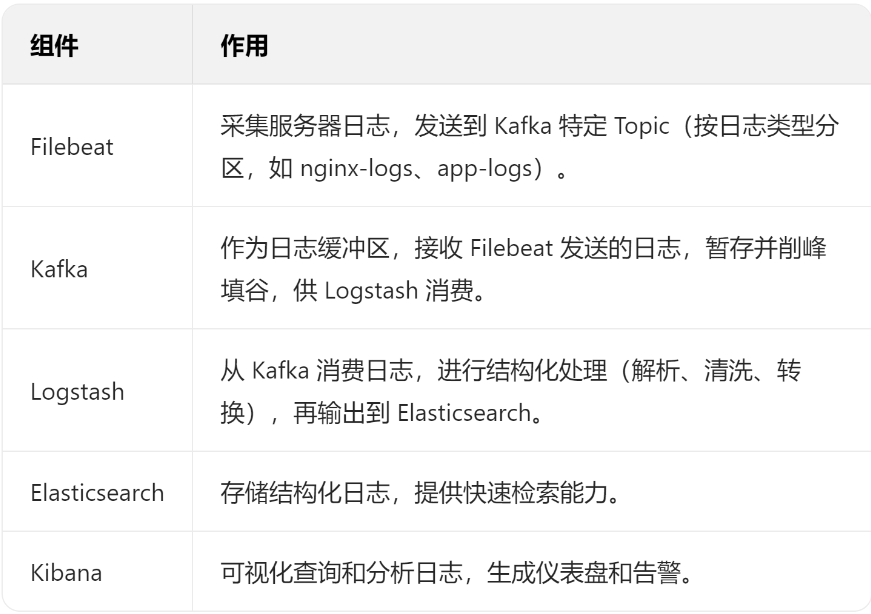
加入 Kafka 的核心优势
-
削峰填谷,应对日志峰值
- 当业务突发流量导致日志量激增(如秒杀活动、系统故障时的错误日志爆发),Kafka 可暂存大量日志,避免直接冲击 Logstash 或 Elasticsearch 导致组件过载。Logstash 可按自身处理能力从 Kafka 消费,保证下游组件稳定。
-
解耦组件,提升架构灵活性
- Filebeat 仅需关注日志采集并发送到 Kafka,无需关心后续处理组件(Logstash 可独立升级或替换)。
- 除 Logstash 外,其他系统(如 Flink 实时计算、数据仓库)可同时从 Kafka 消费日志,实现日志的多目的地分发(一份日志供多个场景使用)。
-
异步处理,提高系统吞吐量
- 日志流转从 “同步链路”(Filebeat → Logstash → ES)变为 “异步缓冲”(Filebeat → Kafka 异步写入,Logstash 异步消费),减少组件间的直接依赖,提升整体吞吐量。
-
日志可靠性保障
- Kafka 支持消息持久化和多副本机制(replication-factor ≥ 2),即使 Logstash 或 ES 短暂故障,日志也不会丢失,待下游恢复后可继续消费。
kafka简介
官网:https://kafka.apache.org/
Apache Kafka 是一个事件流平台。
-
发布(写入)和订阅(读取)事件流,包括从其他系统持续导入/导出数据。
-
根据需要持久可靠地存储事件流。
-
在事件流发生时或回顾性地处理它们。
所有这些功能都以分布式、高度可扩展、弹性、容错且安全的方式提供。Kafka 可以部署在裸机硬件、虚拟机和容器上,也可以部署在本地和云端。
Kafka 如何工作
Kafka 是一个分布式系统,由服务器和客户端组成,通过高性能TCP 网络协议进行通信。
服务器:Kafka 由一台或多台服务器组成集群运行,这些服务器可以跨越多个数据中心或云区域。其中一些服务器构成存储层,称为代理 (broker)。其他服务器运行 Kafka Connect,以事件流的形式持续导入和导出数据,从而将 Kafka 与现有的系统(例如关系数据库)以及其他 Kafka 集群集成。为了帮助实现关键任务用例,Kafka 集群具有高度的可扩展性和容错能力:如果其中任何一台服务器发生故障,其他服务器将接管其工作,以确保持续运行且不会丢失任何数据。
客户端:允许编写分布式应用程序和微服务,以便能够并行、大规模地读取、写入和处理事件流,并且即使在网络问题或机器故障的情况下也能保持容错能力。Kafka 内置了一些客户端,此外, Kafka 社区还提供了数十个客户端,包括 Java 和 Scala 客户端(包括更高级别的 Kafka Streams库),以及 Go、Python、C/C++ 和许多其他编程语言的客户端,以及 REST API。
Kafka 概念及基本术语
-
事件记录了世界上或业务中“发生的事情”。在文档中,也被称为记录或消息。向 Kafka 读取或写入数据时,是以事件的形式进行的。从概念上讲,事件包含键、值、时间戳和可选的元数据标头。以下是一个示例事件:
- 事件键:“爱丽丝”
- 事件值:“向鲍勃支付 200 美元”
- 事件时间戳:“2020年6月25日下午2:06”
-
生产者是向 Kafka 发布(写入)事件的客户端应用程序,而消费者是订阅(读取和处理)这些事件的应用程序。在 Kafka 中,生产者和消费者完全解耦,彼此互不影响,这是 Kafka 实现其高可扩展性的关键设计元素。例如,生产者无需等待消费者。Kafka 提供了各种保证,例如“恰好一次”处理事件的能力。
-
事件被组织并持久存储在主题 (topic)中。简而言之,主题类似于文件系统中的文件夹,而事件就是该文件夹中的文件。例如,主题名称可以是“payments”。Kafka 中的主题始终支持多生产者和多订阅者:一个主题可以有零个、一个或多个向其写入事件的生产者,以及零个、一个或多个订阅这些事件的消费者。主题中的事件可以根据需要随时读取——与传统消息系统不同,主题中的事件不会在消费后被删除。相反,您可以通过每个主题的配置设置来定义 Kafka 应保留事件的时间,超过此时间后,旧事件将被丢弃。Kafka 的性能在数据大小方面实际上保持恒定,因此长期存储数据完全没问题。
-
主题是分区的,这意味着一个主题会分布在位于不同 Kafka 代理上的多个“存储桶”中。这种分布式数据放置方式对于可扩展性至关重要,因为它允许客户端应用程序同时从多个代理读取数据或向多个代理写入数据。当新事件发布到主题时,它实际上会被附加到该主题的某个分区中。具有相同事件键(例如,客户或车辆 ID)的事件会被写入同一个分区,并且 Kafka保证给定主题分区的任何消费者始终会按照写入顺序读取该分区的事件。
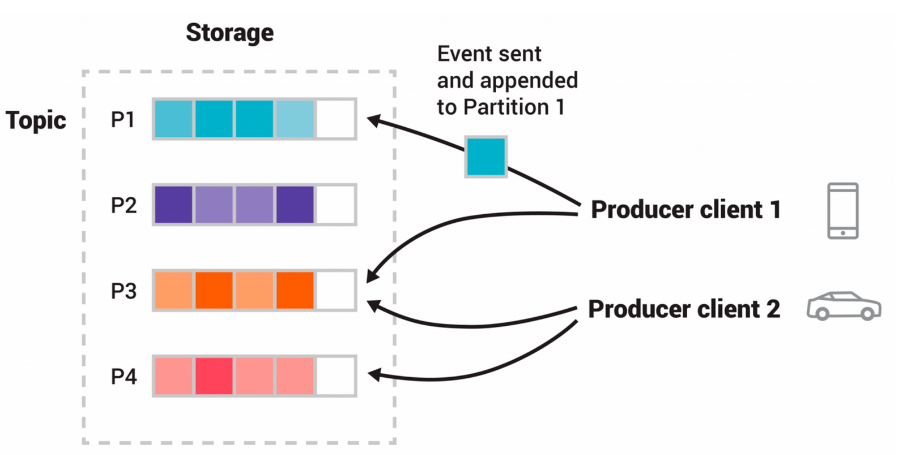
-
图:此示例主题包含四个分区 P1–P4。两个不同的生产者客户端彼此独立地通过网络将事件写入主题的各个分区,从而向主题发布新事件。具有相同键(图中以颜色表示)的事件将被写入同一分区。请注意,如果适用,两个生产者都可以写入同一分区。
-
为了确保数据容错和高可用性,每个主题都可以进行复制,甚至可以跨地理区域或数据中心进行复制。这样,在出现问题、需要对代理进行维护等情况下,始终有多个代理拥有数据副本。常见的生产环境设置是复制因子为 3,即始终有三个数据副本。此复制在主题分区级别执行。
Kafka 的 KRaft( Kafka Raft )模式
Kafka 2.8 版本首次引入去中心化集群管理模式,后在3.3版本证书生产就绪,旨在替代传统依赖 ZooKeeper 的架构。
1.去中心化元数据管理
KRaft 模式通过内置的 Raft 一致性协议实现元数据管理,不再依赖外部 ZooKeeper 集群。Controller 节点(即元数据节点)直接运行在 Kafka Broker 中,负责处理集群元数据操作(如主题创建、分区分配等),元数据存储在 Kafka 内部主题 __cluster_metadata 中。
2.角色划分
-
Controller 节点:负责元数据管理、集群成员协调、分区重分配等任务。多个 Controller 节点通过 Raft 协议选举出 Leader ,确保高可用性。
-
Broker 节点:负责消息存储、生产和消费。Broker 节点可同时作为 Controller 节点,但生产环境建议分离角色以提高隔离性。
3.Raft 协议机制
Controller 节点通过 Raft 协议维护元数据一致性。元数据变更需写入日志( __cluster_metadata ),超过阈值后生成快照,确保故障恢复时快速加载状态。
集群部署
添加解析
# vim /etc/hosts
192.168.117.136 server6
192.168.117.137 server7
192.168.117.138 server8
三台主机安装 JDK 环境
# rpm -ivh jdk-17.0.17_linux-x64_bin.rpm
# java -version
java version "17.0.17" 2025-10-21 LTS
Java(TM) SE Runtime Environment (build 17.0.17+8-LTS-360)
Java HotSpot(TM) 64-Bit Server VM (build 17.0.17+8-LTS-360, mixed mode, sharing)
三台主机安装 Kafka
官方安装包链接:https://kafka.apache.org/downloads
# tar zxf kafka_2.12-3.9.1.tgz -C /opt
# mv /opt/kafka_2.12-3.9.1 /opt/kafka
# cd /opt/kafka/config/kraft
# cp server.properties{,.bak}# 备份配置文件
# mkdir /opt/kafka/logs# 日志目录
三台主机 Kafka 配置文件修改
vim server.properties
server.properties 参数详解
# 节点角色。Kafka节点同时作为Broker和Controller运行。Controller负责集群管理,比如分区分配和Leader选举,而Broker处理消息的存储和转发。
process.roles=broker,controller
# 节点的唯一标识符,每个Broker都需要一个不同的ID,确保在集群中唯一。
node.id=136
# Controller的仲裁节点,配置了三个节点,分别是136、137和138。在选举Controller Leader时,需要这三个节点中的多数同意,确保高可用性。
controller.quorum.voters=136@192.168.117.136:9093,137@192.168.117.137:9093,138@192.168.117.138:9093
# 定义了Broker监听地址和端口。两个监听器:PLAINTEXT和CONTROLLER,分别对应不同的端口。PLAINTEXT用于普通客户端通信,CONTROLLER用于Controller之间的内部通信。
listeners=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
# 指定了Broker之间内部通信使用的监听器名称,这里是PLAINTEXT,意味着Broker之间使用明文协议通信。
inter.broker.listener.name=PLAINTEXT
# 客户端连接Broker时使用的地址,同样配置了PLAINTEXT和CONTROLLER,但客户端通常使用PLAINTEXT来连接。
advertised.listeners=PLAINTEXT://192.168.117.136:9092,CONTROLLER://192.168.117.136:9093
# Controller使用CONTROLLER监听器进行内部通信,确保Controller之间的消息传输。
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,SSL:SSL,SASL_PLAINTEXT:SASL_PLAINTEXT,SASL_SSL:SASL_SSL
# 处理网络请求的最大线程数
num.network.threads=32
# 处理I/O请求的线程数
num.io.threads=32
# TCP发送和接收缓冲区的大小,通常设置为102400字节。
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
# 限制了单个请求的最大大小,防止内存溢出,此处为100MB。
socket.request.max.bytes=104857600
# 指定日志存储的目录
log.dirs=/opt/kafka/logs
# 默认的分区数,新建Topic时如果没有指定,会使用这个值,影响并行处理能力。
num.partitions=3
# 控制日志恢复时的线程数,每个数据目录一个线程,加快恢复速度。
num.recovery.threads.per.data.dir=1
# 确保偏移量和事务日志的高可用性,副本数设为3,容忍两个节点故障。
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
# 设置事务日志的最小同步副本数,保证至少有一个副本同步完成。
transaction.state.log.min.isr=1
# 允许删除Topic,但需谨慎使用。
delete.topic.enable=true
# 控制日志保留策略,按时间和大小删除旧数据。
log.retention.hours=168
log.retention.bytes=1073741824
# 涉及生产者和消费者的性能调优,比如批量消息大小和内存缓冲区。
buffer.memory=68719476736
batch.size=2097152
max.request.size=4194304
message.max.bytes=6291456
fetch.max.bytes=7340032
linger.ms=10
compression.type=snappy
log.segment.bytes=1073741824
log.retention.check.interval.ms=300000
server6配置文件修改
# vim server.properties
process.roles=broker,controller
node.id=136
controller.quorum.voters=136@192.168.117.136:9093,137@192.168.117.137:9093,138@192.168.117.138:9093
listeners=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
inter.broker.listener.name=PLAINTEXT
advertised.listeners=PLAINTEXT://192.168.117.136:9092,CONTROLLER://192.168.117.136:9093
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,SSL:SSL,SASL_PLAINTEXT:SASL_PLAINTEXT,SASL_SSL:SASL_SSL
num.network.threads=2
num.io.threads=2
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/kafka/logs
num.partitions=3
num.recovery.threads.per.data.dir=1
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=1
log.retention.hours=168
log.segment.bytes=1073741824
log.retention.check.interval.ms=300000
server7配置文件修改
# vim server.properties
process.roles=broker,controller
node.id=137
controller.quorum.voters=136@192.168.117.136:9093,137@192.168.117.137:9093,138@192.168.117.138:9093
listeners=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
inter.broker.listener.name=PLAINTEXT
advertised.listeners=PLAINTEXT://192.168.117.137:9092,CONTROLLER://192.168.117.137:9093
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,SSL:SSL,SASL_PLAINTEXT:SASL_PLAINTEXT,SASL_SSL:SASL_SSL
num.network.threads=2
num.io.threads=2
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/kafka/logs
num.partitions=3
num.recovery.threads.per.data.dir=1
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=1
log.retention.hours=168
log.segment.bytes=1073741824
log.retention.check.interval.ms=300000
server8配置文件修改
# vim server.properties
process.roles=broker,controller
node.id=138
controller.quorum.voters=136@192.168.117.136:9093,137@192.168.117.137:9093,138@192.168.117.138:9093
listeners=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
inter.broker.listener.name=PLAINTEXT
advertised.listeners=PLAINTEXT://192.168.117.138:9092,CONTROLLER://192.168.117.138:9093
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,SSL:SSL,SASL_PLAINTEXT:SASL_PLAINTEXT,SASL_SSL:SASL_SSL
num.network.threads=2
num.io.threads=2
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/kafka/logs
num.partitions=3
num.recovery.threads.per.data.dir=1
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=1
log.retention.hours=168
log.segment.bytes=1073741824
log.retention.check.interval.ms=300000
Kafka 集群初始化
server6 节点生成储目录唯一的 UUID
[root@server6 kraft]# KAFKA_CLUSTER_ID="$(/opt/kafka/bin/kafka-storage.sh random-uuid)"
[root@server6 kraft]# echo ${KAFKA_CLUSTER_ID}
kR95Kc0-SR63GpUAICA_xg
三台主机用该 uuid 格式化 kafka 存储目录
[root@server6 kraft]# /opt/kafka/bin/kafka-storage.sh format -t kR95Kc0-SR63GpUAICA_xg -c /opt/kafka/config/kraft/server.properties
[root@server7 kraft]# /opt/kafka/bin/kafka-storage.sh format -t kR95Kc0-SR63GpUAICA_xg -c /opt/kafka/config/kraft/server.properties
[root@server8 kraft]# /opt/kafka/bin/kafka-storage.sh format -t kR95Kc0-SR63GpUAICA_xg -c /opt/kafka/config/kraft/server.properties
三台节点启动 Kafka
[root@server6 kraft]# /opt/kafka/bin/kafka-server-start.sh -daemon /opt/kafka/config/kraft/server.properties
[root@server6 kraft]# jps
7989 Jps
7918 Kafka
[root@server7 kraft]# /opt/kafka/bin/kafka-server-start.sh -daemon /opt/kafka/config/kraft/server.properties
[root@server7 kraft]# jps
7104 Kafka
7204 Jps
[root@server8 kraft]# /opt/kafka/bin/kafka-server-start.sh -daemon /opt/kafka/config/kraft/server.properties
[root@server8 kraft]# jps
7076 Jps
7003 Kafka
Kafka 集群可用性验证
Kafka 集群任意节点创建 Topic
[root@server6 ~]# /opt/kafka/bin/kafka-topics.sh –create –topic testtopics –bootstrap-server localhost:9092 –replication-factor 3 –partitions 3
Created topic testtopics.
–replication-factor 3:设置主题的副本因子为 3,即每个分区的副本数量为 3。副本用于数据冗余和高可用性,副本数需不能超过集群中 Broker 的总数。
–partitions 3:设置主题的分区数为 3。分区是 Kafka 并行处理消息的基本单位,影响吞吐量和扩展性。分区数一旦创建不可减少。
Kafka 集群任意节点查看 Topic
[root@server7 kraft]# /opt/kafka/bin/kafka-topics.sh –list –bootstrap-server localhost:9092
testtopics
Kafka 集群任意节点生产者测试
[root@server6 ~]# /opt/kafka/bin/kafka-console-producer.sh –broker-list localhost:9092 –topic testtopics
\\>111
\\>222
\\>333
\\>444
\\>555
Kafka 集群任意节点查看主题
[root@server8 kraft]# /opt/kafka/bin/kafka-console-consumer.sh –bootstrap-server localhost:9092 –topic testtopics –from-beginning
111
222
333
444
555
Kafka 集群任意节点查看 topic 详细信息
[root@server7 kraft]# /opt/kafka/bin/kafka-topics.sh –bootstrap-server server6:9092,server7:9092,server8:9092 –topic testtopics –describe
Topic: testtopics TopicId: UmiDboG8RUC8avSVESe_8A PartitionCount: 3 ReplicationFactor: 3 Configs: segment.bytes=1073741824
Topic: testtopics Partition: 0 Leader: 136 Replicas: 136,137,138 Isr: 136,137,138 Elr: LastKnownElr:
Topic: testtopics Partition: 1 Leader: 137 Replicas: 137,138,136 Isr: 137,138,136 Elr: LastKnownElr:
Topic: testtopics Partition: 2 Leader: 138 Replicas: 138,136,137 Isr: 138,136,137 Elr: LastKnownElr:
Filebeat 配置文件修改
https://www.elastic.co/guide/en/beats/filebeat/7.6/kafka-output.html
[root@server4 ~]# vim /etc/filebeat/filebeat.yml
#—————————– Kafka output ——————————–
output.kafka:
hosts: ["192.168.117.136:9092", "192.168.117.137:9092", "192.168.117.138:9092"]
# Kafka 集群地址
topic: "apache-logs"# 发送到的 Topic 名称
partition.round_robin:# 日志按轮询方式分发到 Topic 各分区
reachable_only: true
required_acks: 1# 至少 1 个副本确认接收(平衡可靠性和性能)
compression: gzip# 启用压缩,减少网络传输量
max_message_bytes: 1048576# 单条消息最大 1MB
[root@server4 filebeat]# filebeat test config -c /etc/filebeat/filebeat.yml
Config OK
[root@server4 filebeat]# filebeat test output -c /etc/filebeat/filebeat.yml
Kafka: 192.168.117.136:9092...
parse host... OK
dns lookup... OK
addresses: 192.168.117.136
dial up... OK
Kafka: 192.168.117.137:9092...
parse host... OK
dns lookup... OK
addresses: 192.168.117.137
dial up... OK
Kafka: 192.168.117.138:9092...
parse host... OK
dns lookup... OK
addresses: 192.168.117.138
dial up... OK
[root@server4 filebeat]# systemctl restart filebeat.service
Kafka 集群任意节点消费者测试
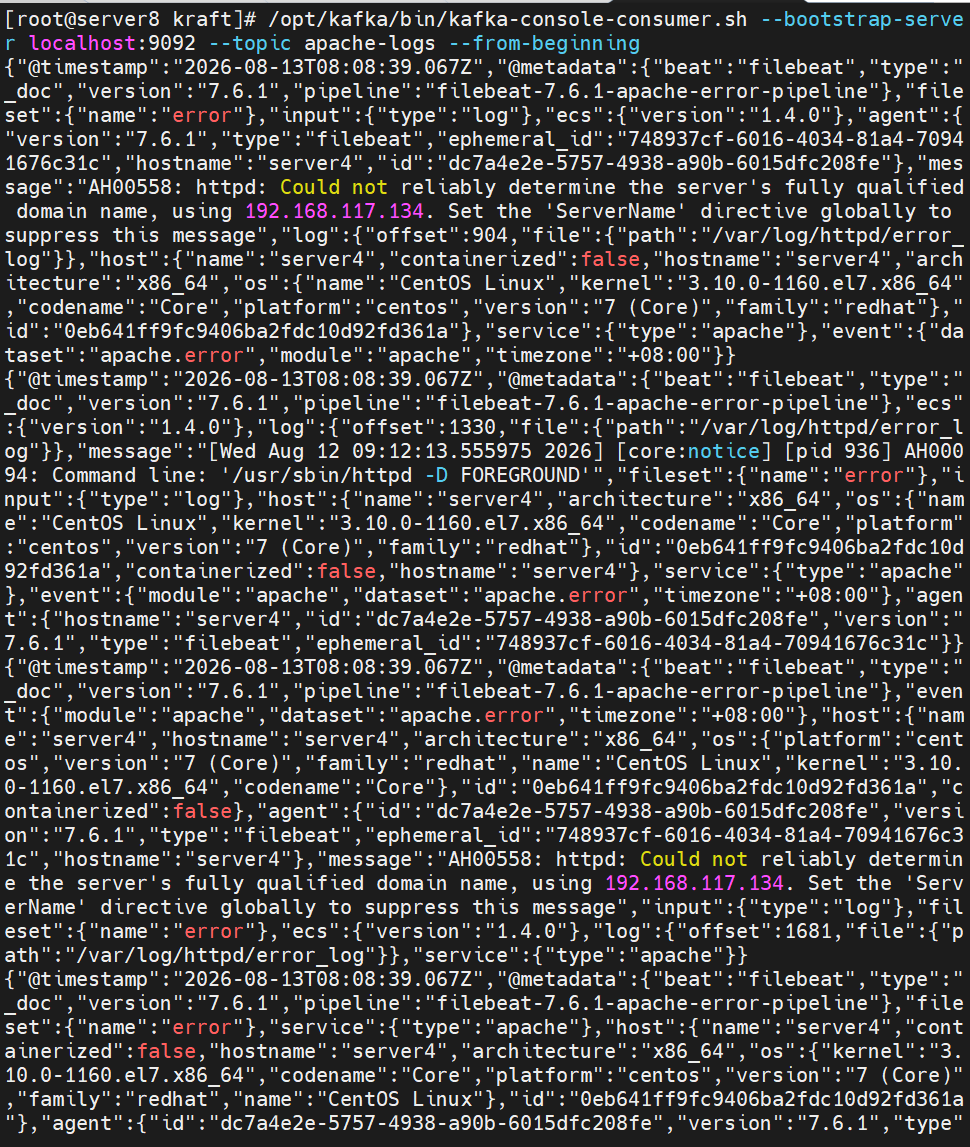
[root@server8 kraft]# /opt/kafka/bin/kafka-console-consumer.sh –bootstrap-server localhost:9092 –topic apache-logs –from-beginning
Filebeat 工作完全正常,Apache 错误日志已经被成功采集并结构化输出
Logstash 消费 Topic 消息
[root@server5 conf.d]# vim kafka.conf
input {
kafka {
bootstrap_servers => "192.168.117.136:9092,192.168.117.137:9092,192.168.117.138:9092"
topics => ["apache-logs"]# 消费的 Topic
group_id => "logstash-consumer-group"# 消费者组 ID
consumer_threads => 3# 消费线程数 = 分区数,最大化并行
auto_offset_reset => "earliest"# 从最早消息开始消费(避免丢失)
codec => "json"
}
}
filter {
grok {
match => { "message" => "%{HTTPD_COMBINEDLOG}" }
}
}
output {
#stdout {}
elasticsearch {
hosts => ["192.168.117.131:9200","192.168.117.132:9200","192.168.117.133:9200"]
index => "apachelog-%{+YYYY.MM.dd}"
user => "elastic"
password => "westos"
}
}
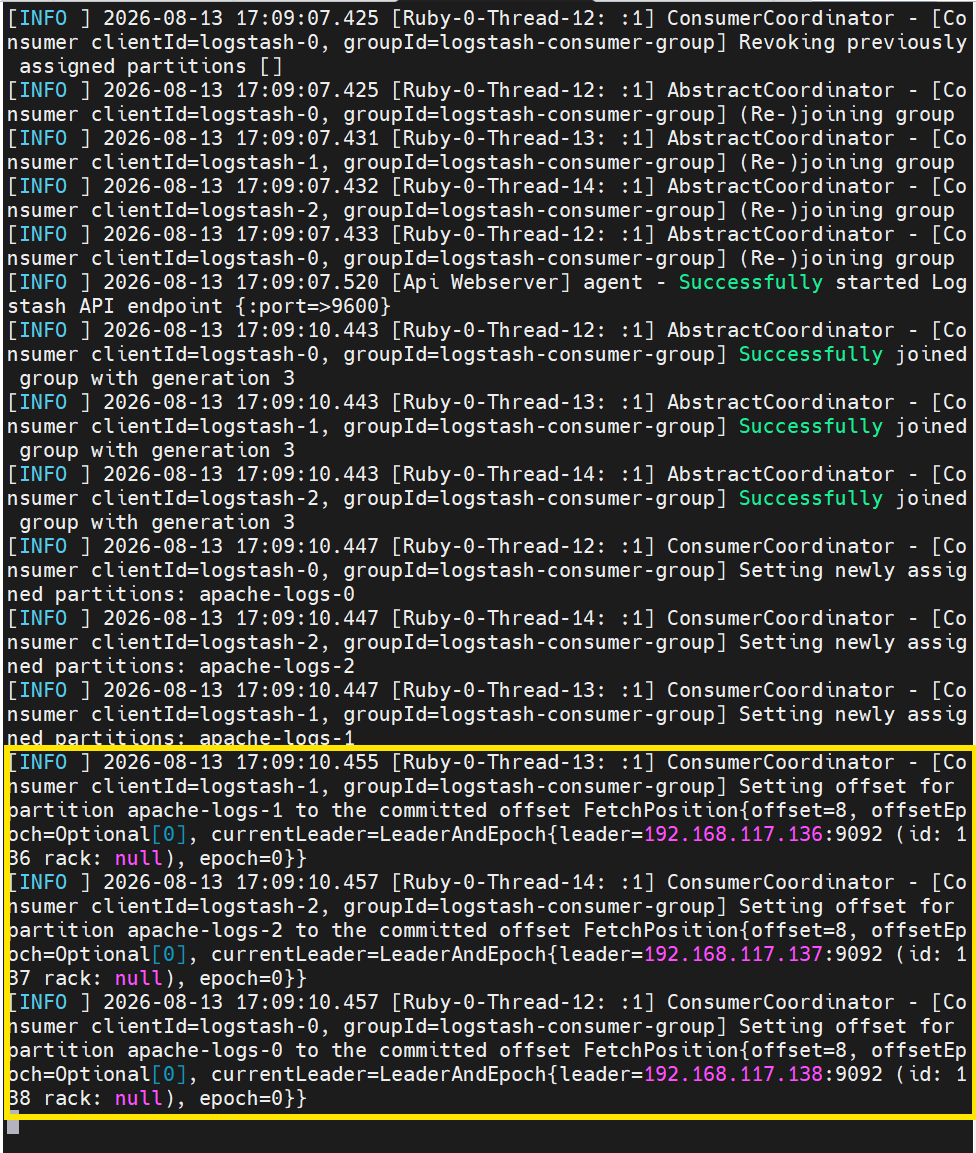
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/kafka.conf
Logstash 已成功连接到 Kafka 并开始消费数据