Python ETL 选型别被功能清单带偏
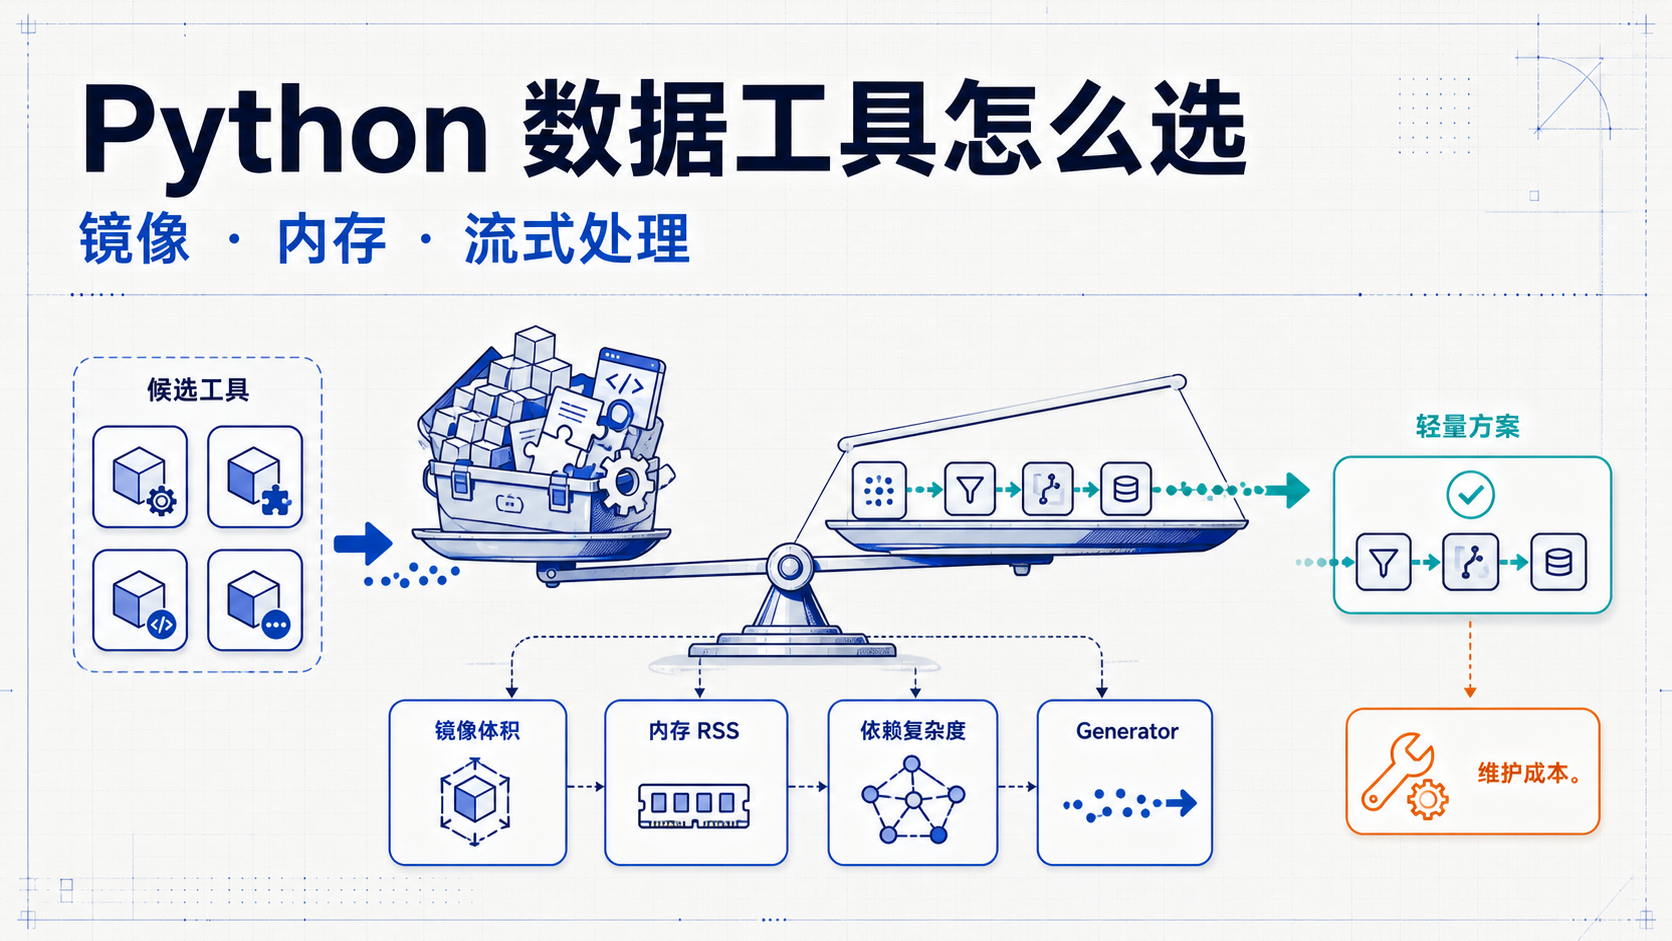
Python ETL 框架的功能清单通常很长,但项目真正会用到的往往只有读取、转换、失败重试和输出。选型时更该关注依赖体积、内存模型、流式处理和故障排查难度。
把候选方案放进同一份构建与测试脚本,用目标硬件和代表性数据复跑。样本规模按实际任务选择,不拿一组固定数字冒充通用基准。
1. 三个评估维度
第一,镜像与依赖。列出基础镜像、C 扩展、漏洞修复方式和冷启动路径,实测拉取与启动时间,而不是引用来源不明的镜像体积。
第二,内存模型。全量 DataFrame 适合部分分析任务,Generator 适合可逐条或分批处理的管线。选择取决于算法是否需要全局状态,不是“流式一定更高级”。
第三,维护成本。核对 API 稳定性、发布节奏、迁移文档、离线安装和团队经验,记录证据,不用“社区活跃”一个标签代替判断。
| 选型路线 | 镜像与依赖 | 内存特点 | 适用条件 || :— | :— | :— | :— | :— || 综合 ETL 框架 | 依候选版本实测 | 可能包含调度与状态管理 | 工作流复杂、需要现成功能 || 标准库与轻量组件 | 依构建结果实测 | 易做分批或流式处理 | 流程简单、团队愿意维护编排 || Pandas 等表格计算 | 依依赖版本实测 | 常以内存表为核心 | 数据规模和算法适合内存计算 |
2. Python 流式计时示意
以下展示基于 Python 实现的数据管线框架选型基准评测脚手架:
import time
import logging
from typing import Dict, Any, Generator
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
class ETLFrameworkSelectionBenchmarking:
def __init__(self, record_count: int = 10000):
self.record_count = record_count
def benchmark_stream_generator_pattern() -> Dict[str, Any]:
logging.info("开启轻量流式 Generator 模式基准测试…")
start_t = time.time()
# 模拟流式处理
def stream_gen() -> Generator[str, None, None]:
for i in range(10000):
yield f"log_record_{i}"
processed = 0
for item in stream_gen():
processed += 1
elapsed = time.time() – start_t
logging.info(f"流式模式处理 {processed} 条记录耗时: {elapsed*1000:.2f}ms")
return {"pattern": "Generator_Stream", "duration_ms": round(elapsed * 1000, 2), "mem_efficient": True}
if __name__ == "__main__":
bench = ETLFrameworkSelectionBenchmarking()
res = bench.benchmark_stream_generator_pattern()
print(f"选型评估结果:\\n{res}")
3. 选型评估的可观测指标
- etl_benchmark_duration_seconds: 选型测试运行耗时。
- etl_benchmark_memory_rss_bytes: 选型测试常驻集内存大小。
4. 工具选型原则
第一,优先流式轻量级(Streaming & Lightweight First)。优先选择支持 Generator 和轻量依赖的方案。
第二,关注容器镜像体积和冷启动,但阈值应来自部署环境与发布目标,不套用固定大小。
镜像大小只是结果,不是唯一目标。选型时还要核对基础镜像的维护周期、漏洞修复方式、离线安装能力和运行时依赖。把候选方案放进同一份构建脚本,比较构建耗时、冷启动和排障难度;不要只因功能列表更长就引入一套难以复现的工具链。