Checkpointer 是 LangGraph(LangChain团队开发的工作流编排框架)里负责存档的机制。它把 Agent 跑到某一步时的全部进展写进数据库,任务中断后再读出来接着跑。没有它,一个跑了 40 分钟的任务在第 39 分钟失败,可能需要从第 1 分钟重来。
如果没有它任务会怎样
假设一个自动生成报告的工作流,由六个节点串成:下载文件、解析文本、语义切分、逐段调用模型做摘要、汇总成报告、发送邮件。
前三步很快,几分钟走完,产出 420 个待摘要的文本片段。第四步要对这 420 个片段逐个调用模型,跑满需要 40 分钟左右。跑到第 318 个片段时,模型服务限流,请求失败。
这时候整个任务挂了。没有存档机制的话,重跑意味着什么:文件重新下载,文本重新解析,切分重新做,前 317 个片段的模型调用重新烧一遍钱和时间。第 318 个片段之后的内容一分钟没推进,前面 39 分钟全部作废。
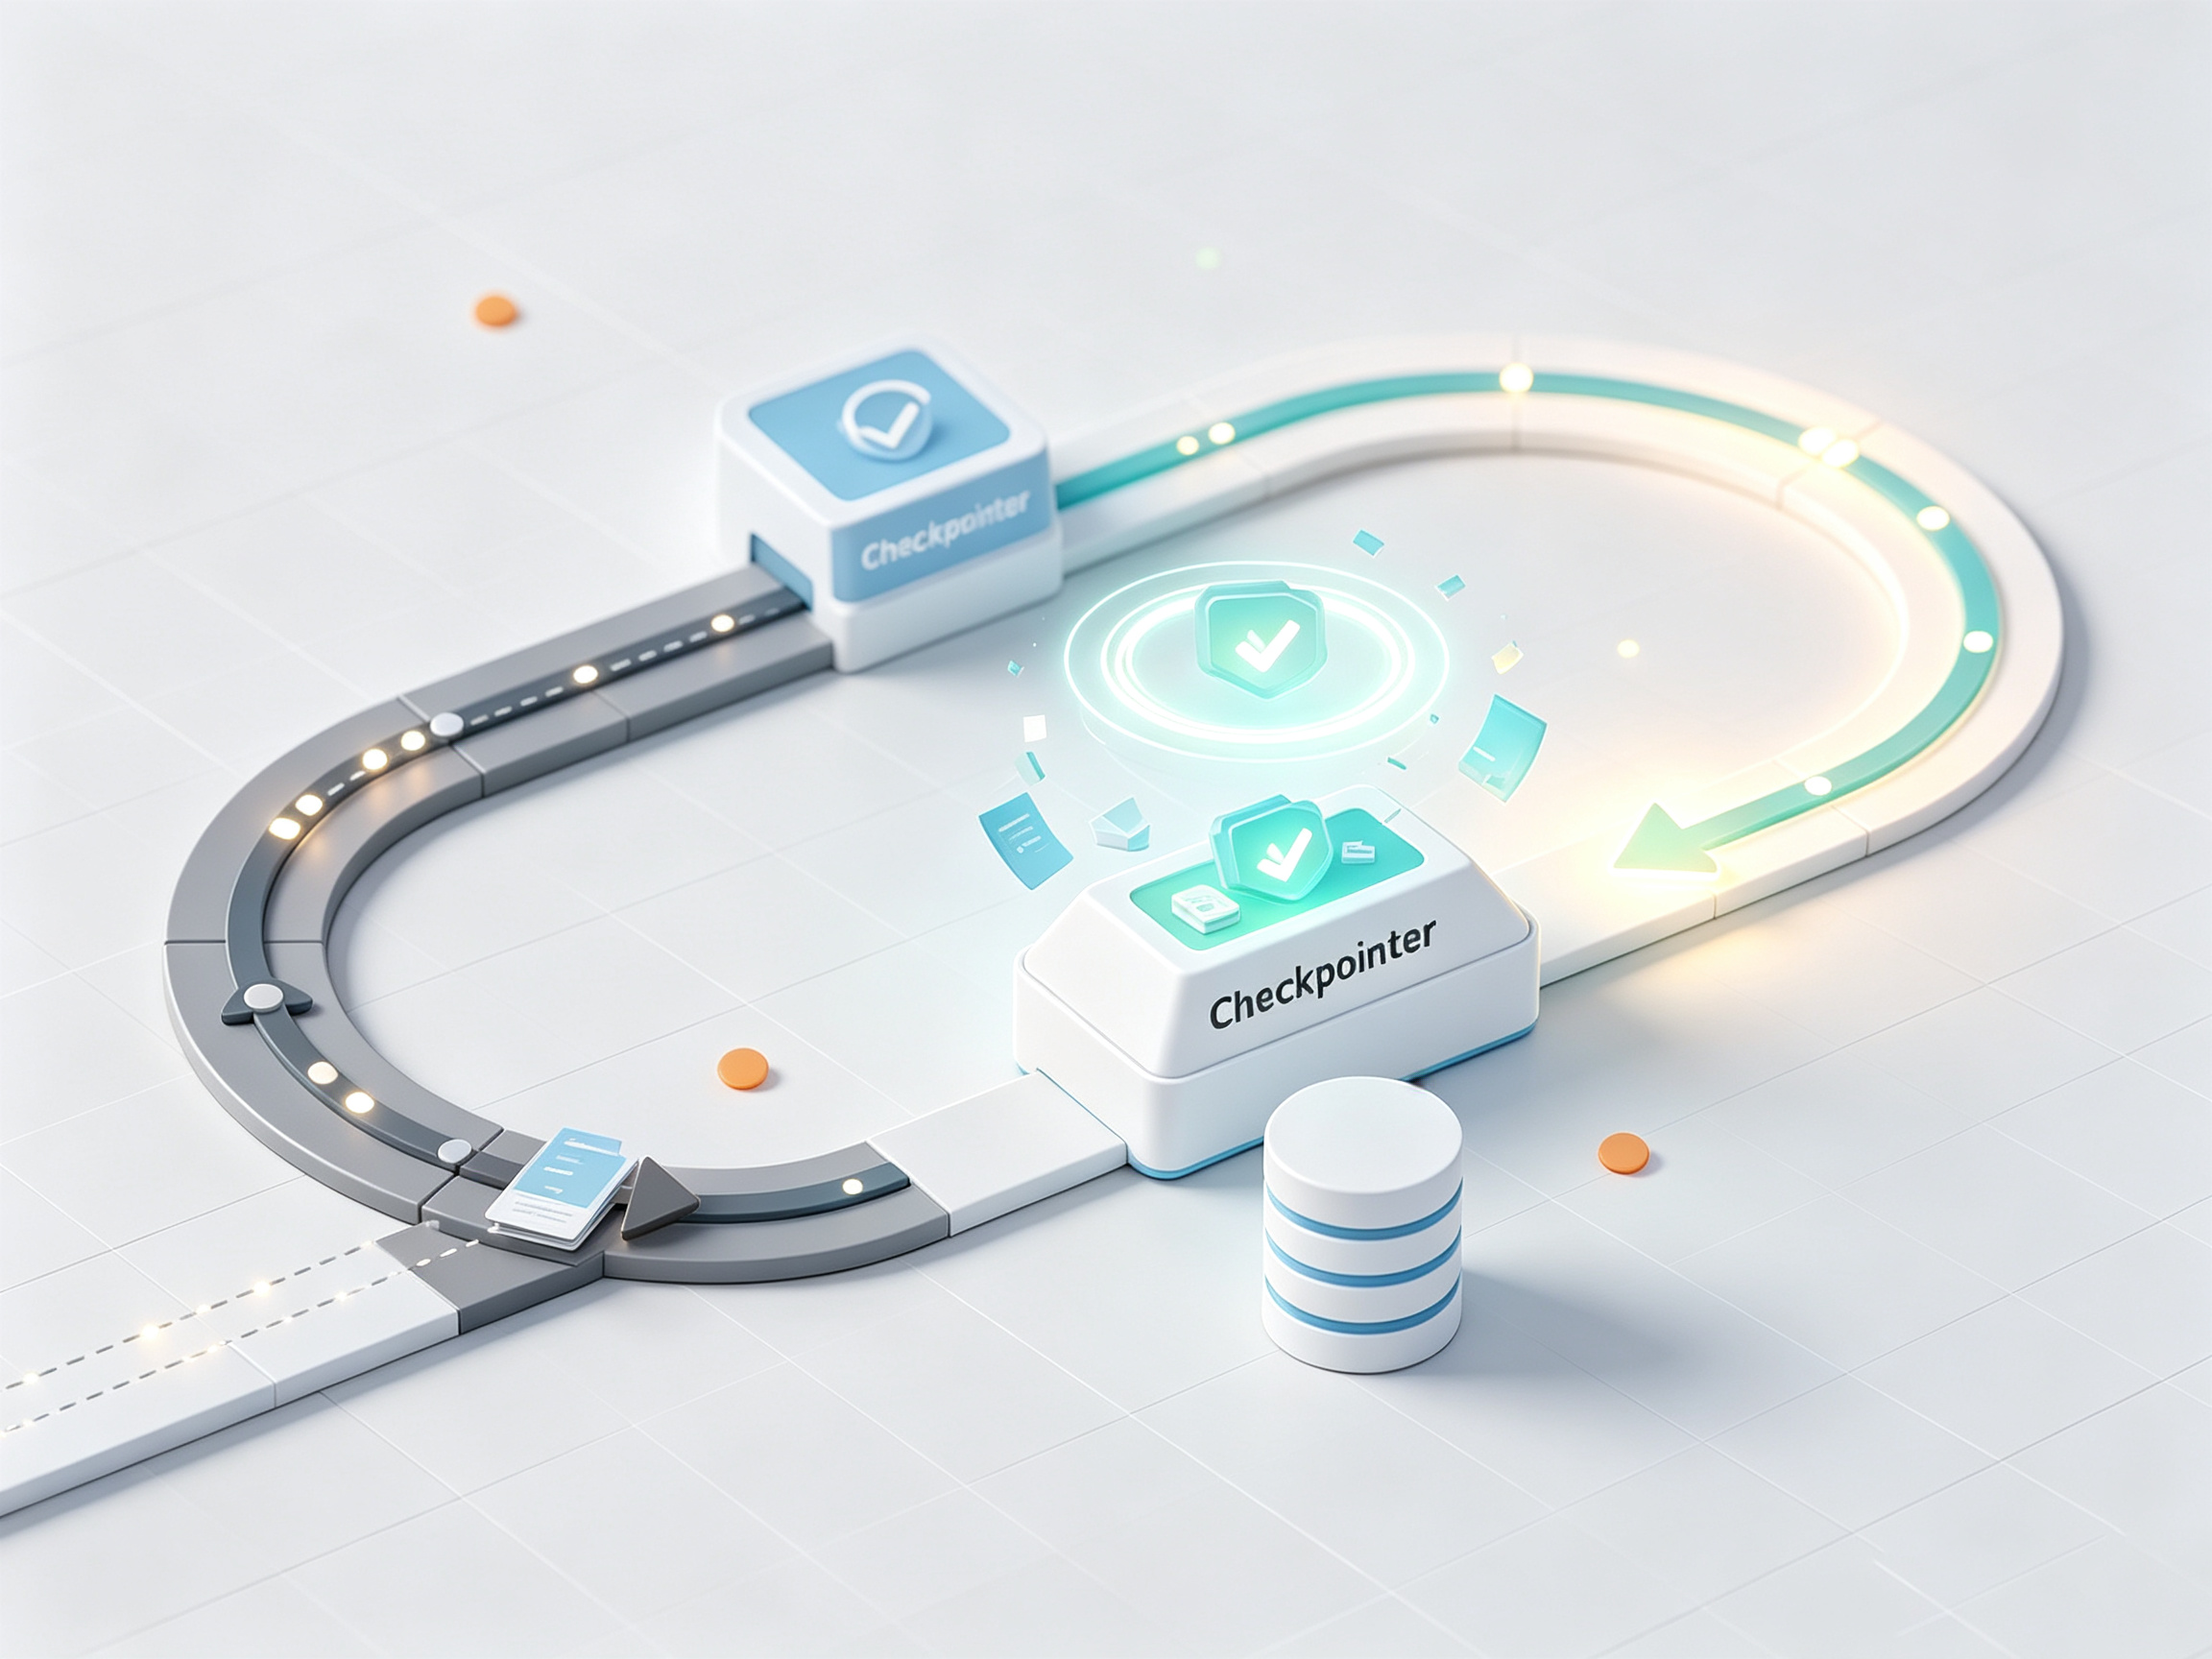
有了 Checkpointer,情形变成这样:它在第四步每处理完一个片段,就把"已完成 317 段、结果是什么"写进数据库。失败后任务被重新拉起,读回这条记录,从第 318 段继续。
长任务能否顺利接续,Checkpointer机制是重要因素之一。
它存的到底是什么
Checkpointer 写下的每条记录叫一个检查点。你可以把它理解成一份进度单,里面装有四样东西。
第一样是位置。任务当前停在第几个节点,下一步轮到谁。例子里就是"停在第四步,处理到第 318 段"。
第二样是数据。前面所有节点产出的东西,尽可能完整地保存:文件路径、解析出来的文本、420 个片段、已经完成的 317 段摘要。节点需要什么,恢复时可尽量获取。
第三样是版本号。每个字段被更新过几次,最后一次是谁改的。框架靠这个判断哪些节点的活已经干完,恢复时不重复执行它们。
第四样是待办消息。也就是哪些消息已经发出去等着下一个节点接收,但还没被处理。
检查点是追加写的,每推进一步留一条。一串检查点连起来,可形成这条任务从头到尾的完整时间线。顺着时间线往下取最新一条,能接着跑;往回翻任意一条,能看到当时那一帧的全部现场,也能从那一帧开一条新分支,换一种参数跑出另一个结果。LangGraph 管这个叫时间旅行,实际用途是复现线上问题和对比方案。
存档和读档是怎么发生的
LangGraph 把一次执行切成一轮一轮来跑,每一轮里能并行的节点同时跑,一轮结束才进下一轮,没有节点要干活了整张图就结束。Checkpointer 在每一轮结束时写一次检查点。
调用方要操心的只有一个 thread_id,也就是这条任务的编号。同一个编号的多次运行共用一条时间线,任务被重新拉起时,框架先按编号去取最新一条检查点,把数据填回状态,然后接着往下走。编号不同,就是相互独立的两条任务线。
人工确认要走另一条路。节点执行到一半可以主动抛出中断,状态就地冻结在检查点里,等外部信号到了再解冻。审批、专家修正这类环节靠这个撑住,等待时长从几小时到几天都行,因为现场已经躺在数据库里,不占进程内存。
状态写在哪里可以选。生产上可选用SQLite(嵌入式数据库)或PostgreSQL(开源关系型数据库)实现,在适用场景下,服务重启后可恢复数据。
另外一个常用接口是读写当前状态。外部系统可以取出某条任务的当前状态,改完再写回去,人工纠错通常走这条路。
长任务为什么离不开它
耗时撑不住一次调用。批量文档处理、全量数据抽取、自动化报告,几十分钟是常态。网关层的超时往往设在几十秒到几分钟,一次调用扛不下整条链路。
外部依赖随时会抖。 模型服务限流,第三方接口超时,向量库慢查询。任务跑得越久,撞上的概率越高。有存档,失败的代价是重放最近一步。
人工环节要能挂得住。前面说过,审批和修正会把任务挂起,内存里的进程等不了那么久。
排查靠现场。长任务出问题时最贵的是复现。检查点链把每一步的输入输出留着,便于跳到出事的那一帧查看。
小艾智能体的动态 Agent 编排里,这套机制对应的就是 Memory 持久化。系统可用 JSON 或 YAML 配置拼工作流,节点从文件解析、语义切分、向量化延伸至知识图谱入库和结果推送,一条自动化报告的链路会跨多个外部服务。
Checkpointer 在这里承担两件事:长链路中断后从最近的节点接着走,需要专家修正的环节挂起后还能被接回来。
持久化跟并行执行、条件路由、状态传递并列,属于编排引擎的基础能力。内置节点中的文本摘要、数据提取、代码审查、会议纪要,都属于耗时偏长且结果可重放的任务,接上持久化之后,重跑成本有望降至单个节点的量级。