标签:数字人、话术播报、数字标牌、实时推流、音视频同步、内容编排、语音控制
摘要:本文介绍一套面向私有化部署的数字人「话术播报」功能。围绕「编排一段口播话术(可挂接图片 / 视频 / 文字素材)→ 数字人按顺序自动开口播报 → 播报中可被语音实时控制」这条主线,文章从功能定位、整体架构、数据模型、内容编排、播报引擎、播报状态机与工程实践等层面展开,重点讨论话术与素材的同步展示、播放顺序管理、定向播报与循环播报、以及播报结束时的素材生命周期治理。
一、功能概览:话术播报解决什么问题
在展厅导览、数字标牌、门店大屏、直播间口播等场景中,客户需要让数字人「照着一批准备好的文案,一条接一条地播报」,并且每条文案往往还要搭配相应的画面素材(图片、视频、文字图层)。传统的做法要么依赖人工现场切换,要么做成固定的录播视频,缺乏灵活性和可维护性。
数字人「话术播报」把这件事变成一套可编排、可控制、可复用的自动化流程:
该功能的核心能力可以概括为:
| 话术编排 | 文案 + 图片/视频/文字图层,可视化编辑 | 门店大屏、展厅导览 |
| 主题管理 | 话术按主题归类,支持按主题播报 | 分栏目、分时段轮播 |
| 地址绑定 | 话术绑定到某个页面地址,语音打开该页面时定向播报 | 语音导航讲解 |
| 顺序管理 | 维护话术播放顺序,支持调整 | 编排播报脚本 |
| 循环 / 定向播报 | 整批循环播报,或指定地址 / 主题一次性播报 | 轮播 vs 点播 |
| 语音控制 | 播报中语音「开始 / 暂停 / 继续 / 休眠」 | 现场灵活控节奏 |
| 素材同步 | 话术与素材卡片严格同步,播完才清理 | 避免画面提前消失 |
这些能力共同把「一堆死的文案」变成了「一个活的、可被实时控制的数字人讲解员」。
二、整体架构:一次播报如何发生
系统按职责可划分为四个层次:内容编排层 → 服务接口层 → 播报引擎层 → 实时推流层。下图给出完整的数据流:
┌────────────────────── 内容编排层(管理端) ──────────────────────┐
│ 话术录入(文案 + 图片/视频/文字图层) │
│ 主题管理(归类、级联删除、设为当前主题) │
│ 地址映射(语音触发词 → 页面 URL / 图片文件) │
│ 话术记录列表(分页浏览、编辑、删除) │
└──────────────────────────────┬─────────────────────────────────┘
│ 结构化话术数据 + 素材 + 排序
┌──────────────────────────────▼─────────────────────────────────┐
│ 服务接口层(后端服务) │
│ 话术 CRUD / 列表分页 / 排序 / AI 生成改写 / 主题 CRUD │
│ 按 用户 / 任务 / 主题 / 绑定地址 过滤,按播放顺序返回 │
└──────────────────────────────┬─────────────────────────────────┘
│ 话术记录(含素材、排序、过滤条件)
┌──────────────────────────────▼─────────────────────────────────┐
│ 播报引擎层(后台线程) │
│ 优先级消息调度:对话 > 事件 > 话术 │
│ 空闲填充队列 → 语音合成 → 唇形推理 → 音频/视频入队 │
│ 顺序/循环/定向过滤、耗尽检测、素材同步与延迟清理 │
└──────────────────────────────┬─────────────────────────────────┘
│ 音频流 + 视频流 + 控制/素材消息
┌──────────────────────────────▼─────────────────────────────────┐
│ 实时推流层(WebRTC) │
│ 浏览器播放数字人音视频,渲染素材卡片与字幕 │
│ 语音指令 / 打断信号 回传服务端 │
└─────────────────────────────────────────────────────────────────┘
一次完整播报大致经历以下阶段:
三、数据模型设计
话术播报的数据模型围绕「话术」和「主题」两张核心表展开。
3.1 话术表
每条话术记录的核心字段如下:
| 文案正文 | 数字人实际口播的文字内容 |
| 角色 | 播报角色(如主播 / 助播),用于路由到不同音色 |
| 素材 | 关联的图片 / 视频 / 文字图层,以结构化 JSON 存储 |
| 绑定地址 | 话术绑定的页面地址;语音打开该页面时定向播报 |
| 所属主题 | 话术归属的主题;为空表示「无主题」 |
| 播放顺序 | 决定播报先后的排序字段,支持调整 |
| 类型 | 区分普通话术与特定类型(如直播脚本、PPT 话术) |
| 归属信息 | 创建人、所属任务等,用于权限与过滤 |
其中「素材」是一个关键设计点:一段话术可以挂接多个图层(图片、视频、文字),这些图层以 JSON 结构随话术一起存储,播报时被解析成可展示的卡片,做到「讲哪条、显示哪条」的同步效果。
3.2 主题表
主题用于对话术进行归类,具有以下特点:
- 全局共享:主题不按用户隔离,作为统一的内容分类维度;
- 级联删除:删除主题时,其下所有话术一并删除,避免出现「孤儿话术」;
- 条数统计:主题列表附带每个主题下的话术条数,便于管理;
- 默认主题:支持设置一个「当前播报主题」,数字人开启播报时按该主题过滤内容。
四、内容编排:从文案到可播报资产
内容编排层是运营人员与系统交互的入口,主要包含四个模块。
4.1 话术录入与素材编辑
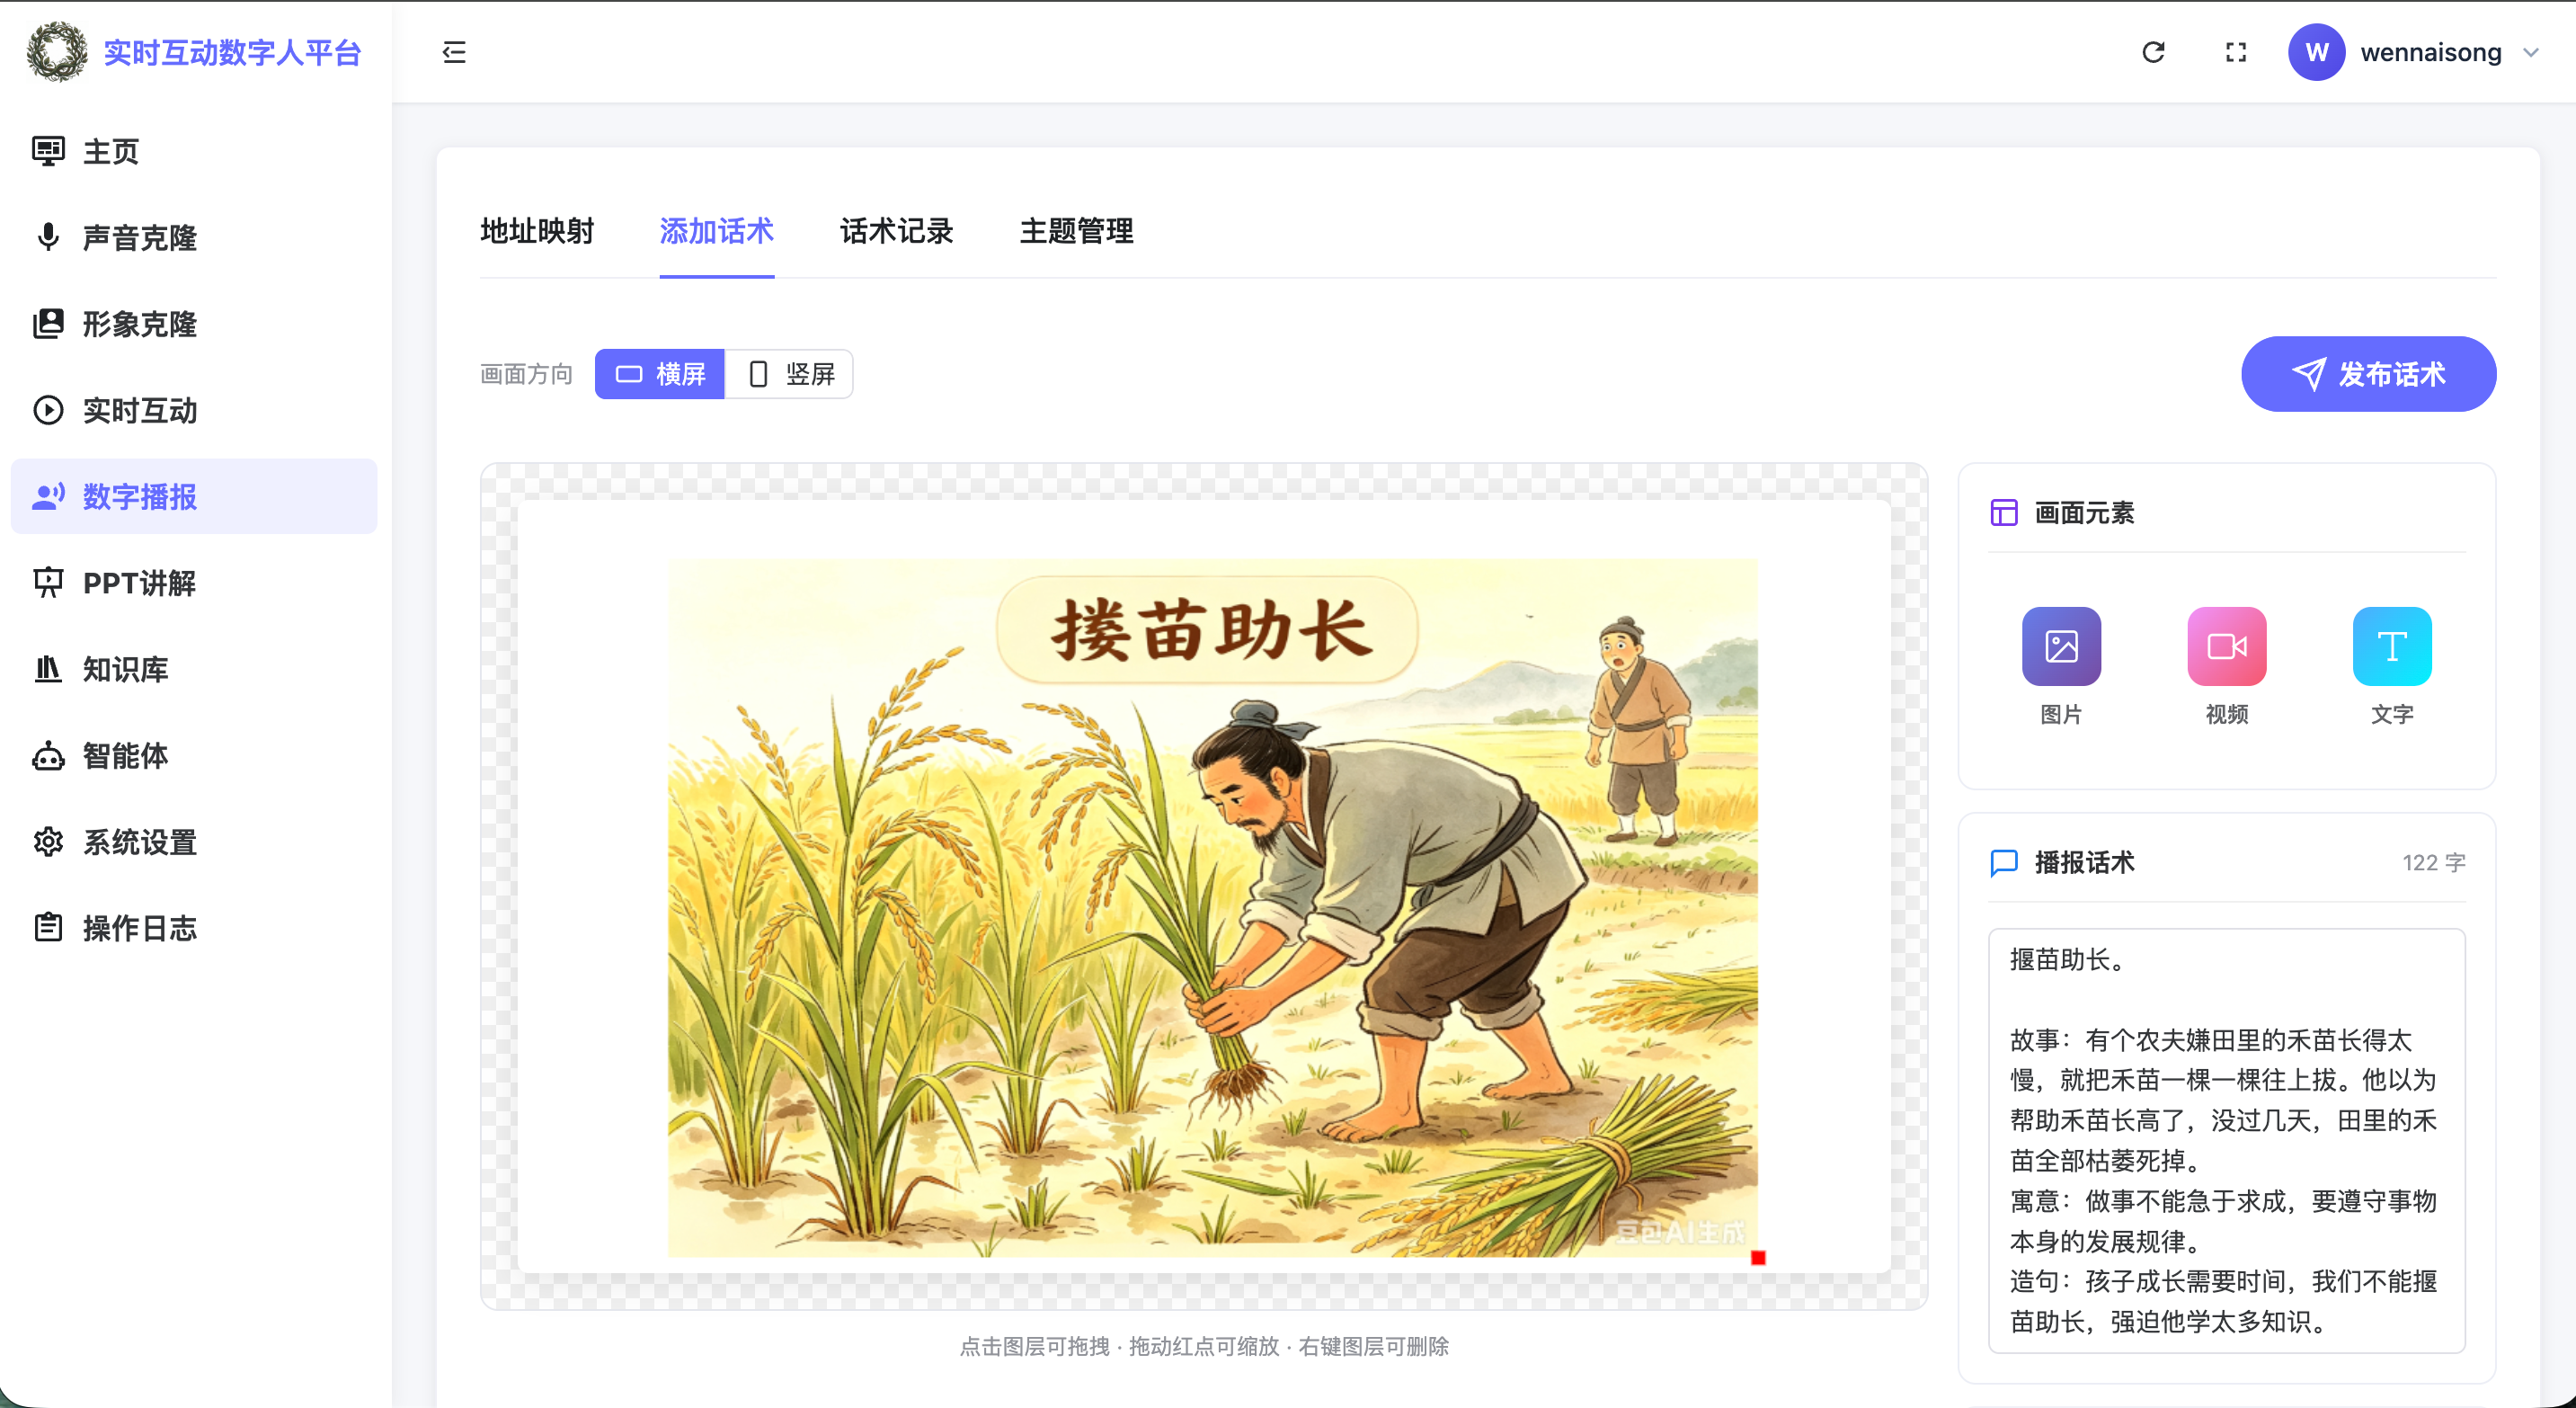
录入话术时,运营人员除了填写口播文案,还可以通过一个图层编辑器为这条话术挂接素材:
- 支持图片、视频、文字三类图层,图层具备位置、尺寸、可见性等属性;
- 素材以引用方式关联(引用媒体资源 ID),与文案一起结构化保存;
- 支持横屏 / 竖屏两种画布,适配大屏与移动端展示。
编辑完成后,一条「可播报的话术」就同时携带了「说什么」和「显示什么」两部分信息。
4.2 地址映射:语音打开页面的桥梁
地址映射是「语音导航」能力的基础。系统维护一张「触发词 → 目标地址」的映射表:
- 触发词即语音指令,如「打开展厅」;
- 目标地址为 URL 或图片文件名;
- 支持父子层结构:打开父页面时,会自动播放其下所有子层对应的话术。
当用户通过语音「打开某个页面」时,系统据此过滤并播报绑定到该地址的话术,实现「说到哪、讲到哪」。
4.3 主题管理
主题管理提供对内容分类的增删改查,并支持「设为当前播报主题」。该状态持久化保存,数字人开启播报时读取默认主题,从而只播报该主题下的话术。删除主题会级联删除其下全部话术,操作前会明确提示影响范围。
4.4 话术记录列表与分页
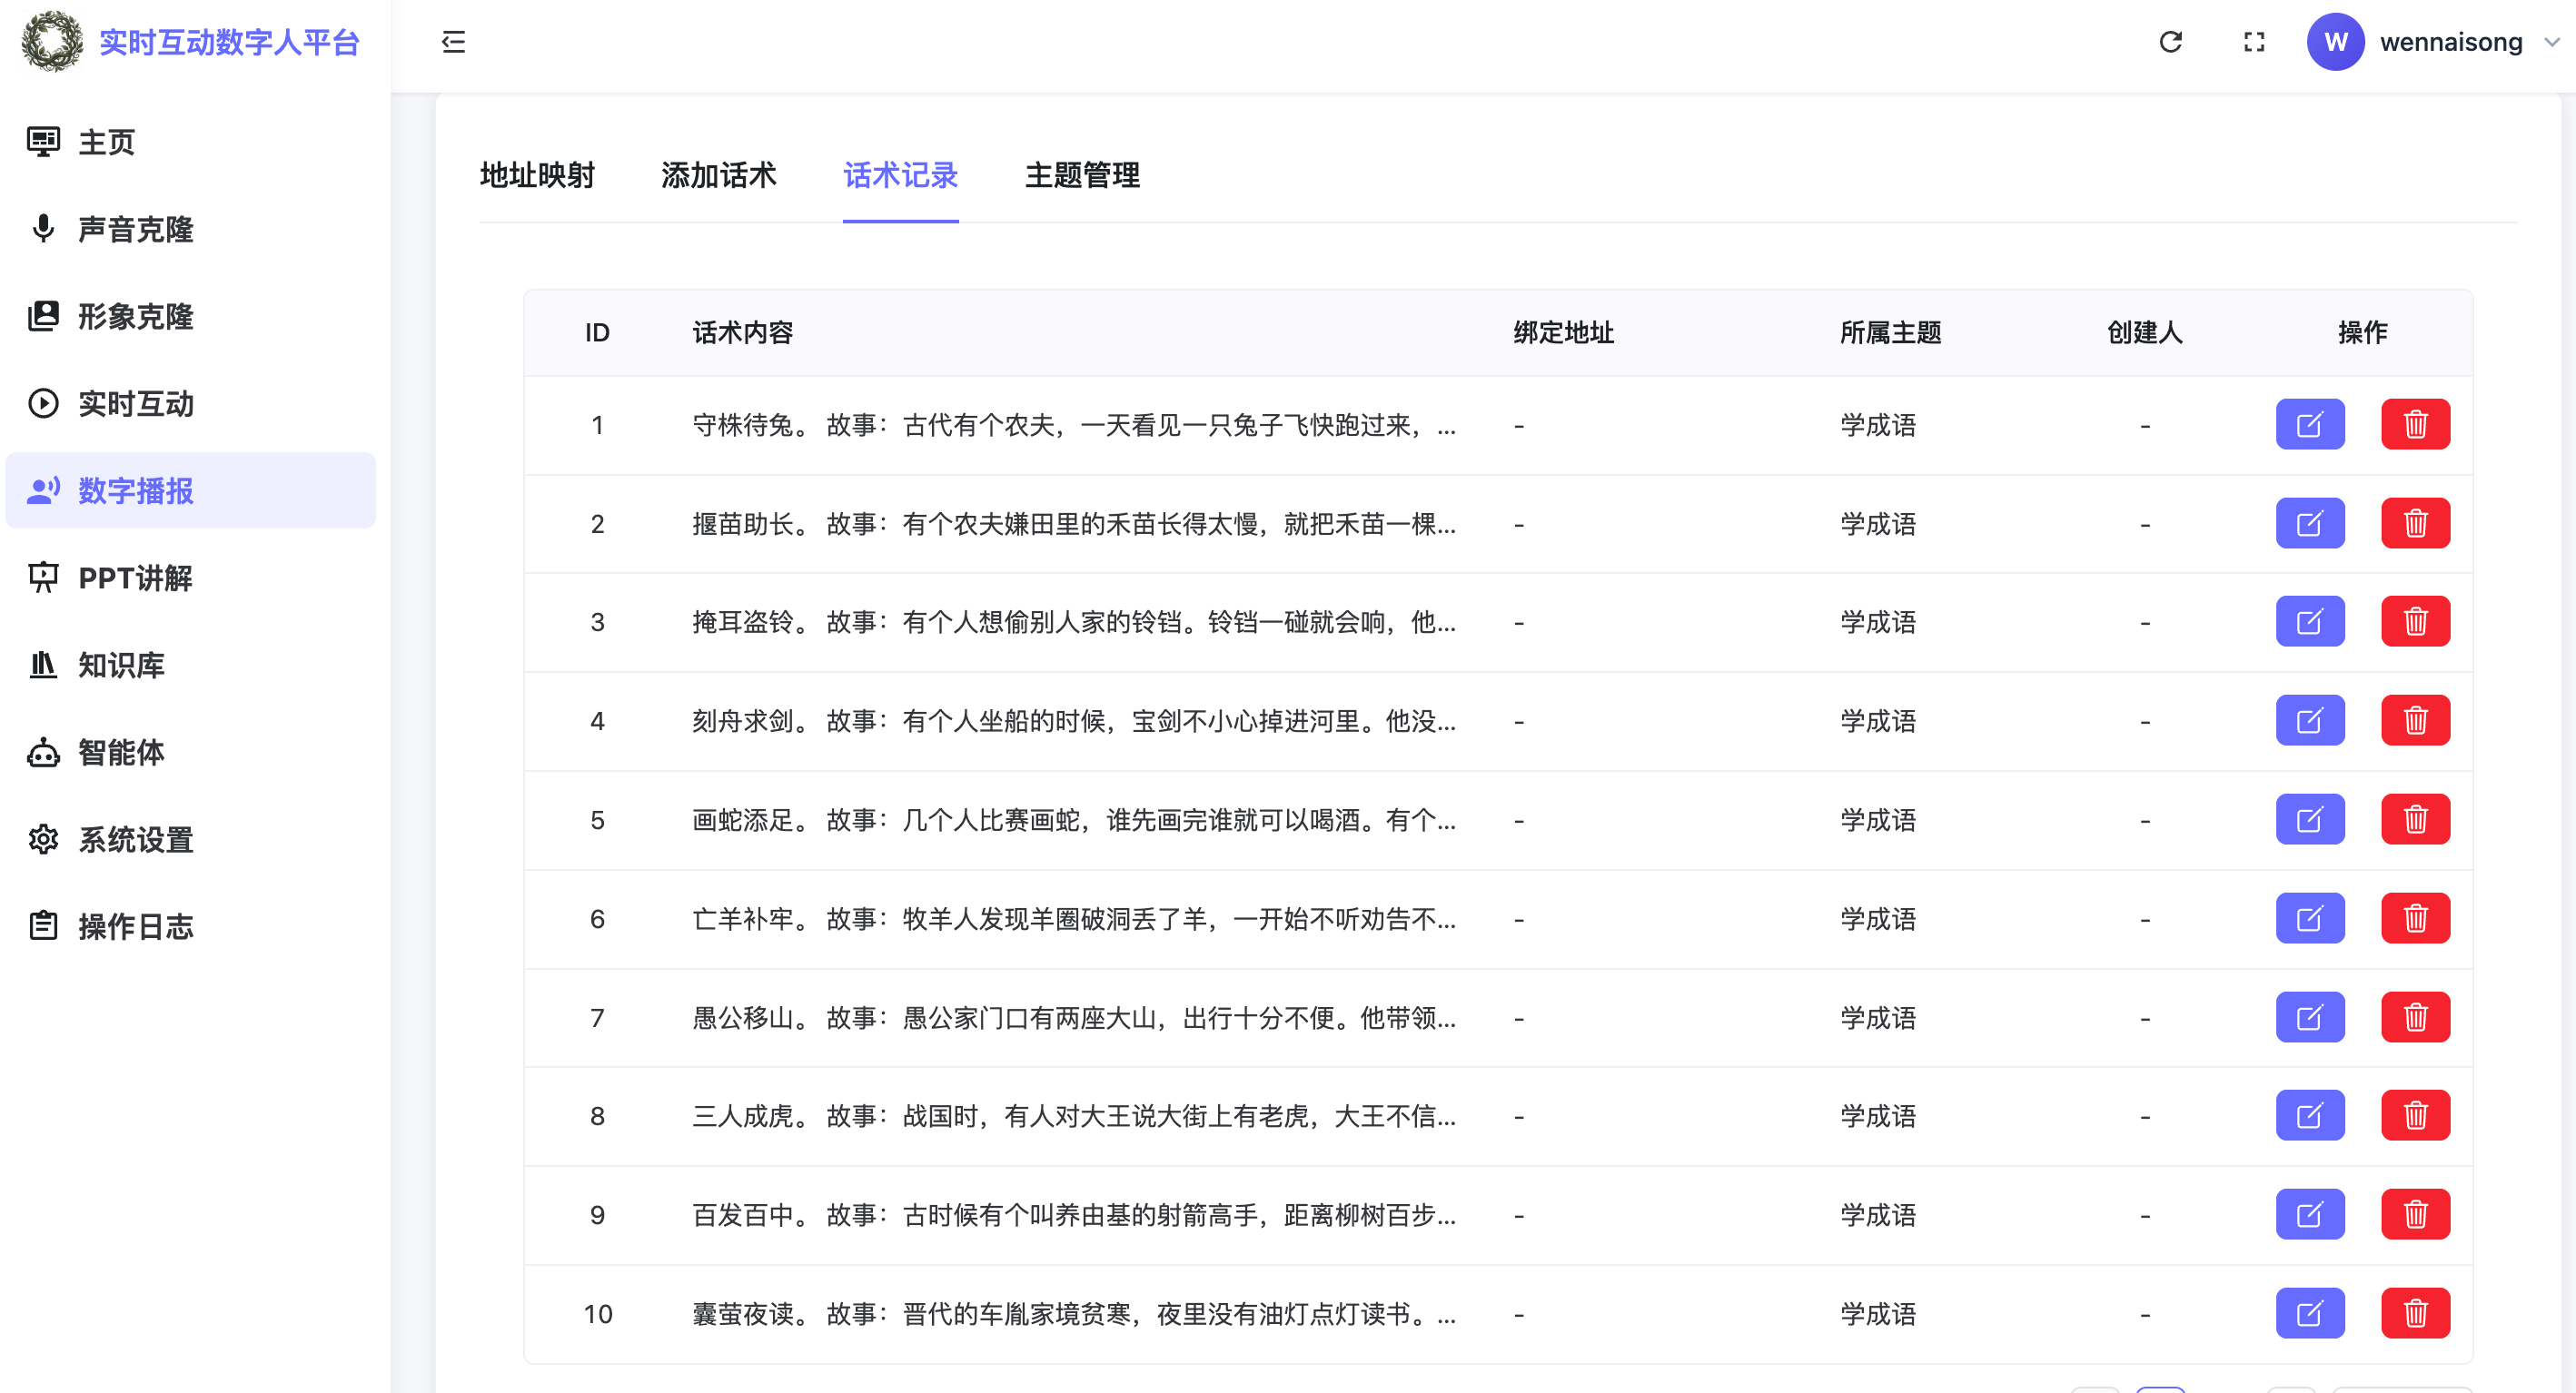
话术记录列表用于浏览、编辑和删除已录入的话术,采用统一的表格样式并支持服务端分页:
- 列表按「播放顺序 + 创建时间倒序」排序;
- 后端分页接口支持页码与每页条数,并返回总条数;
- 前端采用「远程分页」模式:翻页或切换每页条数时重新请求后端,而不是在前端切片;
- 删除当前页最后一条时自动回退上一页,避免停留在空页;
- 操作列用图标按钮(编辑、删除)表达,保持界面紧凑一致。
这套分页设计在话术数量较多时,避免了「一次加载全部」带来的渲染与传输开销,是工程化列表管理的基本实践。
五、播报引擎:如何把话术变成实时音视频
播报引擎是话术播报的核心,运行在服务端的后台线程中,负责「取话术 → 合成语音 → 驱动唇形 → 入队推流」的完整闭环。
5.1 优先级消息调度
引擎内部维护一个优先级消息调度器,将待播报内容分为三个优先级队列:
优先级(高 → 低):对话应答 > 事件消息 > 自动话术
这样设计的目的是:当用户与数字人进行实时对话或系统有紧急事件需要播报时,可以打断当前自动话术,优先响应交互;交互结束后再恢复话术播报。自动话术处于最低优先级,保证它不会抢占交互内容。
5.2 队列填充与播放顺序
播报引擎在满足以下条件时,才会从数据库取一条话术进入播放队列:
- 话术播报开关已开启;
- 当前没有正在进行的交互;
- 待播队列为空;
- 上一次播报的预计结束时间已到(保证话术之间留出缓冲间隔)。
取话术时,引擎按「播放顺序」字段逐条读取,并依据当前是否设置了「绑定地址」或「主题」进行过滤:
- 指定了绑定地址 → 只取该地址下的话术(定向播报);
- 指定了主题 → 只取该主题下的话术;
- 两者都未指定 → 播放全部话术。
取到的每条话术,会依次经过语音合成、唇形推理,产出音频帧与视频帧,交给实时推流层发送。为了降低话术之间的首包空隙,引擎会在保证播放顺序的前提下,允许有限度的预生成下一段内容。
5.3 循环播报与耗尽检测
当所有话术播放完毕后,引擎进入「耗尽」状态,处理方式取决于播报模式:
- 循环播报:播完一轮后,若本轮确实播报过内容,则从头再来一轮;
- 定向播报(指定地址 / 主题):保持一次性,播完即停止,不参与循环;
- 普通播报:播完一轮后自动停止。
耗尽检测必须基于「队列已清空且确认无后续内容」的事实,而不是仅凭时间估算,否则容易出现在最后一条话术尚未真正播完时,就误判为「已播完」并提前收尾的问题。
5.4 素材同步与延迟清理
话术关联的素材卡片需要与语音严格同步:语音讲到哪条,前端就显示哪条对应的素材。这一同步通过「同步标记 + 临时素材标识」实现:
- 每条话术开始播报时,把其关联素材以「临时素材」的方式推送到前端展示;
- 当话术之间切换时,下一条话术的素材自然接管,避免画面闪烁;
- 关键在于结束时的清理:只有当最后一条话术的音频真正播放完毕(收到音频结束帧)时,才下发「清理素材」的指令,而不是在预测的结束时刻就提前清理。
这个「延迟清理」设计解决了一类典型的时序问题:音频生产与推流之间存在链路延迟,若在预测时刻就清理素材,会出现「话术还没说完,图片先消失」的尴尬;改为以「音频实际播完信号」为清理触发点后,素材生命周期才与播报进度严格对齐。
六、播报状态机与语音控制
话术播报不是「一播到底」,而是被纳入统一的播报状态机管理,支持实时控制与打断。
6.1 控制指令
用户在播报过程中发出的语音指令,会被识别为「控制指令」,直接走控制逻辑而不经过大模型,因此响应迅速。主要指令包括:
| 开始播报 | 进入播报态,从第一页(或默认主题)开始播报 |
| 暂停播报 | 停止语音合成与话术取词,记住断点 |
| 继续播报 | 从断点处恢复播报 |
| 休眠 / 待机 | 终止播报,清空话术队列与断点,切换到待机态 |
其中「暂停」与「休眠」的语义不同:暂停是可恢复的,保留断点;休眠是终止,清空队列和断点,避免再次唤醒时把旧话术重新播出来。
6.2 打断与恢复
当用户用唤醒词打断播报、进入对话或问答模式时,系统会暂停话术播报但保留断点;交互结束后,根据之前的播报态决定是否自动恢复。这一机制保证了「播报 — 问答 — 继续播报」的无缝衔接。
6.3 自动播报信号
除了语音指令,系统还支持由上层智能体(Agent)在执行动作后下发「自动播报」信号,触发定向播报(如「播报某个绑定地址的话术」)。这类定向播报保持一次性,播完即止。
七、关键接口一览
服务接口层对外提供的能力可归纳为下表(接口路径与字段名已泛化):
| 话术列表 | 分页查询,支持按用户 / 任务 / 主题 / 绑定地址过滤,返回列表与总条数 |
| 话术新增 | 提交文案、素材、绑定地址、主题、角色 |
| 话术更新 | 更新文案 / 素材 / 绑定地址 / 主题,字段级更新 |
| 话术删除 | 删除话术并清理其关联的媒体素材 |
| 话术排序 | 提交 ID 有序列表,批量更新播放顺序 |
| AI 生成 / 改写 | 基于话题生成口播话术,或对既有话术改写 |
| 主题管理 | 主题的增删改查,删除时级联删除话术 |
权限控制方面,话术的查看、修改、删除均校验归属,防止越权操作。
八、设计要点与工程实践
回顾整个功能,有几点值得提炼的设计经验:
素材与话术一体存储,播报时按条同步:把「说什么」和「显示什么」绑定在一条话术记录里,播报时以话术为最小同步单元,避免素材与语音脱节。
优先级队列保证交互优先:对话与事件高于自动话术,让数字人在「讲解」和「应答」之间切换时,交互内容能及时抢占。
服务端分页而非前端切片:话术数量增长后,列表必须走服务端分页,后端返回总条数,前端只加载当前页,降低传输与渲染开销。
用「实际播完信号」而非「时间估算」做收尾:实时链路的延迟不可忽略,素材清理、耗尽判定等收尾动作应绑定音频实际播放结束的帧信号,避免时序错位。
暂停与休眠语义分离:可恢复的暂停保留断点,终止性的休眠清空队列,二者不可混用,否则会出现「旧内容被重新播出来」的副作用。
定向播报与循环播报解耦:指定地址 / 主题的定向播报保持一次性,整批循环播报才允许回绕,避免「点播完又无限循环」的意外行为。
九、总结
「话术播报」让数字人从「会说话」走向「会按脚本讲、会讲得有声有色」。本文梳理了该功能的设计思路:
- 以「话术 + 素材 + 主题 + 地址 + 顺序」的结构化模型承载内容编排;
- 以「优先级消息调度 + 空闲填充 + 定向 / 循环过滤」的播报引擎驱动实时播报;
- 以「同步标记 + 延迟清理」保证素材与语音的严格同步;
- 以「播报状态机 + 控制指令」支撑语音化的实时控制与打断。
这套设计的核心,是把一批静态文案,转化为一个「编得清、播得准、控得住、不穿帮」的动态讲解体验。若您的团队正计划建设数字人播报能力,或希望对上述方案做进一步交流,欢迎关注并联系。