Harness 口径、benchmaxxing、基准饱和与污染——一份写给开发者的「读分」指南
目录
1. 引言:两个都不是假数字的分数
2. 第一层:Harness —— 决定分数的那只「看不见的手」
3. 第二层:厂商自评表 vs 独立评测
4. 第三层:发布之后,数字还在动
5. 第四层:当基准本身失效——饱和与污染
6. 第五层:分数是有价格的
7. 那到底该怎么读分:一套可落地的流程
8. 把方法用一遍:四个真实案例
9. 回到 Astra:它到底值不值得用
10. 常见问题(FAQ)
11. 相关问题(读者常搜)
12. 参考资料
|
阅读提示 |
|
数据时效声明:本文数据截止 2026 年 9 月 14 日。文中所有评测分数、成本数字与时间线,均来自 ARC Prize 官方结果页、OpenAI 发布资料、Fortune 的调查报道、Artificial Analysis 独立指数以及 Epoch AI 的基准分析等公开来源,并在正文中逐条标注口径。基准分数与厂商定价变化极快,且同一分数在不同口径下不可直接比较,生产决策前请以原始发布页为准。 与同系列文章的差异:本系列此前已有两篇——《多模态统一表征与长上下文的三大技术突破》侧重架构,《Agent 落地与成本账》侧重工程落地与费用。本文刻意避开这两个方向,只回答一个问题:当一张跑分表摆在你面前,哪些数字是真的、哪些是口径的产物、以及你自己该怎么验证。 |
|
摘要 |
|
摘要: GPT-6 Astra 发布后,同一张发布页上出现过 99.99%、99.9%、98.6% 三个 ARC-AGI-3 分数;而独立评测机构 ARC Prize 用「通用接口」测出的官方成绩是 62.7%,用 OpenAI 自家的「适配支架」测出的是 99.9%。两个数都是真的,差距 37.2 分,而模型权重一个字节都没变。本文把这层迷雾逐层拆开:第一层是 harness(脚手架)——它比模型本身更能决定分数;第二层是自评与独立评测的分歧——同一批基准,两家的表格各赢各的,独立指数里 Astra 甚至与自家前代实质打平;第三层是发布后的改动——据 Fortune 对网页快照的比对,幻觉率、竞品数学分、网络安全分都在文章上线后被改过;第四层是基准本身的失效——饱和与污染让许多分差落进统计噪声;第五层是成本——跑一次完整评测要花两万多美元,而且分数不是线性买来的。最后给出一套可直接照做的「读分六问」、一个可运行的最小评测 harness,以及置信区间计算代码。一句话结论:跑分不是没用,而是「不带口径的跑分」没用;下次看到只有一个数字、没有脚手架说明的图表,直接跳过它。 |
1. 引言:两个都不是假数字的分数
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra,宣传口径是"AGI 时代的开端"。发布页上最抓眼的一组数字,是抽象推理基准 ARC-AGI-3 的 99.99%。
同一天,独立非营利机构 ARC Prize(ARC-AGI 系列基准的创建方)也公布了他们对 Astra 的评测结果。他们给出的数字是:62.7%。
一个 99.99%,一个 62.7%。相差近 37 个百分点。
按常规理解,这必然有一个是错的。但事实是:两个都对,而且它们测的是同一套题、同一个模型、同一天的权重。
差别只在一样东西上——评测时的"脚手架"(harness)。
- 在 ARC Prize 的标准支架下,模型只能用自己写下的笔记跨轮携带信息,最高档推理强度拿到 62.7%,整场评测花费约 $26,098;
- 在 OpenAI 的厂商适配支架下,模型可以在请求之间保留不透明的推理状态、并对长对话做压缩,中高档推理强度就拿到 99.9%,花费约 $18,817,反而更便宜。
这件事的重要性,远超"某家公司是不是在吹牛"。它意味着一个更普遍的结论:
|
任何不带脚手架说明的跑分,都不能当作模型自身的属性来读。 |
而这恰恰是绝大多数发布会图表、媒体转述和不严谨的横评文章都在做的事。本文要做的,就是把这件事拆到底,并且给你一套能自己动手的验证方法。
|
你接下来会看到 |
对应的核心问题 |
|
第 2 章 · Harness |
同一模型为什么能差 37 分? |
|
第 3 章 · 自评 vs 独立评测 |
该信厂商的表,还是独立机构的表? |
|
第 4 章 · 发布后的改动 |
上线之后数字还会不会变? |
|
第 5 章 · 饱和与污染 |
基准本身什么时候会失效? |
|
第 6 章 · 成本 |
这些分数要花多少钱才测得出来? |
|
第 7–8 章 · 方法 |
我该怎么自己验证? |
2. 第一层:Harness —— 决定分数的那只「看不见的手」
先说结论:在基准评测里,存在一个比模型本身更能决定分数的变量,而它几乎从不出现在发布页的图表上。这一章用 ARC Prize 官方公布的一张表,把它从幕后拉到台前。
2.1 一份表格里的 12 个 Astra
ARC Prize 没有掩盖这件事。他们在官方结果页上,同时公布了 Astra 在两套支架 × 六个推理档位下的全部 12 个配置结果:
|
推理档位 |
标准支架(通用接口) |
成本 |
厂商适配支架(保留推理状态) |
成本 |
|
none |
35.2% |
$49,791 |
96.7% |
$23,457 |
|
low |
17.5% |
$38,166 |
98.0% |
$21,298 |
|
medium |
38.6% |
$48,090 |
98.4% |
$19,285 |
|
high |
54.8% |
$40,705 |
99.9% |
$18,817 |
|
xhigh |
59.3% |
$37,317 |
98.4% |
$18,147 |
|
max |
62.7% |
$26,098 |
98.6% |
$17,332 |
这张表本身就足以说明问题:同一个模型,分数区间从 17.5% 一直拉到 99.9%——跨度 82 个百分点,全部由配置决定。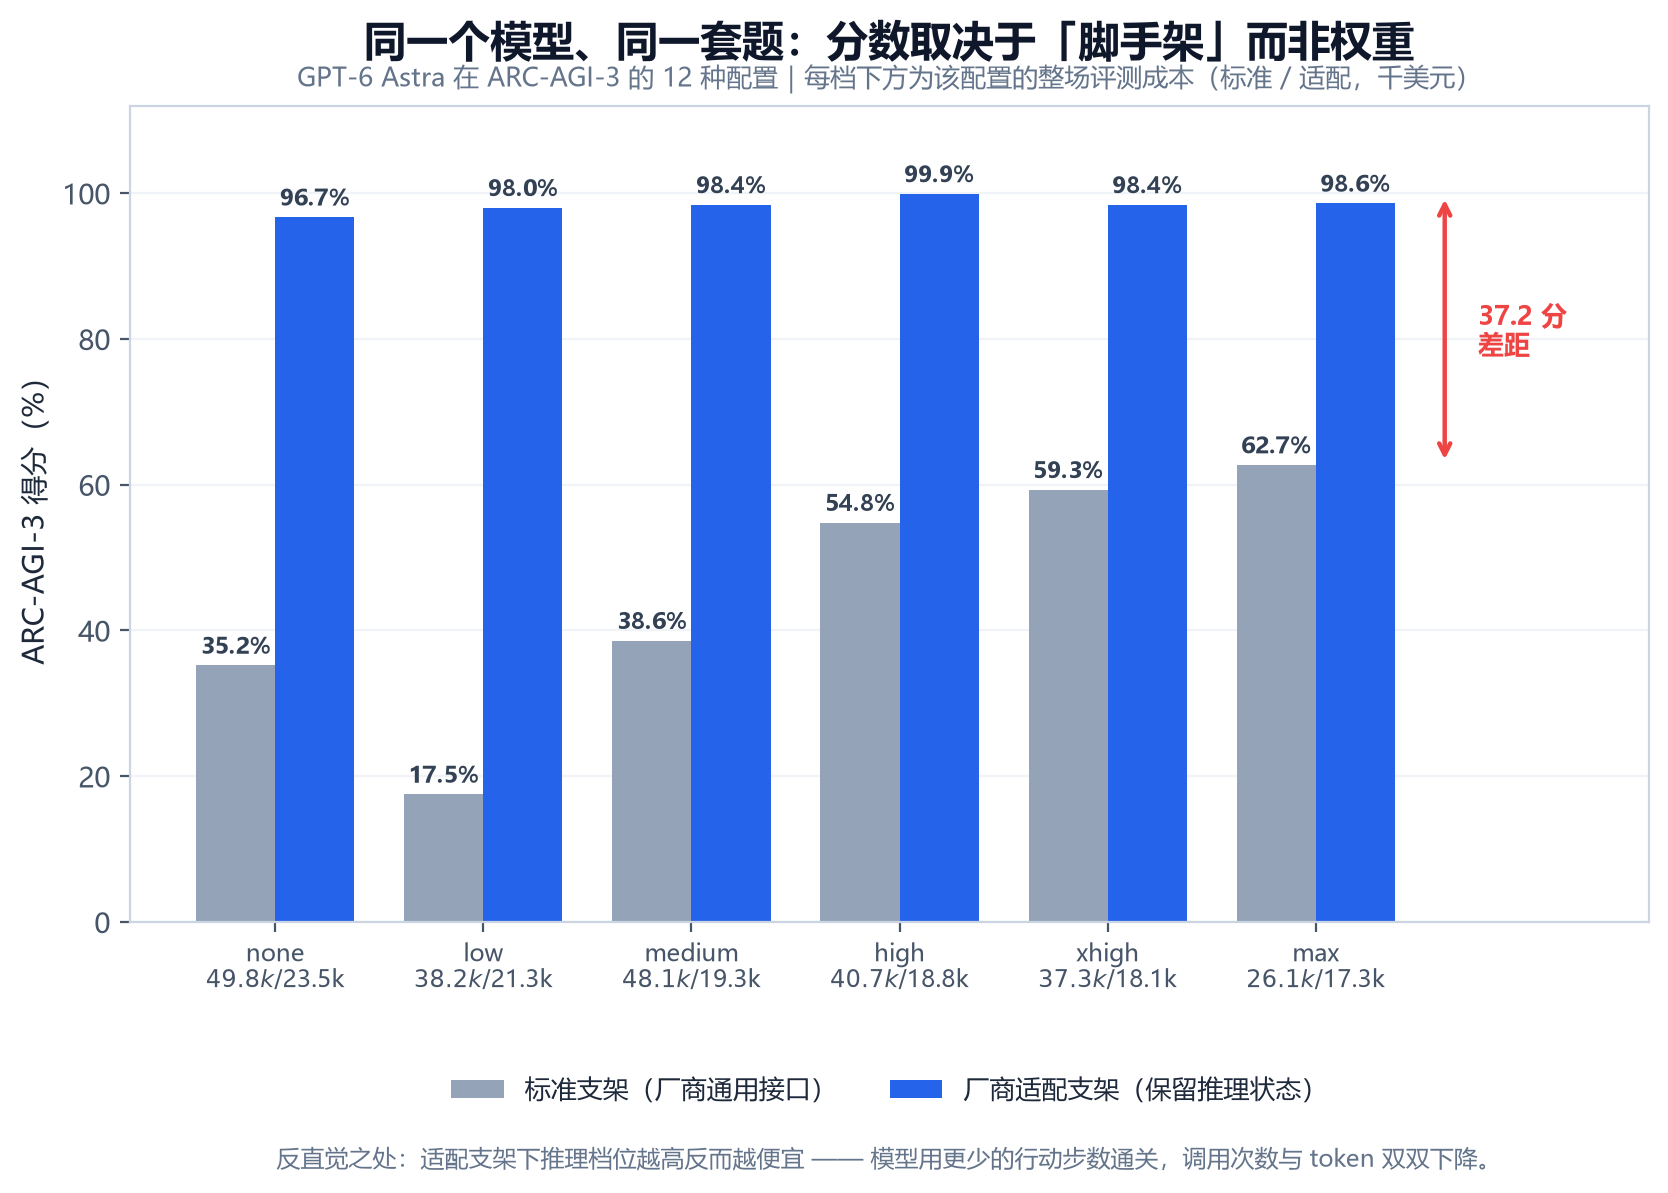 同一个模型、同一套题:分数取决于「脚手架」而非权重
2.2 37.2 分差距,权重一个字节都没变
两套支架的定义差异,用一句话就能说清:
- 标准支架是"通用接口":所有厂商的模型走同一套最小约定,模型只能把自己写下来的笔记带到下一轮,此外什么都不能带。
- 厂商适配支架则允许使用 OpenAI 自家的上下文管理能力:请求之间保留不透明的推理状态,并且对长对话做压缩(compaction)而不是截断。
这就是全部的差别。没有重新训练,没有额外微调,没有换权重——只是让模型能记住自己刚刚想了什么。
结果:在 167 组"两套支架都通关"的游戏–推理对上,适配支架快 3.66 倍、少用 49% 的 token,同时分数还更高。
更低的分、更慢的速度,却是更贵的那一次。 标准支架的 max 档烧掉 $26,098 拿到 62.7%;适配支架的 high 档只花 $18,817 就拿到 99.9%。这直接推翻了一个常见的直觉——"花的钱越多,测出来的分越高"。
2.3 更反直觉的:推理档位开得越高,反而越便宜
再仔细看那张表,会发现一个违反常识的趋势:在适配支架下,推理档位从 high 升到 max,成本反而从 $18,817 降到 $17,332。
原因不复杂,但很值得记住:Astra 在 ARC-AGI-3 这类回合制环境里,推理越充分、越能一次性把规则建模建准,通关所需的行动步数就越少;步数少 → 模型调用次数少 → 总 token 少 → 账单更低。
而更荒诞的对比出现在两列之间:
|
重点提示 |
|
在标准支架下把推理开到最高(max,62.7%),输给了在适配支架下把推理完全关掉(none,96.7%)。 也就是说,"让模型多想"的价值,被"让模型记得"碾压了。 |
2.4 代码示例:harness 的三个开关
把这件事翻译成配置,其实只有三个开关:
|
Python |
|
# -*- coding: utf-8 -*- """ 同一个模型,三行配置,两种分数。 ARC-AGI-3 上 37.2 分的差距,全部来自下面这三个开关 —— 与模型权重无关。 """ STANDARD = { "carry_notes": "model_written", # 只有模型自己写下的笔记能跨轮保留 "preserve_reasoning_state": False, # 请求之间不保留不透明的推理状态 "compaction": False, # 长对话不压缩,超长即截断 } PROVIDER_ADAPTER = { "carry_notes": "model_written", "preserve_reasoning_state": True, # 关键开关一:把上一轮的推理状态带过来 "compaction": True, # 关键开关二:压缩长历史,而不是丢弃 } def describe(cfg): state = "保留推理状态" if cfg["preserve_reasoning_state"] else "不保留推理状态" comp = "压缩长历史" if cfg["compaction"] else "截断长历史" return f"{state} / {comp}" if __name__ == "__main__": print("标准支架 :", describe(STANDARD)) print("厂商适配支架 :", describe(PROVIDER_ADAPTER)) # 运行结果: # 标准支架 : 不保留推理状态 / 截断长历史 # 厂商适配支架 : 保留推理状态 / 压缩长历史 |
这段代码里没有模型,只有脚手架。 而现实是:如果你在自己的生产系统里搭一个 Agent,你几乎一定是"标准支架"那一列——一次 HTTP 请求发出去、一次响应收回来,不透明的推理状态通常在网络边界就死掉了,而 compaction 是需要你自己实现的功能,不是选个模型名就自动拥有的。
所以当你把"Astra 在 ARC-AGI-3 上拿了 99.9%"写进选型报告时,你描述的是一套你还没有部署的系统。
一句话总结:分数是"模型 × 脚手架"的乘积,而发布页只公布了乘积。你需要的不是更高的那个因子,而是知道另一个因子是多少。
3. 第二层:厂商自评表 vs 独立评测
既然"怎么测"能左右 37 分,下一个问题自然是:谁来出题、谁来批卷? 这一章把厂商自家发布的对比表,和独立评测机构的结果放在一起看,分歧之大可能会出乎你的意料。
3.1 两张自评表,各赢各的
如果说 harness 是"同一道题的不同考法",那么下一层问题是:谁来批卷?
GPT-6 Astra 和 Claude Fable 5.1 在 2026 年 9 月 1–3 日先后发布,两家都公布了自己的对比表。放在一起看,结论会非常尴尬——每家的表里,都是自家模型赢。
|
基准 |
OpenAI 表( Astra vs Fable 5.1 ) |
Anthropic 表( Fable 5.1 vs Opus 5 ) |
|
高阶数学 |
Astra 97.6% vs Fable 87.8% |
— |
|
研究生级科学 |
Astra 96.0% vs Fable 93.7% |
— |
|
抽象推理( ARC-AGI-3 ) |
Astra 99.9% (适配支架) |
未列 |
|
终端 / 系统工程 |
Astra 57.7% vs Fable 55.8% |
Fable 55.8% vs Opus 5 52.3% |
|
科学终端 |
Astra 64.6% vs Fable 52.6% |
Fable 52.6% vs Opus 5 29.0% |
|
界面操作 |
Astra 92.7% vs Fable 87.3% |
OSWorld 部分 77.9% vs 75.4% |
|
通用推理(人类最后考试 · 带工具) |
Astra 57.2% vs Fable 65.0% ← 输 |
— |
|
网络安全 |
Astra 100% vs Fable 70% |
— |
注意其中两件事:
也就是说,Astra 的领先是"偏科式领先":计算机操作、数学、网络安全很强;通用长尾推理不是它的强项。
3.2 独立指数的冷水
第三方独立评测机构 Artificial Analysis 不跑厂商的题集,而是自己维护一套固定的评测套件(智能指数),用同一套流程跑所有模型。他们的读数要冷静得多: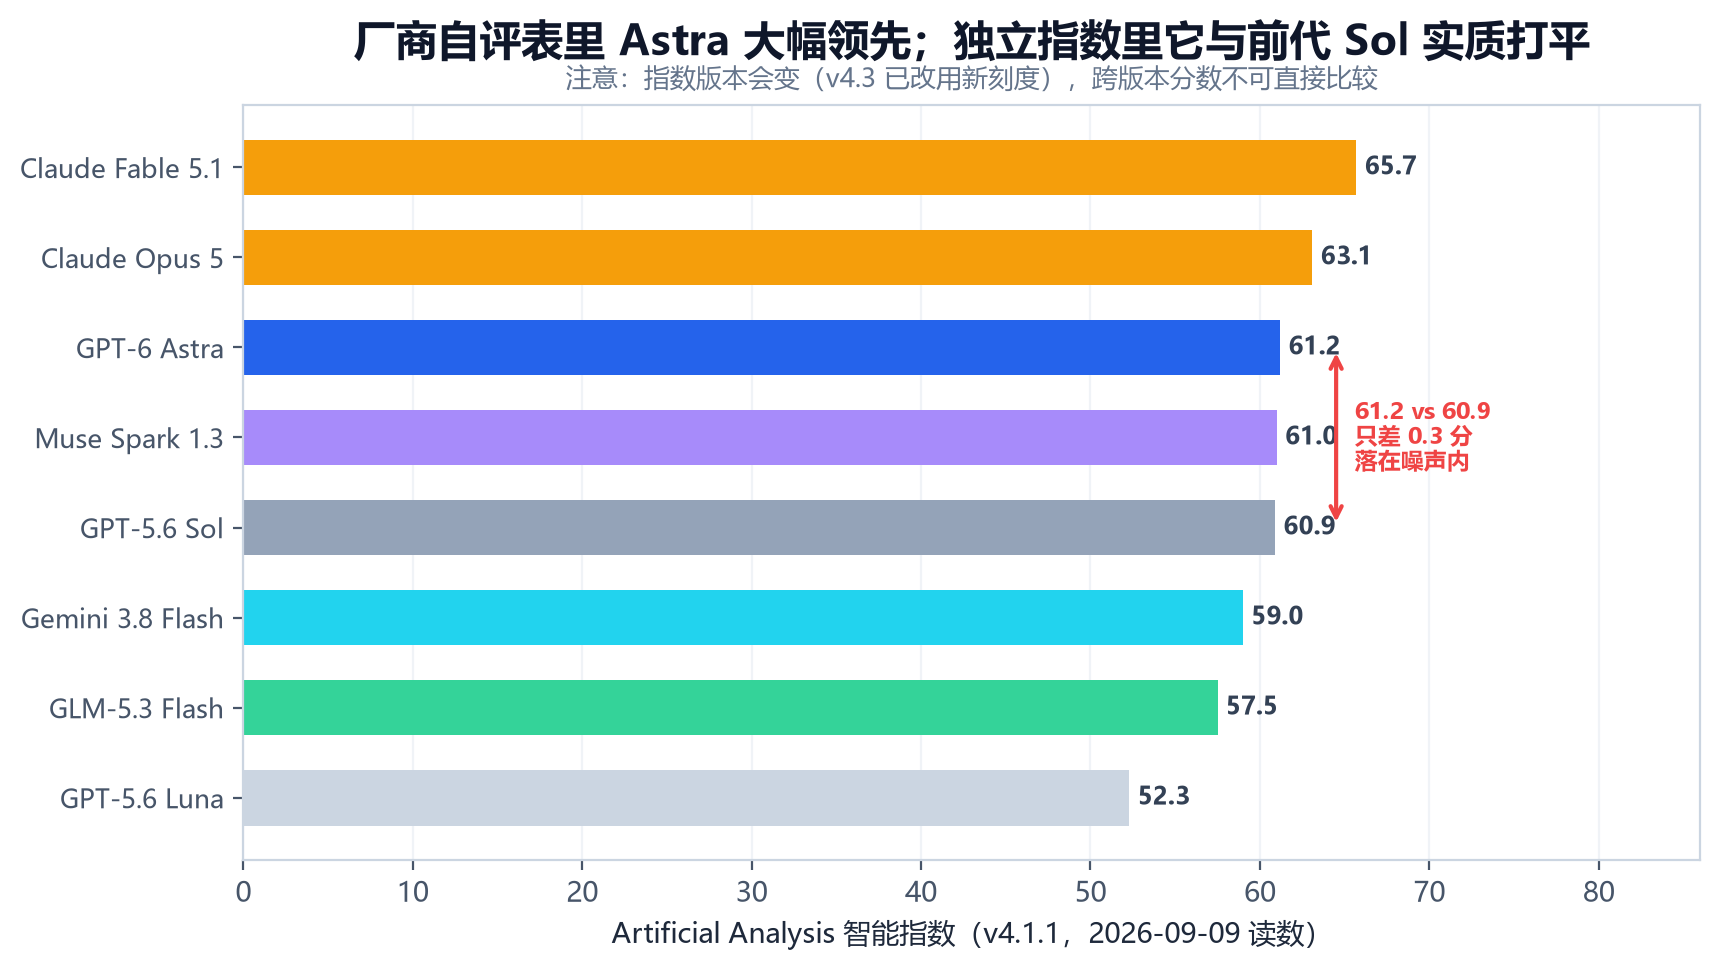 厂商自评表里 Astra 大幅领先;独立指数里它与前代 Sol 实质打平
关键对比是这一组:
|
模型 |
智能指数( v4.1.1 , 2026-09-09 读数) |
|
Claude Fable 5.1 |
65.7 |
|
Claude Opus 5 |
63.1 |
|
GPT-6 Astra |
61.2 |
|
Muse Spark 1.3 |
61.0 |
|
GPT-5.6 Sol(Astra 的前代) |
60.9 |
Astra 61.2,它的前代 Sol 60.9。差 0.3 分。
在一个误差常常在 1–2 分之间的指数上,这不是"代际跃迁",这是"实质打平"。而与此同时,竞品 Fable 5.1 在前方 4.5 分的位置。
这不是说 Astra 不强——它确实进了第一梯队。但它说明的是:"OpenAI 重新夺回前线领先"这个流行叙事,在独立评测里并不成立。
3.3 指数版本:一个容易被忽略的地雷
这里还有一个更隐蔽的坑。Artificial Analysis 的智能指数是会升版的,而跨版本的分数完全不可比。
- 我们在上表中引用的 61.2 / 65.7,是 v4.1.1 的读数;
- 到了 v4.3,同一个模型(Astra max)在同一机构的口径下变成了 53 分,Fable 5.1 也是 53 分——刻度整体变了,评测套件也换了(新增了 AutomationBench-AA 等)。
如果你把 v4.1.1 的 61.2 和 v4.3 的 53 放在同一张图里,或者拿其中一个去和另一个版本的竞品比,你得到的结论一定是错的。
这也是为什么本系列的每张图都标注了版本号与读数日期——这不是形式主义,是这一类数字唯一正确的使用方式。
3.4 代码示例:多来源交叉比对
手工比对容易出错,用一段脚本把"来源、基准、数值、口径"绑在一起管理会稳得多:
|
Python |
|
# -*- coding: utf-8 -*- """ 同一模型的分数,只有在「来源 + 基准 + 口径」三元组齐全时才有比较价值。 """ RECORDS = [ # (来源, 基准, 数值, 口径备注) ("ARC Prize(官方)", "ARC-AGI-3", 62.7, "标准支架 / max"), ("ARC Prize(官方)", "ARC-AGI-3", 99.9, "厂商适配支架 / high"), ("某媒体转述", "ARC-AGI-3", 66.0, "未注明支架"), ("Artificial Analysis", "智能指数", 61.2, "v4.1.1 / 独立复跑"), ("OpenAI 发布页", "GPQA Diamond", 96.0, "厂商自评"), ("Epoch AI", "GPQA Diamond", 95.0, "独立复跑 / ±2 分"), ] # 只要缺少口径标注,就不进入横向比较 TRUSTED_SOURCES = {"ARC Prize(官方)", "Artificial Analysis", "Epoch AI"} def is_comparable(rec): src, _bench, _val, note = rec if src not in TRUSTED_SOURCES: return False, "来源未独立或未复跑" if src == "ARC Prize(官方)" and "支架" not in note: return False, "缺 harness 说明" return True, "可比" def main(): print(f"{'来源':<24}{'基准':<16}{'数值':>7} 结论") for rec in RECORDS: ok, why = is_comparable(rec) flag = "✅ 可比" if ok else f"❌ {why}" print(f"{rec[0]:<24}{rec[1]:<16}{rec[2]:>7} {flag}") if __name__ == "__main__": main() |
核心思想:把"口径"当成数据的一部分来管理,而不是当成附注。 一旦口径缺位,这个数字就不该进入任何比较表格。
4. 第三层:发布之后,数字还在动
前面两章讨论的是"口径分歧"——不同测法得出不同结果,这本身还算方法论问题。这一章要讲一件更少被公开讨论、也更难辩解的事:文章已经上线之后,表上的数字还在变。
4.1 一条被 Fortune 抓出来的时间线
如果说前两层还属于"方法论分歧",那第三层就有点难看了。
据 Fortune 对网页存档快照的比对,OpenAI 在 9 月 3 日发布 Astra 之后,多次修改了发布页上的评测数字——而且这些改动发生在文章已经公开可见之后,并非发布前的内部校准。
|
指标 |
首版快照( 9/3 14:23 ) |
公开可见版( 9/3 17:17–17:20 ) |
事后修订(至今) |
|
Astra 幻觉率 ( ↓ 更好) |
4.2% |
2.0% (近乎腰斩) |
4.2% |
|
GPT-5.6 Sol 幻觉率 ( ↓ 更好) |
12.2% |
9.4% |
12.2% |
|
Claude Fable 5.1 数学分 ( ↑ 更好) |
87.8% |
78.0% |
83.0% |
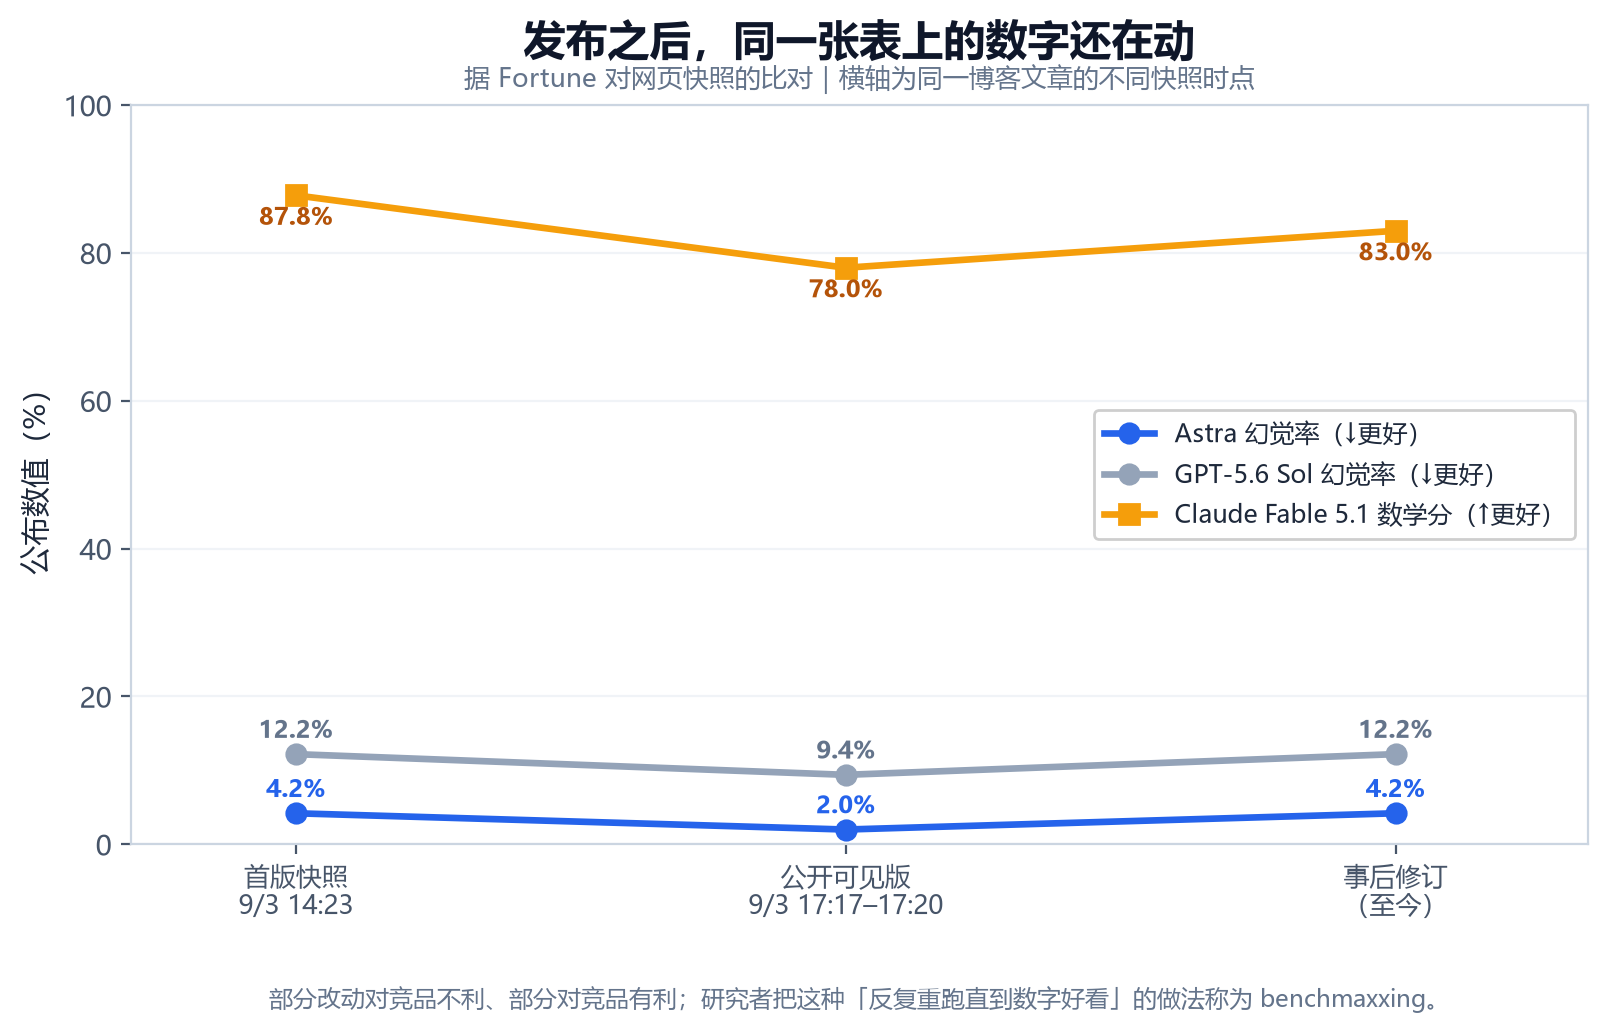 发布之后,同一张表上的数字还在动
4.2 「benchmaxxing」是什么
研究者给这类做法起了个名字:benchmaxxing——直译可以叫"刷分",但它描述的不是造假,而是在略有差异的测试条件之间反复重跑,直到头条数字看起来更好。
它和"伪造数据"有本质区别:每一次跑的分数可能都是真实测出来的。问题在于,选择公布哪一个。
Snorkel AI 负责基准与评测研究的 Vincent Sunn Chen 提供了一个值得听的背景:在模型发布的最后几个小时里调整基准数字并不罕见,因为这些数字对应着一整套测量设置——检查点、允许的算力与时间、脚手架、评分配置的随机性——"所有这些因素通常都会在发布前的最后几天持续调整"。
他同时提出了一个很合理的期望:当公司修改基准成绩时,应该明确说明评测条件发生了什么变化。 这正是本文认为最可操作的一条建议。
4.3 三个值得记住的细节
这条时间线里有三个细节,比"改了几个数"本身更重要:
第一,改动方向大部分对自家有利,但不是全部。 Fortune 也发现部分 Anthropic 的数字在同期上调了(HealthBench Professional 上,Fable 5.1 从 56.6% 升到 58.1%,Opus 5 从 54.5% 升到 56.4%)。所以这不是一个"单向操纵"的干净故事——它更像是一套缺乏版本管理的发布流程。
第二,网络安全那一处改动的性质更严重。 OpenAI 把 Sol 在内部 ExploitBench 上的成绩从 5.5% 提高到 11.5%,随后承认:这个 11.5% 对应的是一个当前并未向商业用户开放的推理档位。这不是"数字算错了",而是拿一个客户拿不到的能力去和竞品的常规设置作对比。这一处后来被 OpenAI 表示"正在研究是否回退"。
第三,最小的一处改动反而最能说明问题。 Astra 的编码分从 57.7% 改成 57.9%。0.2 个百分点,远在噪声范围内——但依然被替换成了更高的那个数字。当 0.2 分都要往上取的时候,你很难指望更大的分差会被保守处理。
另外还有一个耐人寻味的对照:一份受发布禁令约束的预发布草稿里,ARC-AGI-3 的分数是 98.6%;公开版变成了 99.99%。而 ARC Prize 的官方口径是 62.7%(标准支架)与 99.9%(适配支架)。同一个指标,三个数字,三种来源。
4.4 这不是某一家的问题
值得公平地说一句:基准分数被动过手脚,是整个行业的长期问题,不是 OpenAI 的独家行为。
- 2025 年,Meta 曾被报道在 Llama 4 的测试成绩上做了处理(用内部版本而非最终公开版本),公司最初否认,其前首席 AI 科学家后来承认确实对基准结果做过"修饰"。
- 斯坦福的研究者(Anka Reuel、Mike Hardy)指出,Astra 的系统卡本应提供更多评测方法的技术信息,但对于内部的幻觉率评测,"几乎没有提供任何有关评测方法的细节,甚至连测试项目的数量都没有列出"。
但也存在反向证据:Epoch AI 把各家自报的 GPQA Diamond 分数与自己的独立复跑做对照,发现所有主要厂商的自报分数都落在置信区间内(统计检验的 p 值均明显高于 0.05)。也就是说,在这些可复现的基准上,厂商并没有系统性撒谎。
两件事同时为真:在标准化、可复现的基准上,厂商数字大体可信;在自定义的、口径模糊的、竞品无法复跑的指标上,数字的可比性就要打折扣。你需要区分的不是"谁在骗人",而是"这个指标能不能被第三方复现"。
一句话总结:可复现的基准可信度较高;不可复现的基准,无论数字多漂亮,都只能当作参考。
5. 第四层:当基准本身失效——饱和与污染
即使口径清楚、来源独立、版本一致,仍然有一种情况会让分数彻底失去意义:这套题本身已经测不出差异了。 造成这种局面的原因有两个——饱和与污染,它们一个让题变简单,一个让题变熟悉。
5.1 已经退役的四个基准
2026 年的评测生态有一个尴尬的现实:过去几年最常被引用的几个基准,已经基本失去区分能力。
|
基准 |
现状 |
曾经的作用 |
|
MMLU |
头部聚集在 88% 以上,功能性饱和 |
世界知识广度 |
|
HellaSwag |
头部 95% 以上 |
常识与物理推理 |
|
HumanEval |
头部 90% 以上,污染风险高 |
代码生成 |
|
GSM8K |
头部 95% 以上 |
小学数学推理 |
当所有前沿模型都挤在同一个天花板上时,分差衡量的不是能力,而是随机波动。
5.2 噪声地板:0.7 分的领先等于打平
以目前最常用的科学推理基准 GPQA Diamond 为例。它只有 198 道题,这意味着:
- 1 道题 ≈ 0.5 分;
- Epoch AI 估计其独立评测对真实能力的判定精度约为 ±2 分(90% 置信度,基于 198 题样本量);
- Artificial Analysis 采用"三次运行取中位数"的惯例来降低方差,但即便如此,前几名之间 2 分以内的差距仍应谨慎对待。
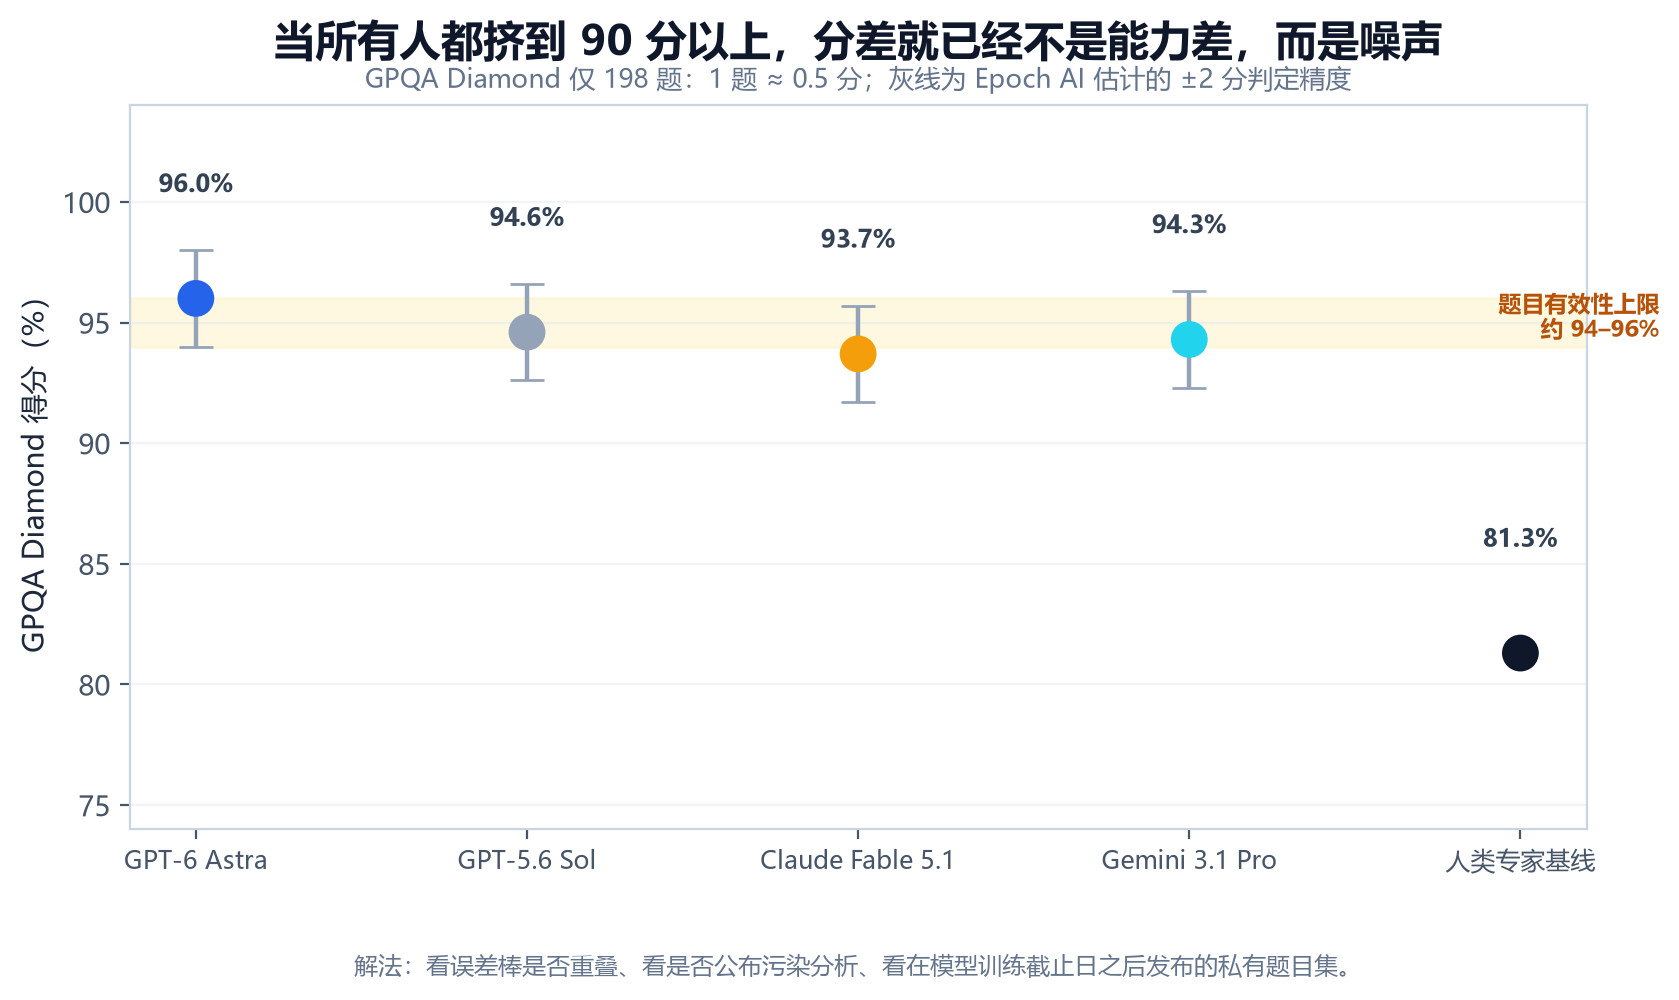 当所有人都挤到 90 分以上,分差就已经不是能力差,而是噪声
更麻烦的是,这 198 题本身也不是完全干净的。经独立专家组复核,约 4%–6% 的题目存在答案有争议、表述含糊或依赖过时实验惯例的问题,这把手写答案的理论天花板压在了 94%–96% 附近。也就是说,当表中的模型打 96% 时,它可能已经触到了这套题的上限。
|
一条实用的判据:当一张 2026 年的发布图表以 GPQA 或 AIME 打头时,这本身就是一个信号——那些更有区分度的基准,大概率没有给出好看的分数。 |
5.3 污染的三副面孔
比饱和更隐蔽的问题是污染:模型在训练时"见过"了考题。
|
类型 |
表现 |
例子 |
|
直接污染 |
题目原文出现在预训练语料里 |
公开数据集被爬取 |
|
间接污染 |
题目的改写、解析、讨论出现在语料里 |
博客与论坛的 " 解题笔记 " |
|
潜在污染 |
因在该基准上得分高而被选为检查点,偏向 " 会背 " 的版本 |
模型选择偏差 |
一个经典的验证设计是 GSM1k:Scale AI 构造了一批与 GSM8K 同分布但未公开的新题,结果多个模型的成绩出现明显下滑——这直接证明了原基准上的高分里含有记忆成分。
一个反向信号也值得知道:前沿模型在 GPQA Diamond 上始终错在同一小批题上,且错误集合在不同版本间相对稳定。如果分数主要来自记忆,失败集合应该随机漂移——它没有漂移,说明剩余错误更可能来自真实的能力边界或题目本身的歧义。
5.4 抗污染的三种设计
2026 年的"新一代基准"基本围绕三个原则重建:
5.5 代码示例:污染与饱和的自检清单
在看到任何分数之前,先用一张清单过一遍:
|
Python |
|
# -*- coding: utf-8 -*- """ 在相信任何一个分数之前,先过一遍这张清单。 问题不在「分数高不高」,而在「这个分数测的是什么」。 """ def audit(bench: dict) -> list: issues = [] # 1) 饱和:头部聚集在高位时,分差已落入噪声 if bench["top_score"] > 90: issues.append("疑似饱和:头部聚集在 90 分以上,分差可能已落在噪声内") # 2) 样本量:题越少,单题权重越大 n = bench.get("n_items") if n and n < 300: issues.append(f"样本量偏小({n} 题):1 题 ≈ {100 / n:.2f} 分") # 3) 是否私有留出 if not bench["private_holdout"]: issues.append("题目公开:存在训练数据污染风险") # 4) 是否晚于训练截止日 if not bench["post_cutoff"]: issues.append("题目早于模型训练截止日:无法排除「背答案」") # 5) 是否公布污染分析 if not bench["contamination_report"]: issues.append("技术报告未给出污染分析") return issues or ["暂未发现明显问题(仍建议在你自己的数据上复测)"] BENCH = { "name": "GPQA Diamond", "top_score": 96.0, "n_items": 198, "private_holdout": False, "post_cutoff": False, "contamination_report": True, } if __name__ == "__main__": print(f"【{BENCH['name']}】") for i, s in enumerate(audit(BENCH), 1): print(f" {i}. {s}") # 运行结果: # 1. 疑似饱和:头部聚集在 90 分以上,分差可能已落在噪声内 # 2. 样本量偏小(198 题):1 题 ≈ 0.51 分 # 3. 题目公开:存在训练数据污染风险 # 4. 题目早于模型训练截止日:无法排除「背答案」 |
6. 第五层:分数是有价格的
前面四层讨论的都是"这个分数可不可信"。这一章补上最后一个维度:这些分数本身要花多少钱才测得出来——以及当"分数"变成一种商品时,它的边际价格是怎么定的。
6.1 跑一次分要多少钱
分数不是免费的。Artificial Analysis 公布过跑完整套智能指数的实测花费,这组数字本身就很说明问题: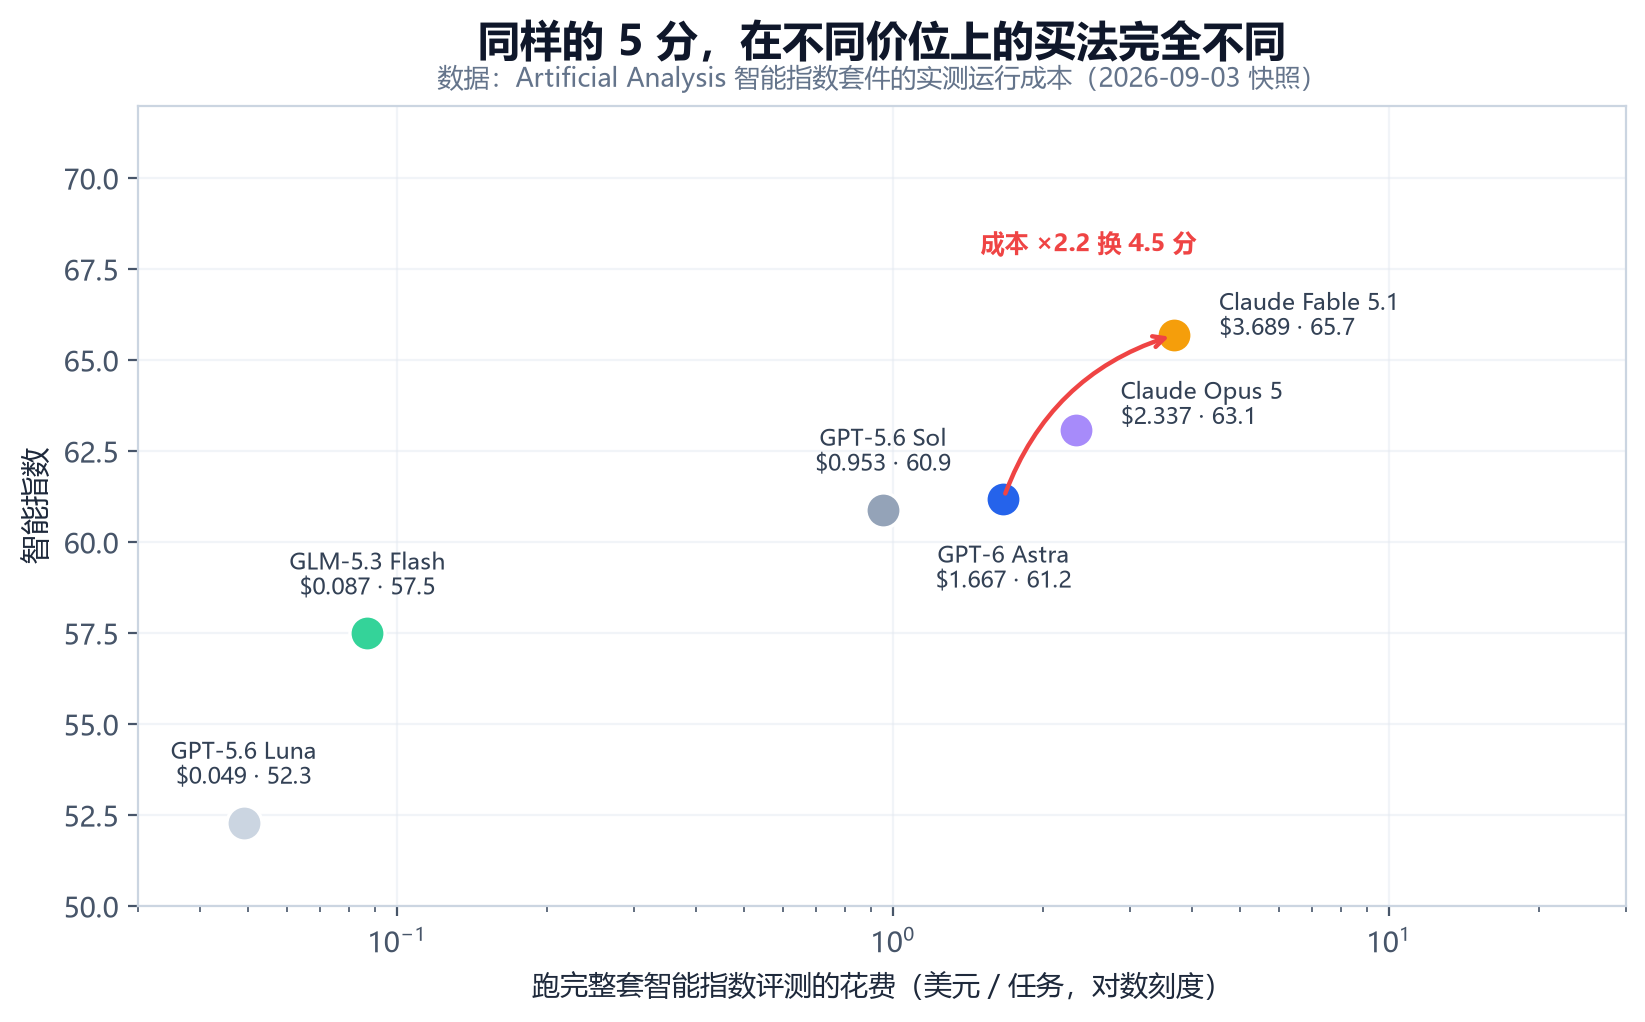 同样的 5 分,在不同价位上的买法完全不同
|
模型 |
智能指数 |
跑完整套评测的花费(美元 / 任务) |
|
GPT-5.6 Luna |
52.3 |
$0.049 |
|
GLM-5.3 Flash |
57.5 |
$0.087 |
|
Gemini 3.8 Flash |
59.0 |
$0.58 |
|
GPT-5.6 Sol |
60.9 |
$0.953 |
|
GPT-6 Astra |
61.2 |
$1.667 |
|
Claude Opus 5 |
63.1 |
$2.337 |
|
Claude Fable 5.1 |
65.7 |
$3.689 |
注意最后两行与 Astra 的关系:从 Astra 走到 Fable 5.1,成本要乘以 2.2 倍,换来的是 4.5 分。 这个边际价格值不值,完全取决于你的任务是否真的需要那 4.5 分——而这个问题,只有你自己的数据能回答。
6.2 ARC-AGI-3 那次评测的账单
回到最开头那场评测。ARC Prize 公布的成本是:
- 标准支架 max 档:$26,098,得 62.7%;
- 厂商适配支架 high 档:$18,817,得 99.9%。
作为对照,ARC Prize 还招募了约 500 名普通公众做人类基线测试,报酬是每 90 分钟 $115、每完成一关再加 $5,平均下来每次尝试约 $12.78。
这组数字揭示了一个常被忽略的事实:"跑分"本身就是一项需要预算的工程活动。对大多数团队来说,你不可能自己复现一个两万美元的评测;你能做的,是用你自己的真实任务做小规模压测——这正是下一章的内容。
6.3 代码示例:把分数换算成「每分每美元」
很多"哪个模型更好"的争论,在把成本放进来之后会立刻清晰:
|
Python |
|
# -*- coding: utf-8 -*- """把「分数」换算成「每分每美元」,很多争论会立刻消失。""" RUNS = [ # 模型, 智能指数, 跑完整套评测的花费(美元 / 任务) ("GPT-5.6 Luna", 52.3, 0.049), ("GLM-5.3 Flash", 57.5, 0.087), ("Gemini 3.8 Flash", 59.0, 0.580), ("GPT-5.6 Sol", 60.9, 0.953), ("GPT-6 Astra", 61.2, 1.667), ("Claude Opus 5", 63.1, 2.337), ("Claude Fable 5.1", 65.7, 3.689), ] print(f"{'模型':<20}{'指数':>6}{'美元/任务':>12}{'每分成本(美元)':>16}") for name, score, cost in RUNS: print(f"{name:<20}{score:>6.1f}{cost:>12.3f}{cost / score:>16.4f}") # 追问:从 Astra 走到 Fable 5.1,多花的钱到底买到了什么? d_score = 65.7 – 61.2 d_cost = 3.689 – 1.667 print(f"\\n多花 ${d_cost:.3f}/任务,多拿 {d_score:.1f} 分" f" → 边际价格约 ${d_cost / d_score:.3f}/分") |
运行结果(节选):
|
运行结果 |
|
模型 指数 美元/任务 每分成本(美元) GPT-6 Astra 61.2 1.667 0.0272 Claude Fable 5.1 65.7 3.689 0.0561 多花 $2.022/任务,多拿 4.5 分 → 边际价格约 $0.449/分 |
7. 那到底该怎么读分:一套可落地的流程
分析到这里,方法论已经完整了。但知道"跑分不可信"没有用,你得知道遇到下一张跑分表时具体该做什么。这一章把它收成一套可以直接照着执行的流程:一张清单、一张落差图,以及两段能直接拿去用的代码。
7.1 读分六问
把前面五层收成一个可以直接照着做的清单:
|
# |
问题 |
为什么问 |
危险信号 |
|
1 |
谁跑的? |
自评 / 第三方是两种可信度 |
只有厂商自己的表 |
|
2 |
什么支架? |
脚手架能造成 37 分差距 |
图表里没有 harness 说明 |
|
3 |
哪个版本? |
指数会升版,刻度会变 |
跨版本数字放在一起比 |
|
4 |
饱和了吗? |
头部 90 分以上只剩噪声 |
用 GPQA / AIME 打头 |
|
5 |
污染了吗? |
题目是否公开、是否早于训练截止日 |
无私有留出、无污染分析 |
|
6 |
花了多少钱? |
分数不是免费买来的 |
不提成本、不提误差棒 |
7.2 从论文分数到线上表现的五道损耗
即便以上六问全部过关,你拿到的也仍是一个实验室数字。从它到你线上真正能看到的表现,中间还会损耗五次: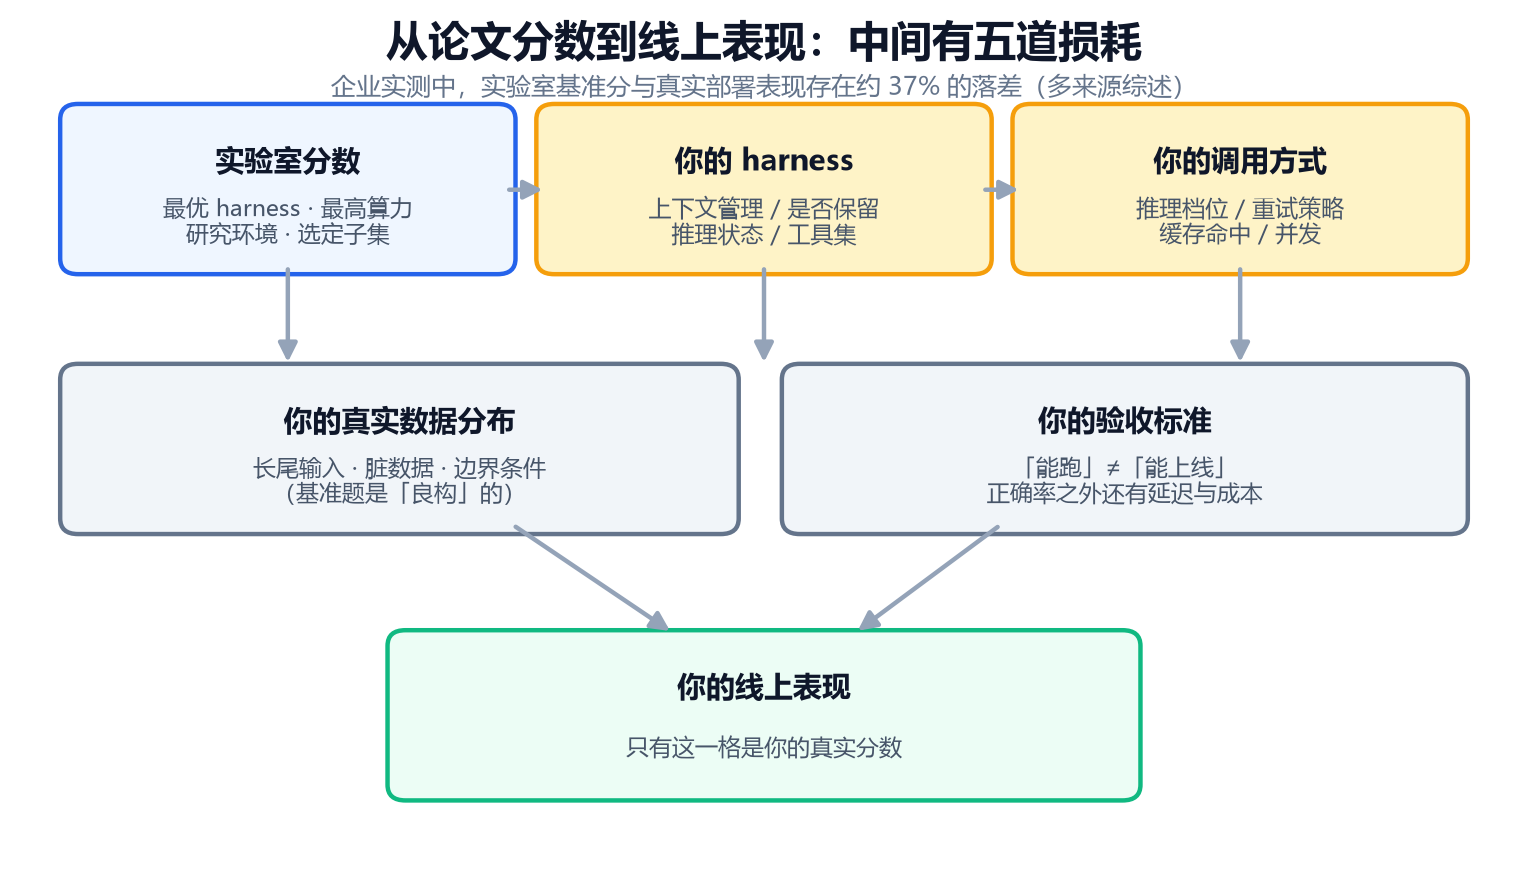 从论文分数到线上表现:中间有五道损耗
多来源的综述显示,企业级 Agent 系统中,实验室基准分与真实部署表现之间存在约 37% 的落差,而达到相近准确率的方案之间,成本差异可达数十倍。
这 37% 才是你真正需要关心的数字。 它不在任何发布页上,只能自己测。
7.3 代码示例:一个可以跑的最小评测 harness
自建评测不需要很复杂,关键在于所有候选模型走完全相同的脚手架——这恰恰是发布页做不到的事:
|
Python |
|
# -*- coding: utf-8 -*- """ 一个可以跑的最小评测 harness。 重点不是它多完备,而是:所有候选模型必须走完全相同的脚手架, 并且把脚手架配置一起写进报告。 """ from dataclasses import dataclass, field @dataclass class Case: case_id: str prompt: str expect: str checker: str = "contains" # exact / contains / json_equal @dataclass class HarnessConfig: """脚手架配置 —— 评测报告里最该写清楚的就是这一块。""" effort: str = "medium" # 推理档位 tools: list = field(default_factory=list) preserve_state: bool = False # 是否跨轮保留推理状态 max_retry: int = 0 # 允许重试几次 notes: str = "" # 任何影响可比性的额外设定 def run_case(model, case, cfg): """真实场景下这里换成 SDK 调用;关键是所有模型共用同一份 cfg。""" for attempt in range(cfg.max_retry + 1): raw = call_model(model, case.prompt, cfg) if judge(raw, case): return True, attempt return False, cfg.max_retry def evaluate(models, cases, cfg): report = {"config": cfg.__dict__, "models": {}} for m in models: passed = tries = 0 for c in cases: ok, t = run_case(m, c, cfg) passed += int(ok) tries += t n = len(cases) report["models"][m] = { "pass_rate": round(passed / n, 4), "avg_retries": round(tries / n, 3), "passed": passed, "total": n, } return report if __name__ == "__main__": cfg = HarnessConfig(effort="high", tools=["file_search"], preserve_state=False, max_retry=1, notes="统一 0-shot,无系统提示词优化") # 真实运行示例(伪调用): # print(evaluate(["model-a", "model-b"], cases, cfg)) print("harness 配置:", cfg) |
注意报告里的 config 字段。 你自己做的评测,如果不同时写下脚手架配置,三个月后连你自己都无法解释当初的结论。
7.4 代码示例:样本量与置信区间
最后一个坑:你以为的"高 2 分",很可能只是抽样波动。
|
Python |
|
# -*- coding: utf-8 -*- """ 「高 2 分」到底是不是真的高?先算置信区间,再下结论。 用 Wilson 区间:在小样本 + 比例型分数(通过/不通过)下比正态近似更稳。 """ import math def wilson(k: int, n: int, z: float = 1.96): """k 次通过 / n 次尝试 → 95% 置信区间""" if n == 0: return 0.0, 0.0 p = k / n d = 1 + z * z / n center = (p + z * z / (2 * n)) / d half = z * math.sqrt(p * (1 – p) / n + z * z / (4 * n * n)) / d return max(0.0, center – half), min(1.0, center + half) RESULTS = [("模型 A", 122, 200), ("模型 B", 118, 200)] for name, k, n in RESULTS: lo, hi = wilson(k, n) print(f"{name}: {k / n:6.1%} 95% 置信区间 [{lo:.1%}, {hi:.1%}]") (lo_a, hi_a), (lo_b, hi_b) = (wilson(122, 200), wilson(118, 200)) overlap = not (hi_b < lo_a or hi_a < lo_b) print("\\n区间是否重叠:", "是 → 差异不显著,不要据此选型" if overlap else "否 → 差异显著") |
运行结果:
|
运行结果 |
|
模型 A: 61.0% 95% 置信区间 [54.1%, 67.5%] 模型 B: 59.0% 95% 置信区间 [52.1%, 65.6%] 区间是否重叠: 是 → 差异不显著,不要据此选型 |
这就是很多"某某模型领先 2 分"的真相:两个置信区间大面积重叠。 如果一张表不告诉你样本量,你连它测没测出差异都不知道。
8. 把方法用一遍:四个真实案例
原则只有落到具体案例上才有说服力。这一章用四个真实案例把前面整套方法完整走一遍——其中最后一个案例,给出了支持本文结论的正向证据,而不是又一条"厂商不可信"的抱怨。
8.1 案例一:ARC-AGI-3 的 99.9% 与 62.7%
- 表面现象:一个说 99.99%,一个说 62.7%,还有一个草稿说 98.6%。
- 读分六问:谁跑的?ARC Prize 官方 + OpenAI 两方,都标了来源。什么支架?关键——一个是通用接口,一个是厂商适配。
- 结论:两者都对,但不共享同一套记忆规则。ARC Prize 从这次事件后决定:今后在排行榜上同时标注两种支架的结果,因为"一个不带支架标注的 ARC-AGI-3 分数已经无法用于比较"。
- 对你有用的部分:ARC Prize 明确指出,如果你的运行时不能在工具调用之间保留推理状态,那 99.9% 描述的是"别人的技术栈",你该参考的是 62.7% 那一行。
8.2 案例二:Terminal-Bench 4.0 的 0.2 分
- 表面现象:Astra 在 Terminal-Bench 4.0 上的分数,出现了 57.7% 与 57.9% 两种引用。
- 原因:两个数字都来自 OpenAI 自己,后者是重跑后的结果,替代了前者。
- 结论:0.2 分远在噪声内,但在对外表述时被替换为更高的那个。
- 对你有用的部分:看到两个近似数字在流传时,别急着判断谁错——先查是不是同一来源的不同版本。
8.3 案例三:ExploitBench 的「不可用档位」
- 表面现象:OpenAI 把前代模型 Sol 在内部网络安全评测 ExploitBench 上的成绩从 5.5% 上调到 11.5%。
- 问题所在:11.5% 来自一个当前并未向商业用户开放的推理档位。
- 结论:这是本节里方法论问题最严重的一处——用客户拿不到的能力,去和竞品的常规设置作对比。
- 对你有用的部分:比较任何两个数字之前,先确认它们在同一档位设置下测出。
8.4 案例四:奖金榜反向证明了 harness 的价值
这是本文最想留到最后的一个案例,因为它给出的是正向的证据。
ARC Prize 的 ARC-AGI-3 奖金赛第一阶段(2026 年 6 月 30 日截止评选)前三名,没有一家调用前沿 API:
|
名次 |
方案 |
模型 |
关键做法 |
|
1 |
The Duck ( Tufa Labs ) |
Qwen 3.6 27B ( FP8 ,本地) |
把棋盘写进代码解释器变成变量;三通道读取(渲染图 / ASCII 网格 / 分割工具);通过 " 淘汰最旧消息 " 突破上下文上限 |
|
2 |
Reki |
Gemma 4 31B (本地) |
把最近若干帧渲染成带标注图像,只要求返回一个 JSON |
|
3 |
forge |
Gemma 4 31B (本地) |
同上路线 |
前三名全部是可运行在笔记本级别的 27B / 31B 权重,并且按赛制要求必须开源(CC0 或 MIT-0)。
这一条还有个耐人寻味的发现:在 The Duck 的方案里,"手工精心设计的工具反而让模型变差,让它自由发挥反而变好"。
这直接呼应了第 2 章的结论:让分数上涨的往往不是更大的模型,而是更好的脚手架——而这类增益,恰恰是"换模型"永远买不到的。
9. 回到 Astra:它到底值不值得用
把前面所有分析收拢,给一个尽量诚实的结论:
第一,Astra 的能力是真实的,但它是"偏科式"的。 在计算机操作(ScreenSpot-Pro 92.7%、OSWorld 2.0 72.6%)、高阶数学(FrontierMath T4 97.6%)和网络安全(ExploitBench 100%)上,它的领先在多个来源下都能被观察到。但在通用推理上,它明确落后于同期的 Fable 5.1(人类最后考试带工具:57.2% vs 65.0%)。
第二,它的"代际跃迁"叙事并不牢固。 独立指数显示它与自家前代 Sol 差 0.3 分——在可复现的标准化评测里,Astra 是"第一梯队的一员",不是"断层第一"。
第三,它最亮眼的那个数字,需要额外条件才能复现。 99.9% 的 ARC-AGI-3 成绩建立在"保留推理状态 + 压缩长历史"之上。如果你的技术栈没有这两样东西,你的实际体验会更接近 62.7% 那一行。
第四,别被那 37 分吓到,也别被它说服。 ARC Prize 自己的结论是:即便饱和了 ARC-AGI-3,也不构成 AGI 的证明。他们设计这个基准的初衷,就是让"把它做满"不等于"实现 AGI"。
|
给不同人的一句话建议 |
|
10. 常见问题(FAQ)
Q1:99.9% 和 62.7% 到底哪个是 GPT-6 Astra 的真实水平?
两个都是真实测量结果,但对应不同条件。62.7% 是 ARC Prize 用通用标准支架(模型只能携带自己写下的笔记)测出的官方成绩;99.9% 是用 OpenAI 厂商适配支架(请求之间保留不透明推理状态、长对话压缩)测出的成绩。该参考哪个,取决于你自己的运行时能不能保留推理状态。
Q2:厂商自评的跑分是不是就不能信了?
不能一概而论。Epoch AI 把各家自报的 GPQA Diamond 分数与独立复跑对照,发现所有主要厂商的自报分数都落在置信区间内,没有系统性造假。能第三方复现的标准化基准,自评数据大体可信;自定义的、口径模糊的、竞品无法复跑的内部指标,可比性要打折扣。
Q3:什么是 benchmaxxing?
指在略有差异的测试条件之间反复重跑评测,直到头条数字更好看。它和"伪造数据"的区别在于:每个数字可能都是真实测出来的,问题在于选择公布哪一个、以及是否同步说明口径变化。Fortune 对发布页快照的比对显示,Astra 发布后幻觉率、竞品数学分、网络安全分都发生过变动。
Q4:看到"某某模型在某某基准领先 2 分",我该怎么判断?
三件事:① 若基准头部已聚集在 90 分以上,2 分通常落在噪声内;② 若样本量小(如 GPQA Diamond 仅 198 题,1 题约 0.5 分),2 分可能只是两三道题;③ 直接算置信区间——本文第 7.4 节的 Wilson 区间代码可以直接用,如果两个区间重叠,就不该据此选型。
Q5:为什么说"饱和的基准分差没有意义"?
当所有前沿模型都挤在天花板附近时,剩余差异主要由三件事构成:随机抽样波动、题目本身的质量问题(GPQA Diamond 约有 4%–6% 的题目存在争议)、以及评分器的非确定性。这些都不是能力差异。 一个实用判据是:2026 年的发布图表如果以 GPQA 或 AIME 打头,说明更有区分度的基准大概率没测出好看的结果。
Q6:什么是污染?怎么知道自己关注的基准有没有被污染?
污染指模型训练数据里包含了考题,使高分来自"回忆"而非"推理"。分三类:直接污染(题目原文)、间接污染(改写与解题讨论)、潜在污染(因该基准得分高而被选中检查点)。判断方法:题目是否公开、是否早于模型训练截止日、技术报告有没有给出污染分析、有没有私有留出版本。参考 GSM1k 的设计——用同分布但未公开的新题复测,成绩下滑即说明有记忆成分。
Q7:我不会做评测,有没有最低成本的验证方法?
有。取你自己真实的 50–200 个任务样本(覆盖正常情况和边界情况),固定同一套提示词和工具配置,把候选模型都跑一遍,记录"完成率 × 单任务成本"。这一步的价值远高于读任何评测表——因为企业实测中实验室分数与真实部署表现存在约 37% 的落差,而那个落差只能靠你自己的数据暴露。
Q8:ARC-AGI-3 拿了 99.9%,是不是说明接近 AGI 了?
ARC Prize 自己的回答是明确的"否"。他们在公布结果时写道:饱和这个基准"不构成实现 AGI 的证明"。该基准的设计初衷就是——把下一代基准需要解决的能力,与"把这一代做满"区分开。Astra 的成绩主要说明哪些能力已经不再构成障碍,而不是通用智能已经达成。
Q9:那 GPT-6 Astra 到底该不该用?
看你的任务落在哪一档。计算机操作、长周期工程任务、高价值专业文档、网络安全防御——这些是它领先明确成立的地方,值得试。通用长尾推理、需要微调或 embeddings 的场景、对成本极敏感的批量调用——这些不是它的主场,同价位或更低价位上都有更合适的选择。唯一的正确做法仍然是:用你的真实任务压测。
11. 相关问题(读者常搜)
12. 参考资料
本文数据与观点基于以下公开资料整理。部分指标存在多口径现象(例如 ARC-AGI-3 的 Astra 分数在官方、媒体转述、预发布草稿中分别出现过 62.7%、66%、99.9%、99.99%、98.6%,本文一律以 ARC Prize 官方结果页为准并标注支架),实际使用请以原始发布页为准。
12.1 评测结果与口径
- ARC Prize:OpenAI's GPT-6 Astra on ARC-AGI-3(含 12 种 harness 配置的完整结果表与成本)https://arcprize.org/blog/astra
- Astra's Adapter Beat the Reasoning Dial on ARC-AGI-3(支架差异与"不带标注的分数不可用"的讨论)https://www.worldprogramming.org/posts/astras-adapter-beat-the-reasoning-dial-on-arc-agi-3-s2w7vn
- GPT-6 Astra's ARC-AGI-3 score depends on which harness scored it(口径差异的复述与解读)https://aiinsiders.net/article/gpt-6-astras-arc-agi-3-score-depends-on-which-harness
- 以 Arc Prize 评测为切入的中文整理(含人类基线与符号化笔记行为)https://atii.edu-sjtu.cn/article/10135
12.2 发布后数据修订
- Startup Fortune:OpenAI Changed GPT-6 Astra's Benchmark Numbers Days After Its Launch(幻觉率、ExploitBench、FrontierMath 的变动时间线)https://startupfortune.com/openai-changed-gpt-6-astras-benchmark-numbers-days-after-its-launch
- Silicon Report:OpenAI alters benchmark scores for GPT-6 Astra after rollout delayhttps://www.siliconreport.com/openai-alters-benchmark-scores-for-gpt-6-astra-after-rollout-delay
- ExplainX:GPT-6 Astra Benchmarks: What OpenAI Changed, and Whyhttps://www.explainx.ai/blog/openai-astra-benchmark-numbers-changed-post-launch-2026
- IT之家(中文,含多份网页快照的具体数值对比)https://www.163.com/dy/article/L65CA7DM0511B8LM.html
12.3 独立指数与横评
- Artificial Analysis:Announcing the Artificial Analysis Intelligence Index v4.3(版本变更与 cost-per-task 方法)https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v4-3
- Requesty:stop comparing price per token(同一套评测在不同模型上的实测花费)https://www.requesty.ai/blog/cost-per-task-not-cost-per-token-llm-economics
- O-mega:GPT-6 Astra Pricing: Real Cost per Agent Task 2026(token 消耗与缓存占比)https://o-mega.ai/articles/gpt-6-astra-pricing-real-cost-per-agent-task-2026
- GPT-6 Astra vs Claude Fable 5.1: The Frontier Duel(两家自评表的逐行对照)https://codingfleet.com/blog/gpt-6-astra-vs-claude-fable-5-1/
12.4 基准饱和与污染
- AI Benchmarks in 2026: The Complete Guide(饱和状况、Goodhart 定律与刷分脆弱性)https://explainx.ai/blog/ai-benchmarks-complete-guide-2026
- GPQA Diamond 词条(198 题、专家基线、题目有效性复核与 ±2 分判定精度)https://aiwiki.ai/wiki/gpqa_diamond
- What Is a Contaminated LLM? Detection, Famous Cases, 2026 Guide(污染分类、GSM1k、时间门控与私有留出)https://llm-stats.com/blog/research/what-is-a-contaminated-llm
- How to Read a 2026 AI Benchmark Chart Without Getting Fooled(读图清单)https://dev.to/michael_lee_4c5625964438c/how-to-read-a-2026-ai-benchmark-chart-without-getting-fooled-2m5p
- AI Benchmarks & Evals 术语页(污染与饱和的判读建议)https://www.lumichats.com/glossary/ai-benchmarks