全文只回答一个问题:写下的一段 PySpark 代码,是如何变成集群中许多机器共同执行的任务,并最终产出结果的?
本文要点
- 一条主线走完全链路:代码 → 执行计划 → Job → Stage → Task → Shuffle → 输出
- Driver、Cluster Manager、Executor 各自做什么、不做什么
- 懒执行:为什么写完 filter() 不会立刻运行
- Job、Stage、Task、Partition 的层级关系——全文唯一需要记住的口诀
- Shuffle 为什么是性能成本最高的环节
- DataFrame、RDD、Dataset 应该怎么选
开始之前:一个最小心智模型
四句话,先不纠结细节:
全文用一个贯穿始终的例子——统计每个城市的成年用户数,并把结果写回对象存储。
业务背景:某 App 的全量用户注册数据按天增量写入 S3,目前累计 3 亿条用户记录,存成 Parquet 格式,共约 120GB。每条记录包含 user_id、city、age、注册时间等 20 多个字段。全国 300 多个城市的数据混在一起,城市人口规模差异很大——上海、北京各 2000 多万,而一些小城市只有几万。
任务目标:从 3 亿条用户记录中,过滤出 18 岁以上的成年用户,按城市分组计数,最终得到一张 300 多行的结果表(每行一个城市 + 该城市成年用户数),写回 S3 供下游报表系统读取。
result = (
spark.read.parquet("s3://data/users") # 读取 3 亿条用户记录(120GB)
.filter("age >= 18") # 过滤成年用户(约 2.1 亿条)
.groupBy("city") # 按城市分组(300+ 城市)
.count() # 每个城市的成年人数
)
result.write.mode("overwrite").parquet("s3://output/adult_by_city")
最终结果长这样:
| 北京 | 18,523,441 |
| 上海 | 16,892,103 |
| 广州 | 9,231,547 |
| … | … |
| 拉萨 | 28,392 |
这是一个典型的生产任务形态:
- 数据量大:120GB、3 亿行,单机内存装不下、读起来也慢到不可接受;
- 结果很小:从 3 亿行压成 300 多行,直接写回 S3,不拉回 Driver;
- 分布不均:城市人口差异大,Shuffle 时 DataFrame 的分区天然倾斜(北京/上海的分区特别大)。
下文每个概念都会落回这段代码——读到哪里、算到哪一步、数据有多大,都有具体数字可参照。
一 单次Spark 作业,到底经历了什么?
先走一遍流程,术语在需要时才引入。这段代码提交后:
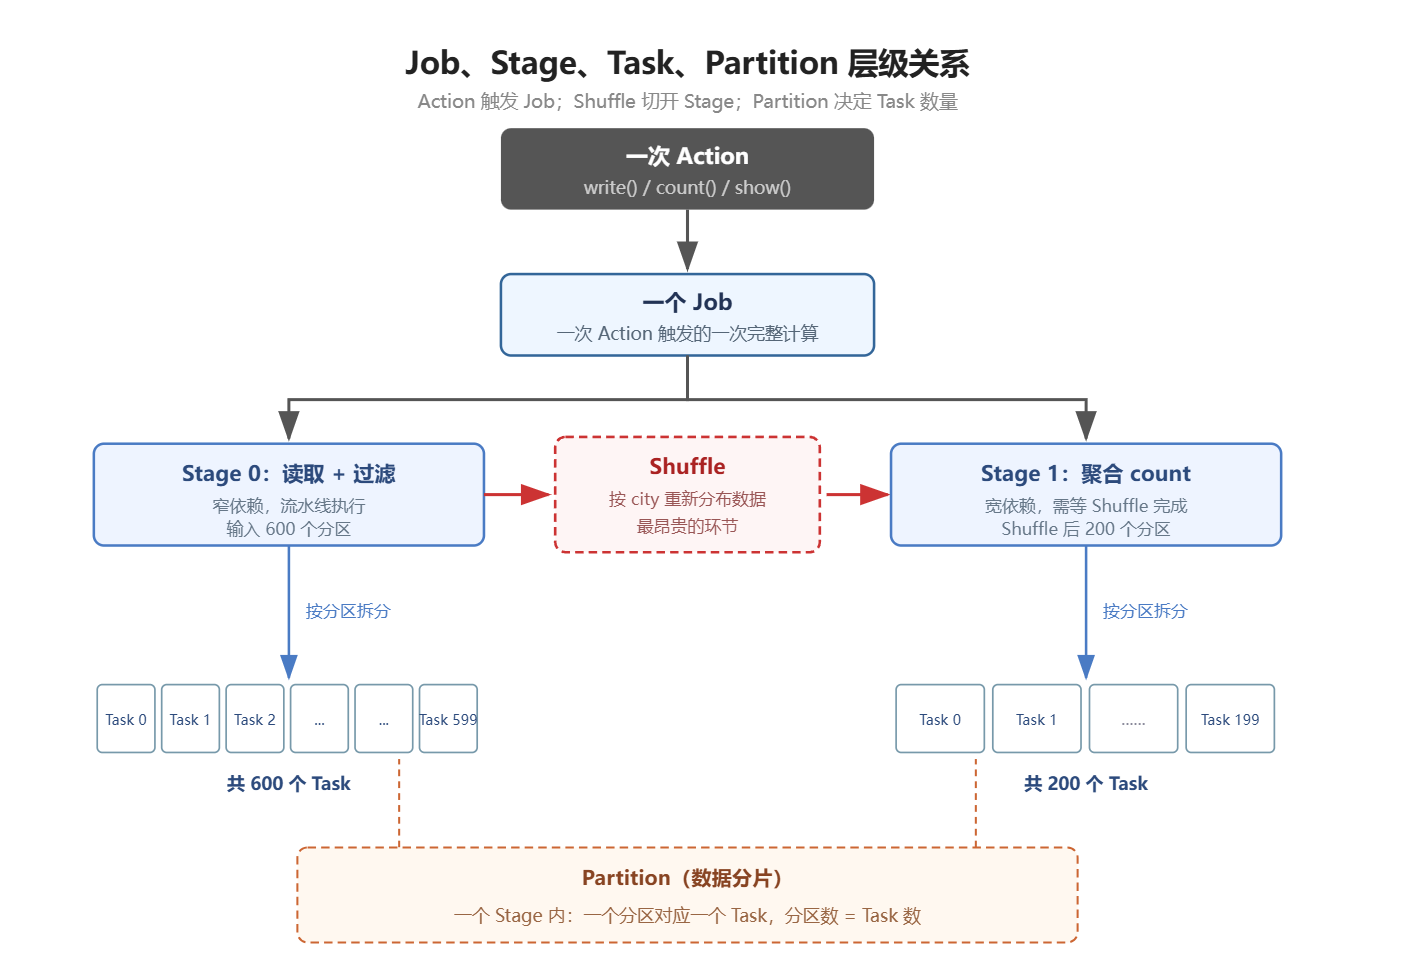
例子进展:read 要读 3 亿条 / 120GB 的用户表,S3 上按 200MB 一个文件块存储,DataFrame 读入后约 600 个分区。filter("age >= 18") 过滤掉约 9000 万条未成年用户,剩 2.1 亿条。groupBy("city") 要把 2.1 亿条按 300+ 城市重新分组,但此时还没执行——直到 write() 才真正触发。
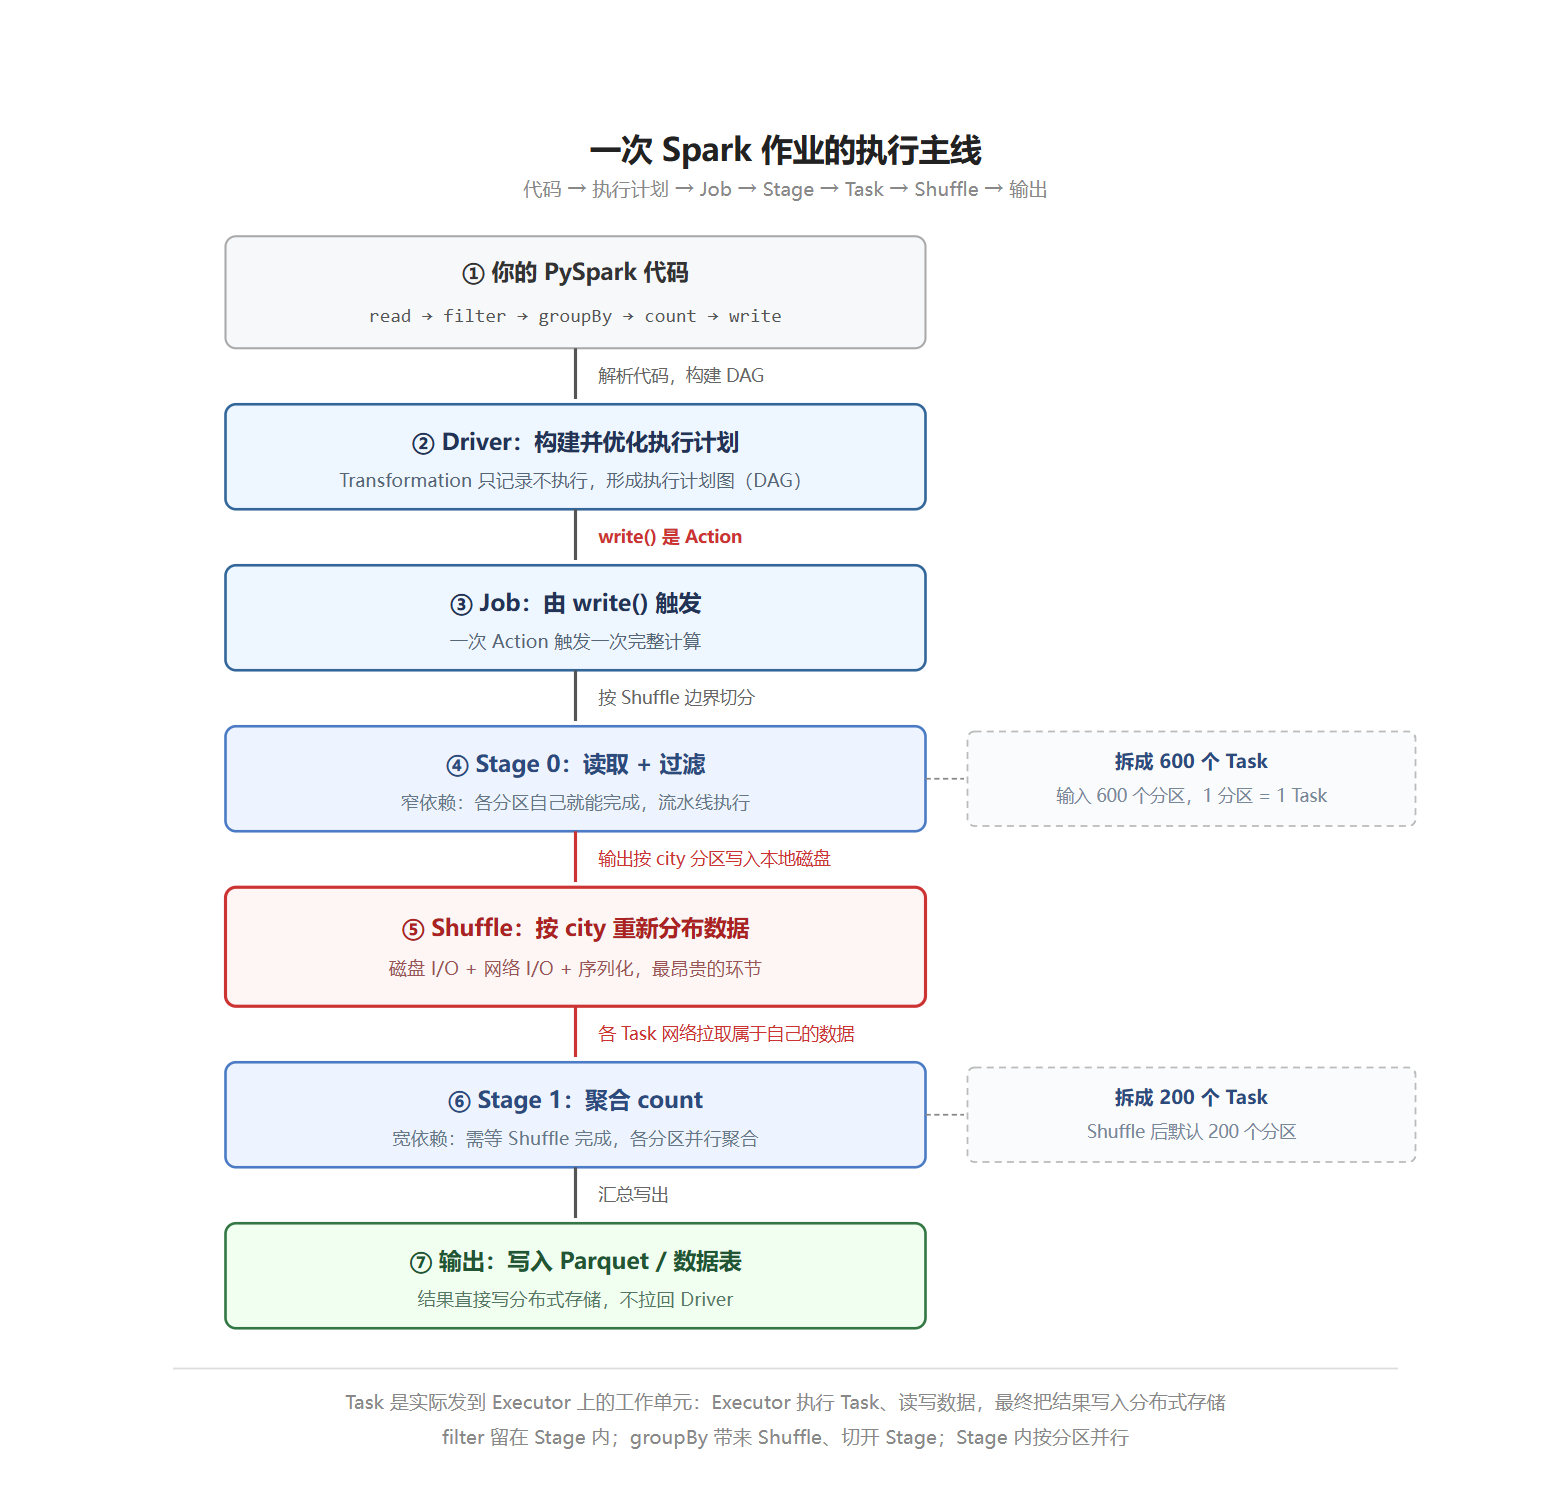
看懂这张图,只需要记住三个结论:
- filter 这类每个分区自己就能完成的操作,留在同一个 Stage 内;
- groupBy 这类必须把相同 Key 汇到一起的操作,会带来 Shuffle,从而形成新的 Stage;
- Stage 内部按分区并行,Task 才是实际发到机器上的工作单元。
后续章节依次展开链路中的每一环:谁在干活(二)、计划何时执行(三)、任务如何拆分(四)、数据如何重分布(五)、用哪套 API(六)。
二 谁在做什么:Driver、Cluster Manager、Executor
一次作业涉及的所有进程可以归为三个角色,职责边界非常清晰:
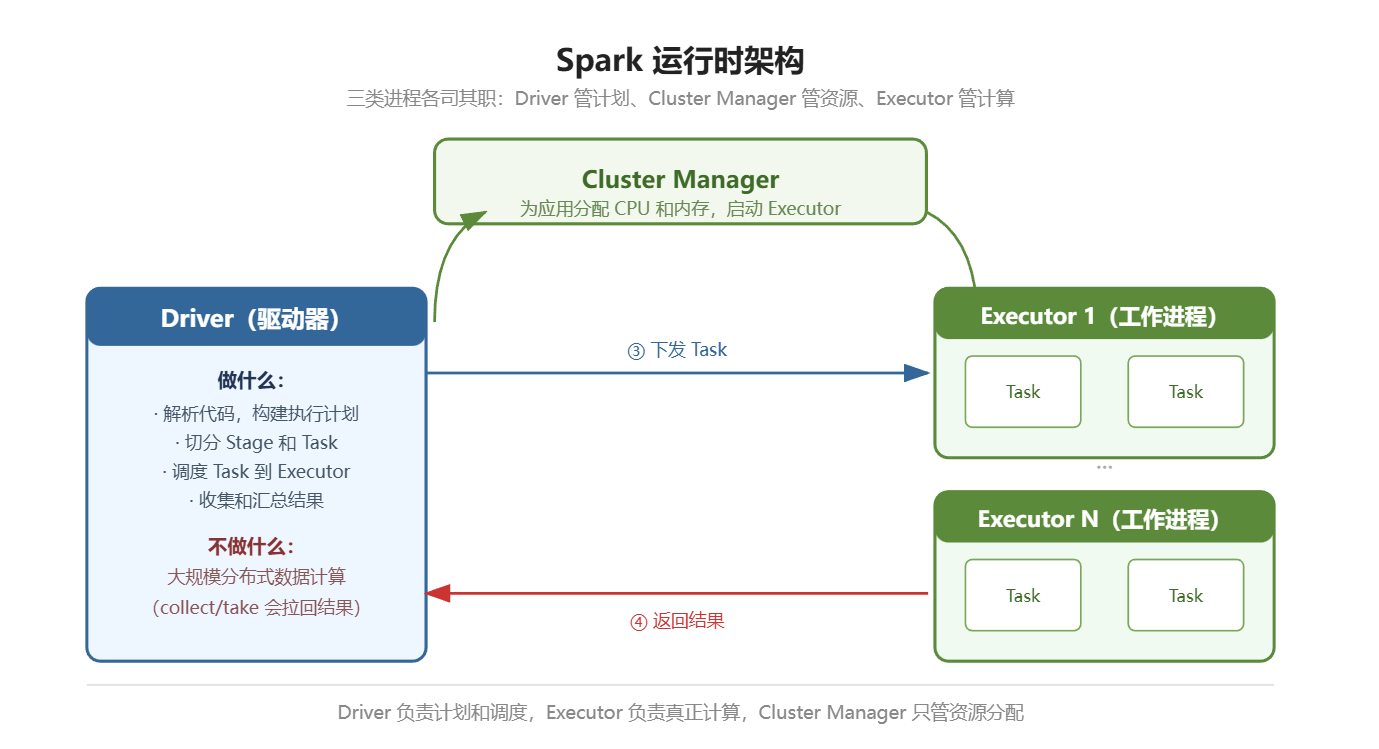
Driver(驱动器):把代码变成可调度的执行计划。 用户代码在 Driver 中运行,它负责解析代码、构建并优化执行计划、把计划切成 Stage 和 Task、向 Cluster Manager 申请资源、把 Task 分发给 Executor、跟踪执行状态并汇总结果。
Cluster Manager(集群管理器):为应用分配 CPU 和内存。 收到 Driver 的申请后,在各工作节点上启动 Executor 进程。它只管资源,不理解 SQL 或业务逻辑。常见实现:YARN、Kubernetes、Standalone。
Executor(执行器):执行 Task,读取、处理、写出数据。 一个 Executor 可同时运行多个 Task(数量取决于分配到的 CPU 核数),同时负责缓存数据与 Shuffle 数据的读写。
| Driver | 把代码变成可调度的执行计划 | 大规模分布式数据计算 |
| Cluster Manager | 为应用分配 CPU、内存,并启动 Executor | 理解 SQL 或业务逻辑 |
| Executor | 执行 Task,读取/处理/写出数据 | 决定整个 Job 如何切分 |
一个需要澄清的细节:常说"Driver 不参与数据计算",更准确的表述是大规模数据处理发生在 Executor;但 collect()、take() 等操作会把结果拉回 Driver,结果集过大时 Driver 也会内存溢出。这也是主例子用 write() 而不是 collect() 的原因——生产任务的结果一般直接写分布式存储。
本地调试时(master("local[*]")),Driver 和所有 Executor 运行在同一个 JVM 进程里,不需要 Cluster Manager;生产环境通常运行在 YARN 或 Kubernetes 上。
例子进展:write() 触发后,Driver 解析执行计划发现 groupBy 需要按 city 重分布 2.1 亿条数据,于是向 YARN 申请资源——假设申请 10 台机器 × 每台 1 个 Executor × 5 核 = 50 核。YARN(Cluster Manager)在各机器上启动 Executor 进程。Driver 随后把 Stage 0 的 600 个 Task 和 Stage 1 的 200 个 Task 依次分发给各 Executor 执行,Executor 各自读取本地 S3 数据分片、过滤、Shuffle 写盘、网络拉取、聚合,最终把每个城市一行结果写回 S3——300 多行结果,Driver 只收集确认信息。
数据本地化:计算和存储在同一台机器上吗?
主例子用 S3 存储,Executor 从 S3 读取数据时必须走网络——S3 是远程对象存储,数据不在任何 Executor 的本地磁盘上。这叫没有数据本地化。
如果换成 HDFS,情况不同。HDFS 把数据块分散存在各 DataNode 上,Spark 会优先把 Task 调度到数据所在的节点,让 Task 直接读本地磁盘,避免网络传输。这叫数据本地化(Data Locality):
| PROCESS_LOCAL | Task 和数据在同一个 Executor 进程里 | 最快(内存/本地盘) |
| NODE_LOCAL | Task 和数据在同一台机器上,但不同进程 | 快(本地盘) |
| RACK_LOCAL | Task 和数据在同一个机架的不同机器上 | 中等(机架内网络) |
| ANY | 数据在其他机架上 | 最慢(跨机架网络) |
例子进展:因为数据在 S3 上,Stage 0 的所有 Task 都是网络读取,Spark 无法优化数据本地化。如果数据存在 HDFS 上,600 个数据块分布在 10 台 DataNode 上,Spark 会尽量把 Task 0 调度到存了对应数据块的那台机器上。
常见误区
| 一个 Executor 只能跑一个 Task | 一个 Executor 可以同时跑多个 Task,由分配的 CPU 核心数决定 |
| Driver 完全不碰数据 | collect() / take() 会把结果拉回 Driver,结果集过大时 Driver 会 OOM |
| collect() 只是多返回一些数据 | collect() 会将全量数据拉取到 Driver 内存中,大数据量下直接 OOM,生产环境慎用 |
三 懒执行:为什么写完 filter() 没有立刻运行?
这一节只回答一个问题:Spark 为什么非要等到 Action 才开始计算?
先把时间线说清楚。一段 PySpark 代码从写到跑,分两个阶段:
| 构建计划 | 调用 read / filter / groupBy / count | 运行这些代码,逐步构建逻辑计划;Catalyst 做基础分析(检查列名是否存在、类型对不对) | 没有 |
| 触发执行 | 调用 write(Action) | Catalyst 优化计划(列裁剪、谓词下推)→ DAG Scheduler 切分 Stage → Task Scheduler 拆分 Task → 下发 Executor | 从这一刻开始 |
一个容易混淆的点:write 本身就是 Action。不是"write 触发了某个 Action",而是 write = Action → 直接触发 Job。count() 在 .groupBy("city").count() 那个位置,看起来像 Action,但它返回的是一个新的 DataFrame(Transformation),不触发执行——只有最后的 write() 才是真正的 Action。
write 不是唯一的 Action。常见的 Action 有:
| write.parquet(…) | 无(写出文件) | 是 |
| df.count() | 一个数字(long) | 是 |
| df.show() | 打印到控制台 | 是 |
| df.collect() | Python 列表 | 是 |
| df.take(n) | Python 列表 | 是 |
但如果 count() 跟在 groupBy() 后面,它是 Transformation 不是 Action:df.count() 直接返回一个数字(触发执行),而 df.groupBy("city").count() 返回一个新的 DataFrame(不触发)。区别在于返回类型——返回 DataFrame 说明 Spark 还在"描述计划",返回具体结果说明你在"要答案"。
如果你把 age 拼成 ag,Spark 在调用 .filter("ag >= 18") 时就会报错(列不存在),不用等到 write。这说明基础分析在 Transformation 阶段就做了一部分,但优化和执行一定要等 Action。
write() 触发后的执行顺序:
write() 触发
→ Catalyst 优化整个计划(看到 groupBy 是宽依赖,标记 Shuffle 边界)
→ DAG Scheduler 按 Shuffle 边界切分 Stage
→ 执行 Stage 0(Map 端:读 → filter → hash 分区写本地盘)
→ Stage 0 全部完成后,Shuffle 自然发生(Reduce 端拉数据)
→ 执行 Stage 1(Reduce 端:排序 → count → write 到 S3)
groupBy 不会"预触发 Shuffle"——Catalyst 在分析阶段发现"这里需要跨节点重分布数据",标记为 Stage 切分点。Shuffle 在 Stage 0 执行完之后自然发生:Map Task 写完本地盘,Reduce Task 才开始拉。
Spark 的操作分两类:
- Transformation(转换):描述"如何变换数据",如 select、filter、groupBy。调用时不执行任何计算,只把这一步追加到 Driver 内部的执行计划图里,返回一个新的 DataFrame;
- Action(行动):真正要求"给出结果"或"写出去",如 count、show、write。调用 Action 时,Spark 才把完整计划提交执行。
主例子中,前四行全是 Transformation,只有最后一行 write 是 Action:
spark.read.parquet(...) # Transformation:只记录"读取 3 亿条、20 列"
.filter("age >= 18") # Transformation:只记录"过滤掉未成年"
.groupBy("city") # Transformation:只记录"按城市分组"
.count() # Transformation:只记录"计数"
.write.parquet(...) # Action:触发!以上全部开始执行
例子进展:写 read 时 Spark 不读数据,只记下"要读 s3://data/users"。写 filter 时不执行过滤,只记下"保留 age>=18"。写 groupBy 时不分组,只记下"按 city 分组"。直到 write(),Driver 才把整条计划交给 Catalyst 优化——Catalyst 看到 filter 后面只用了 city 和 age 两列,于是做了列裁剪:读 Parquet 时只读这两列,跳过 user_id、注册时间等 18 列。120GB 的数据实际只读约 12GB。
懒执行的价值:Spark 能看到完整链路后再优化。 懒执行的主要原因不是"内存存不下所以要等"——内存不够时 Spark 有自己的溢写(Spill)机制。真正的原因是让 Catalyst 在动手前看到完整计划,从而做全局优化。
如果每写一行就立刻执行,read 必须把整张表的所有列读进来——哪怕后面的 filter 会丢掉大部分行。懒执行让 Spark 在动手前看到全貌,从而可以:
- 列裁剪:只读取后续真正用到的列;
- 谓词下推:把过滤条件推到数据源层,读数据时就跳过不需要的行;
- 流水线执行:同一个 Stage 内的多个操作连续执行,中间结果不落盘。
进阶:Catalyst 优化器与 Tungsten 引擎做了什么?
DataFrame 的执行计划由 Catalyst 优化器处理,分四步:分析(检查表名、列名、类型)→ 逻辑优化(应用谓词下推、列裁剪等规则)→ 物理计划生成(如 Join 选择 SortMergeJoin 还是 BroadcastJoin)→ 代码生成(Whole-Stage CodeGen,把物理计划编译为优化的字节码)。Tungsten 引擎负责堆外内存管理与二进制数据格式,减少 JVM GC 开销。初学阶段知道"执行计划会被自动优化"即可,性能调优篇再展开。
常见误区
| 调用 filter() 后数据就被过滤了 | filter() 是 Transformation,仅记录操作不执行。只有 Action 才触发计算 |
| cache() / persist() 会立即缓存数据 | 也是惰性的,需要等第一次 Action 触发后数据才会真正被缓存 |
| orderBy 是窄依赖 | 排序需要全局有序,必须经过 Shuffle 将相同 Key 的数据拉到同一分区,属于宽依赖 |
四 Job、Stage、Task、Partition:最容易混淆的一组
前面讲了物理角色(Driver/Executor),也提了逻辑概念(Job/Stage/Task),这些概念混在一起容易晕。先用一张表把它们分到正确的层:
| 是什么 | 计算任务的拆分方式 | 数据的物理分片 + 实际跑在机器上的进程 |
| 概念 | Job → Stage → Task | Partition、Driver、Executor |
| 类比 ES | Index → 查询计划 → 查询子任务 | Shard、Coordinating Node、Data Node |
| 因果关系 | Task 是计划:“去处理分区 N” | Partition 是 DataFrame 的物理分片:实实在在存在磁盘上 |
简单说:逻辑层是"怎么算",物理层是"在哪算、算什么数据"。 Task 是两者的桥梁——逻辑层定义了 200 个工作指令("处理分区 0"“处理分区 1”……),物理层的 Executor 接收并执行这些指令。
这四个概念的层级关系如下:
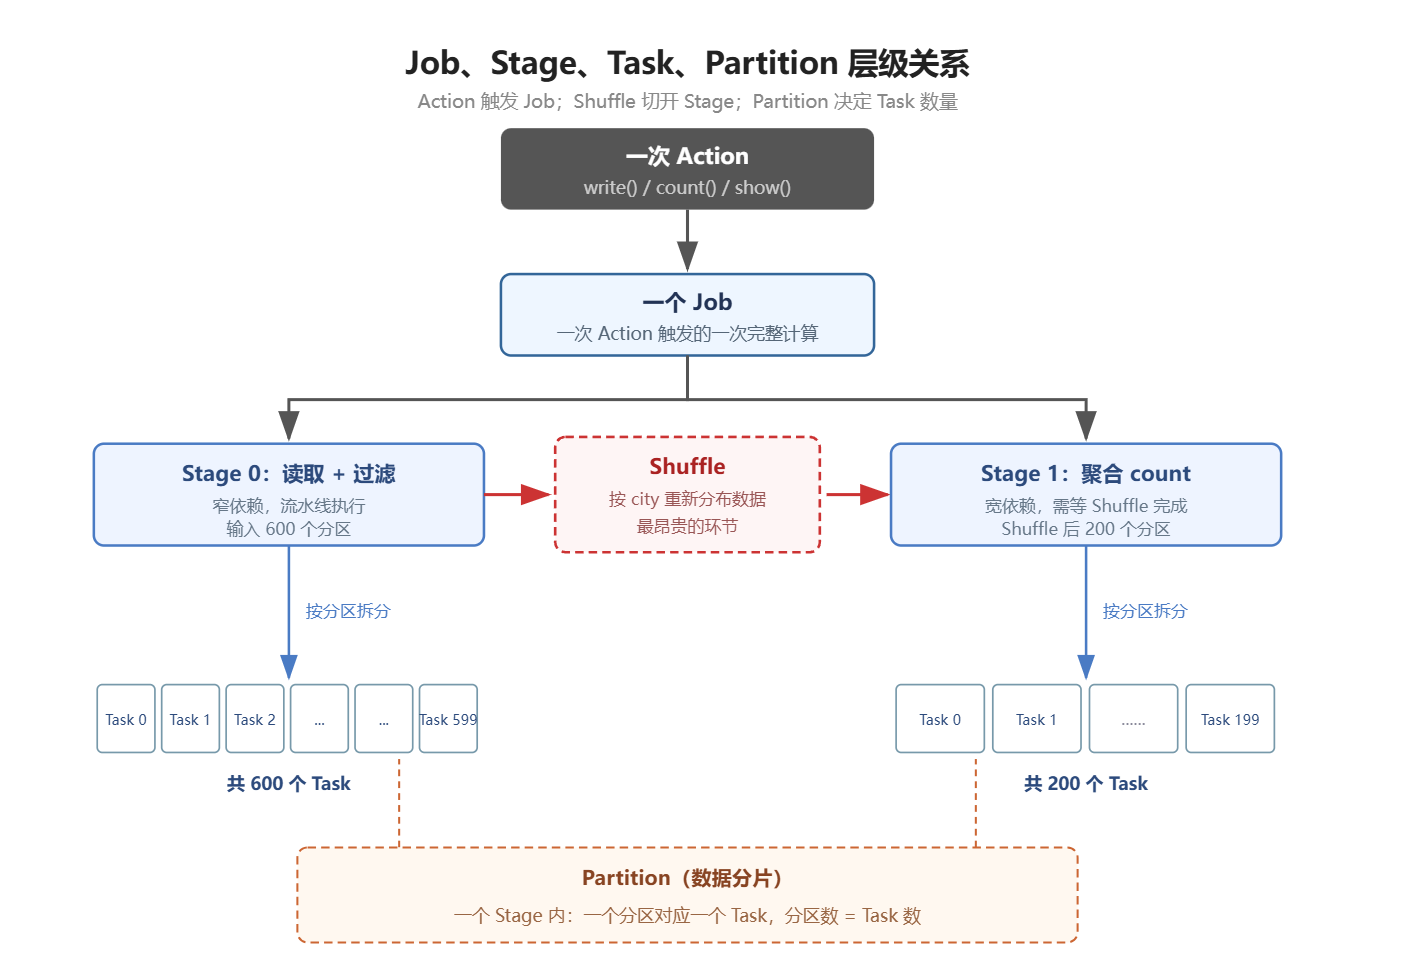
一句口诀:
Action 触发 Job;Shuffle 切开 Stage;Partition 决定 Task 数量。
- Job:一次 Action 触发的完整计算。一段脚本里若有 3 个 Action,就会产生 3 个 Job;
- Stage:Job 按 Shuffle 边界切分出的阶段。Stage 内的操作(如 Read → Filter)不需要跨节点交换数据,可在各节点流水线执行;
- Partition:DataFrame 在物理上的分片——一张 DataFrame 逻辑上是一整张表,但物理上被切成多份。读文件时分区数通常由文件块数决定,但小文件可被合并(spark.sql.files.maxPartitionBytes 默认 128MB,多个小文件可合并成一个分区),大文件也可被切分。Shuffle 之后分区数由 spark.sql.shuffle.partitions 控制(默认 200);
- Task:Driver 下发的工作指令——“去处理第 N 号分区,把 Filter、GroupBy 这些操作对它执行一遍”。一个 Stage 内,Task 数 = 分区数——你不能独立配置 Task 数,它是从分区数派生的。同一分区同一时刻不会被两个 Task 处理(由调度器保证),但如果分区数大于 CPU 核数,Task 会分批串行执行。Task 不是物理实体,是 Driver 分配工作的单位,Spark UI 中的进度就是 Task 的完成情况。
分区数、Task 数、文件数三者的关系:这三者不是一回事。分区数决定 Task 数(派生关系),但分区数和文件数不是严格一对一——300 个小文件可能被合并成 200 个分区(→ 200 个 Task),一个大文件也可能被切成多个分区。配置 spark.sql.shuffle.partitions = 200 意味着 Shuffle 后有 200 个分区,对应 200 个 Task,但最终写出多少个文件也由这 200 个分区决定(默认每个分区写一个文件,即 200 个输出文件,不管这些文件大小如何)。
逻辑层与物理层:一张图看清关系
Spark 的概念可以分成逻辑层和物理层,两者之间的映射关系不同:
物理层 逻辑层 物理层
────── ────── ──────
文件(磁盘上) ──N:M──▶ Partition(逻辑分片)──1:1──▶ Task(工作指令)──N:M──▶ Executor 核(CPU)
不严格一对一 严格一对一 不严格一对一
| 文件 → 分区 | N:M(不严格) | 小文件可合并成一个大分区,大文件可切成多个分区 |
| 分区 → Task | 1:1(严格) | 一个分区对应一个 Task,逻辑层内部确定不变 |
| Task → CPU 核 | N:M(不严格) | Task 数 > 核数时分批串行,一个核在不同时刻跑不同 Task |
规律:逻辑层内部(分区 → Task)是严格 1:1 的,物理与逻辑之间(文件 → 分区、Task → 核)是弹性 N:M 的。理解了这个框架,就不会混淆"为什么 300 个文件只有 200 个 Task"或"为什么 200 个 Task 只有 50 个在跑"。
Map Task 和 Reduce Task:Stage 的标签,不是操作的标签
前文多次提到"Map Task"和"Reduce Task",这里澄清它们的准确含义。Map/Reduce 标签取决于 Stage 在 Shuffle 的哪一侧,不取决于这个 Task 做了什么操作。
Stage 0(Shuffle 前) Shuffle(数据搬运) Stage 1(Shuffle 后)
├── 600 个 Map Task (不是 Task,是 ├── 200 个 Reduce Task
│ 读 → filter → Stage 之间的 │ 拉数据 → 排序 → count →
│ 写 Shuffle 数据到本地盘 数据搬运过程) │ 写结果到 S3
│ │
└── 整批叫 "Map Task" └── 整批叫 "Reduce Task"
- Map Task:Shuffle 前的 Stage 里的所有 Task。不管它们做的是 read、filter 还是别的操作,都叫 Map Task——因为它们产出数据交给 Shuffle;
- Reduce Task:Shuffle 后的 Stage 里的所有 Task。不管做的是 count、filter 还是别的操作,都叫 Reduce Task——因为它们消费 Shuffle 搬运过来的数据;
- Shuffle 不是 Task,是 Stage 之间的数据搬运过程(Map 端写本地盘 → Reduce 端网络拉取)。
一个容易混淆的场景:如果 groupBy("city").count() 后面再加一个 .filter("count > 1000000")(过滤掉小城市),这个 filter 会产生新的 Shuffle 吗?不会——它是窄依赖,每个分区各自过滤自己的行,留在 Stage 1 里。Stage 1 的 Task 依然是 Reduce Task,即使它们做了 filter。Map/Reduce 标签看的是"在 Shuffle 哪一侧",不是"做了什么操作"。
主例子中,Stage 0 共 600 个 Map Task,Stage 1 共 200 个 Reduce Task,整个 Job 总计 800 个 Task:
| Stage 0 | 600 | 输入分区数(120GB ÷ 200MB) | 读 S3 → filter → 写 Shuffle 到本地盘 | Map Task |
| Stage 1 | 200 | spark.sql.shuffle.partitions(默认 200) | 网络拉取 → 排序 → count → 写 S3 | Reduce Task |
spark.sql.shuffle.partitions = 200 配置的是 Reduce Task 的数量,和 Map Task 的 600 没有关系。
Spark 内部更精确的叫法:
| ShuffleMapTask | Map Task | 这个 Stage 的输出还会喂给下一个 Shuffle |
| ResultTask | Reduce Task | 这个 Stage 产出最终结果,不再 Shuffle |
如果作业中有多次 Shuffle(比如 groupBy 之后又 join),中间的 Stage 既是上一次 Shuffle 的 Reduce 端、又是下一次 Shuffle 的 Map 端。此时 Spark 按它的最终输出去向来定标签:输出喂给下一个 Shuffle 叫 ShuffleMapTask,产出最终结果叫 ResultTask。
主例子的数字推演
回到主例子。S3 上 120GB 数据按 200MB 一个文件块,DataFrame 读入后约 600 个分区:
注意因果关系:Task 数量由当前 Stage 的分区数决定,与机器数量无关;所有 Executor 的 CPU 核数总和才决定这些 Task 能同时运行多少个。
一个 Executor 是一个 JVM 进程,可以分配多个 CPU 核(如 –executor-cores 5),每个核同时跑一个 Task。一台物理机器上可以运行多个 Executor,但更常见的是一台机器一个 Executor、分配多个核。集群若有 50 个核(比如 10 台机器 × 每台 1 个 Executor × 5 核),Stage 0 的 600 个 Task 分 12 批跑完,Stage 1 的 200 个 Task 分 4 批跑完。
Task 总数 vs 同时运行数:这是两件不同的事。600 个 Task 是 Driver 生成的工作指令数量(由分区数决定),50 核是集群能同时执行多少个 Task(由 CPU 核数决定)。就像快递站有 600 个包裹、50 个快递员——不是只能送 50 个,而是 50 个一批分 12 批送完:
时间 →
批次1: Task 0 Task 1 Task 2 … Task 49 ← 50核同时跑
批次2: Task 50 Task 51 Task 52 … Task 99 ← 跑完一批,换下一批
…
批次12: Task 550 Task 551 Task 552 … Task 599 ← 最后一批
| Task 总数 | 分区数(600) |
| 同时能跑几个 Task | CPU 核数(50) |
| 跑完整批要多少轮 | 600 ÷ 50 = 12 批 |
理想情况下,分区数 ≈ CPU 核数的整数倍,让每个核刚好跑完整的一轮或多轮,不浪费也不积压太多。如果分区远大于核数(如 6000 分区 / 50 核),每个 Task 只处理很小一块数据,调度开销反而比计算还大;如果分区远小于核数(如 10 分区 / 50 核),40 个核闲着。
组 vs 分区:为什么 300 个城市不是 300 个 Task?
这是最容易卡住的地方。groupBy("city") 有 300+ 个城市,但 Task 数是 200(由 spark.sql.shuffle.partitions 控制),不是 300。原因:Spark 用 hash(city) % 200 把数据分到分区,组和分区不是一一对应:
300+ 个城市 → hash 到 200 个分区
分区 0:北京 + 南京 + 贵阳的数据(3 个城市碰巧 hash 到同一分区)
分区 1:上海的数据
分区 2:(空的,没有城市 hash 到这里)
…
分区 47:广州 + 深圳的数据
一个 Task 处理一个分区,一个分区里可能有多个组(城市),这完全正常。Task 拿到分区后,把里面所有行按 city 排好序,逐个城市做 count 聚合——分区 0 的 Task 会算出北京多少人、南京多少人、贵阳多少人,各自出结果。
| 组(group) | groupBy 的 Key,逻辑概念 | 300+ 个城市 |
| 分区(Partition) | DataFrame 物理切分,由配置决定 | 200 个(spark.sql.shuffle.partitions) |
| Task | 处理一个分区的工作指令 | 200 个(= 分区数) |
唯一的问题叫数据倾斜:北京 2000 万行、拉萨 3 万行,恰好 hash 到同一个分区,这个 Task 的数据量远大于其他 Task,跑得最慢。这个在 Join 篇与性能调优篇展开。
常见误区 & 分区数如何确定
| 分区数越多并行度越高,所以分区越多越好 | 分区过多会导致 Task 调度开销增大、单 Task 数据量过小(通常建议单分区 128~256MB),反而变慢 |
| groupBy N 个 Key 就产生 N 个 Task | Task 数由 spark.sql.shuffle.partitions(默认 200)决定,与 Key 数量无关 |
| 一个 Task 对应一张表 | 一个 Task 对应 DataFrame 的一个分区——表被物理切成多份后的一份 |
DataFrame 的分区数在不同阶段动态变化:
| spark.read 读取 HDFS/S3 文件 | 通常等于文件块数(HDFS 默认 128MB/块),小文件可被合并 |
| Shuffle 后(join/groupBy/orderBy) | 由 spark.sql.shuffle.partitions 控制,默认 200 |
| df.repartition(n) | 手动重分区为 n 个(触发 Shuffle) |
| df.coalesce(n) | 合并为 n 个分区(不触发 Shuffle,仅用于减少分区) |
五 Shuffle:为什么它是性能核心?
为什么必须发生? groupBy("city") 要求所有 city 为"北京"的行由同一个 Task 处理,但它们一开始分散在各个节点上:
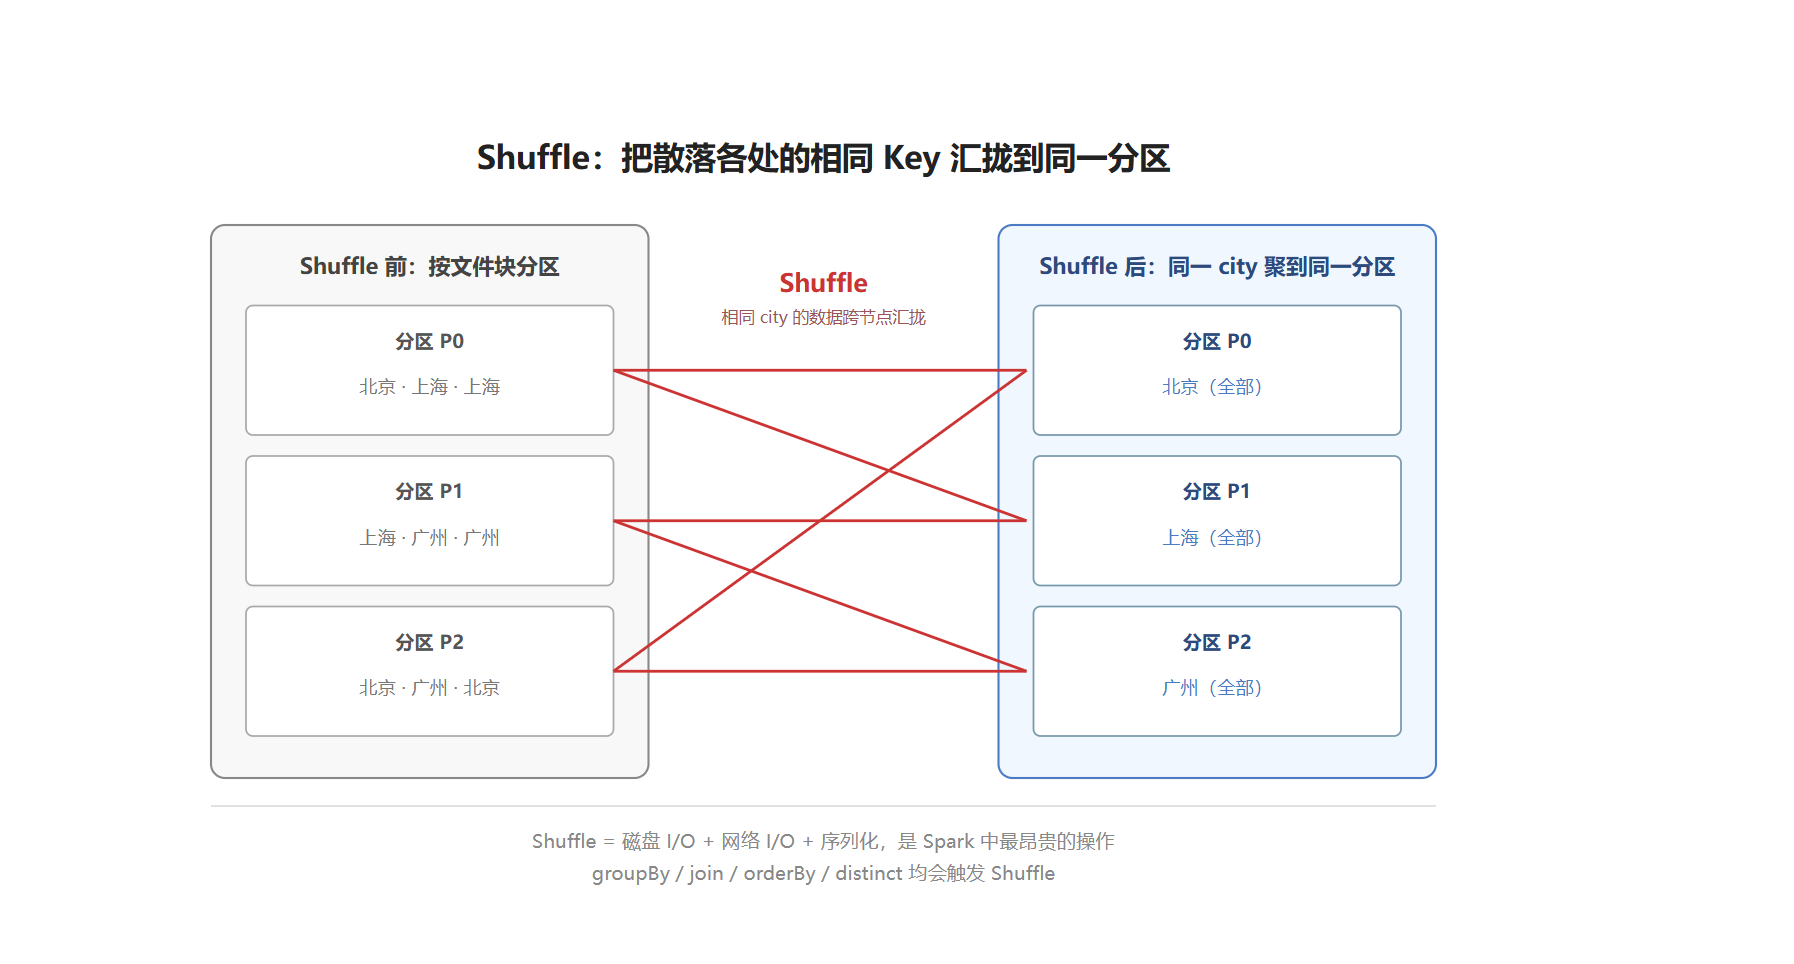
Shuffle 之前,DataFrame 按文件块分区,每个分区混着多个城市的行;Shuffle 之后,相同 city 的数据聚到了同一个分区。这个把散落各处的相同 Key 汇拢的过程,就是 Shuffle。
例子进展:Shuffle 前,2.1 亿条数据分散在 600 个分区里,每个分区约 35 万行混着北京、上海、拉萨等城市的用户。Shuffle 时,每个 Map Task(共 600 个)把自己的数据按 hash(city) % 200 分成 200 份写入本地磁盘——Map 端不做 groupBy 聚合计算,只做 hash 分区写盘。然后 200 个 Reduce Task 各自通过网络从 600 个 Map Task 那里拉取属于自己的那份数据——比如 Reduce Task 0 拉取所有 hash(city) % 200 == 0 的数据,可能是北京 + 南京 + 贵阳的行,拉到后在内存里按 city 排序、做 count 聚合。这个阶段要写 600 × 200 = 12 万个磁盘文件,再网络传输 2.1 亿条数据,是整个作业最慢的环节。
分区在不同阶段是什么形态?
容易混淆的一点:分区不总是文件。它在执行过程的不同阶段形态不同:
| 读入时(Stage 0 输入) | 一个 Parquet 文件块 | S3 / HDFS 上 | 是,本来就存在的文件 |
| Shuffle 过程中 | 临时 Shuffle 数据 | Executor 本地磁盘 | 临时文件,作业结束就删 |
| Shuffle 后(Stage 1 输入) | 内存中的数据结构 | Executor 内存(太大就溢写磁盘) | 不是文件 |
| 最终输出 | 写到 S3 的结果文件 | S3 上 | 是,新产生的文件 |
主例子的文件生命周期:
输入:S3 上 600 个 Parquet 文件(120GB,本来就在)
↓ read
600 个分区(对应这 600 个文件)
↓ filter(不产生新文件,内存里处理)
仍是 600 个分区
↓ Shuffle Write
600 个 Executor 本地磁盘上的临时文件(600 × 200 = 12 万个小文件)
↓ Shuffle Read(网络拉取)
200 个内存中的分区(不是文件!)
↓ count 聚合
200 个内存中的结果分区
↓ write 到 S3
输出:S3 上 200 个新 Parquet 文件(每个很小,总共才 300 多行)
Spark "内存计算"的准确含义
Map Task 和 Reduce Task 都是 Executor JVM 进程里的一段计算代码,核心计算(filter、count、聚合)确实在内存中执行。但整个过程并非"全程在内存里":
| Map Task(Stage 0) | S3 网络 / HDFS 本地盘 | Executor 内存 | Executor 本地磁盘(Shuffle Write) |
| Reduce Task(Stage 1) | 其他 Executor 本地盘(网络拉取) | Executor 内存 | S3 / HDFS |
三个不在内存里的环节:
所以"Spark 是内存计算引擎"的准确含义是:计算逻辑在内存中执行,但数据流动经过磁盘和网络。 不是"所有数据从头到尾都在内存里"——那是缓存(cache() / persist())才有的效果,而且缓存也是可选的。
什么时候写磁盘,什么时候纯内存?
有明确规则:
一定写磁盘(不可配置):
| Shuffle Write | Executor 本地磁盘 | Map 端结果必须落盘,Reduce 端才能通过网络拉取 |
| 最终输出 | S3 / HDFS | write() 的结果,持久存储 |
纯内存计算(不落盘):
| filter / select / map(窄依赖) | 读进来在内存处理完就传给下一个操作,不需要写盘 |
| 同一 Stage 内流水线操作 | 多个窄依赖连续执行,中间结果在内存传递 |
内存不够时自动溢写磁盘(Spark 自动决定):
| Reduce 端排序/聚合 | 数据量超过 Executor 内存 | 本地磁盘(Spill) |
| Reduce 端拉取数据 | 拉到的数据 + 正在处理的数据超过内存 | 本地磁盘(Spill) |
可选缓存(手动控制):
df.persist(StorageLevel.MEMORY_ONLY) # 只缓存在内存,放不下的分区不缓存
df.persist(StorageLevel.MEMORY_AND_DISK) # 先放内存,放不下溢写到磁盘
df.cache() # 等同于 MEMORY_ONLY
| 窄依赖计算(filter) | 否 | 是 | 否 |
| Shuffle Write | 是 | 否 | 否 |
| Shuffle Read + 聚合(内存够) | 否 | 是 | 否 |
| Shuffle Read + 聚合(内存不够) | 是(Spill) | 是 | 否 |
| cache / persist | 看级别 | 看级别 | 是 |
| 最终 write 输出 | 是(S3/HDFS) | 否 | 否 |
为什么 Shuffle 比窄依赖贵得多?
窄依赖也有网络 I/O(从 S3 读数据),为什么 Shuffle 还是瓶颈?区别在于通信模式:
| 网络 | 600 个 Task 各读自己的 1 个文件块,并行 1 对 1 | 200 个 Reduce Task 各从 600 个 Map Task 拉数据,M×N = 12 万次连接 |
| 磁盘 | 无(读进来在内存算完就结束了) | Map 端写本地磁盘 + Reduce 端可能溢写磁盘 |
| 序列化 | 不需要(内存里直接处理) | 写磁盘要序列化,读回来要反序列化 |
| 等待 | 不等别人,各算各的 | 所有 Map Task 必须全部完成,Reduce Task 才能开始拉数据 |
| 排序 | 不需要 | Reduce Task 拉到数据后要按 Key 排序才能聚合 |
窄依赖像 600 个人各自去图书馆借一本不同的书,互不影响;Shuffle 像 600 个人写完报告后,200 个人要从这 600 个人手里各收一份章节——所有人写完才能开始收,而且收回来还要按章节排序。
为什么贵? 综合以上:
- 磁盘 I/O:Map 端把输出按 Key 分区后写入本地磁盘;
- 网络 I/O:Reduce 端 Task 通过网络从所有 Map 端拉取属于自己的数据(M×N 连接);
- 序列化/反序列化:数据在传输前后需要转换格式;
- 排序:Reduce Task 拉到数据后要按 Key 排序才能聚合;
- 等待:Reduce 必须等所有 Map 完成才能开始。
groupBy、大多数 join、orderBy、distinct 都会触发 Shuffle。数据量大时,Shuffle 往往占据作业耗时的大头,是性能调优的第一关注点。
优化第一原则:
数据倾斜、Shuffle 分区数调优、广播 Join 等实战手段,将在 Join 篇与性能调优篇展开。
常见误区
| Shuffle 是"把数据打乱"这么简单 | 涉及 Map 端磁盘写、网络传输、Reduce 端拉取和排序聚合,是 Spark 中最昂贵的操作 |
| 血缘关系 = 数据备份 | 不是。血缘记录的是"计算过程"而非"数据副本",容错靠重算而非复制 |
六 DataFrame、RDD、Dataset:该怎么选?
前文一直在说 DataFrame,这里补齐 Spark 的三层数据抽象。结论先行:
| DataFrame | 结构化数据处理、SQL、ETL、绝大多数业务任务 | 默认选择 |
| RDD | 需要低层控制或处理特殊非结构化对象 | 知道即可,按需使用 |
| Dataset | Scala / Java 的强类型 API | PySpark 中无需单独学习 |
一句话理解差别:DataFrame 带有 Schema(列名和类型),Spark 更容易理解代码意图,并据此生成更好的执行计划。 RDD 是不带结构的数据集合,Spark 只知道它是一堆对象,无法自动优化;Dataset 是 DataFrame 的强类型版本,仅 Scala/Java 可用,PySpark 中 DataFrame 就是 Dataset[Row]。
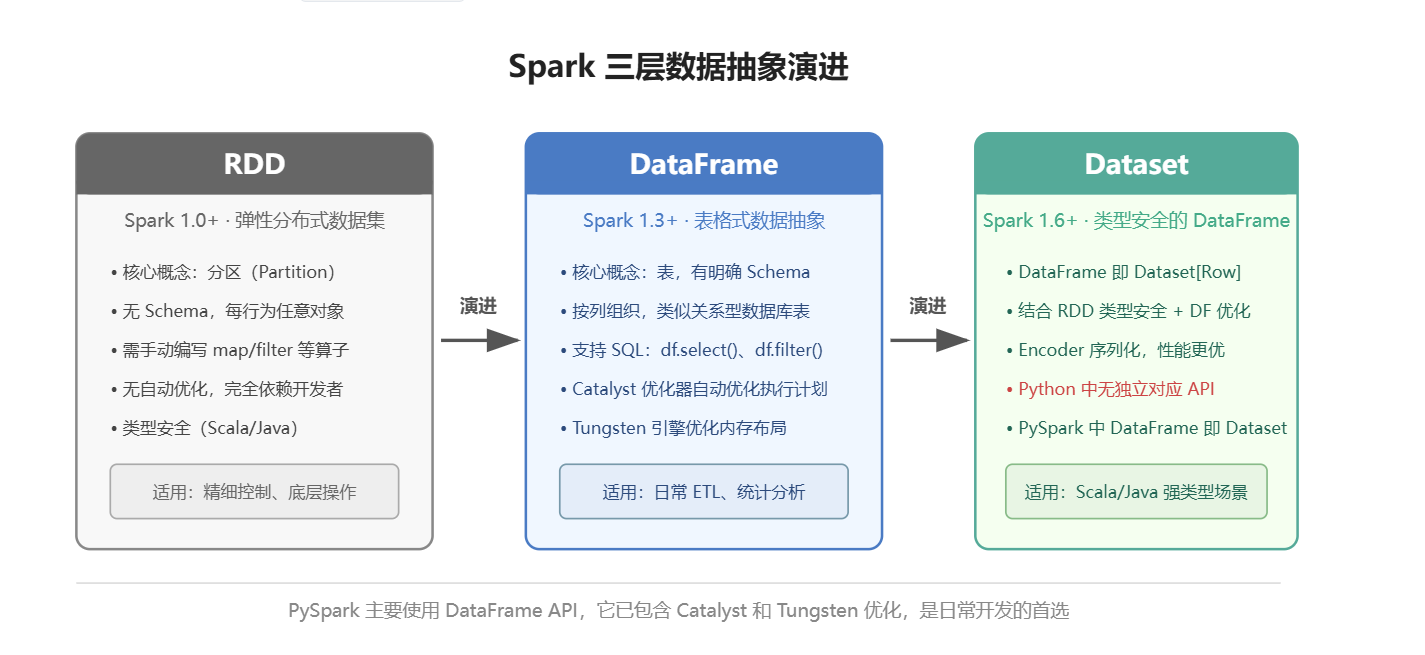
对于结构化数据任务,DataFrame 通常更容易获得 Spark SQL 的优化,应优先使用;RDD 适合少数需要低层控制的场景(如自定义分区器、处理非结构化数据)。
例子进展:主例子全程用的就是 DataFrame——spark.read.parquet() 返回 DataFrame,.filter() 返回新的 DataFrame,.groupBy().count() 也是 DataFrame。Catalyst 看到 DataFrame 的 Schema(city 是字符串、age 是整数),知道 age >= 18 是数值比较,能下推到 Parquet 层读取时过滤。如果用 RDD,Spark 只看到一堆 Row 对象,不知道 age 是第几列、什么类型,无法做这些优化。这就是"带 Schema 的 DataFrame 比 RDD 更容易被 Spark 优化"的具体含义。
常见误区
| RDD 是底层 API,性能比 DataFrame 好 | 对结构化任务,DataFrame 更容易获得 Spark SQL 优化,应优先使用;RDD 适合少数需要低层控制的场景 |
| DataFrame 就是 RDD 外面包了一层 | 两者是不同的数据抽象。DataFrame 内部使用 Tungsten 二进制格式存储数据(不是 JVM 对象),内存效率和执行性能远高于 RDD |
| 数据结构 | 无结构对象集合 | 结构化表格(行+列) | 结构化 + 强类型 |
| Schema | 无 | 有(列名+列类型) | 有 |
| 自动优化 | 无(手动优化) | Catalyst 优化器 | Catalyst 优化器 |
| 类型安全 | Scala/Java 有,Python 无 | 无(运行时检查) | 编译期检查(仅 Scala/Java) |
| 性能 | 较低 | 高(Tungsten 引擎) | 高 |
| Python 支持 | ✅ | ✅ | ❌(统一为 DataFrame) |
| 日常使用频率 | 低 | ⭐ 最高 | Scala/Java 场景使用 |
进阶:血缘关系(Lineage)——Spark 容错的核心
RDD/DataFrame 会记录自己是从哪个上游、经过什么变换操作得到的,形成一条完整的依赖链条。记录的是操作过程(配方),不是数据本身。
以主例子为例,每个分区的 Lineage 是这样的:
Stage 1 分区 47(丢失了!)
← 怎么来的?Shuffle Read:从 600 个 Map Task 拉取 hash(city)%200==47 的数据
← Map Task 的数据怎么来的?filter(age>=18) 的结果
← filter 的输入怎么来的?read("s3://data/users") 的分区 N
← 原始数据在哪?S3 上,永远不会丢
Spark 的恢复策略:如果 Map 端 Shuffle 输出还在别的机器磁盘上 → 重新调度 Reduce Task 到另一个 Executor,重新拉取即可。如果 Map 端输出也丢了(那台 Executor 也挂了)→ 重新跑对应的 Map Task:从 S3 重新读取 → 重新 filter → 重新写 Shuffle 输出。
原始数据(S3,不会丢)+ 操作过程(Lineage,几 KB 元数据)
= 可以还原任何阶段的任何分区
| 做法 | 烤 3 个一样的蛋糕,掉了一个还有两个 | 烤 1 个蛋糕,但保留配方 |
| 蛋糕掉了 | 用备用蛋糕 | 按配方重新烤一个 |
| 成本 | 3 倍存储 | 1 倍存储 + 可能的重算时间 |
| 存的是 | 数据本身 | 计算步骤(几 KB 元数据) |
这就是"弹性(Resilient)"的真正含义:不是数据有副本,而是计算可回溯——用计算换存储。DataFrame 同样保留了血缘机制,只是 Catalyst 优化器会在执行前对链条进行优化和重写。
七 小结一下
回到开头的问题:一段 PySpark 代码如何变成集群中许多机器共同执行的任务?
检验学习效果的方式:把主例子在本地模式(master("local[*]"),路径可换成本地文件)跑起来,打开 Spark UI(默认 http://localhost:4040),对照 Jobs / Stages / Tasks 页面——应该能解释每个 Job 为什么被切成两个 Stage、每个 Stage 为什么有那么多 Task、groupBy 之后的 Stage 为什么耗时明显更长。能看懂 Spark UI,说明这条主线已经建立。
例子终局:一行 write() 触发后,经历了完整的链路:
- Driver 解析代码 → Catalyst 列裁剪(20 列只读 2 列)→ 切分 2 个 Stage
- Stage 0:600 个 Task 并行读取 + 过滤,产出 2.1 亿条中间数据
- Shuffle:600 个 Map Task 写本地磁盘 → 200 个 Reduce Task 网络拉取(最慢)
- Stage 1:200 个 Task 各自按 city 聚合 count
- 最终:300+ 行结果(北京 2000 万、上海 1800 万……拉萨 3 万)写回 S3
120GB 数据进去,300 行结果出来,整个过程在 50 核集群上跑完约几分钟。
附录:核心概念速查
架构层:谁在干活
| Driver | 大脑(指挥) | 解析代码、构建并优化执行计划、切分 Stage/Task、调度执行、汇总结果 |
| Executor | 工人(干活) | 执行 Task、管理内存与缓存;一个 Executor 可同时运行多个 Task(取决于核数) |
| Cluster Manager | 调度员(分资源) | 只负责资源分配,不感知业务计算;常见实现:Standalone / YARN / Kubernetes |
数据层:数据如何表示
| DataFrame | 分布式结构化数据表 | PySpark 日常开发的主力 API;带 Schema,可获得 Catalyst 自动优化 |
| Partition | DataFrame 物理切分后的最小单元 | 一张 DataFrame 逻辑上是一整张表,物理上被切成多个分区;决定并行度上限:200 个分区最多 200 个 Task 同时执行 |
| Lineage(血缘关系) | 数据变换的依赖链条 | 容错靠按血缘重算丢失分区,而非数据副本 |
执行层:计算如何发生
| Transformation | 惰性转换操作 | 只记录不执行,逐步构建 DAG;如 filter / select / groupBy |
| Action | 触发计算的操作 | 一个 Action 触发一个 Job;如 count / show / write |
| DAG | 有向无环图执行计划 | Action 触发后经 Catalyst 优化(谓词下推、列裁剪等) |
| 窄依赖 | 子分区只依赖一个父分区 | Stage 内可流水线连续执行,无网络传输 |
| 宽依赖 | 子分区依赖多个父分区 | 必须 Shuffle,是 Stage 的分界线;如 groupBy / join / orderBy |
| Stage | 两个 Shuffle 边界之间的一组计算 | 由 DAG Scheduler 从后往前回溯、按宽依赖切分 |
| Task | 发给 Executor 的最小工作单元 | 公式:1 Partition + 1 Stage = 1 Task |
| Job | 一次 Action 触发的完整计算 | 层级:Job ⊃ Stage ⊃ Task |
| Shuffle | 按 Key 跨节点重新分布数据 | 磁盘 I/O + 网络 I/O + 序列化,Spark 中最昂贵的操作 |
主例子的代码链路对照
result = (
spark.read.parquet("s3://data/users") # DataFrame 读取后按文件块切分为 N 个 Partition
.filter("age >= 18") # Transformation(窄依赖),仅记录
.groupBy("city") # Transformation(宽依赖),仅记录
.count() # Transformation,仅记录
)
result.write.parquet("s3://output/…") # Action → 触发 1 个 Job
| 读取时 DataFrame 按文件块切分 | Partition(并行度的来源) |
| filter / groupBy / count 被记录而非执行 | Transformation、懒执行,共同构成 DAG |
| groupBy 产生跨分区依赖 | 宽依赖 → Shuffle → Stage 的切分边界 |
| write() 触发计算 | Action → Job |
| Stage 按分区数拆分下发 | Task(1 Partition + 1 Stage = 1 Task) |
| 各节点执行并网络拉取数据 | Executor、Shuffle Write / Shuffle Read |