🌈 个人主页: 小小、码农的 CSDN 博客 🔥 系列方向: linux网络 💪 学习宣言: 行动胜于空谈,实践出真知
上一篇我们已经完整实现了 UDP Socket 编程。
UDP Server 的核心流程比较简单:
socket()
↓
bind()
↓
recvfrom()
↓
业务处理
↓
sendto()
但 TCP 和 UDP 有一个非常关键的区别:
TCP 是面向连接的。
因此 TCP 在正式通信之前,必须先建立连接。
服务器和客户端的流程也就变成了:
TCP Server
socket()
↓
bind()
↓
listen()
↓
accept()
↓
read() / write()
TCP Client
socket()
↓
connect()
↓
read() / write()
这一篇就沿着这两条主线真正写出一个 TCP Server,并在此基础上一步步解决:
单客户端
↓
多客户端
↓
多进程
↓
多线程
↓
线程池
↓
守护进程
最后再回到 TCP 本身,从内核角度理解:
连接到底是什么?
accept 和三次握手是什么关系?
为什么 TCP 是全双工?
read/write 到底在干什么?
为什么 TCP 必须解决消息边界问题即粘包问题?
1. 先把最基本的 TCP 通信跑起来
1.1 程序结构
和 UDP 版本一样,我们先建立几个最基本的文件:
TcpServer
├── server.hpp
├── server.cc
├── client.hpp
├── client.cc
└── Makefile
最终实现的仍然是最简单的 Echo Server:
Client
↓
发送 hello
↓
Server
↓
收到 hello
↓
原样返回 hello
↓
Client
先准备 Makefile:
.PHONY:all
all:server client
server:server.cc
g++ -o $@ $^ -std=c++11
client:client.cc
g++ -o $@ $^ -std=c++11
.PHONY:clean
clean:
rm -rf server client
1.2 Server:socket 和 bind
首先创建服务器 Socket。
UDP 中:
socket(AF_INET, SOCK_DGRAM, 0);
TCP 中:
socket(AF_INET, SOCK_STREAM, 0);
区别就在第二个参数:
SOCK_DGRAM
↓
UDP 数据报
SOCK_STREAM
↓
TCP 字节流
因此:
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
创建的是一个 TCP Socket。
接着仍然需要绑定服务器自己的:
IP
+
Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_addr.s_addr = inet_addr(ip_.c_str());
local.sin_port = htons(port_);
bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local));
这里和 UDP Server 基本一致。
端口仍然需要:
htons();
转换为网络字节序。
到这里:
UDP Server
已经可以直接等待数据了。
但 TCP 不行。
因为 TCP 是:
面向连接的。
服务器还必须告诉操作系统:
我这个 Socket 接下来不是主动连接别人,而是专门等待别人来连接我。
这就是:
listen();
1.3 listen:把 Socket 变成监听 Socket
函数原型:
#include <sys/socket.h>
int listen(int sockfd, int backlog);
使用:
listen(listen_sock_, backlog);
第一个参数:
sockfd
就是之前:
socket();
创建并通过:
bind();
绑定好的 Socket。
listen() 做完以后,这个 Socket 就从一个普通 TCP Socket 变成了:
监听 Socket。
它以后主要负责:
等待连接
+
获取连接
而不是直接和客户端收发业务数据。
backlog 到底是什么?
我们这一篇暂时不用继续深入,只需要记住:
backlog
↓
等待 accept 的连接队列长度
另外:
listen();
本身通常不会阻塞等待客户端。
真正负责:
没有连接就一直等。
的是下面的:
accept();
1.4 accept:真正获取一个连接
函数原型:
int accept(int sockfd, struct sockaddr* addr, socklen_t* addrlen);
使用:
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
在默认阻塞模式下,如果当前没有已经建立好的连接:
accept()
↓
阻塞等待
一旦有客户端成功建立 TCP 连接:
accept()
↓
返回
但这里最重要的不是阻塞。
而是它的返回值:
service_sock
为什么服务器需要两个 Socket?
这是 TCP Socket 编程中最重要的地方之一。
一开始:
listen_sock_ = socket(...);
得到的是:
监听 Socket
它负责:
listen
accept
但是:
accept();
成功以后会返回:
service_sock
这个才是:
专门和当前客户端通信的 Socket。
所以服务器实际上是:
┌── service_sock A ↔ Client A
│
listen_sock ─accept─┼── service_sock B ↔ Client B
│
└── service_sock C ↔ Client C
假设有三个客户端连接服务器。
服务器一共会存在:
1 个 listen_sock
+
3 个 service_sock
监听 Socket 继续等待新连接。
每一个 accept() 返回的 Socket,则负责和对应客户端通信。
所以这两个 Socket 的职责一定不能混:
listen_sock
↓
只负责获取新连接
service_sock
↓
真正负责 read/write
accept 还能拿到客户端信息
和 UDP 的:
recvfrom();
类似,accept() 的:
addr
addrlen
也能够把客户端地址带回来。
例如:
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
于是服务器能够知道:
哪个 IP
+
哪个 Port
建立了连接。
1.5 当前阶段完整 Server
到这里,我们已经把 TCP Server 建立连接之前需要的几个核心接口学完了:
socket()
↓
创建 TCP Socket
↓
bind()
↓
绑定服务器 IP + Port
↓
listen()
↓
进入监听状态
↓
accept()
↓
获取已经建立好的 TCP 连接
此时这个 Server 暂时还不会和客户端进行数据通信,它只完成一件事:
等待客户端建立连接,并打印客户端的 IP、Port 以及 accept() 返回的通信 Socket。
当前项目只有三个文件:
TcpServer
├── server.hpp
├── server.cc
└── Makefile
server.hpp
#pragma once
#include <iostream>
#include <string>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
namespace fxs_server
{
const uint16_t default_port = 8877;
const std::string default_ip = "0.0.0.0";
const int backlog = 5;
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
BIND_ERR,
LISTEN_ERR
};
class TcpServer
{
public:
TcpServer(uint16_t port = default_port, const std::string& ip = default_ip)
: ip_(ip), port_(port)
{}
~TcpServer()
{}
void InitServer()
{
// 1.创建TCP监听套接字
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(listen_sock_ < 0)
{
std::cerr << "Create Socket Fail: "
<< strerror(errno) << std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success: "
<< listen_sock_ << std::endl;
// 2.绑定IP和Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port_);
local.sin_addr.s_addr = inet_addr(ip_.c_str());
if(bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "Bind IP&&Port Fail: "
<< strerror(errno) << std::endl;
exit(BIND_ERR);
}
std::cout << "Bind IP&&Port Success" << std::endl;
// 3.进入监听状态
if(listen(listen_sock_, backlog) < 0)
{
std::cerr << "Listen Fail: "
<< strerror(errno) << std::endl;
exit(LISTEN_ERR);
}
std::cout << "Listen Success" << std::endl;
}
void StartServer()
{
while(true)
{
// 4.获取已经建立好的连接
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
{
std::cerr << "Accept Fail: "
<< strerror(errno) << std::endl;
continue;
}
// 5.获取客户端IP和Port
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
uint16_t clientport = ntohs(client.sin_port);
std::cout << "Get a new connection -> "
<< "[" << clientip << ":" << clientport << "] "
<< "service_sock: " << service_sock
<< std::endl;
// 当前阶段还没有学习数据通信,
// 所以这里只验证accept能够成功获取连接
close(service_sock);
}
}
private:
int listen_sock_;
std::string ip_;
uint16_t port_;
};
}
server.cc
#include <iostream>
#include <memory>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
unique_ptr<TcpServer> server(new TcpServer(port));
server->InitServer();
server->StartServer();
return 0;
}
编译:
make
运行:
./server 8877
此时可以看到:
Create Socket Success: …
Bind IP&&Port Success
Listen Success
随后程序停在那里。
这并不是程序卡死了,而是:
accept();
在默认阻塞模式下发现当前还没有已经建立好的连接,因此正在等待客户端。
现在,我们就可以真正找一个 TCP 客户端来验证它。
1.6 使用 telnet 测试 TCP 连接
目前我们还没有编写自己的 TCP Client。
但是为了验证:
socket
bind
listen
accept
这一整套流程是否已经正常工作,可以暂时使用:
telnet
充当 TCP Client。
如果 Ubuntu 中还没有安装:
sudo apt install telnet
首先保持 Server 正在运行:
./server 8877
然后再打开一个终端:
telnet 127.0.0.1 8877
此时客户端会主动向:
127.0.0.1:8877
建立 TCP 连接。
Server 中原本阻塞的:
accept();
就会立即返回,并打印类似:
Get a new connection -> [127.0.0.1:xxxxx] service_sock: 4
其中:
127.0.0.1
↓
客户端IP
xxxxx
↓
客户端由操作系统自动分配的临时Port
4
↓
accept返回的通信Socket文件描述符
整个过程:
Server
↓
socket()
↓
bind()
↓
listen()
↓
accept()
↓
等待……
Client
↓
telnet 127.0.0.1 8877
↓
TCP建立连接
↓
Server accept()返回
↓
获得client IP + Port
↓
获得service_sock

这里 telnet 建立连接以后很快又会被 Server 断开,这是正常现象。
因为当前代码:
accept();
成功以后只做了:
打印连接信息
↓
close(service_sock)
我们目前只是为了验证:
TCP Server 已经能够成功监听并获取连接。
下一步学习:
read();
write();
以后,服务器才会真正利用这个 service_sock 和客户端进行数据通信。
1.7 read 和 write:真正开始 TCP 通信
连接建立完成以后,接下来就是通信。
Linux 中:
Socket 也是文件。
所以我们完全可以直接使用以前学习文件时的:
read();
write();
读取和发送网络数据。
服务器业务函数:
void Service(int sock, const std::string& clientip, const uint16_t& clientport)
{
char buff[1024];
std::string who = clientip + "-" + std::to_string(clientport);
while(true)
{
ssize_t n = read(sock, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Server get: "
<< buff
<< " from "
<< who
<< std::endl;
std::string respond = func_(buff);
write(sock, respond.c_str(), respond.size());
}
else if(n == 0)
{
std::cout << "Client "
<< who
<< " quit!"
<< std::endl;
close(sock);
break;
}
else
{
std::cerr << "Read Fail! "
<< strerror(errno)
<< std::endl;
close(sock);
break;
}
}
}
这里:
read();
一共有三种结果。
read > 0
表示:
真正读取到了数据
返回值:
n
就是实际读取的字节数。
因此:
buff[n] = '\\0';
把它临时当 C 风格字符串使用。
read == 0
这个特别重要。
对于 TCP Socket:
read() == 0
不是:
对方给我发送了一个长度为 0 的普通消息。
而意味着:
TCP 字节流已经到达 EOF,通常说明对端已经有序关闭了这一方向的连接。
最常见的情况就是:
客户端 close()
↓
TCP 通知服务器
↓
服务器 read()
↓
返回 0
于是服务器知道:
客户端退出了。
这也是 TCP 和 UDP 很明显的一个区别。
UDP 没有连接状态,所以对端程序退出时:
Server
并不会自动知道。
TCP 因为维护连接,所以:
read() == 0
可以让我们感知对端关闭。
read < 0
表示:
读取发生错误
此时:
errno
保存错误原因。
1.8 Client:socket 和 connect
TCP Client 初始化仍然先:
sock_ = socket(AF_INET, SOCK_STREAM, 0);
客户端一般不需要像 Server 一样手动:
bind();
因为:
客户端只要主动发起连接,操作系统就可以自动给它选择合适的本地 IP 和临时端口。
所以客户端真正新增的核心接口是:
connect();
函数原型:
int connect(int sockfd, const struct sockaddr* addr, socklen_t addrlen);
使用:
struct sockaddr_in server;
memset(&server, 0, sizeof(server));
server.sin_family = AF_INET;
inet_aton(server_ip_.c_str(), &server.sin_addr);
server.sin_port = htons(server_port_);
connect(sock_, (const struct sockaddr*)&server, sizeof(server));
这里:
bind()
传的是:
自己的地址
而:
connect()
传的是:
对方 Server 的地址
connect 成功到底意味着什么?
这个地方必须说清楚。
调用:
connect();
以后,真正负责建立 TCP 连接的不是我们的 C++ 代码。
而是:
客户端和服务器两边操作系统中的 TCP 协议栈。
connect() 会触发 TCP 建连流程。
当三次握手成功以后:
connect();
就可以成功返回。
这里并不要求服务器应用层已经执行:
accept();
因为:
三次握手
↓
TCP 内核协议栈完成
accept()
↓
应用层从内核已经完成的连接中取走一个
这是两层完全不同的事情。
所以以后一定要记住:
connect 对应“主动发起连接”,accept 对应“拿走已经建立好的连接结果”,accept 并不负责完成三次握手。
连接失败重试
服务器可能暂时没有启动。
如果:
connect();
失败就立即退出,体验并不好。
所以可以简单尝试数次:
int cnt = 5;
while(cnt)
{
int ret = connect(sock_, (const struct sockaddr*)&server, sizeof(server));
if(ret == 0)
break;
std::cerr << "网络异常,正在进行重连… 剩余连接次数: "
<< —cnt
<< std::endl;
sleep(1);
}
if(cnt == 0)
{
std::cerr << "连接失败! "
<< strerror(errno)
<< std::endl;
close(sock_);
exit(CONNECT_ERR);
}
1.9 Client 获取服务
连接成功后:
Client
同样使用:
write();
read();
通信。
void GetService()
{
char buff[1024];
std::string who = server_ip_ + "-" + std::to_string(server_port_);
while(true)
{
std::string msg;
std::cout << "Please Enter >> ";
std::getline(std::cin, msg);
write(sock_, msg.c_str(), msg.size());
ssize_t n = read(sock_, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Client get: "
<< buff
<< " from "
<< who
<< std::endl;
}
else if(n == 0)
{
std::cout << "Server "
<< who
<< " quit!"
<< std::endl;
close(sock_);
break;
}
else
{
std::cerr << "Read Fail! "
<< strerror(errno)
<< std::endl;
close(sock_);
break;
}
}
}
于是一个完整请求:
Client getline()
↓
write()
↓
Server read()
↓
业务处理
↓
Server write()
↓
Client read()
基本 TCP Echo 就打通了。
1.10 基础版完整代码
server.hpp
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
namespace fxs_server
{
const uint16_t default_port = 8877;
const std::string default_ip = "0.0.0.0";
const int backlog = 5;
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
BIND_ERR,
LISTEN_ERR
};
using func_t = std::function<std::string(std::string)>;
class TcpServer
{
public:
TcpServer(const func_t& func, const uint16_t port = default_port, const std::string ip = default_ip)
: ip_(ip), port_(port), func_(func)
{}
~TcpServer()
{}
void InitServer()
{
// 1.创建监听套接字
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(listen_sock_ == –1)
{
std::cerr << "Create Socket Fail! "
<< strerror(errno)
<< std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success! "
<< listen_sock_
<< std::endl;
// 2.绑定IP和Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_addr.s_addr = inet_addr(ip_.c_str());
local.sin_port = htons(port_);
if(bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "Bind IP&&Port Fail: "
<< strerror(errno)
<< std::endl;
exit(BIND_ERR);
}
// 3.进入监听状态
if(listen(listen_sock_, backlog) < 0)
{
std::cerr << "Listen Fail: "
<< strerror(errno)
<< std::endl;
exit(LISTEN_ERR);
}
}
void StartServer()
{
while(true)
{
// 1.获取新连接
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
{
std::cerr << "Accept Fail: "
<< strerror(errno)
<< std::endl;
continue;
}
// 2.获得客户端信息
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
std::cout << "Server accept "
<< clientip
<< ":"
<< clientport
<< ", service sock: "
<< service_sock
<< std::endl;
// 3.提供服务
Service(service_sock, clientip, clientport);
}
}
void Service(int sock, const std::string& clientip, const uint16_t& clientport)
{
char buff[1024];
std::string who = clientip + "-" + std::to_string(clientport);
while(true)
{
ssize_t n = read(sock, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Server get: "
<< buff
<< " from "
<< who
<< std::endl;
std::string respond = func_(buff);
write(sock, respond.c_str(), respond.size());
}
else if(n == 0)
{
std::cout << "Client "
<< who
<< " quit!"
<< std::endl;
close(sock);
break;
}
else
{
std::cerr << "Read Fail! "
<< strerror(errno)
<< std::endl;
close(sock);
break;
}
}
}
private:
int listen_sock_;
std::string ip_;
uint16_t port_;
func_t func_;
};
}
server.cc
#include <iostream>
#include <memory>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
client.hpp
#pragma once
#include <iostream>
#include <string>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
namespace fxs_client
{
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
CONNECT_ERR
};
class TcpClient
{
public:
TcpClient(const std::string& ip, const uint16_t port)
: server_ip_(ip), server_port_(port)
{}
~TcpClient()
{}
void InitClient()
{
sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(sock_ == –1)
{
std::cerr << "Create Socket Fail! "
<< strerror(errno)
<< std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success! "
<< sock_
<< std::endl;
}
void StartClient()
{
struct sockaddr_in server;
memset(&server, 0, sizeof(server));
server.sin_family = AF_INET;
inet_aton(server_ip_.c_str(), &server.sin_addr);
server.sin_port = htons(server_port_);
int cnt = 5;
while(cnt)
{
int ret = connect(sock_, (const struct sockaddr*)&server, sizeof(server));
if(ret == 0)
break;
std::cerr << "网络异常,正在进行重连… 剩余连接次数: "
<< —cnt
<< std::endl;
sleep(1);
}
if(cnt == 0)
{
std::cerr << "连接失败! "
<< strerror(errno)
<< std::endl;
close(sock_);
exit(CONNECT_ERR);
}
std::cout << "连接成功!" << std::endl;
GetService();
}
void GetService()
{
char buff[1024];
std::string who = server_ip_ + "-" + std::to_string(server_port_);
while(true)
{
std::string msg;
std::cout << "Please Enter >> ";
std::getline(std::cin, msg);
write(sock_, msg.c_str(), msg.size());
ssize_t n = read(sock_, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Client get: "
<< buff
<< " from "
<< who
<< std::endl;
}
else if(n == 0)
{
std::cout << "Server "
<< who
<< " quit!"
<< std::endl;
close(sock_);
break;
}
else
{
std::cerr << "Read Fail! "
<< strerror(errno)
<< std::endl;
close(sock_);
break;
}
}
}
private:
int sock_;
std::string server_ip_;
uint16_t server_port_;
};
}
client.cc
#include <iostream>
#include <memory>
#include "client.hpp"
using namespace std;
using namespace fxs_client;
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerIP ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 3)
{
Usage(argv[0]);
return USAGE_ERR;
}
std::string ip = argv[1];
uint16_t port = stoi(argv[2]);
unique_ptr<TcpClient> client(new TcpClient(ip, port));
client->InitClient();
client->StartClient();
return 0;
}
1.9 运行测试
编译:
make
启动服务器:
./server 8877
启动客户端:
./client 127.0.0.1 8877
客户端输入:
hello tcp
应该得到:
Client
↓
hello tcp
↓
Server
↓
hello tcp
↓
Client

还可以查看当前 TCP 监听端口:
ss -ntlp | grep 8877

netsat -nltp | grep 8877

2. 单进程服务器为什么不能同时服务多个客户端?
现在打开两个 Client:
Client A
Client B
A 先连接。
Server 执行:
accept();
获得:
A 的 service_sock
然后马上进入:
Service();
而:
Service();
内部是:
while(true)
不断为 A 服务。
因此服务器此时的执行流:
accept A
↓
Service A
↓
Service A
↓
Service A
↓
……
根本回不到下一次:
accept();
所以 B 无法被应用层处理。
为什么 B 的 connect 却可能显示成功?
这个地方特别容易产生误解。
B:
connect();
成功,只说明:
客户端和服务器内核中的 TCP 三次握手成功了。
并不代表:
服务器应用代码已经调用 accept() 并开始处理 B。
因此完全可能出现:
Client B
↓
connect 成功
Server 应用
↓
还在 Service(A)
B 对应的连接已经在:
内核
中建立完成,并等待:
accept();
取走。
所以:
connect 成功
≠
服务器业务代码已经开始服务你
这正好也说明:
连接建立属于内核 TCP 协议栈,而 accept 属于应用层获取连接。
问题真正出在:
接受新连接
和:
为旧连接提供服务
使用了同一个执行流。
所以接下来我们必须:
让“获取连接”和“处理连接”同时进行。
第一种方法:
多进程
3. 多进程版 TCP Server
核心思路:
父进程
↓
只负责 accept
子进程
↓
负责 Service
每建立一个新连接:
accept()
↓
fork()
↓
┌───────────────┐
│ │
父进程 子进程
│ │
继续 accept Service
3.1 为什么子进程能够直接使用 service_sock?
因为:
fork();
以后,子进程会继承父进程的:
文件描述符表。
所以父进程刚刚:
accept();
得到的:
service_sock
子进程同样能够访问。
假设:
父进程
fd 3 -> listen socket
fd 4 -> client socket
fork() 后:
父进程 子进程
fd 3 -> listen fd 3 -> listen
fd 4 -> client fd 4 -> client
但两边职责不同。
子进程:
只负责当前 Client
所以不需要:
listen_sock
应该:
close(listen_sock_);
父进程:
只负责继续 accept
所以不需要这个客户端的:
service_sock
应该:
close(service_sock);
注意:
这里父进程 close(service_sock) 并不会立即断开子进程和客户端的连接。
因为 fork() 后父子进程的文件描述符虽然是两份表项,但都引用内核中的同一个打开文件对象。
只有相关引用全部关闭,底层连接才真正失去引用。
3.2 最直接的多进程版本
void StartServer()
{
while(true)
{
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
continue;
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
pid_t id = fork();
if(id < 0)
{
close(service_sock);
continue;
}
else if(id == 0)
{
close(listen_sock_);
Service(service_sock, clientip, clientport);
exit(0);
}
close(service_sock);
}
}
这样:
Client A -> Child A
Client B -> Child B
Client C -> Child C
而父进程始终:
accept
accept
accept
服务器就具备并发能力了。
3.3 子进程退出后谁来回收?
这里又出现进程编程中的老问题:
僵尸进程。
子进程完成:
Service();
以后退出。
父进程如果完全不:
wait();
waitpid();
就可能产生僵尸进程。
那是不是直接:
waitpid(id, nullptr, 0);
就行?
也不行。
因为这是:
阻塞等待
父进程就会变成:
fork Client A
↓
wait Client A
↓
Client A 不退出
↓
父进程无法 accept B
又失去了并发意义。
所以我们需要:
既回收子进程,又不能阻塞父进程继续 accept。
3.4 四种处理思路
方法一:waitpid + WNOHANG
waitpid(id, nullptr, WNOHANG);
这样:
waitpid
本身不会阻塞。
但问题是:
如果调用 waitpid() 时子进程还没退出,它会直接返回。
以后子进程真正退出时,如果父进程正阻塞在:
accept();
就可能暂时没人回收。
所以只是简单在:
fork();
后调用一次:
waitpid(..., WNOHANG);
并不能彻底解决问题。
方法二:捕获 SIGCHLD
子进程退出时,父进程会收到:
SIGCHLD
所以可以注册信号处理函数:
static void Handler(int signo)
{
while(waitpid(–1, nullptr, WNOHANG) > 0)
{}
}
然后:
signal(SIGCHLD, Handler);
这样:
父进程
↓
正常 accept
子进程退出
↓
SIGCHLD
↓
Handler
↓
waitpid
就能做到异步回收。
注意:
信号处理函数中应该尽量只调用异步信号安全的接口,不要随便塞大量 cout、内存分配等复杂逻辑。
方法三:显式忽略 SIGCHLD
Linux 下还有一种非常简单的方法:
signal(SIGCHLD, SIG_IGN);
显式将:
SIGCHLD
设置为忽略以后,Linux 可以自动处理这些退出子进程,不让它们长期处于僵尸状态。
对于我们现在这个简单 TCP Server:
signal(SIGCHLD, SIG_IGN);
是最省事的写法。
因此最终:
void StartServer()
{
signal(SIGCHLD, SIG_IGN);
while(true)
{
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
continue;
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
pid_t id = fork();
if(id < 0)
{
close(service_sock);
continue;
}
else if(id == 0)
{
close(listen_sock_);
Service(service_sock, clientip, clientport);
exit(0);
}
close(service_sock);
}
}
方法四:双重 fork
还有一种经典技巧:
父进程
↓
fork 子进程
↓
子进程再 fork 孙子进程
↓
子进程立即退出
↓
父进程只等待这个很快退出的子进程
↓
孙子进程真正 Service
原来的父子关系被切断以后,孙子进程会由系统中的父进程接管机制负责。
这种方式能够绕开父进程长期等待业务进程的问题。
不过:
对我们当前 TCP Server 来说,没有必要专门绕这么一大圈。
知道这个方法即可。
后面讲守护进程时,还会再次看到:
fork
+
setsid
+
再次 fork
这种思路。
3.5 多进程版 TCP Server 完整代码
前面我们已经把多进程服务器中几个关键问题解决了:
父进程
↓
accept()
↓
获取新连接
↓
fork()
父进程
↓
关闭自己的 service_sock
↓
继续 accept()
子进程
↓
关闭 listen_sock
↓
Service()
↓
专门服务当前客户端
同时,子进程退出以后还需要解决:
僵尸进程
的问题。
在当前这个简单 TCP Server 中,我们采用:
signal(SIGCHLD, SIG_IGN);
让 Linux 自动处理退出的子进程。
因此,现在可以把前面的内容真正组合起来,得到一份完整的多进程 TCP Server。
当前代码结构:
TcpServer
├── server.hpp
├── server.cc
├── client.hpp
├── client.cc
└── Makefile
客户端本身不需要发生变化,仍然使用前面已经写好的 TCP Client。
这一阶段真正修改的是 Server。
server.hpp
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <signal.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
namespace fxs_server
{
const uint16_t default_port = 8877;
const std::string default_ip = "0.0.0.0";
const int backlog = 5;
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
BIND_ERR,
LISTEN_ERR
};
using func_t = std::function<std::string(std::string)>;
class TcpServer
{
public:
TcpServer(const func_t& func, uint16_t port = default_port, const std::string& ip = default_ip)
: ip_(ip), port_(port), func_(func)
{}
~TcpServer()
{}
void InitServer()
{
// 1.创建监听套接字
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(listen_sock_ < 0)
{
std::cerr << "Create Socket Fail: "
<< strerror(errno) << std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success: "
<< listen_sock_ << std::endl;
// 2.绑定IP和Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port_);
local.sin_addr.s_addr = inet_addr(ip_.c_str());
if(bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "Bind IP&&Port Fail: "
<< strerror(errno) << std::endl;
exit(BIND_ERR);
}
std::cout << "Bind IP&&Port Success" << std::endl;
// 3.进入监听状态
if(listen(listen_sock_, backlog) < 0)
{
std::cerr << "Listen Fail: "
<< strerror(errno) << std::endl;
exit(LISTEN_ERR);
}
std::cout << "Listen Success" << std::endl;
}
void Service(int sock, const std::string& clientip, uint16_t clientport)
{
char buff[1024];
std::string who = clientip + ":" + std::to_string(clientport);
while(true)
{
ssize_t n = read(sock, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Server get: "
<< buff
<< " from "
<< who
<< std::endl;
std::string respond = func_(buff);
write(sock, respond.c_str(), respond.size());
}
else if(n == 0)
{
std::cout << "Client "
<< who
<< " quit!"
<< std::endl;
close(sock);
break;
}
else
{
std::cerr << "Read Fail: "
<< strerror(errno)
<< std::endl;
close(sock);
break;
}
}
}
void StartServer()
{
// 子进程退出后由系统自动处理,避免产生僵尸进程
signal(SIGCHLD, SIG_IGN);
while(true)
{
// 1.父进程获取新连接
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
{
std::cerr << "Accept Fail: "
<< strerror(errno)
<< std::endl;
continue;
}
// 2.获取客户端信息
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
uint16_t clientport = ntohs(client.sin_port);
std::cout << "Get a new connection -> "
<< "[" << clientip << ":" << clientport << "] "
<< "service_sock: " << service_sock
<< std::endl;
// 3.创建子进程
pid_t id = fork();
if(id < 0)
{
std::cerr << "Fork Fail: "
<< strerror(errno)
<< std::endl;
close(service_sock);
continue;
}
else if(id == 0)
{
// 子进程只负责当前客户端,不需要监听套接字
close(listen_sock_);
Service(service_sock, clientip, clientport);
exit(0);
}
// 父进程只负责继续获取新连接
close(service_sock);
}
}
private:
int listen_sock_;
std::string ip_;
uint16_t port_;
func_t func_;
};
}
这里最核心的其实就是:
pid_t id = fork();
之后父子进程职责彻底分开:
父进程
↓
close(service_sock)
↓
回到 accept()
↓
继续等待其他客户端
子进程
↓
close(listen_sock_)
↓
Service(service_sock)
↓
一直服务当前客户端
所以此时:
Client A
↓
Child Process A
Client B
↓
Child Process B
Client C
↓
Child Process C
父进程则始终专门负责:
accept();
这就解决了前面单进程版本:
Service(A)
↓
长期不返回
↓
无法继续 accept(B)
的问题。
server.cc
业务层仍然使用最简单的 Echo:
#include <iostream>
#include <memory>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
可以看到,业务层完全没有因为服务器从:
单进程
改成:
多进程
而发生变化。
变化的只是:
服务器如何调度不同客户端。
运行多进程 Server
重新编译:
make clean
make
启动服务器:
./server 8877
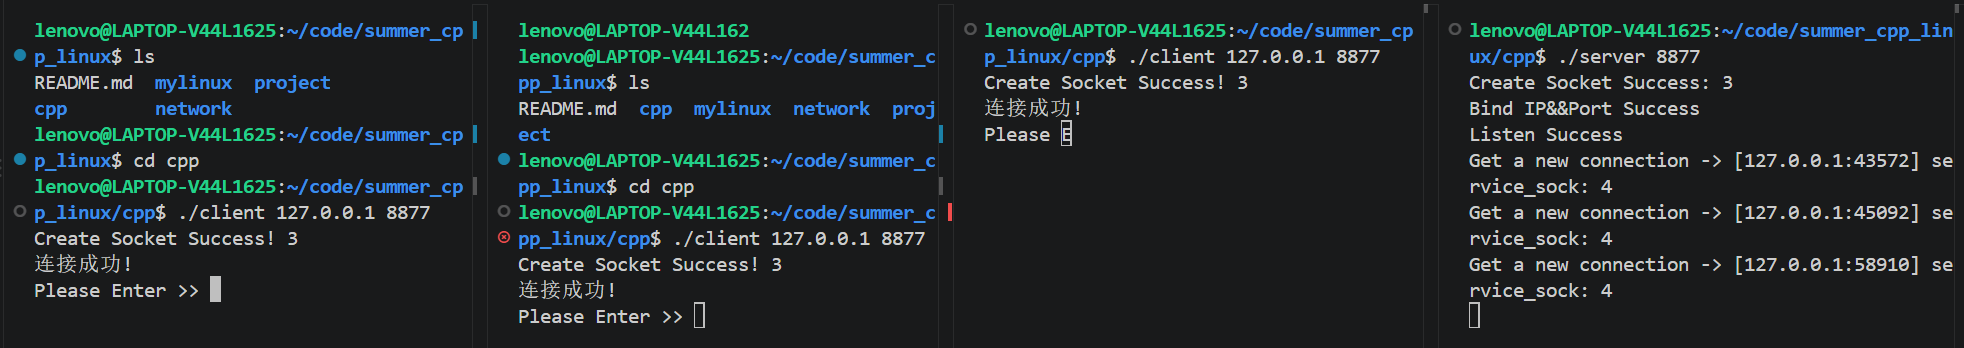
然后分别打开多个终端。
Client A:
./client 127.0.0.1 8877
Client B:
./client 127.0.0.1 8877
Client C:
./client 127.0.0.1 8877
此时三个客户端都可以持续和服务器通信。
例如:
Client A
Please Enter >> hello A
Client B
Please Enter >> hello B
Client C
Please Enter >> hello C
三个客户端都能分别收到自己的 Echo。
这说明:
父进程
↓
仍然可以不断 accept()
多个子进程
↓
同时为不同客户端提供 Service()
查看 Server 的多个进程
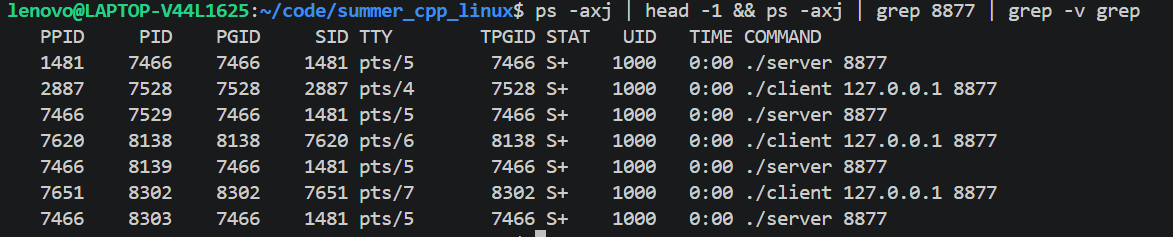
此时再打开一个终端:
ps -axj | head -1 && ps -axj | grep 8877 | grep -v grep
观察父子关系
应该可以看到:
一个 Server 父进程
+
多个 Server 子进程
再观察一次文件描述符关系
这个版本还有一个特别值得复习的地方。
假设父进程:
listen_sock = 3
service_sock = 4
执行:
fork();
之后:
父进程 子进程
fd 3 fd 3
↓ ↓
listen Socket listen Socket
fd 4 fd 4
↓ ↓
Client Socket Client Socket
因为子进程继承了父进程的文件描述符表。
但是双方职责不同。
所以子进程:
close(listen_sock_);
只保留:
service_sock
用于服务客户端。
父进程:
close(service_sock);
只保留:
listen_sock
继续接受新连接。
最终:
Parent
│
└── listen_sock
│
├── accept A -> fork -> Child A -> service_sock A
│
├── accept B -> fork -> Child B -> service_sock B
│
└── accept C -> fork -> Child C -> service_sock C
这就是当前多进程 TCP Server 的完整结构。
3.6 多进程版本还有什么问题?
现在服务器确实已经能够同时服务多个客户端了。
但是它采用的是:
来一个客户端
↓
fork 一个子进程
再来一个客户端
↓
再 fork 一个子进程
进程的创建和维护成本并不低。
因为不同进程拥有各自独立的:
虚拟地址空间
页表
PCB
资源管理结构
……
而我们的需求其实只是:
让不同客户端由不同执行流同时处理。
未必真的需要:
多个独立进程
因此接下来可以考虑一种更轻量的执行流:
线程。
于是服务器继续演进:
单进程串行
↓
多进程并发
↓
多线程并发
4. 多线程版 TCP Server
多进程版本能够工作。
但每来一个客户端就:
fork();
仍然比较重。
不同进程:
拥有独立虚拟地址空间
而线程:
属于同一个进程
共享地址空间
共享文件描述符表
共享大量进程资源
所以对于这种:
一个连接
↓
交给一个独立执行流
的问题,也可以使用线程。
整体结构:
主线程
↓
accept
↓
创建新线程
↓
继续 accept
工作线程
↓
Service
4.1 ThreadData:怎么把参数传给线程?
pthread_create() 的线程入口形式:
void* Routine(void*);
而:
Service();
需要:
service_sock
client IP
client Port
TcpServer 对象本身
一个:
void*
显然直接装不下这么多独立参数。
所以把它们封装成一个对象:
class ThreadData
{
public:
ThreadData(int sock, const std::string& ip, uint16_t port, TcpServer* current)
: sock_(sock), clientip_(ip), clientport_(port), current_(current)
{}
public:
int sock_;
std::string clientip_;
uint16_t clientport_;
TcpServer* current_;
};
然后:
ThreadData* td = new ThreadData(service_sock, clientip, clientport, this);
把:
td
作为:
void*
传给线程。
4.2 为什么线程函数是 static?
普通成员函数实际上隐藏了:
this
参数。
而:
pthread_create();
要求的是普通函数形式:
void* (*)(void*);
所以类内线程入口一般写成:
static
static void* Routine(void* args)
{
pthread_detach(pthread_self());
ThreadData* td = static_cast<ThreadData*>(args);
td->current_->Service(td->sock_, td->clientip_, td->clientport_);
delete td;
return nullptr;
}
其中:
pthread_detach(pthread_self());
表示:
当前线程退出以后,系统自动回收线程资源,不要求主线程再 pthread_join()。
4.3 多线程 StartServer
void StartServer()
{
while(true)
{
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
continue;
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
ThreadData* td = new ThreadData(service_sock, clientip, clientport, this);
pthread_t tid;
pthread_create(&tid, nullptr, Routine, td);
}
}
与多进程版本有一个非常重要的区别。
多进程:
父子进程有各自的文件描述符表
所以父进程可以:
close(service_sock);
只关闭自己那一份引用。
但是线程之间:
共享同一个进程的文件描述符表
所以主线程不能像多进程一样随便再:
close(service_sock);
否则工作线程使用的也是这个文件描述符。
4.4 多线程版 TCP Server 完整代码
到这里,多线程版本需要的内容已经全部具备了:
主线程
↓
accept()
↓
获得 service_sock
↓
构造 ThreadData
↓
pthread_create()
↓
继续 accept()
工作线程
↓
Routine()
↓
pthread_detach()
↓
Service()
↓
专门服务当前客户端
和多进程版本相比,它们解决的问题完全相同:
不能让一个客户端的 Service() 占住服务器唯一的执行流。
但是实现方式发生了变化:
多进程
↓
一个客户端对应一个子进程
多线程
↓
一个客户端对应一个工作线程
现在把前面的内容组合起来,得到完整的多线程 TCP Server。
当前项目结构仍然是:
TcpServer
├── server.hpp
├── server.cc
├── client.hpp
├── client.cc
└── Makefile
客户端代码不需要修改,继续使用前面已经完成的 TCP Client。
这一阶段真正修改的仍然只有 Server。
server.hpp
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <pthread.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
namespace fxs_server
{
const uint16_t default_port = 8877;
const std::string default_ip = "0.0.0.0";
const int backlog = 5;
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
BIND_ERR,
LISTEN_ERR
};
class TcpServer;
// 将线程执行Service所需要的数据统一封装起来
class ThreadData
{
public:
ThreadData(int sock, const std::string& ip, uint16_t port, TcpServer* current)
: sock_(sock), clientip_(ip), clientport_(port), current_(current)
{}
public:
int sock_;
std::string clientip_;
uint16_t clientport_;
TcpServer* current_;
};
using func_t = std::function<std::string(std::string)>;
class TcpServer
{
public:
TcpServer(const func_t& func, uint16_t port = default_port, const std::string& ip = default_ip)
: ip_(ip), port_(port), func_(func)
{}
~TcpServer()
{}
void InitServer()
{
// 1.创建监听套接字
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(listen_sock_ < 0)
{
std::cerr << "Create Socket Fail: "
<< strerror(errno) << std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success: "
<< listen_sock_ << std::endl;
// 2.绑定IP和Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port_);
local.sin_addr.s_addr = inet_addr(ip_.c_str());
if(bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "Bind IP&&Port Fail: "
<< strerror(errno) << std::endl;
exit(BIND_ERR);
}
std::cout << "Bind IP&&Port Success" << std::endl;
// 3.进入监听状态
if(listen(listen_sock_, backlog) < 0)
{
std::cerr << "Listen Fail: "
<< strerror(errno) << std::endl;
exit(LISTEN_ERR);
}
std::cout << "Listen Success" << std::endl;
}
void StartServer()
{
while(true)
{
// 1.主线程获取新连接
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
{
std::cerr << "Accept Fail: "
<< strerror(errno) << std::endl;
continue;
}
// 2.获取客户端IP和Port
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
uint16_t clientport = ntohs(client.sin_port);
std::cout << "Get a new connection -> "
<< "[" << clientip << ":" << clientport << "] "
<< "service_sock: " << service_sock
<< std::endl;
// 3.构造线程需要的参数
ThreadData* td = new ThreadData(service_sock, clientip, clientport, this);
// 4.创建线程,让工作线程负责当前客户端
pthread_t tid;
pthread_create(&tid, nullptr, Routine, td);
// 主线程不进入Service,直接继续下一轮accept
}
}
// 工作线程入口函数
static void* Routine(void* args)
{
// 分离当前线程,退出后自动回收资源
pthread_detach(pthread_self());
ThreadData* td = static_cast<ThreadData*>(args);
// 调用当前TcpServer对象的Service
td->current_->Service(td->sock_, td->clientip_, td->clientport_);
delete td;
return nullptr;
}
// 通信服务 + 业务处理
void Service(int sock, const std::string& clientip, uint16_t clientport)
{
char buff[1024];
std::string who = clientip + ":" + std::to_string(clientport);
while(true)
{
ssize_t n = read(sock, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Server get: "
<< buff
<< " from "
<< who
<< std::endl;
std::string respond = func_(buff);
write(sock, respond.c_str(), respond.size());
}
else if(n == 0)
{
std::cout << "Client "
<< who
<< " quit!"
<< std::endl;
close(sock);
break;
}
else
{
std::cerr << "Read Fail: "
<< strerror(errno)
<< std::endl;
close(sock);
break;
}
}
}
private:
int listen_sock_;
std::string ip_;
uint16_t port_;
func_t func_;
};
}
这一版最核心的地方就是:
ThreadData* td = new ThreadData(service_sock, clientip, clientport, this);
pthread_t tid;
pthread_create(&tid, nullptr, Routine, td);
主线程得到连接以后,并不会自己执行:
Service();
而是创建一个线程:
service_sock
client IP
client Port
this
全部交给工作线程。
工作线程再执行:
td->current_->Service(td->sock_, td->clientip_, td->clientport_);
所以:
Main Thread
│
├── accept Client A
│ ↓
│ Thread A -> Service(A)
│
├── accept Client B
│ ↓
│ Thread B -> Service(B)
│
└── accept Client C
↓
Thread C -> Service(C)
主线程始终能够继续:
accept();
server.cc
业务层继续使用 Echo,不需要任何修改:
#include <iostream>
#include <memory>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
这里再次能够看到我们前面进行业务解耦的好处。
无论服务器使用:
单进程
多进程
多线程
业务函数始终还是:
std::string Echo(const std::string& request)
{
return request;
}
变化的是:
服务器如何安排执行流去处理不同客户端。
业务本身没有发生变化。
Makefile
由于现在使用:
pthread_create();
pthread_detach();
需要链接 pthread:
.PHONY:all
all:server client
server:server.cc
g++ -o $@ $^ -std=c++11 -lpthread
client:client.cc
g++ -o $@ $^ -std=c++11
.PHONY:clean
clean:
rm -rf server client
客户端仍然使用前面已经完成的:
client.hpp
client.cc
不需要修改。
4.5 运行多线程 TCP Server
重新编译:
make clean
make
启动 Server:
./server 8877
然后分别启动多个客户端。
Client A:
./client 127.0.0.1 8877
Client B:
./client 127.0.0.1 8877
Client C:
./client 127.0.0.1 8877
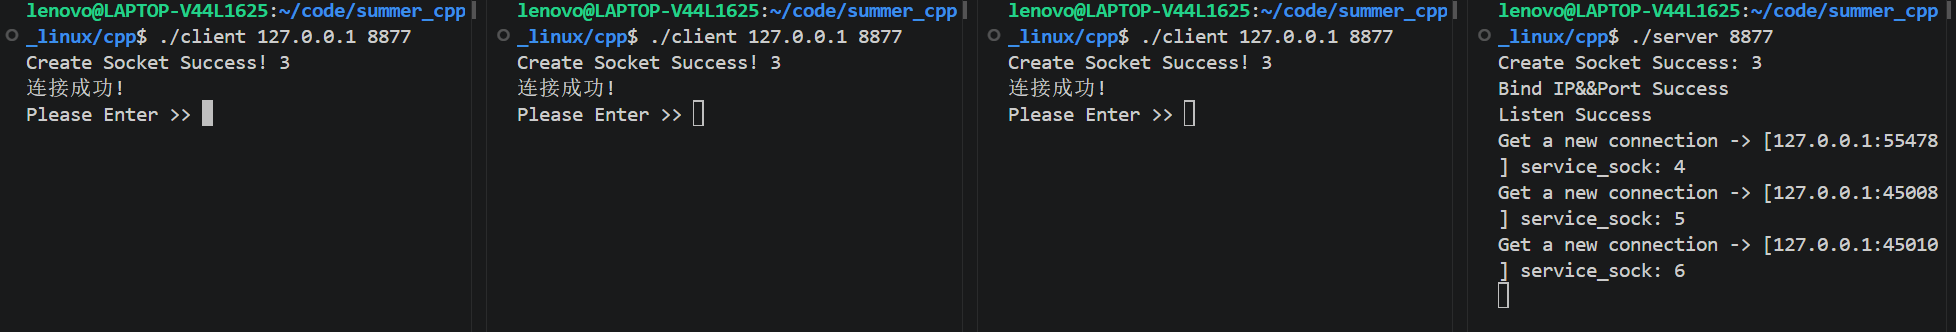
三个 Client 都可以持续发送消息:
Client A
Please Enter >> hello A
Client B
Please Enter >> hello B
Client C
Please Enter >> hello C
并分别收到服务器 Echo。
此时服务器内部结构已经变成:
Server Process
│
├── Main Thread
│ ↓
│ accept()
│
├── Thread A
│ ↓
│ Service(Client A)
│
├── Thread B
│ ↓
│ Service(Client B)
│
└── Thread C
↓
Service(Client C)
这和多进程版本:
Parent
├── Child A
├── Child B
└── Child C
解决的是同一个问题。
只不过现在所有执行流都属于:
同一个 Server 进程。
使用 ps 查看线程
可以打开另一个终端:
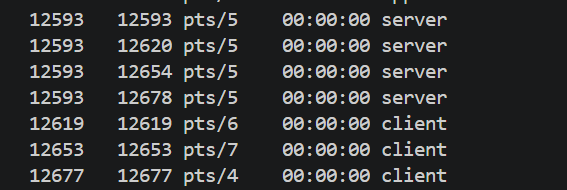
ps -aL | grep server
其中:
-L
表示:
显示进程中的线程。
假设目前有三个客户端,那么可以看到同一个:
PID
下面存在多个不同的:
LWP
大致可以理解为:
PID
↓
属于哪个进程
LWP
↓
具体哪个线程
所以你会看到:
一个 Server PID
+
多个不同的线程 ID
这与前面的多进程版本形成非常明显的对比。
多进程:
ps -ef
↓
多个不同 PID
多线程:
ps -aL
↓
同一个 PID
+
多个线程
4.6 多进程和多线程到这里到底差在哪?
现在正好可以把两个版本放在一起。
多进程:
Server Parent
│
├── Child A -> Client A
├── Child B -> Client B
└── Child C -> Client C
多线程:
Server Process
│
├── Main Thread
├── Thread A -> Client A
├── Thread B -> Client B
└── Thread C -> Client C
它们的共同点:
主执行流
↓
只负责accept
其他执行流
↓
负责Service
不同点:
多进程
↓
不同进程拥有独立虚拟地址空间
↓
资源隔离更强
↓
创建和切换相对更重
多线程
↓
多个线程属于同一个进程
↓
共享地址空间、文件描述符等资源
↓
创建和切换相对更轻
但是多线程版本现在还有一个问题。
当前是:
Client 来了
↓
pthread_create()
又来一个 Client
↓
再 pthread_create()
再来一个
↓
继续 pthread_create()
也就是说:
线程仍然是在客户端到来以后临时创建的。
如果客户端特别多:
连接越多
↓
创建线程越多
↓
线程数量缺乏统一控制
那么有没有办法:
程序启动的时候就提前创建好固定数量的线程,客户端来了以后只需要把任务交给它们?
这就是我们前面已经学习过的:
线程池。
于是服务器继续演进:
单进程
↓
多进程
↓
多线程
↓
线程池
5. 线程池版 TCP Server
现在多线程服务器还有一个问题。
当前逻辑:
客户端来了
↓
accept
↓
pthread_create
↓
创建线程
也就是说:
客户端已经来了,我们才临时创建线程。
如果连接数量不断增加:
来一个
↓
建一个线程
再来一个
↓
再建一个线程
……
线程数量就可能不断增长。
这并不是一个很好的资源管理方式。
于是我们自然想到前面已经学习过的:
线程池。
5.1 为什么使用线程池?
线程池:
程序启动
↓
提前创建固定数量线程
↓
所有线程等待任务
客户端来了以后:
accept()
↓
构造 Task
↓
Push 进入任务队列
↓
唤醒工作线程
↓
处理 Task
所以:
连接到来
和:
线程创建
不再绑定在一起。
整个结构:
accept
↓
Task Queue
↙ ↓ ↘
thread1 thread2 thread3
这本质上就是以前的:
生产者消费者模型。
主线程:
生产任务
工作线程:
消费任务
5.2 Task 到底是什么?
在当前 TCP Server 中,一份任务至少需要:
service_sock
client IP
client Port
业务处理函数
所以:
class Task
{
public:
Task(int sockfd, const std::string& clientip, uint16_t clientport, const func_t& func)
: sockfd_(sockfd), clientip_(clientip), clientport_(clientport), func_(func)
{}
void Run()
{
char buff[1024];
ssize_t n = read(sockfd_, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::string respond = func_(buff);
write(sockfd_, respond.c_str(), respond.size());
}
close(sockfd_);
}
private:
int sockfd_;
std::string clientip_;
uint16_t clientport_;
func_t func_;
};
然后:
Task task(service_sock, clientip, clientport, func_);
ThreadPool<Task>::GetInstance()->Push(task);
5.3 为什么这里去掉 Service 的 while(true)?
这个地方必须讲明白。
如果线程池只有:
5 个线程
而一个任务内部:
while(true)
{
read();
write();
}
表示:
一个 Worker 一旦服务一个长连接,就一直被这个连接占住。
那么:
5 个线程
最多就只能同时被:
5 个长期连接
占用。
所以这个教学版本采用:
一个连接
↓
读取一次
↓
处理一次
↓
返回一次
↓
关闭连接
的短服务模型。
因此如果 Client 仍然想在同一个 TCP 连接中发送第二条消息:
第一次
↓
Server 处理
↓
Server close
第二次
↓
原连接已经关闭
当然会失败。
这不是:
线程池导致 TCP 不能连续通信。
更不是:
TCP 一个连接只能发送一次数据。
而只是:
我们这里的 Task::Run() 主动设计成了一次请求处理完就关闭连接。
如果业务需要:
TCP 长连接
完全可以重新设计任务模型。
这里只是利用它理解:
线程池
+
TCP Server
是如何结合的。
5.4 主线程加入线程池
核心代码:
void StartServer()
{
ThreadPool<Task>::GetInstance()->Start();
while(true)
{
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
continue;
uint16_t clientport = ntohs(client.sin_port);
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
Task task(service_sock, clientip, clientport, func_);
ThreadPool<Task>::GetInstance()->Push(task);
}
}
于是:
主线程
↓
只负责 accept + Push
线程池
↓
负责真正执行 Task::Run()
5.5 线程池版 TCP Server 完整代码
到这里,线程池版本需要的几个模块已经全部具备:
主线程
↓
accept()
↓
获得一个新的 service_sock
↓
构造 Task
↓
Push 到任务队列
↓
继续 accept()
线程池中的工作线程
↓
提前创建
↓
等待任务
↓
从任务队列取出 Task
↓
Task::Run()
↓
处理客户端请求
和前面的多线程版本相比,最大的变化就是:
多线程版
Client 到来
↓
pthread_create()
↓
临时创建工作线程
变成:
线程池版
Server 启动
↓
提前创建固定数量工作线程
↓
Client 到来
↓
只需要构造 Task
↓
放入任务队列
这一阶段项目结构变成:
TcpServer
├── ThreadPool.hpp
├── Task.hpp
├── server.hpp
├── server.cc
├── client.hpp
├── client.cc
└── Makefile
其中:
client.hpp
client.cc
继续使用前面已经完成的 TCP Client,不需要修改。
这一阶段新增的是:
ThreadPool.hpp
Task.hpp
并重新修改:
server.hpp
ThreadPool.hpp
这里直接使用我们之前学习过的线程池。
线程池本质上仍然是一个:
生产者消费者模型。
主线程
↓
生产 Task
↓
任务队列
工作线程
↓
消费 Task
↓
执行 Run()
代码如下:
#pragma once
#include <iostream>
#include <vector>
#include <string>
#include <queue>
#include <pthread.h>
struct ThreadInfo
{
pthread_t tid;
std::string name;
};
static const int default_num = 5;
template<class T>
class ThreadPool
{
private:
void Lock()
{
pthread_mutex_lock(&mutex_);
}
void Unlock()
{
pthread_mutex_unlock(&mutex_);
}
void Wakeup()
{
pthread_cond_signal(&cond_);
}
void ThreadSleep()
{
pthread_cond_wait(&cond_, &mutex_);
}
bool IsQueueEmpty()
{
return tasks_.empty();
}
public:
static void* HandlerTask(void* args)
{
ThreadPool<T>* tp = static_cast<ThreadPool<T>*>(args);
while(true)
{
tp->Lock();
while(tp->IsQueueEmpty())
tp->ThreadSleep();
T task = tp->Pop();
tp->Unlock();
task.Run();
}
return nullptr;
}
void Start()
{
int num = threads_.size();
for(int i = 0; i < num; i++)
{
threads_[i].name = "thread-" + std::to_string(i + 1);
pthread_create(&threads_[i].tid, nullptr, HandlerTask, this);
}
}
T Pop()
{
T task = tasks_.front();
tasks_.pop();
return task;
}
void Push(const T& task)
{
Lock();
tasks_.push(task);
Wakeup();
Unlock();
}
static ThreadPool<T>* GetInstance()
{
if(tp_ == nullptr)
{
pthread_mutex_lock(&lock_);
if(tp_ == nullptr)
tp_ = new ThreadPool<T>();
pthread_mutex_unlock(&lock_);
}
return tp_;
}
private:
ThreadPool(int num = default_num)
: threads_(num)
{
pthread_mutex_init(&mutex_, nullptr);
pthread_cond_init(&cond_, nullptr);
}
~ThreadPool()
{
pthread_mutex_destroy(&mutex_);
pthread_cond_destroy(&cond_);
}
ThreadPool(const ThreadPool<T>&) = delete;
ThreadPool<T>& operator=(const ThreadPool<T>&) = delete;
private:
std::vector<ThreadInfo> threads_;
std::queue<T> tasks_;
pthread_mutex_t mutex_;
pthread_cond_t cond_;
static ThreadPool<T>* tp_;
static pthread_mutex_t lock_;
};
template<class T>
ThreadPool<T>* ThreadPool<T>::tp_ = nullptr;
template<class T>
pthread_mutex_t ThreadPool<T>::lock_ = PTHREAD_MUTEX_INITIALIZER;
线程池启动以后:
ThreadPool<Task>::GetInstance()->Start();
就会提前创建:
5 个 Worker
这些线程开始时没有任务,于是:
Lock
↓
发现任务队列为空
↓
pthread_cond_wait
↓
线程休眠
主线程以后:
Push(task);
就会:
任务入队
↓
pthread_cond_signal
↓
唤醒一个 Worker
↓
取出 Task
↓
Task::Run()
Task.hpp
那么什么是:
Task
呢?
前面的多线程版本把一个连接直接交给:
Service()
处理。
现在使用线程池以后,不能再:
accept
↓
创建线程
↓
Service
而是需要先把:
这次需要做的事情
封装成一个对象。
一份 TCP 服务任务至少需要知道:
service_sock
客户端 IP
客户端 Port
业务处理函数
因此:
Task task(service_sock, clientip, clientport, func_);
本质上就是:
把一次网络服务所需要的所有信息打包。
Task.hpp:
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <cstring>
#include <cerrno>
#include <unistd.h>
namespace fxs_server
{
using func_t = std::function<std::string(std::string)>;
class Task
{
public:
Task(int sockfd, const std::string& clientip, uint16_t clientport, const func_t& func)
: sockfd_(sockfd), clientip_(clientip), clientport_(clientport), func_(func)
{}
~Task()
{}
void Run()
{
char buff[1024];
std::string who = clientip_ + ":" + std::to_string(clientport_);
ssize_t n = read(sockfd_, buff, sizeof(buff) – 1);
if(n > 0)
{
buff[n] = '\\0';
std::cout << "Server get: "
<< buff
<< " from "
<< who
<< std::endl;
std::string respond = func_(buff);
write(sockfd_, respond.c_str(), respond.size());
}
else if(n == 0)
{
std::cout << "Client "
<< who
<< " quit!"
<< std::endl;
}
else
{
std::cerr << "Read Fail: "
<< strerror(errno)
<< std::endl;
}
close(sockfd_);
}
private:
int sockfd_;
std::string clientip_;
uint16_t clientport_;
func_t func_;
};
}
仔细看:
void Run()
其实就是前面:
Service()
中的核心业务。
只不过它发生了一个非常重要的变化:
以前:
while(true)
{
read
business
write
}
现在:
read
↓
business
↓
write
↓
close
↓
Task结束
也就是把:
while(true)
去掉了。
server.hpp
使用线程池以后,前面的:
ThreadData
Routine
Service
都不再需要。
因为:
ThreadData
↓
原来负责给临时创建的线程传参数
而现在:
Task
↓
已经把任务需要的参数全部封装起来
所以 Server 只需要负责:
accept
↓
构造 Task
↓
Push
完整代码:
#pragma once
#include <iostream>
#include <string>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
#include "ThreadPool.hpp"
#include "Task.hpp"
namespace fxs_server
{
const uint16_t default_port = 8877;
const std::string default_ip = "0.0.0.0";
const int backlog = 5;
enum
{
USAGE_ERR = 1,
SOCKET_ERR,
BIND_ERR,
LISTEN_ERR
};
class TcpServer
{
public:
TcpServer(const func_t& func, uint16_t port = default_port, const std::string& ip = default_ip)
: ip_(ip), port_(port), func_(func)
{}
~TcpServer()
{}
void InitServer()
{
// 1.创建监听套接字
listen_sock_ = socket(AF_INET, SOCK_STREAM, 0);
if(listen_sock_ < 0)
{
std::cerr << "Create Socket Fail: "
<< strerror(errno) << std::endl;
exit(SOCKET_ERR);
}
std::cout << "Create Socket Success: "
<< listen_sock_
<< std::endl;
// 2.绑定IP和Port
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port_);
local.sin_addr.s_addr = inet_addr(ip_.c_str());
if(bind(listen_sock_, (const struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "Bind IP&&Port Fail: "
<< strerror(errno) << std::endl;
exit(BIND_ERR);
}
std::cout << "Bind IP&&Port Success" << std::endl;
// 3.进入监听状态
if(listen(listen_sock_, backlog) < 0)
{
std::cerr << "Listen Fail: "
<< strerror(errno) << std::endl;
exit(LISTEN_ERR);
}
std::cout << "Listen Success" << std::endl;
}
void StartServer()
{
// 线程池只需要在服务器启动时创建一次
ThreadPool<Task>::GetInstance()->Start();
while(true)
{
// 1.获取新连接
struct sockaddr_in client;
socklen_t len = sizeof(client);
int service_sock = accept(listen_sock_, (struct sockaddr*)&client, &len);
if(service_sock < 0)
{
std::cerr << "Accept Fail: "
<< strerror(errno)
<< std::endl;
continue;
}
// 2.获取客户端信息
char clientip[32];
inet_ntop(AF_INET, &client.sin_addr, clientip, sizeof(clientip));
uint16_t clientport = ntohs(client.sin_port);
std::cout << "Get a new connection -> "
<< "[" << clientip << ":" << clientport << "] "
<< "service_sock: " << service_sock
<< std::endl;
// 3.构造任务
Task task(service_sock, clientip, clientport, func_);
// 4.把任务交给线程池
ThreadPool<Task>::GetInstance()->Push(task);
}
}
private:
int listen_sock_;
std::string ip_;
uint16_t port_;
func_t func_;
};
}
这里整个 Server 最核心的变化,其实只有:
ThreadPool<Task>::GetInstance()->Start();
和:
Task task(service_sock, clientip, clientport, func_);
ThreadPool<Task>::GetInstance()->Push(task);
最终运行流程:
Server启动
↓
创建5个Worker
↓
Worker全部等待任务
Main Thread
↓
accept Client A
↓
Task A
↓
Push
Worker 1
↓
Pop Task A
↓
Run()
Main Thread
↓
继续accept Client B
↓
Task B
↓
Push
Worker 2
↓
Pop Task B
↓
Run()
这就是线程池版本最核心的结构。
server.cc
业务处理仍然完全不需要变化:
#include <iostream>
#include <memory>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
到这里其实已经连续验证了很多次业务解耦的意义。
从:
单进程
↓
多进程
↓
多线程
↓
线程池
服务器内部的调度方式一直在改变。
但:
std::string Echo(const std::string& request)
{
return request;
}
始终不需要改变。
也就是说:
网络通信 / 并发模型
和:
具体业务
已经基本分开了。
5.6 运行线程池版 TCP Server
重新编译:
make clean
make
启动 Server:
./server 8877
这时候一个 Client 都还没有连接。
马上执行:
ps -aL | grep server
就应该能够看到:
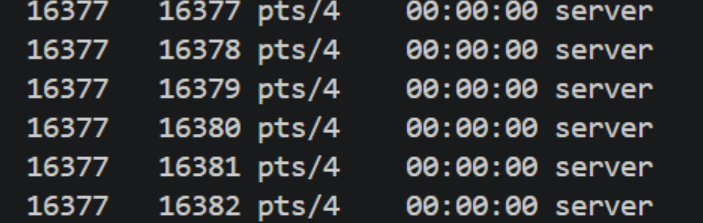
一共:
6 个线程
其中:
1 个主线程
+
5 个线程池 Worker
注意:
此时还没有任何客户端连接。
这正是线程池和前一个多线程版本最直观的区别。
前一个版本:
Server刚启动
↓
只有主线程
Client A来了
↓
多一个线程
Client B来了
↓
再多一个线程
而线程池:
Server刚启动
↓
主线程 + 5个Worker已经全部存在
再连接客户端
启动:
./client 127.0.0.1 8877
输入:
hello thread pool
流程:
Client
↓
connect
Server Main Thread
↓
accept
↓
Task
↓
Push
Worker
↓
Pop
↓
read
↓
Echo
↓
write
↓
close
客户端能够正常收到:
hello thread pool
但是如果继续在原来的连接中发送第二条消息,就会发现:
连接已经断开
这是正常的。
因为当前:
Task::Run()
在处理完一次请求以后执行:
close(sockfd_);
也就是说我们当前设计的是:
一次连接
↓
一次请求
↓
一次响应
↓
关闭
而不是:
建立一次连接
↓
while(true)
↓
长期通信
一定不要把这个现象理解成:
线程池不能处理 TCP 长连接。
它只能说明:
我们当前这个 Task 被人为设计成短任务。
5.7 三个版本放在一起看
现在正好可以把三个并发版本彻底串起来。
多进程
Client来了
↓
fork()
↓
Child
↓
Service
结构:
Parent
├── Child A
├── Child B
└── Child C
多线程
Client来了
↓
pthread_create()
↓
Thread
↓
Service
结构:
Server Process
├── Main Thread
├── Thread A
├── Thread B
└── Thread C
线程池
Server启动
↓
提前创建Worker
Client来了
↓
Task
↓
Queue
↓
已有Worker处理
结构:
Server Process
│
├── Main Thread
│ ↓
│ accept
│ ↓
│ Push
│
├── Worker 1 ─┐
├── Worker 2 │
├── Worker 3 ├── Task Queue
├── Worker 4 │
└── Worker 5 ─┘
所以整个服务器并发模型的演进其实非常自然:
单进程
↓
Service占住唯一执行流
↓
多进程
↓
能并发,但进程较重
↓
多线程
↓
更轻,但每来一个连接临时创建线程
↓
线程池
↓
提前创建固定数量线程
↓
连接来了只提交Task
到这里,我们已经从:
能通信
一步一步走到了:
如何更合理地组织服务器并发执行
下一步再继续解决:
怎样让这个 Server 脱离终端,长期运行在后台?
这就进入守护进程。
6. 把 TCP Server 变成守护进程
到目前为止,我们的 TCP Server 已经经历了:
单进程
↓
多进程
↓
多线程
↓
线程池
服务器已经具备了一定的并发处理能力。
但现在还有一个问题。
我们启动 Server 时使用:
./server 8877
程序会一直占着当前终端运行。
例如:
终端
│
└── ./server 8877
↓
长期运行
而真正的服务器程序往往需要:
长期运行
+
不占用终端
+
不依赖当前终端是否一直存在
例如:
sshd
crond
这种程序,并不需要我们始终打开一个终端看着它们。
这就引出了:
守护进程(Daemon)。
守护进程可以简单理解为:
脱离控制终端、长期在后台运行并提供某种服务的进程。
我们的 TCP Server 本身就是一个非常典型的适合守护进程化的程序。
6.1 先看看现在的 Server 到底和终端有什么关系
先暂时不要做任何守护进程化。
正常启动:
./server 8877
然后再打开一个终端执行:
ps axj | head -1
看到 
这里突然出现了一堆以前不太关注的字段:
PID
PPID
PGID
SID
TPGID
TTY
其中:
PID
↓
当前进程是谁
PPID
↓
当前进程的父进程是谁
PGID
↓
当前进程属于哪个进程组
SID
↓
当前进程属于哪个会话
TPGID
↓
当前终端的前台进程组
TTY
↓
当前进程关联的终端
例如:
TTY = pts/5
就说明:
当前 Server 仍然处在 pts/5 这个终端的控制体系中。
所以如果想真正理解守护进程,我们首先要把:
进程
进程组
作业
会话
控制终端
这几个概念串起来。
6.2 从一个终端理解进程组、作业和会话
这些概念如果分开背会非常乱。
直接记住下面这条关系:
一个终端
↓
对应一套会话 Session
↓
Session 中可以存在多个进程组 Process Group
↓
Shell 利用进程组进行作业控制
↓
其中最多有一个前台进程组
也就是说,可以粗略理解为:
Session
│
├── Foreground Process Group
│ ├── Process
│ └── Process
│
├── Background Process Group
│ └── Process
│
└── Background Process Group
├── Process
└── Process
接下来分别看看它们到底是什么。
6.2.1 进程组
进程除了有自己的:
PID
之外,还会属于一个:
Process Group
也就是:
进程组。
每个进程组都有:
PGID
一个进程组中可以包含多个相关进程。
例如我们前面写多进程 TCP Server 时:
Server父进程
├── Server子进程A
├── Server子进程B
└── Server子进程C
使用 ps 查看时就可能发现:
PID 不同
PGID 相同
也就是说:
它们是不同进程
↓
但属于同一个进程组
所以:
PID
↓
标识单独一个进程
PGID
↓
标识一组相关进程
为什么操作系统还需要把进程组成一个组?
其中一个非常重要的原因,就是:
方便对一组相关进程统一进行控制。
例如终端产生某些信号时,可以直接发送给:
一个前台进程组
而不是只发送给某一个进程。
6.2.2 作业
再看 Shell 中一个非常常见的现象。
执行:
sleep 100
此时终端会被它占用。
在 sleep 结束之前,Shell 不会重新给我们命令提示符。
这种就可以看作:
前台作业。
而如果:
sleep 100 &
Shell 会立即返回:
$
此时:
sleep 100
仍然在运行,但是已经成为:
后台作业。
所以 Shell 中:
前台
后台
jobs
fg
bg
这些功能,本质上都属于:
作业控制(Job Control)。
Shell 在实现作业控制时,会大量使用:
进程组
这个操作系统机制。
因此:
作业
更多是:
Shell 看待和管理用户任务的角度。
而:
进程组
则是:
操作系统真正用来组织进程的机制。
6.2.3 会话
比进程组范围更大的概念叫:
Session
也就是:
会话。
一个会话中可以包含多个:
Process Group
所以层级关系:
Session
↓
Process Group
↓
Process
例如:
Session
│
├── Process Group A
│ ├── Process 1
│ └── Process 2
│
├── Process Group B
│ └── Process 3
│
└── Process Group C
├── Process 4
└── Process 5
一个会话中:
最多有一个前台进程组
+
可以有多个后台进程组
而一个会话还可能拥有:
控制终端。
这就把最后一个概念串起来了。
6.3 控制终端到底控制了什么?
我们平时看终端,容易觉得它只是一个:
输入命令
+
显示输出
的窗口。
实际上终端还参与了:
进程控制。
最典型的例子就是:
Ctrl + C
假设当前运行:
./server 8877
然后按:
Ctrl + C
Server 会退出。
这里并不是:
Shell 发现你按了 Ctrl+C,然后自己调用 kill(server_pid)。
更接近真实的过程是:
Ctrl + C
↓
终端驱动识别特殊字符
↓
产生 SIGINT
↓
发送给当前终端的前台进程组
所以:
控制终端
不仅负责输入输出,还参与:
前台进程组
+
作业控制
+
终端产生的信号
例如:
Ctrl+C
↓
SIGINT
Ctrl+Z
↓
SIGTSTP
都会和:
当前前台进程组
发生关系。
现在再回头看 Server:
./server 8877
↓
属于当前Session
↓
属于某个进程组
↓
仍然关联当前控制终端
所以它还没有真正成为一个:
独立运行的后台服务
6.4 后台进程就是守护进程吗?
既然我们只是嫌 Server 占着终端,那能不能直接:
./server 8877 &
不就行了吗?
这样确实会立即返回 Shell。
但是:
后台进程并不等于守护进程。
执行:
./server 8877 &
只是让 Server 作为:
Shell 的后台作业
运行。
它通常仍然处在:
原来的 Session
+
原来的终端体系
之中。
可以执行:
ps -o pid,ppid,pgid,sid,tpgid,tty,stat,cmd -C server
继续观察。
通常仍然能够看到类似:
TTY = pts/5
SID = 当前终端对应的Session
也就是说:
./server &
只是:
不要占据Shell前台
并没有真正完成:
脱离原会话
脱离控制终端
所以真正的守护进程需要继续做更多工作。
6.5 setsid:真正脱离原来的会话
Linux 提供:
#include <unistd.h>
pid_t setsid(void);
调用:
setsid();
成功以后,当前进程会:
创建一个新的 Session
↓
自己成为 Session Leader
↓
同时创建一个新的 Process Group
↓
自己成为 Process Group Leader
↓
脱离原来的控制终端
这一步正是:
守护进程化最核心的操作。
如果我们原来是:
原Session
│
├── Shell
└── Server
↓
pts/5
调用:
setsid();
成功以后:
原Session
│
└── Shell
↓
pts/5
新Session
│
└── Server
↓
无控制终端
这样 Server 才真正从原来的终端控制体系中脱离出来。
6.6 为什么不能直接调用 setsid?
这里还有一个限制:
如果当前进程已经是进程组组长,那么 setsid() 会失败。
所以经典守护进程的第一步并不是:
setsid();
而是:
fork();
整体过程:
当前进程
↓
fork()
↓
┌──────────────┐
│ │
父进程 子进程
│ │
退出 继续
↓
setsid()
为什么新创建的子进程适合调用:
setsid();
呢?
因为子进程:
PID
↓
是一个新PID
但是它会继承父进程原来的:
PGID
所以通常:
子进程 PID != PGID
也就是说:
这个新子进程不是原进程组的组长。
于是可以成功:
setsid();
因此第一次 fork() 的一个非常重要的目的就是:
得到一个肯定不是原进程组组长的子进程,从而安全调用 setsid()。
6.7 为什么经典守护进程还要再 fork 一次?
现在:
第一次fork
↓
父进程退出
↓
子进程setsid()
当前子进程已经:
脱离原控制终端
+
成为新Session Leader
似乎已经够了。
但经典的守护进程实现通常还会:
fork();
第二次。
原因在于:
调用 setsid() 的进程已经成为了 Session Leader。
一个 Session Leader 在特定条件下仍存在:
重新获得控制终端
的可能。
所以再:
Session Leader
↓
fork()
↓
┌────────────────┐
│ │
父进程 子进程
Session Leader 最终Daemon
│ │
退出 继续运行
最终真正提供服务的进程:
不是 Session Leader
因此进一步避免它以后重新获得控制终端。
所以经典双重 fork() 的核心逻辑:
第一次fork
↓
为了能够setsid
setsid
↓
创建新会话并脱离控制终端
第二次fork
↓
让最终Daemon不再是Session Leader
↓
避免重新获得控制终端
需要特别注意:
第二次 fork() 的主要目的不是解决僵尸进程问题。
它解决的是:
Session Leader 仍可能重新获得控制终端的问题。
6.8 守护进程还需要处理什么?
完成:
fork
↓
setsid
↓
fork
以后,控制终端的问题基本解决了。
但是还有几个运行环境需要处理。
6.8.1 修改当前工作目录
假设我们在:
/home/lenovo/code/TcpServer
启动 Server。
当前进程的:
current working directory
也是:
/home/lenovo/code/TcpServer
守护进程可能长期运行几小时、几天,甚至更久。
经典守护进程通常会:
chdir("/");
把工作目录切换到根目录。
这样可以避免守护进程长期占用某个特定目录所在的文件系统。
Daemon
↓
chdir("/")
↓
不再依赖启动时所在目录
不过这里也要注意:
如果程序以后需要通过相对路径访问配置文件、网页资源等内容,就不能随便 chdir("/")。
例如以后 HTTP Server 使用:
./wwwroot
作为网站根目录,那么突然:
chdir("/");
就会导致:
./wwwroot
的含义发生变化。
因此生产程序应该根据自己的实际需求选择:
/
或者:
某个固定工作目录
当前 TCP Echo Server 不依赖相对路径,因此使用:
chdir("/");
没有问题。
6.8.2 修改 umask
进程会继承父进程的:
umask
而守护进程以后可能会创建:
日志文件
配置文件
PID文件
临时文件
为了避免启动它的 Shell 环境影响文件权限,可以重新设置:
umask(0);
这样守护进程后续创建文件时,就不会额外继承原进程的权限屏蔽规则。
当前只是为了学习经典守护进程流程。
实际项目中也可以根据安全需求设置一个明确的:
umask
而不是一定使用 0。
6.9 stdin、stdout、stderr 怎么办?
这里还有一个非常关键的问题。
我们当前 Server 中大量使用:
std::cout
std::cerr
本质上最终都会使用:
stdout
stderr
也就是:
fd 1
fd 2
正常前台程序:
fd 0 -> 当前终端
fd 1 -> 当前终端
fd 2 -> 当前终端
但是现在我们不是已经说:
守护进程要脱离终端吗?
所以:
0
1
2
就不应该继续依赖原来的终端。
经典做法之一就是:
全部重定向到 /dev/null。
/dev/null 是什么?
Linux 中:
/dev/null
是一个特殊设备文件。
可以简单理解成:
数据黑洞。
向它写数据:
echo "hello" > /dev/null
数据会直接被丢弃。
读取:
/dev/null
则会立即得到 EOF。
因此对于守护进程:
stdin
stdout
stderr
暂时不需要时,可以全部重定向到:
/dev/null
使用 dup2 完成重定向
先打开:
int fd = open("/dev/null", O_RDWR);
然后:
dup2(fd, STDIN_FILENO);
dup2(fd, STDOUT_FILENO);
dup2(fd, STDERR_FILENO);
最终:
fd 0 ─┐
fd 1 ─┼──> /dev/null
fd 2 ─┘
这样:
std::cout << "hello";
虽然代码仍然执行,但内容最终进入:
/dev/null
直接被丢弃。
所以一旦 Server 真正守护进程化以后:
原来终端里的 cout/cerr 日志看不到是正常现象。
真正的服务器以后应该使用:
日志文件
syslog
专业日志系统
记录运行信息。
6.10 手动实现完整守护进程
到这里,创建守护进程的所有步骤就都能解释清楚了。
完整流程:
当前进程
↓
fork()
↓
父进程退出
↓
子进程继续
↓
setsid()
↓
创建新Session
↓
脱离控制终端
↓
再次fork()
↓
Session Leader退出
↓
最终Daemon不是Session Leader
↓
umask()
↓
chdir()
↓
打开/dev/null
↓
dup2()
↓
0/1/2全部脱离终端
现在就把它真正写出来。
新增:
Daemon.hpp
当前项目:
TcpServer
├── Daemon.hpp
├── ThreadPool.hpp
├── Task.hpp
├── server.hpp
├── server.cc
├── client.hpp
├── client.cc
└── Makefile
6.10.1 Daemon.hpp
#pragma once
#include <cstdlib>
#include <unistd.h>
#include <fcntl.h>
#include <sys/stat.h>
#include <sys/types.h>
namespace fxs_daemon
{
enum
{
FORK_ERR = 1,
SETSID_ERR,
CHDIR_ERR,
OPEN_ERR,
DUP_ERR
};
void Daemon()
{
// 1.第一次fork
pid_t id = fork();
if(id < 0)
exit(FORK_ERR);
if(id > 0)
_exit(0);
// 2.创建新的Session,脱离原控制终端
if(setsid() < 0)
exit(SETSID_ERR);
// 3.第二次fork,让最终进程不再是Session Leader
id = fork();
if(id < 0)
exit(FORK_ERR);
if(id > 0)
_exit(0);
// 4.重新设置文件权限掩码
umask(0);
// 5.修改当前工作目录
if(chdir("/") < 0)
exit(CHDIR_ERR);
// 6.打开/dev/null
int fd = open("/dev/null", O_RDWR);
if(fd < 0)
exit(OPEN_ERR);
// 7.重定向标准输入、标准输出、标准错误
if(dup2(fd, STDIN_FILENO) < 0 ||
dup2(fd, STDOUT_FILENO) < 0 ||
dup2(fd, STDERR_FILENO) < 0)
{
exit(DUP_ERR);
}
if(fd > STDERR_FILENO)
close(fd);
}
}
这里使用:
_exit(0);
而不是普通:
exit(0);
是因为:
fork() 以后父子进程会继承用户层的一些缓冲状态。
_exit() 会直接结束当前进程,不再重复处理用户层缓冲区和退出处理函数。
在这种:
fork后父进程立即退出
的场景下更加直接。
6.10.2 接入当前 TCP Server
现在服务器已经是线程池版本。
其他代码:
ThreadPool.hpp
Task.hpp
server.hpp
client.hpp
client.cc
全部不用修改。
只需要修改:
server.cc
引入:
#include "Daemon.hpp"
然后在真正创建服务器之前:
Daemon();
完整:
#include <iostream>
#include <memory>
#include "server.hpp"
#include "Daemon.hpp"
using namespace std;
using namespace fxs_server;
using namespace fxs_daemon;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
// 将当前进程守护进程化
Daemon();
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
这里一定要注意调用顺序:
解析参数
↓
Daemon()
↓
InitServer()
↓
StartServer()
我们是在:
socket();
之前完成守护进程化。
因此当前:
listen_sock
service_sock
都还没有创建。
这样就不会出现守护进程化过程中误处理 Server Socket 的问题。
6.11 真正运行并观察守护进程
现在重新:
make clean
make
启动:
./server 8877
会发现:
命令几乎立即返回了。
例如:
lenovo@LAPTOP:~/code/TcpServer$ ./server 8877
lenovo@LAPTOP:~/code/TcpServer$
但是:
Server 并没有退出。
执行:
ps -o pid,ppid,pgid,sid,tpgid,tty,stat,cmd -C server
应该能够看到 Server 仍然存在。
最值得观察的是:
TTY
守护进程化之前:
TTY
↓
pts/5
守护进程化以后通常:
TTY
↓
?
也就是说:
之前
Server -> pts/5
之后
Server -> 无控制终端
这才是:
守护进程真正应该观察的现象。
再看 PID、PGID 和 SID
双重 fork() 后,最终运行 Server 的进程:
已经不是原来的那个进程
并且:
最终Daemon
↓
不是Session Leader
所以最终可能观察到:
PID != SID
甚至:
PID != PGID
这正是第二次:
fork();
留下来的结果。
原来调用:
setsid();
的那个进程:
PID = SID = PGID
但是它随后:
第二次fork
↓
自己退出
最终留下的子进程继承:
Session
+
Process Group
但它自己的:
PID
已经变成新的值。
因此最终 Daemon:
属于这个新Session
↓
但自己不是Session Leader
这正是我们想要的效果。
6.12 脱离终端以后还能正常提供 TCP 服务吗?
当然可以。
守护进程化改变的是:
Server 如何运行
而不是:
TCP 如何通信
所以 Client 仍然正常:
./client 127.0.0.1 8877
发送:
hello daemon
服务器仍然:
accept
↓
Task
↓
ThreadPool
↓
Echo
↓
返回Client
客户端仍然能够收到:
hello daemon
因此:
Daemon
和:
TCP
并不存在什么新的网络关系。
它只是把:
前台TCP Server
变成:
后台长期运行的TCP Server
6.13 Linux 已经提供了 daemon()
手动写完以后,我们已经真正知道:
守护进程为什么要fork
为什么需要setsid
为什么再fork
为什么处理工作目录
为什么处理umask
为什么处理0、1、2
实际上 Linux/glibc 已经提供了一个非常方便的函数:
#include <unistd.h>
int daemon(int nochdir, int noclose);
使用:
daemon(0, 0);
其中:
nochdir
控制:
是否改变工作目录
当:
nochdir == 0
时,会切换工作目录。
第二个参数:
noclose
控制:
是否处理stdin/stdout/stderr
当:
noclose == 0
时,会将标准输入、标准输出、标准错误处理到:
/dev/null
因此:
daemon(0, 0);
就可以帮助我们完成常见的守护进程化操作。
需要注意:
glibc 的 daemon() 并不是把我们上面的“双重 fork”代码一字不差地封装起来。
它完成的是常见的:
fork
↓
setsid
↓
chdir
↓
处理0、1、2
但 glibc 的实现不会再进行我们前面经典流程中的第二次 fork()。
因此调用成功后产生的进程仍可能是:
Session Leader
对于我们当前学习 TCP Server 来说:
daemon(0, 0);
已经足够方便地完成实验。
但手写经典双重 fork() 仍然有意义,因为它能让我们真正理解:
守护进程到底是怎样从原来的终端环境中脱离出来的。
6.14 使用 daemon() 简化 Server
如果不想自己维护:
Daemon.hpp
那么:
server.cc
甚至可以直接写成:
#include <iostream>
#include <memory>
#include <unistd.h>
#include "server.hpp"
using namespace std;
using namespace fxs_server;
std::string Echo(const std::string& request)
{
return request;
}
void Usage(const char* program)
{
cout << "Usage:" << endl;
cout << "\\t" << program << " ServerPort" << endl;
}
int main(int argc, char* argv[])
{
if(argc != 2)
{
Usage(argv[0]);
return USAGE_ERR;
}
uint16_t port = stoi(argv[1]);
if(daemon(0, 0) == –1)
return 1;
unique_ptr<TcpServer> server(new TcpServer(Echo, port));
server->InitServer();
server->StartServer();
return 0;
}
也就是把前面一整套守护进程化过程,在当前 Linux 环境下简化成:
daemon(0, 0);
但是现在我们再看到这一行时,已经不会只是:
“背一个 daemon API。”
而是能够知道它背后解决的到底是什么问题:
普通Server
↓
属于当前Session
↓
关联控制终端
↓
终端会参与作业控制
守护进程化
↓
创建独立Session
↓
脱离原控制终端
↓
处理运行目录
↓
处理文件权限掩码
↓
处理stdin/stdout/stderr
↓
长期后台运行
6.15 这一节到底要记什么?
守护进程这一块概念很多,但真正复习的时候不需要把所有名词拆开背。
只需要顺着这一条因果链:
我的TCP Server为什么要守护进程化?
↓
因为Server应该长期运行,不应该依赖一个终端一直存在
为什么普通 ./server & 不够?
↓
因为它只是后台作业,仍然处于原来的Session和终端体系中
为什么终端还能控制进程?
↓
因为进程属于进程组
↓
进程组属于Session
↓
Session可能关联控制终端
↓
终端通过前台进程组进行作业控制
怎么真正脱离原终端?
↓
setsid()
为什么setsid前先fork?
↓
进程组组长不能成功setsid
↓
fork出的子进程不是原进程组组长
setsid之后发生什么?
↓
创建新Session
↓
成为Session Leader
↓
创建新Process Group
↓
成为Process Group Leader
↓
脱离原控制终端
为什么还要第二次fork?
↓
让最终Daemon不再是Session Leader
↓
避免以后重新获得控制终端
然后还要处理什么?
↓
umask
chdir
stdin/stdout/stderr
stdin/stdout/stderr放哪?
↓
/dev/null
最终怎么验证?
↓
ps查看
↓
TTY从pts/x变成?
↓
Client仍然可以正常访问Server
如果这条能够顺着讲下来:
进程组、作业、会话、控制终端、setsid、双重 fork 和守护进程就不再是七八个互不相干的知识点,而是一整套因果关系。
到这里,我们才算真正把:
TCP Server
从一个普通前台程序,变成了一个更符合服务器运行形态的:
后台服务程序
接下来再回到 TCP 本身,从内核角度重新理解:
connect
accept
三次握手
四次挥手
Socket缓冲区
全双工
字节流
这些接口背后到底发生了什么。
7. 再从底层重新理解 TCP
程序写到这里,我们已经会用了。
接下来把刚才写代码时看到的现象重新串起来。
这一部分比代码本身更重要。
7.1 connect、accept 和三次握手到底是什么关系?
应用层:
Client
↓
connect()
Server
↓
accept()
很容易让人产生错觉:
connect
+
accept
=
三次握手
实际上不是。
真正的 TCP 连接建立发生在:
客户端和服务器操作系统中的 TCP 协议栈。
可以理解成:
Client Application
│
connect()
↓
Client TCP
│
│ 三次握手
↓
Server TCP
│
已建立连接
↓
完成连接队列
│
accept()
↓
Server Application
所以:
connect();
是:
应用层告诉内核:我要主动连接这个 Server。
accept();
是:
Server 应用从内核已经建立完成的连接中拿走一个结果。
因此:
accept 不参与三次握手的具体过程。
即使应用暂时没有:
accept();
只要队列还有空间,TCP 三次握手仍然可能完成。
这也是为什么前面的:
Client B
能够显示:
connect 成功
但 Server 程序仍然卡在:
Service(Client A)
7.2 TCP 连接需要成本吗?
当然需要。
服务器同时维护:
Client A
Client B
Client C
……
操作系统不能只记一句:
“我和 A 连着呢。”
它至少必须维护大量 TCP 状态:
对端 IP
对端 Port
本端 IP
本端 Port
TCP 状态
序号信息
确认信息
发送相关状态
接收相关状态
缓冲区
……
因此内核需要:
先描述连接
↓
形成内核对象
↓
再用数据结构组织这些对象
所以:
TCP 连接本身是有时间和空间成本的。
这也是为什么实际服务器不能无限维护连接。
7.3 简单理解三次握手
Client 主动连接:
Client Server
SYN
───────────────────────────>
SYN + ACK
<───────────────────────────
ACK
───────────────────────────>
TCP Connection Established
这个过程由:
两端 TCP 协议栈
负责。
应用层主要看到的现象就是:
connect 成功
accept 返回
具体三次握手为什么一定是三次、序号如何交换、为什么能够避免历史连接等问题,后面的 TCP 协议进阶再详细展开。
这里暂时只建立:
TCP 通信之前
↓
先建立连接
↓
建立连接依赖三次握手
这条主线。
7.4 简单理解四次挥手
假设 Client 主动关闭:
Client Server
FIN
───────────────────────────>
ACK
<───────────────────────────
FIN
<───────────────────────────
ACK
───────────────────────────>
应用层看到:
close(client_sock);
会触发 TCP 关闭过程。
Server:
read();
最终读取到:
0
就能够知道:
对端这一方向已经关闭。
Server 随后也:
close();
触发自己这一侧的关闭流程。
所以:
close()
read() == 0
都是应用层看到的接口现象。
真正的:
FIN
ACK
TCP 状态转换
仍然由内核 TCP 协议栈完成。
7.5 TCP 通信的本质:先拷到内核缓冲区
假设应用代码:
char buff[1024];
write(sock, buff, n);
千万不要理解成:
write() 一调用,CPU 就立刻把这些数据直接发送到另一台电脑。
更准确地说:
用户层 buff
↓
write()
↓
内核 Socket 发送缓冲区
随后:
TCP 协议栈什么时候真正发送、怎么分段、什么时候重传,由内核自己决定。
接收也是:
网络数据
↓
TCP
↓
Socket 接收缓冲区
↓
read()
↓
应用层 buff
所以从应用层角度:
write();
首先做的是:
把用户层数据交给内核。
read();
首先做的是:
把内核已经收到的数据拷贝到用户缓冲区。
7.6 为什么 TCP 是全双工?
每条 TCP 连接都能够:
Client -> Server
同时:
Server -> Client
双方互不排斥。
可以粗略理解成两端都存在自己的:
发送方向
+
接收方向
例如:
Client 发送缓冲区
↓
Server 接收缓冲区
Server 发送缓冲区
↓
Client 接收缓冲区
所以:
Client 正在给 Server 发数据,并不妨碍 Server 同时给 Client 发数据。
这就是 TCP:
全双工
的重要体现。
7.7 TCP 最大的问题:它是字节流,不是消息流
我们前面的 Echo 程序还有一个非常重要的问题。
Client:
write(sock, "hello", 5);
Server:
read(sock, buff, sizeof(buff));
我们当前代码默认:
一次 write
↓
对应一次 read
但 TCP 根本没有这种保证。
TCP 只提供:
连续、有序、可靠的字节流。
例如客户端:
write("hello")
write("world")
Server 有可能:
第一次 read
↓
helloworld
也可能:
第一次
↓
hel
第二次
↓
loworld
甚至还可能有其他组合。
所以:
发送了几次
和:
对方 read 了几次
没有一一对应关系。
这和管道非常类似:
写端
↓
连续写入字节流
读端
↓
根据当前缓冲区状态读取
因此真实 TCP 应用一定要解决:
怎么判断一条完整消息到底从哪里开始、在哪里结束?
答案就是:
应用层协议。
例如:
固定长度
或者:
特殊分隔符
或者:
长度字段 + 正文
这些将在后面的协议设计中继续解决。
所以一定记住:
TCP 保证字节可靠有序
≠
TCP 帮你保存应用层消息边界
7.8 网络字节序不要和应用数据混在一起
这里还要纠正一个特别容易混淆的问题。
像:
sin_port
这样的协议字段,需要:
htons();
ntohs();
因为 TCP/IP 协议规定这些数字字段使用:
网络字节序
但是:
write(sock, buff, n);
read(sock, buff, n);
并不会自动把你:
buff
里的所有整数从小端改成大端,或者再自动改回来。
例如:
int x = 0x12345678;
write(sock, &x, sizeof(x));
write() 只会把:
x 在当前内存中的 4 个字节
交给内核。
不会理解:
这 4 个字节原来是一个 int,我替你做一下 htonl()。
因此真正需要跨平台传递数字时:
程序员自己定义协议
↓
明确哪些字段是数字
↓
自己完成序列化和字节序转换
网络接口负责的是:
传输字节
而不是理解你应用层数据的类型。
7.9 TIME_WAIT 和服务器快速重启
测试时可能遇到:
关闭 Server
↓
立刻重新启动
↓
bind: Address already in use
这和 TCP 连接关闭后的状态有关。
在 TCP 四次挥手中:
主动关闭的一方可能进入 TIME_WAIT。
所以不能简单记成:
Server 一定 TIME_WAIT
而应该记:
谁主动完成关闭
↓
谁可能进入 TIME_WAIT
如果服务器开发过程中需要频繁重启,可以使用:
setsockopt();
设置:
SO_REUSEADDR
后面马上封装。
8. 封装 Socket 接口
到现在我们已经反复写过:
socket();
bind();
listen();
accept();
connect();
close();
这些代码。
继续往后的网络项目还会不断使用。
所以应该将它们统一封装。
8.1 Socket.hpp
#pragma once
#include <iostream>
#include <string>
#include <cstring>
#include <cerrno>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <arpa/inet.h>
#include <netinet/in.h>
enum
{
SOCKET_ERR = 2,
BIND_ERR,
LISTEN_ERR
};
const int backlog = 10;
class Sock
{
public:
Sock()
: sockfd_(–1)
{}
~Sock()
{}
void Socket()
{
sockfd_ = socket(AF_INET, SOCK_STREAM, 0);
if(sockfd_ < 0)
{
std::cerr << "socket error: "
<< strerror(errno)
<< std::endl;
exit(SOCKET_ERR);
}
int opt = 1;
setsockopt(sockfd_, SOL_SOCKET, SO_REUSEADDR, &opt, sizeof(opt));
}
void Bind(uint16_t port)
{
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port);
local.sin_addr.s_addr = INADDR_ANY;
if(bind(sockfd_, (struct sockaddr*)&local, sizeof(local)) < 0)
{
std::cerr << "bind error: "
<< strerror(errno)
<< std::endl;
exit(BIND_ERR);
}
}
void Listen()
{
if(listen(sockfd_, backlog) < 0)
{
std::cerr << "listen error: "
<< strerror(errno)
<< std::endl;
exit(LISTEN_ERR);
}
}
int Accept(std::string* clientip, uint16_t* clientport)
{
struct sockaddr_in peer;
socklen_t len = sizeof(peer);
int newfd = accept(sockfd_, (struct sockaddr*)&peer, &len);
if(newfd < 0)
return –1;
char ipstr[64];
inet_ntop(AF_INET, &peer.sin_addr, ipstr, sizeof(ipstr));
*clientip = ipstr;
*clientport = ntohs(peer.sin_port);
return newfd;
}
bool Connect(const std::string& ip, uint16_t port)
{
struct sockaddr_in peer;
memset(&peer, 0, sizeof(peer));
peer.sin_family = AF_INET;
peer.sin_port = htons(port);
inet_pton(AF_INET, ip.c_str(), &peer.sin_addr);
int n = connect(sockfd_, (struct sockaddr*)&peer, sizeof(peer));
if(n == –1)
return false;
return true;
}
void Close()
{
close(sockfd_);
}
int Fd() const
{
return sockfd_;
}
private:
int sockfd_;
};
以后服务器初始化就从:
一大堆系统调用
变成:
listensock_.Socket();
listensock_.Bind(port_);
listensock_.Listen();
获取连接:
int sockfd = listensock_.Accept(&clientip, &clientport);
客户端连接:
sock_.Socket();
sock_.Connect(server_ip, server_port);
代码结构会清楚很多。
8.2 setsockopt
刚才:
Socket();
中还有:
int opt = 1;
setsockopt(sockfd_, SOL_SOCKET, SO_REUSEADDR, &opt, sizeof(opt));
setsockopt() 用来:
修改 Socket 的各种工作选项。
Linux 常见函数形式:
int setsockopt(int sockfd,
int level,
int optname,
const void* optval,
socklen_t optlen);
其中:
sockfd
↓
修改哪个 Socket
level
↓
选项属于哪一层
optname
↓
具体哪个选项
optval
↓
选项值
optlen
↓
选项值长度
8.3 常见 Socket 选项
SOL_SOCKET
常见:
SO_REUSEADDR
↓
允许地址在特定情况下快速重新绑定,
开发服务器快速重启时经常使用
SO_RCVBUF
↓
接收缓冲区大小
SO_SNDBUF
↓
发送缓冲区大小
SO_KEEPALIVE
↓
开启 TCP Keepalive 检测
SO_LINGER
↓
控制 close 时未发送数据的处理方式
SO_DEBUG
↓
Socket 调试相关
SO_OOBINLINE
↓
带外数据相关
还有:
SO_BROADCAST
用于允许广播发送,主要和 UDP 数据报场景有关。
IPPROTO_TCP
TCP 特有选项例如:
TCP_NODELAY
↓
关闭 Nagle 算法,
需要更低小包延迟时可能使用
TCP_MAXSEG
↓
TCP 最大报文段相关设置
IPPROTO_IP
例如:
IP_MULTICAST_IF
IP_MULTICAST_TTL
IP_ADD_MEMBERSHIP
IP_DROP_MEMBERSHIP
主要用于:
IP 多播
这种场景更加常见于 UDP。
本篇不继续展开。
现在只需要建立:
Socket 行为不是固定死的,内核提供了大量 Socket Option 允许程序调整。
总结
这一篇真正把 TCP Socket 编程的主线完整走通了。
最基础的 TCP Server:
socket()
↓
bind()
↓
listen()
↓
accept()
↓
read() / write()
TCP Client:
socket()
↓
connect()
↓
read() / write()
其中一定要区分:
listen_sock
↓
监听、获取新连接
service_sock
↓
真正和某一个客户端通信
一个服务器如果同时连接三个 Client:
1 个监听 Socket
+
3 个通信 Socket
单进程版本:
accept
↓
Service
↓
Service 不退出
↓
无法继续 accept
所以必须让:
获取连接
和:
处理连接
进入不同执行流。
第一种:
多进程
父进程
↓
accept
子进程
↓
Service
然后又需要解决:
子进程退出
↓
僵尸进程
因此学习了:
waitpid + WNOHANG
SIGCHLD 信号处理
SIGCHLD -> SIG_IGN
双重 fork
进一步:
多线程
变成:
主线程
↓
accept
工作线程
↓
Service
通过:
ThreadData
将:
sock
IP
Port
this
一起传给线程。
再使用:
pthread_detach();
让工作线程自动回收。
继续优化:
来一个连接
↓
创建一个线程
变成:
程序启动
↓
提前创建 Worker
↓
accept
↓
Task Queue
↓
线程池处理
这又重新回到了以前学习过的:
生产者消费者模型
随后将 Server:
脱离控制终端
+
长期后台运行
就得到了:
守护进程
这一过程中又把 Linux 进程体系串了起来:
进程
↓
进程组
↓
会话
↓
控制终端
经典守护进程流程:
fork
↓
setsid
↓
再次 fork
↓
chdir
↓
umask
↓
处理文件描述符
而 Linux 已经提供:
daemon();
帮助我们直接完成常见守护进程化操作。
最后再从内核重新理解 TCP:
connect()
↓
通知客户端 TCP 主动建立连接
三次握手
↓
双方操作系统 TCP 协议栈完成
accept()
↓
应用层取走已经建立好的连接
所以:
connect 成功
≠
Server 已经执行 accept
也解释了为什么:
单进程 Server 忙着服务 A
时:
B 的 connect
仍然可能成功。
TCP 通信本身:
应用层 buff
↓
write
↓
Socket 发送缓冲区
↓
TCP 自己决定什么时候发送
网络
↓
TCP 接收缓冲区
↓
read
↓
应用层 buff
所以:
write/read
本质上首先是:
用户空间和内核 Socket 缓冲区之间的数据拷贝。
两边又分别具有发送和接收方向,因此 TCP 能够实现:
全双工
但 TCP 是:
面向字节流
所以:
一次 write
≠
一次 read
真正的网络程序还必须继续解决:
如何从连续字节流中识别出一条完整消息?
这就需要:
应用层协议
而这也正是后面网络编程要继续解决的问题。
最后把这一篇压成一条复习链:
UDP 已会
↓
TCP 多了“连接”
↓
Server:socket -> bind -> listen -> accept
↓
Client:socket -> connect
↓
双方 read/write
↓
监听 Socket 和通信 Socket 必须分开
↓
单进程无法同时处理多个长连接
↓
多进程
↓
子进程回收
↓
多线程
↓
线程池
↓
守护进程
↓
连接其实由内核 TCP 维护
↓
connect 触发建连,accept 只是拿结果
↓
TCP 发送接收依赖 Socket 缓冲区
↓
TCP 全双工
↓
TCP 是字节流
↓
下一步:应用层协议
如果这一整条能够顺着说下来,那么 TCP Socket 编程这一篇的核心知识就真正串起来了。