文章目录
-
- 1. 先说结论
- 2. 审计对象,和两次快照
- 3. 发现一:32 个月报文件,发布滞后 5–13 天
- 4. 发现二:32 次发布,一次都没落在周末
- 5. 发现三:差饷署五张表,在同一秒被覆盖写
- 6. 发现四:同一个「临时」,五个源口径一致
- 7. 发现五:同样的月份,留下的可复现痕迹差多少
- 8. 免费的变更检测:条件请求
- 9. 踩坑清单与结论
- 10. 参考链接
1. 先说结论
同样是「香港某个月的楼市数据」,两份官方公开数据给出的东西差别很大。我把 37 个文件全量探了一遍:
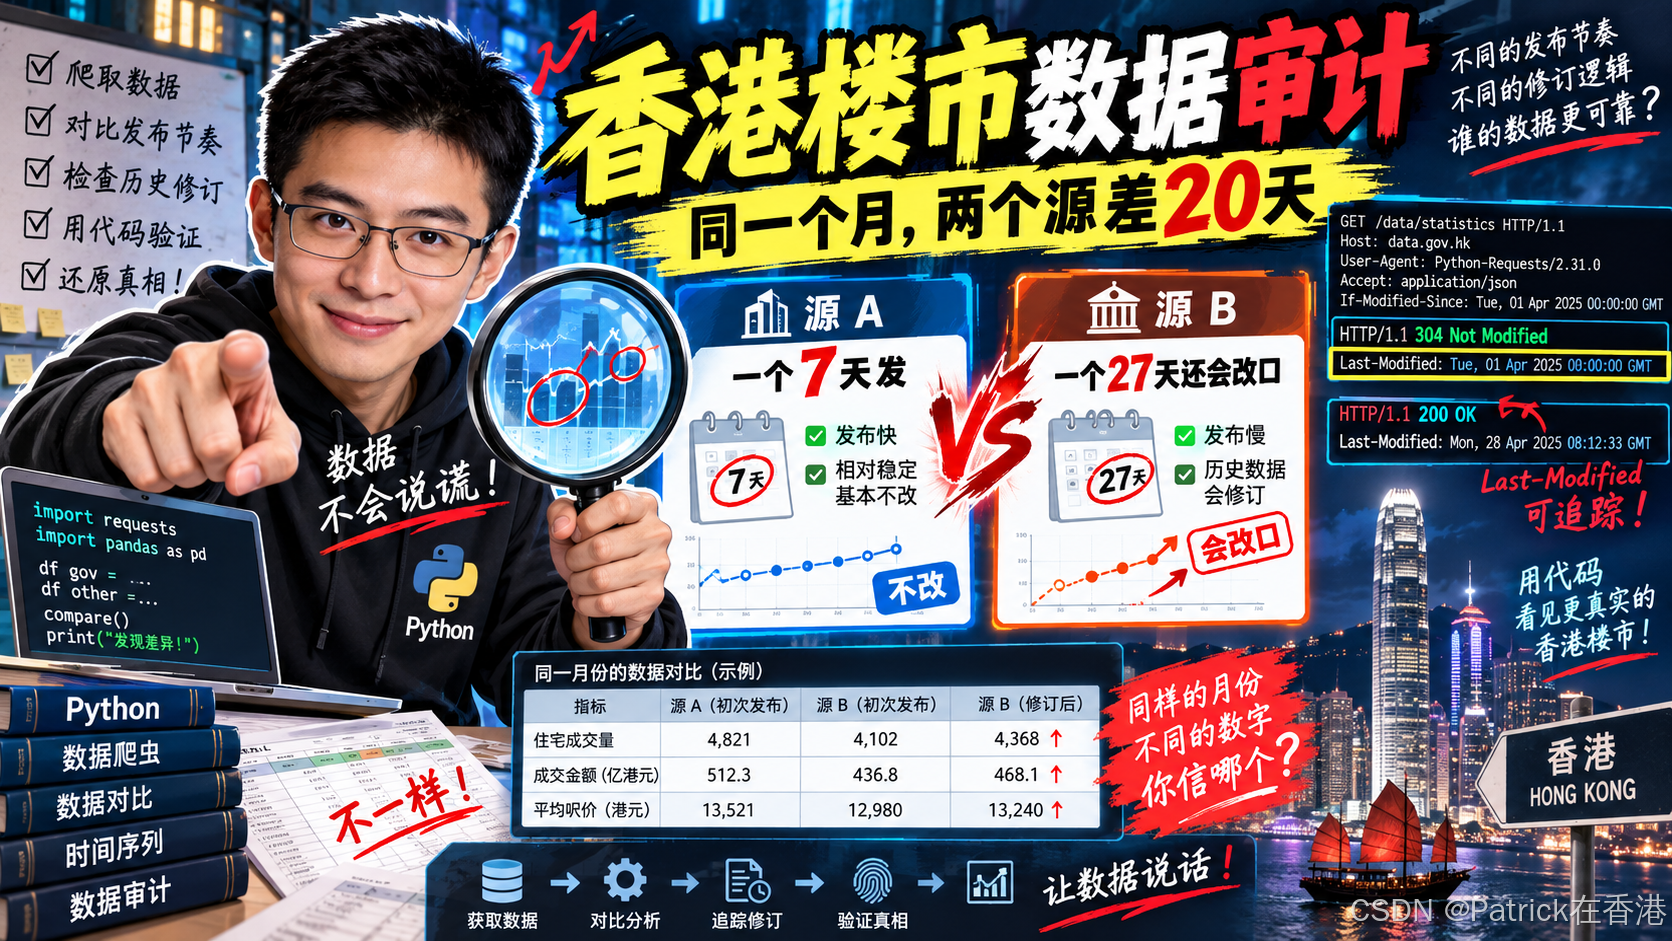
| 同一个月的数据,两个源差多久? | 差了 20 天。2026 年 7 月的成交数据,土地注册处在 8 月 7 日就发了;差饷署那张房价表要到 8 月 27 日 |
| 发布之后,数字还会变吗? | 一个不会,一个会。土地注册处 32 个月报文件的 Last-Modified 全部停在各自的发布日,之后再没被动过;差饷署最近 3 个月的数字带着临时标记 P,将来会被改口 |
| 出了错,能倒查吗? | 土地注册处有 32 个互不相同的哈希可核对;差饷署五张表的时间戳精确到秒完全相同,单表什么时候被改过,从元数据一点都看不出来 |
这篇不是房价分析——2026-09-15 这天我把同一批 URL 探了两遍,37 个文件一个字节都没变。所以真正值得挖的是:它为什么不变,以及什么时候一定会变。
2. 审计对象,和两次快照
两份数据我都在用:
| 土地注册处 月报 | 一个月一个文件 YYYYMM_data.json | 2021 起(我取了最近 32 个月) |
| 差饷署 RVD | 5 张持续覆盖写的 CSV | 1992/1993/1999 起,逐月 |
探两件事:HTTP 响应头(Last-Modified / Content-Length)、以及正文的 SHA-256。先写采集。
import subprocess, hashlib, json
def head(url):
"""取响应头。返回真实状态码 + 头字段。"""
out = subprocess.run(["curl", "-sIL", "-m", "30", url],
capture_output=True, text=True).stdout
# 🔴 首行可能是代理开隧道留下的「HTTP/1.1 200 Connection Established」,
# 必须取**最后一个** HTTP 状态行才是真实状态码
lines = out.splitlines()
statuses = [l.split()[:2] for l in lines if l.startswith("HTTP/")]
code = statuses[–1][1] if statuses else "000"
h = {}
for line in lines:
if ":" in line:
k, _, v = line.partition(":")
h[k.strip().lower()] = v.strip()
return code, h
def probe(url):
"""一条台账记录:状态码 + 元数据 + 内容指纹。"""
code, h = head(url)
rec = {"url": url, "status": code,
"last_modified": h.get("last-modified"),
"content_length": int(h["content-length"]) if h.get("content-length") else None}
if code == "200":
body = subprocess.run(["curl", "-sL", "-m", "60", url],
capture_output=True).stdout
rec["bytes"] = len(body)
rec["sha256"] = hashlib.sha256(body).hexdigest()
return rec
那个「取最后一个 HTTP 状态行」的注释不是我多事——我第一版就是按常见写法取的第一行,结果 37 个文件全部被记成「状态码 200 OK 里的 OK」,整套台账从第一步就是废的。这类错误不抛异常,只是让后续所有统计都建立在错误数据上。
第一次快照和第二次快照间隔 2 分 02 秒:
快照 ① 2026-09-15T11:59:29+08:00
快照 ② 2026-09-15T12:01:31+08:00
内容指纹相同 37/37|Last-Modified 相同 37/37
零变化。 这个结果本身有用:它说明「数据不会在你写代码的时候偷偷变」,所以接下来的问题不是「变没变」,而是**「它按什么节奏变」**。而 Last-Modified 正好把每个文件的发布日记录下来了。
3. 发现一:32 个月报文件,发布滞后 5–13 天
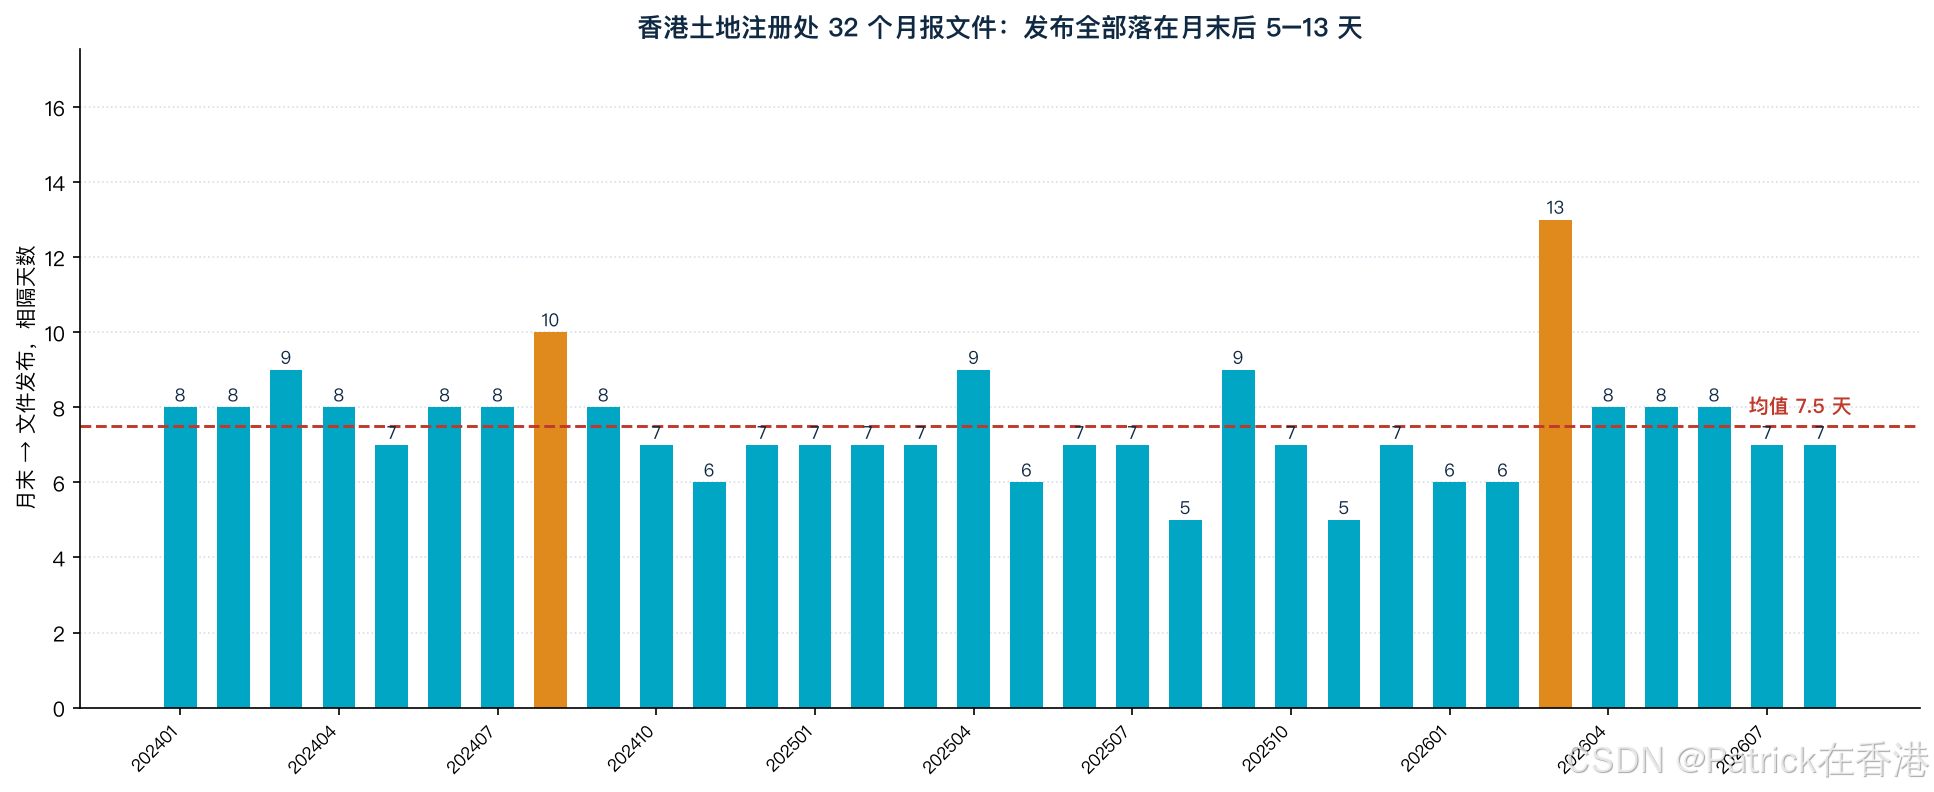
对每个文件,算出「月末 → 文件发布」相隔几天:
import datetime as dt, email.utils
def month_end(ym):
y, m = int(ym[:4]), int(ym[4:])
return dt.date(y + (m == 12), (m % 12) + 1, 1) – dt.timedelta(days=1)
def lag_days(ym, last_modified):
pub = email.utils.parsedate_to_datetime(last_modified).date()
return (pub – month_end(ym)).days, pub
这段发布滞后测算可以收藏备用——换一批月度文件,改两行就能算出它们的发布节奏。32 个文件的结果是:最短 5 天,最长 13 天,均值 7.50 天。分布是:
5 天: 2 个 6 天: 4 个 7 天: 12 个 8 天: 9 个
9 天: 3 个 10 天: 1 个 13 天: 1 个
七到八天占了 21/32,也就是三分之二的月份,你都能在下个月 8 号前后拿到数据。唯一一次明显拖后的是 2026 年 3 月那份:月末 3 月 31 日,直到 4 月 13 日才出现,滞后 13 天。
有意思的是文件体积:32 个文件的字节数落在 11,421 ~ 11,509 之间,极差 88 字节,不到 0.8%。结构完全固定,每月只换数字——这说明它是模板化生成的,不是人工排版的报告,也解释了为什么发布时间能这么稳。
4. 发现二:32 次发布,一次都没落在周末
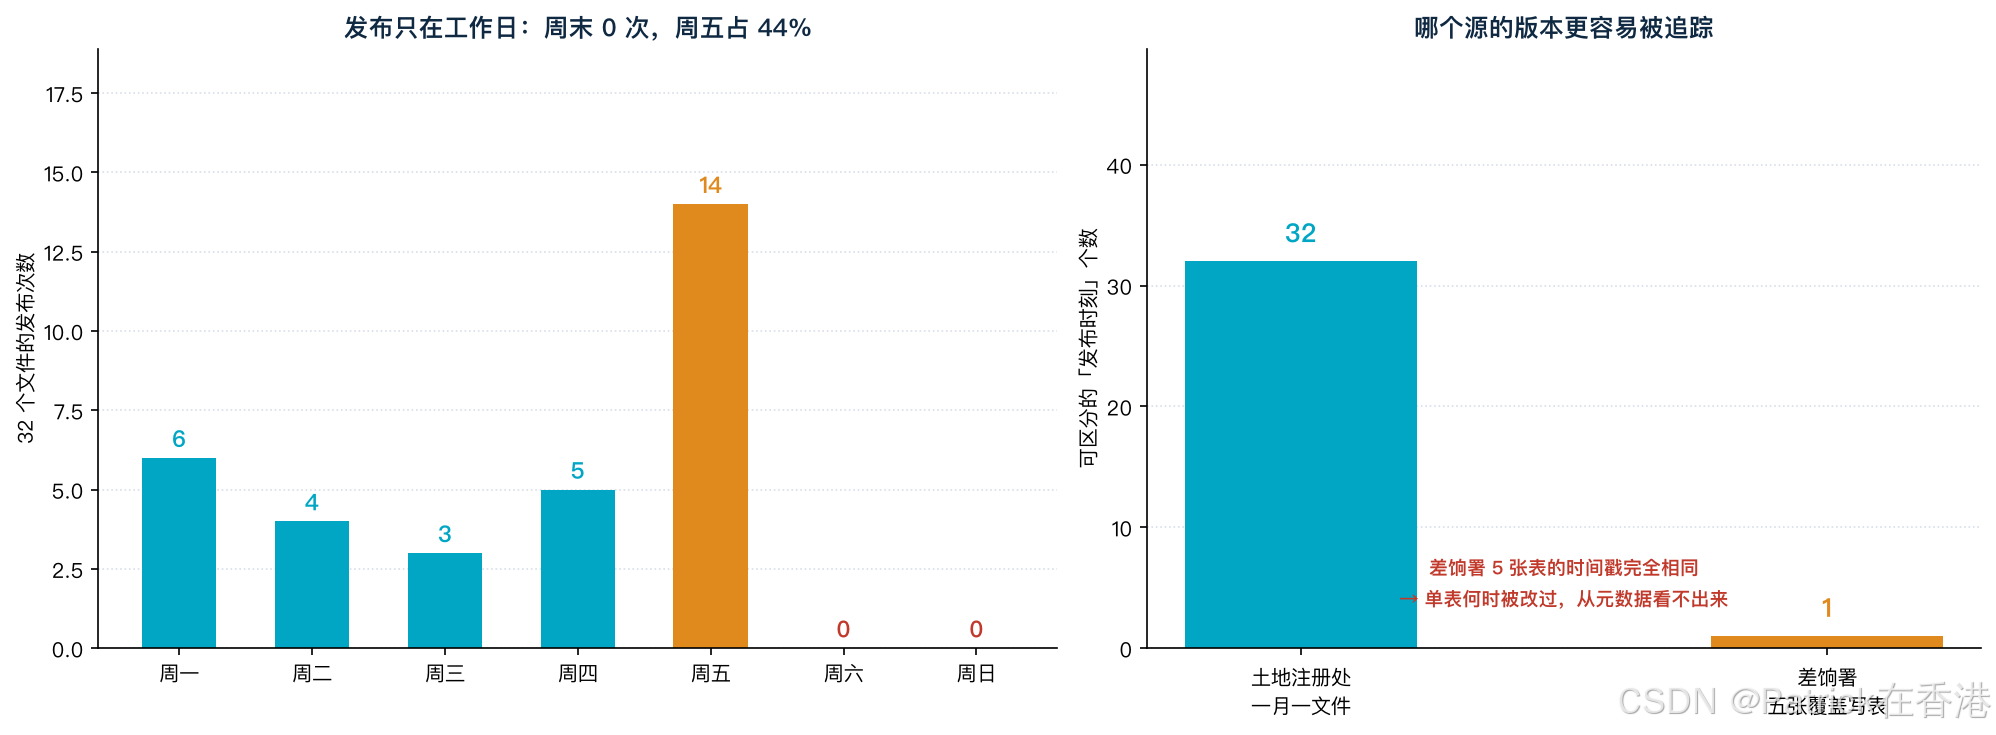
把 32 个发布日按星期归一下:
周五 14 次 | 周一 6 次 | 周四 5 次 | 周二 4 次 | 周三 3 次
周六 0 次 | 周日 0 次
32 次发布全部落在工作日,周五占 44%。
这个规律有直接的工程价值:如果你要轮询拿新数据,没必要一周七天都跑。按「月末后第 5 天开始,每个工作日探一次」就够了,能砍掉大约 29% 的无效请求(周末那两天)。
5. 发现三:差饷署五张表,在同一秒被覆盖写
同一个 7 月的数据,土地注册处 8 月 7 日就发了。那差饷署呢?
1.1M Thu, 27 Aug 2026 02:00:04 GMT 29,168 B
1.2M Thu, 27 Aug 2026 02:00:04 GMT 41,804 B
1.3M Thu, 27 Aug 2026 02:00:04 GMT 25,239 B
1.4M Thu, 27 Aug 2026 02:00:04 GMT 25,203 B
1.5M Thu, 27 Aug 2026 02:00:04 GMT 28,763 B
五张表的时间戳完全相同,精确到秒(2026-08-27 02:00:04 GMT,香港时间上午 10 点)。而且它们的最新月份都是 07-2026。
所以同一个 7 月:土地注册处 8 月 7 日就给,差饷署要等到 8 月 27 日——差 20 天。
更关键的是可区分度:土地注册处 32 个文件有 32 个不同的时间戳;差饷署 5 张表加起来只有 1 个可比对的发布时刻,而且是整体覆盖写——你是无法从元数据看出「1.2M 这张表单独在某天被改过」的。
6. 发现四:同一个「临时」,五个源口径一致
差饷署的表里,每个数值列后面跟一列 Remarks。最近三个月是这样的:
def rvd_p_scan(csv_text):
"""扫一张 RVD 表:哪些月份被标为 P(临时数字)。"""
import csv as _csv, io
rows = list(_csv.reader(io.StringIO(csv_text)))
hdr_i = next(i for i, r in enumerate(rows) if r and r[0] == "Month")
hdr, data = rows[hdr_i], [r for r in rows[hdr_i + 1:] if r and "-" in r[0]]
remark = [i for i, h in enumerate(hdr) if h.strip().endswith("Remarks")]
return sorted({data[i][0] for i, r in enumerate(data)
for c in remark if c < len(r) and r[c].strip() == "P"})
五张表跑出来结果一致:
1.1M P 月份: ['05-2026', '06-2026', '07-2026']
1.2M P 月份: ['05-2026', '06-2026', '07-2026']
1.3M P 月份: ['05-2026', '06-2026', '07-2026']
1.4M P 月份: ['05-2026', '06-2026', '07-2026']
1.5M P 月份: ['05-2026', '06-2026', '07-2026']
P 的窗口是全局统一的,不是每张表各标各的。而且注意:1.1M / 1.2M 有 331 个月的数据(1999 年起),1.5M 有 415 个月(1992 年起)——在几百个月的历史里,只有最后 3 个月被标成临时。
这说明 P 是一个滚动窗口:数字发布时是临时的,往后滚动三个月左右就定型。所以「临时数字」的存在期限是可预期的大约 3 个月,而不是无限期挂着。
但这里有一条边界必须说清楚: 差饷署的文件是覆盖写的,官方又不提供历史版本。所以「三个月后的确定值会不会和今天看到的临时值不同、差多少」——我在这台机器上验证不了。我只能证明「标记了临时」,不能证明「改了多少」。任何拿这个差异做结论的写法都是猜。
7. 发现五:同样的月份,留下的可复现痕迹差多少
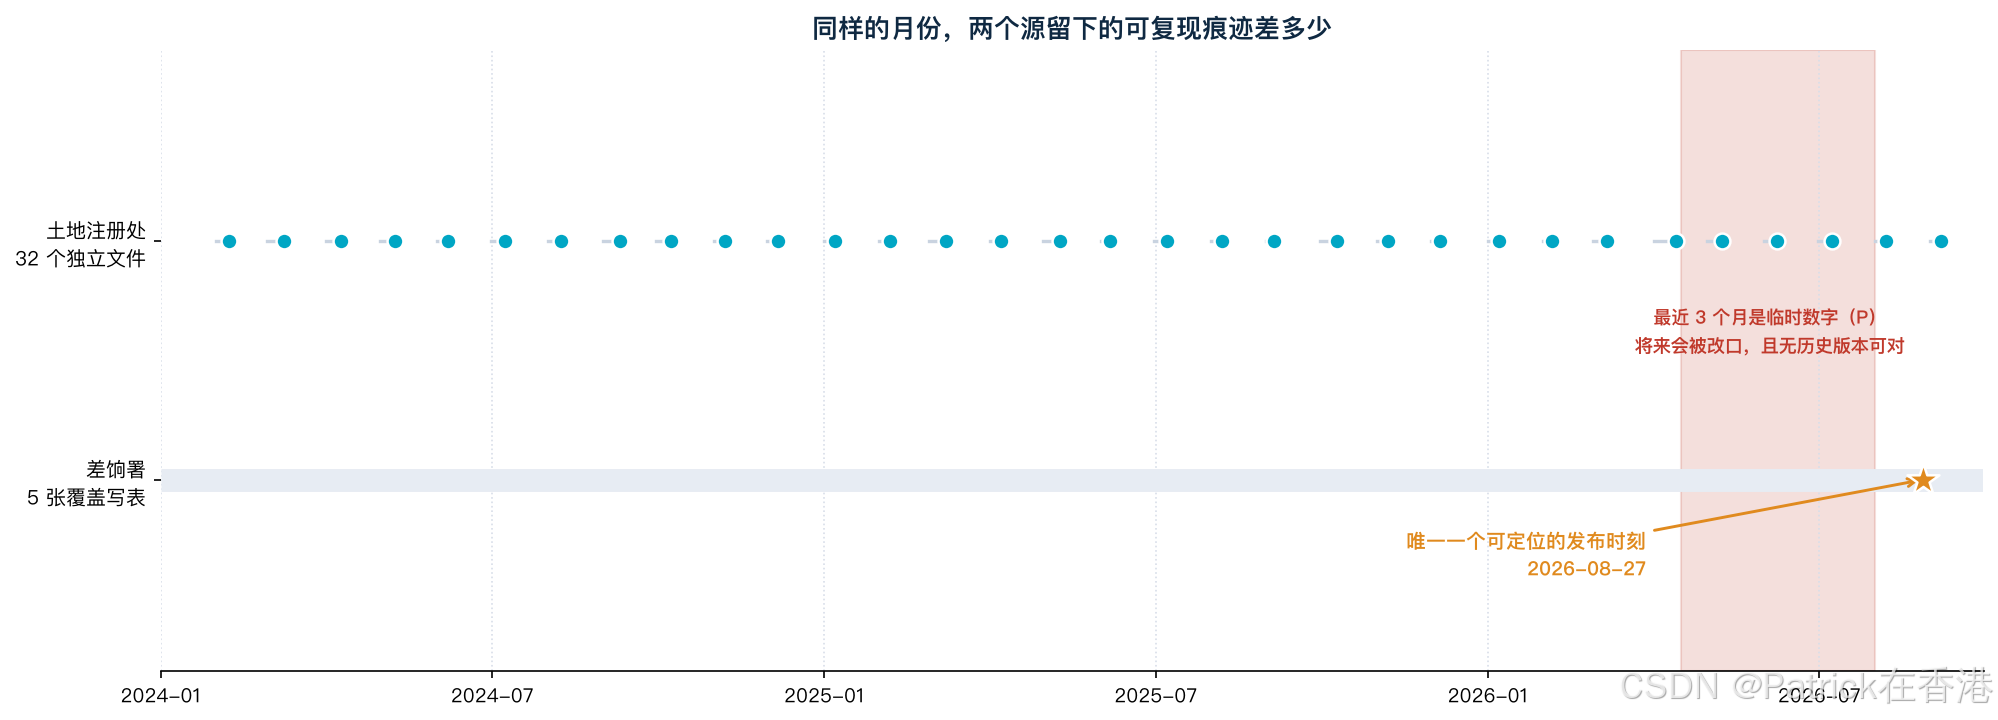
把两条轨放在同一条时间轴上,差别一眼可见:
- 土地注册处:32 个独立文件,每个有自己的 Last-Modified 和 SHA-256。你今天存下的哈希,随时能再下一次核对。
- 差饷署:一张表覆盖全部历史,你看到的永远是「最新一版」。没有历史版本,就没有对账的锚点。
落到工程上就是一句话:做需要复现的历史看板,选前者;只要当期读数,后者也行。
8. 免费的变更检测:条件请求
比起每次都把文件整段下下来比对,HTTP 本身提供了一个更便宜的办法:
import datetime as dt, email.utils, subprocess
def conditional_probe(url):
"""同一 URL,两个不同的 If-Modified-Since 值,看对端认不认。"""
_, h = head(url)
lm = h["last-modified"]
t = email.utils.parsedate_to_datetime(lm)
one_sec_before = email.utils.format_datetime(
t – dt.timedelta(seconds=1), usegmt=True)
def code(ims):
out = subprocess.run(["curl", "-sI", "-m", "30", "-H",
f"If-Modified-Since: {ims}", url],
capture_output=True, text=True).stdout
st = [l.split()[:2] for l in out.splitlines() if l.startswith("HTTP/")]
return st[–1][1] if st else "000"
return {"ims_equal_last_modified": code(lm),
"ims_one_sec_before": code(one_sec_before)}
实测两个源都通过了:
202608_data.json IMS = Last-Modified → 304 | IMS = Last-Modified − 1s → 200
1.2M.csv IMS = Last-Modified → 304 | IMS = Last-Modified − 1s → 200
把 Last-Modified 原样回传就得到 304,减一秒就得到 200。 这说明这两个源都正确实现了条件请求,而且 Last-Modified 确实是内容版本的可靠代理。
于是轮询可以这样写:每次只发一个 HEAD 带 If-Modified-Since,拿到 304 就什么都不用下载;只有 200 的那天才去取正文。 对差饷署那 5 张表,一次有效检查的流量是 0 字节。
这段代码建议收藏——它是「只想知道变没变」时最省的一条路,比下全文再比哈希便宜三个数量级。
9. 踩坑清单与结论
| 取第一个 HTTP 状态行 | 走代理时首行是 200 Connection Established,真实状态码被盖住 | 取最后一个 HTTP/ 开头的行 |
| 拿「响应正常」当「内容没变」 | 200 只说明这台机器还活着,不说明内容 | 比 Last-Modified 或内容哈希 |
| 以为月频数据不会变 | 差饷署最近 3 个月带 P,会改口 | 用带 P 的月份做预测前先标「临时」 |
| 以为发布日固定 | 实测落在月末后 5–13 天,还有一次 13 天 | 从第 5 天开始每个工作日探 |
| 拿覆盖写表做历史对账 | 5 张表同一秒发布,单表改动无从区分 | 用一月一文件的源留档 |
| 假定所有官方站都支持条件请求 | 本次两个源支持,但这是要逐个实测的 | 先跑一次 304/200 双探测 |
三条:
这套探测方式不挑数据源:换任何一批政府公开文件,probe() 加条件请求双探测跑一遍,半小时就能把它的发布契约摸清楚——如果这篇对你有用,收藏 + 点赞,下次接新的官方数据源时可以直接套。
香港公开数据的实测会继续更新,关注不迷路。
10. 参考链接
原创声明:本文为原创技术实践。全部数字来自 2026-09-15 对两个官方数据源的真实探测(土地注册处 32 个月报文件、差饷署 5 张表,两次快照间隔 2 分 02 秒)。Last-Modified 由站点自报,理论上可被重写,本文的一致性依据是「32 个时间戳互不相同、32 个哈希互不相同、且都精确落在各自月末后 5–13 天」这一组互相印证的事实。差饷署 P 标记的含义以官方数据字典为准,临时值的修订幅度本文未做验证。接口字段与发布节奏可能随官方调整而变化,请以自测数据为准。