长对话用久了,最先变麻烦的往往不是模型“记不住”,而是应用每一轮都要把越来越长的历史带回去。做长文档分析、持续运行 Agent,或者反复修改一份方案时,业务代码还得自己维护摘要、拼接上下文,再小心保留不能丢的最近几轮。
Anthropic 这次把一部分工作交给了 Messages API:开发者可以在自己选定的时机请求压缩,让服务端生成一段带签名的上下文摘要,后续请求直接从这段摘要继续。它看起来像新增了一个参数,实际改变的是长任务的上下文管理方式。
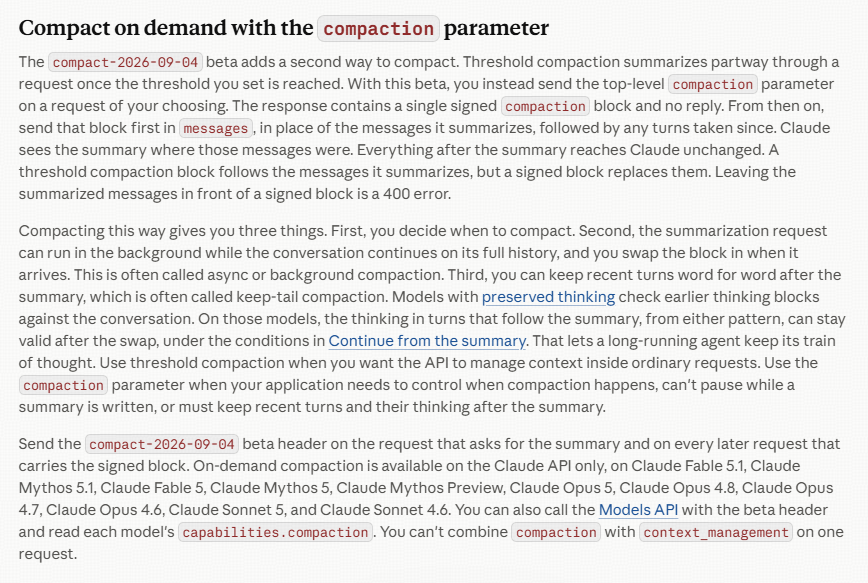 图1|官方文档说明按需压缩的工作方式、后台运行和 beta header。来源:Anthropic Compaction 文档。
这次更新具体增加了什么
此前的阈值压缩,是请求运行到设定的输入 token 阈值后,由 API 在处理中自动触发。新的按需方式则把决定权交给应用:你可以在任务的某个节点单独发起压缩请求,不必等到下一次普通请求碰到阈值。
请求里使用顶层的 compaction 参数,服务端返回一个 compaction block。这个 block 不是普通文本,它带有签名,后续请求需要把它原样放回消息历史。压缩请求本身不会生成普通回复,返回状态是 stop_reason: "compaction"。
这也是它和普通摘要函数的区别:摘要不是停在业务代码里的字符串,而是 API 认可的上下文块。服务端知道它替代了哪些旧消息,后续请求可以从压缩后的状态继续。
一次按需压缩请求怎样流转
官方示例把流程拆得很清楚。应用先把当前对话发给 Messages API,并加入:
"compaction": {"type": "summarize"}
同时带上 compact-2026-09-04 beta header。响应会返回一个 compaction 内容块,其中包括摘要内容和 signature,并以 compaction 作为停止原因。
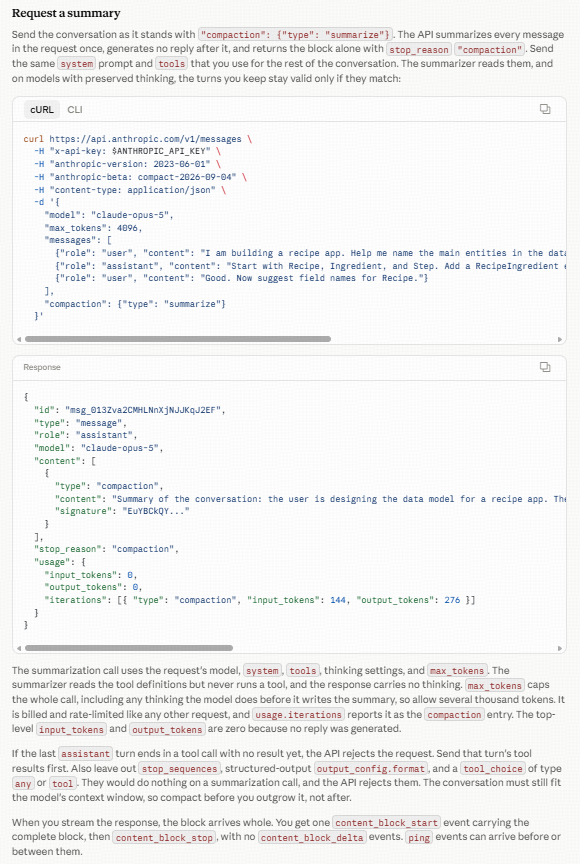 图2|官方示例展示请求参数、签名压缩块、stop_reason 和 usage.iterations。来源:Anthropic Compaction 文档。
下一次请求时,应用要把这个 block 放进 messages 的最前面,再接上压缩之后保留的近期消息。已经被摘要覆盖的旧消息要移除;如果旧消息还放在签名 block 前面,API 会返回 400 错误。
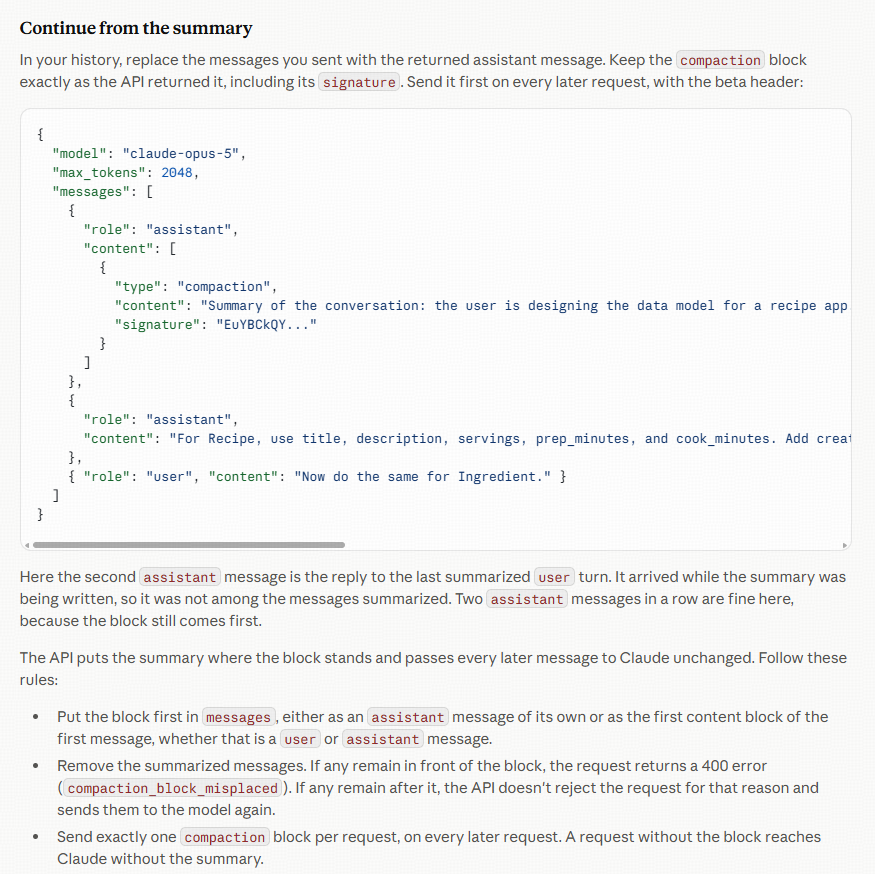 图3|后续请求把签名压缩块放在 messages 最前面,并继续携带摘要之后的消息。来源:Anthropic Compaction 文档。
这个顺序不能省。应用可以保留原始历史,等后台摘要返回后再完成替换,也可以直接在本地删掉已经被概括的消息。无论采用哪种方式,发回 API 的压缩块都要保持原样,不能重新拼一段文字代替它。
为什么长任务会直接受益
长文档问答是最直观的场景。用户可能先让模型梳理全文,再追问某一章,接着要求根据新条件改写。如果每次都把完整历史带上,请求体会越来越大;如果完全由业务代码做摘要,又要维护一套“哪些信息必须留下”的规则。
持续运行的 Agent 也会遇到同样的问题。工具调用、阶段性结果和用户追加的要求不断累积,应用很难预先知道什么时候该压缩。按需压缩允许后台生成摘要,主流程继续推进,摘要回来后再把历史切换过去。对于必须保留最近几轮原话的任务,还可以把这些轮次放在摘要之后,使用 keep-tail 的方式继续工作。
压缩以后,Token 和缓存怎样看
这里最容易产生误解:上下文变短,不等于这一次请求没有成本。官方文档明确说明,压缩本身会计费,也会占用速率额度。响应里的 usage.iterations 会把压缩迭代和普通消息迭代分开列出,计算总消耗时要把这些记录合在一起;只看顶层 input_tokens 和 output_tokens,会漏掉压缩这一步。
缓存也会跟着上下文结构变化。官方支持在 compaction block 上设置 cache_control,并建议给 system prompt 单独设置缓存断点。这样发生压缩时,系统提示仍可从缓存读取,需要重新写入的主要是新的摘要内容。
所以,压缩真正值不值得用,要看一项完整长任务的输入、输出、缓存写入、缓存读取和费用,而不是只看“历史被压短了”。这也是我会把这项更新放进 Token 与缓存测评的原因。
接入时真正要改的地方
接入按需压缩,至少要检查四件事:请求是否带上对应 beta header,压缩 block 是否原样保存,后续请求是否把它放在消息最前面,以及旧消息是否按规则移除。还要处理摘要没有生成、工具调用打断摘要、上下文已经超过窗口,以及服务暂时不可用等情况。
如果任务需要保留 thinking,还要按照官方条件检查保留轮次是否紧跟摘要、system 和 tools 是否发生变化。压缩不是把历史简单截短,接入方需要把消息替换、错误处理和成本记录一起改好。
上下文压缩只是第一步
Anthropic 这次更新的价值,在于 API 开始直接承担长会话的上下文整理。开发者少维护一套手工摘要逻辑,长任务也多了一种可以后台执行、保留近期轮次的管理方式。
但真正接入之后,还要回答一个更实际的问题:压缩让一次完整任务少花了多少,缓存有没有继续命中,压缩本身又增加了多少消耗?这不能靠参数说明直接得出,需要把同一模型、同一任务的 Token 和费用记录放在一起看。
 图4|多维度测评入口同时展示模型一致性、Token 消耗量(缓存)和稳定性测评,适合在接入新能力后继续观察 API 服务表现。来源:OkenAI 页面截图。
这类新能力接入后,先把官方请求格式接对,再用完整任务记录观察实际消耗,才知道它对自己的 API 工作流到底带来了什么变化。