训练监控脚手架横评:TensorBoard vs Prometheus + Grafana 运维级监控
在深度学习模型训练中,如果缺乏实时、立体的可观测性(Observability)监控体系,算法工程师往往只能面对“训练跑了一夜,第二天早晨才发现凌晨发生 NaN 崩溃”或者“8 卡分布式训练中有一张卡掉电挂起导致整个集群死锁等待 12 小时”的悲剧。
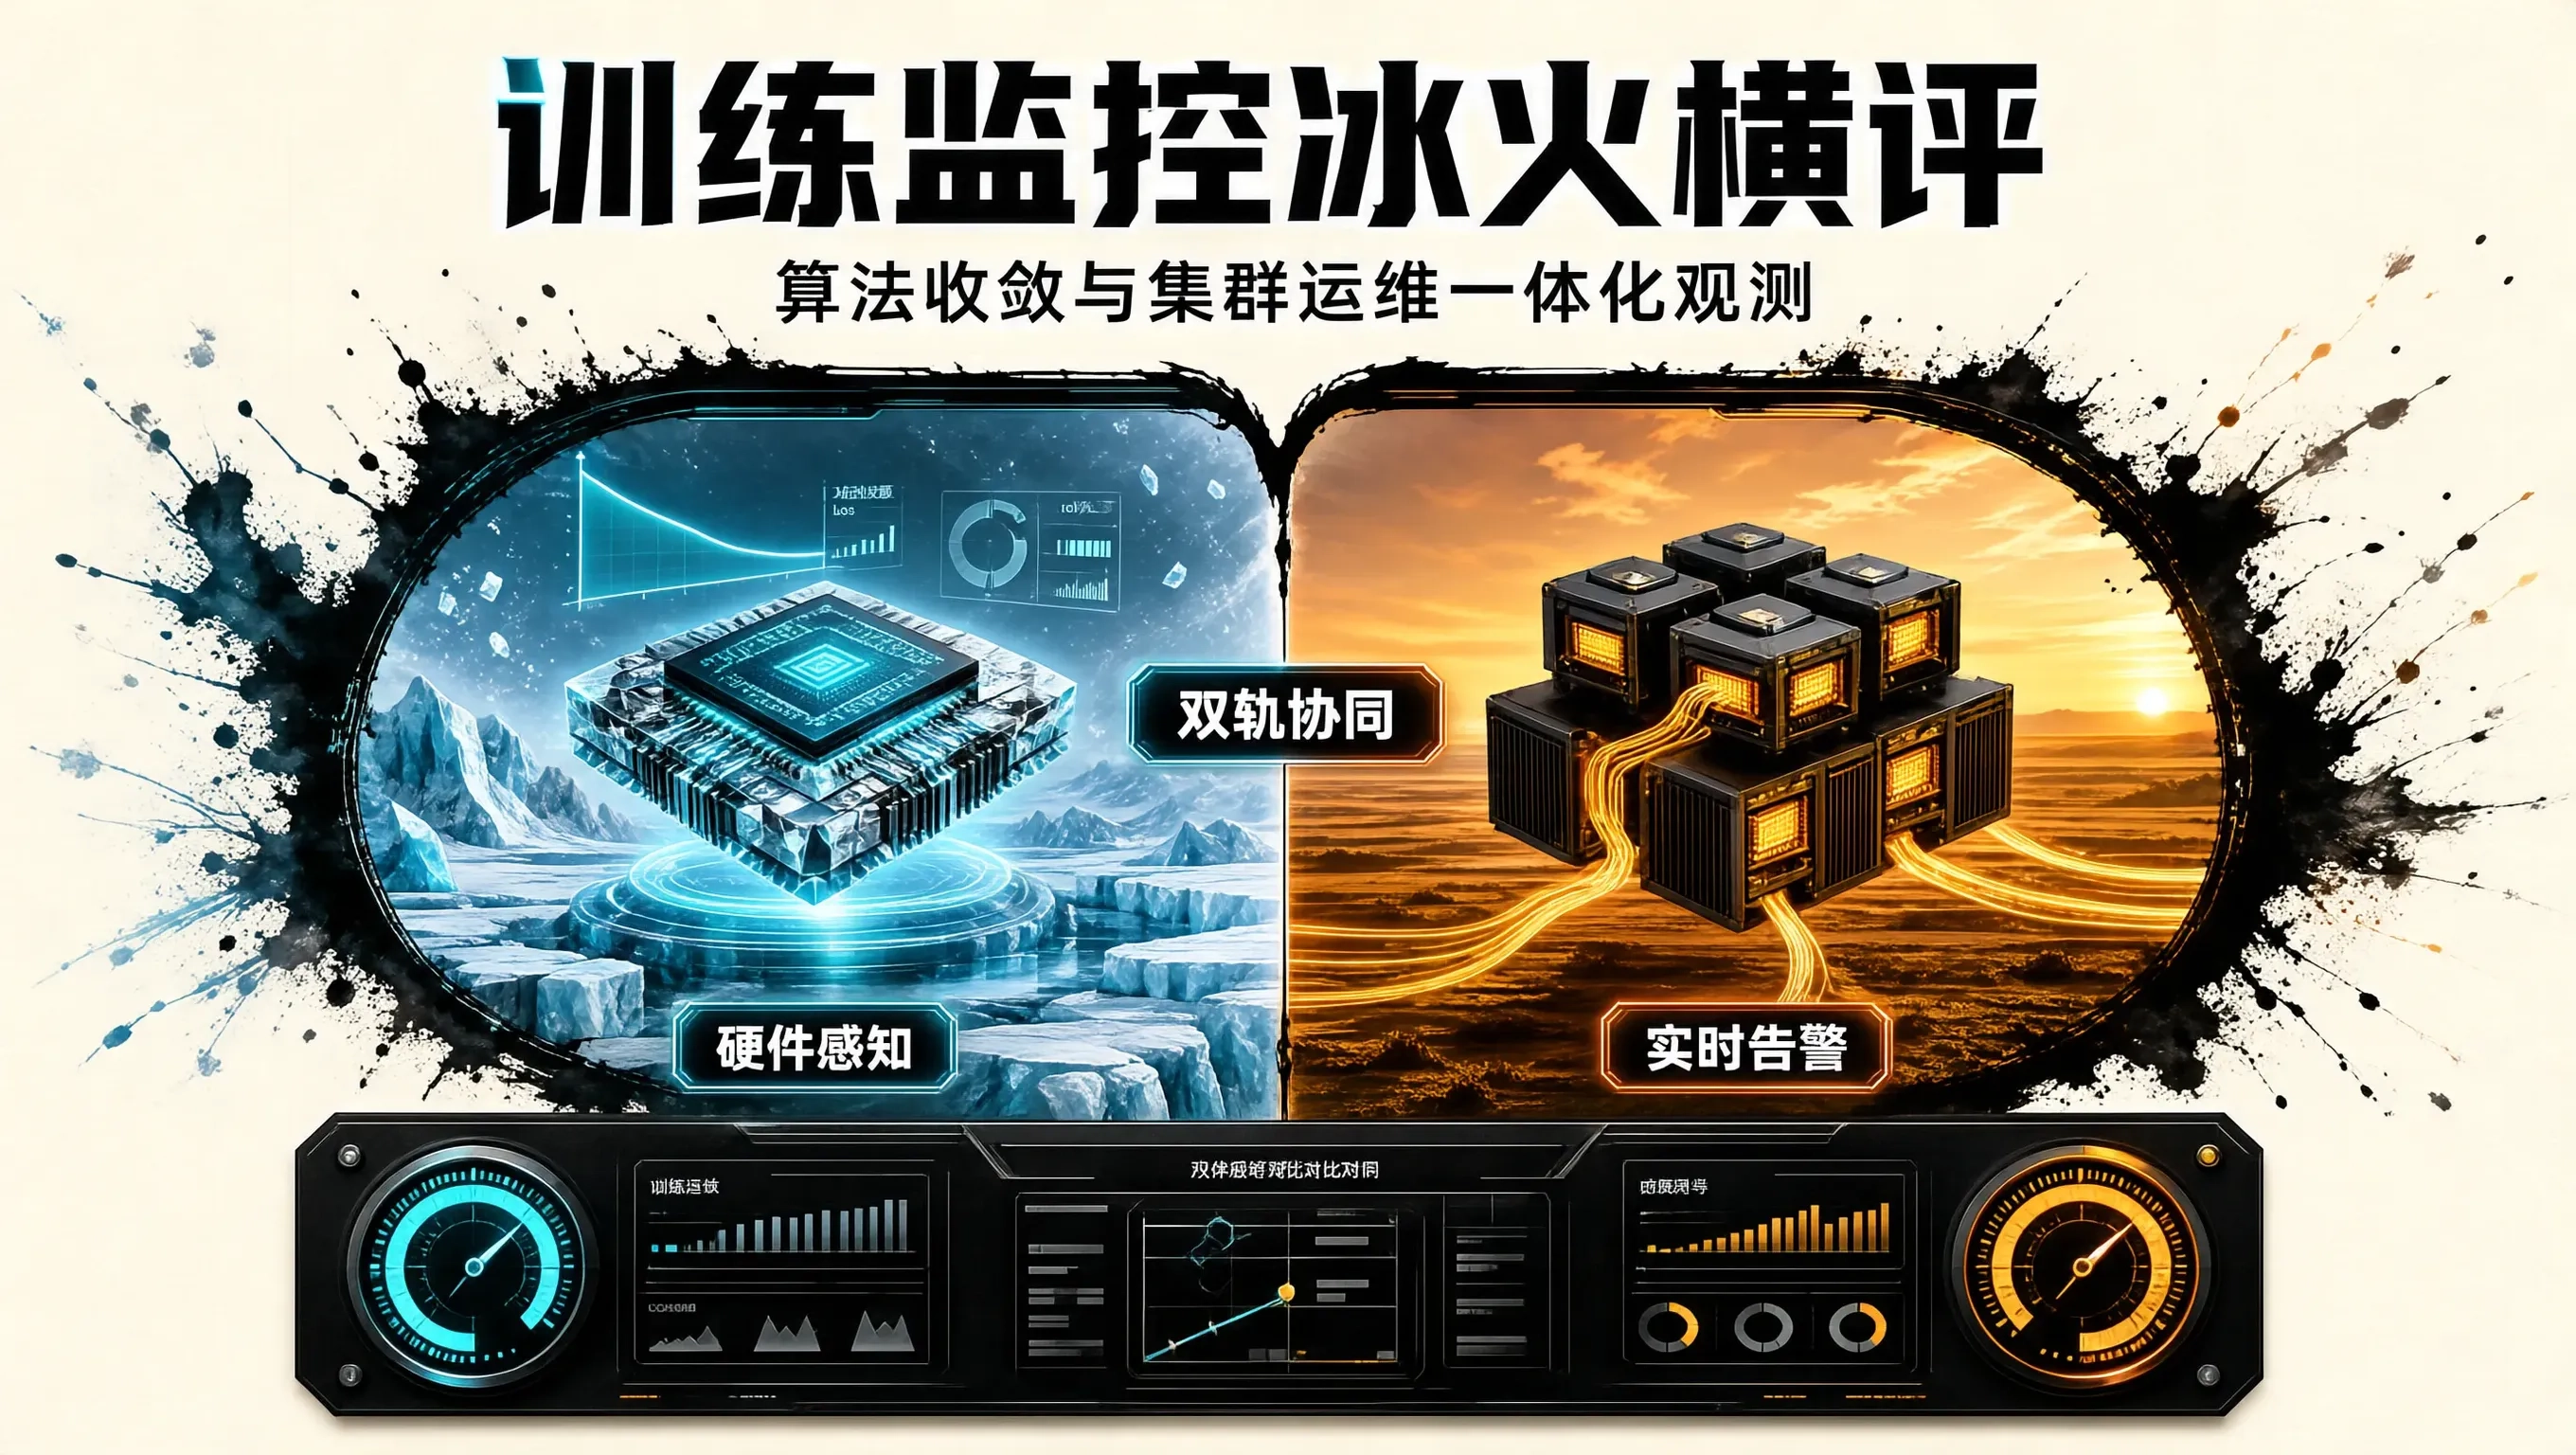
在监控选型上,团队通常会接触到两类工具:专注于算法指标与收敛轨迹的 TensorBoard,以及专注于集群算力、硬件健康与网络拓扑的 Prometheus + Grafana + NVIDIA DCGM。
这两类方案在监控粒度、数据采集开销和适用场景上有何本质区别?如何搭建互补的一体化监控体系?
1. 两大监控范式的定位差异
-
算法级应用监控(TensorBoard / WandB):
- 关注核心:Loss 曲线、学习率退火、评估指标(F1/BLEU)、梯度范数(Grad Norm)、权重直方图、文本生成示例;
- 数据协议:在 Python 训练循环中显式调用 SummaryWriter.add_scalar(),将事件写入本地事件文件(events.out.tfevents);
- 局限性:无法感知底层硬件异常(如 GPU 温度过高降频 Thermal Throttling、NVLink 传输丢包、ECC 内存单比特错误、Host 内存泄漏)。
-
系统级基础设施监控(Prometheus + Grafana + NVIDIA DCGM):
- 关注核心:SM 算力利用率(GPU-Util)、显存带宽占用(Memory Bandwidth)、PCIe/NVLink 吞吐速率、GPU 温度与实时功耗(Power Draw)、NVIDIA XID 硬件故障事件;
- 数据协议:通过在每个物理节点部署 dcgm-exporter 与 node-exporter,后台 DaemonSet 每隔 1~5 秒独立轮询 GPU 驱动,Prometheus 集中拉取并存储于时序数据库中;
- 局限性:无法获知当前运行的具体模型名字或特定 Batch 的 Loss 数值。
2. 关键能力横向对比矩阵
| 核心数据源 | Python 代码内部显式埋点 | NVIDIA 驱动与内核硬件传感器 |
| 对训练速度的侵入性 | 中等 (高频写入事件会影响 IO) | 零侵入 (独立后台守护进程) |
| 硬件异常捕获 (如 XID 报错) | 完全无法感知 | 毫秒级捕获并触发短信/飞书告警 |
| 网络与 NVLink 丢包监控 | 不支持 | 原生支持每卡 NVLink 吞吐细分看板 |
| 多节点超大规模集群汇聚 | 文件分散,跨机聚合体验差 | 天生支持万卡集群集中式时序聚合 |
| 模型梯度与特征可视化 | 极强 (支持直方图与投影) | 不支持 (仅限纯时序数值) |
3. 运维级 DCGM + Prometheus 核心告警规则配置
在企业级集群中,配置以下 Prometheus Alertmanager 告警规则,能够在硬件隐患爆发前自动隔离坏节点:
groups:
– name: gpu_cluster_alerts
rules:
# 1. 监控 GPU 算力闲置告警 (排查分布式死锁与数据加载阻塞)
– alert: GPUSMLowUtilization
expr: avg_over_time(DCGM_FI_DEV_GPU_UTIL[10m]) < 15
for: 15m
labels:
severity: warning
annotations:
summary: "节点 {{ $labels.instance }} GPU 利用率持续低于 15%,疑似训练死锁或 IO 卡顿!"
# 2. 监控 GPU 驱动层 XID 严重硬件故障
– alert: GPUXIDCriticalError
expr: increase(DCGM_FI_DEV_XID_ERRORS[1m]) > 0
labels:
severity: critical
annotations:
summary: "节点 {{ $labels.instance }} 检测到 NVIDIA XID 硬件级故障 (代码 {{ $value }})!"
# 3. 监控 GPU 温度过高降频风险
– alert: GPUTemperatureHigh
expr: DCGM_FI_DEV_GPU_TEMP > 82
for: 2m
labels:
severity: warning
annotations:
summary: "节点 {{ $labels.instance }} GPU 温度超过 82°C,可能触发硬件过热降频!"
4. 最佳实践:双轨协同的一体化观测体系
在成熟的 AI 实验室与工程团队中,推荐采用双轨互补架构: