模型能力决定Agent的天花板,上下文工程才是决定真实业务落地表现的地板。
1 上下文决定能力上限
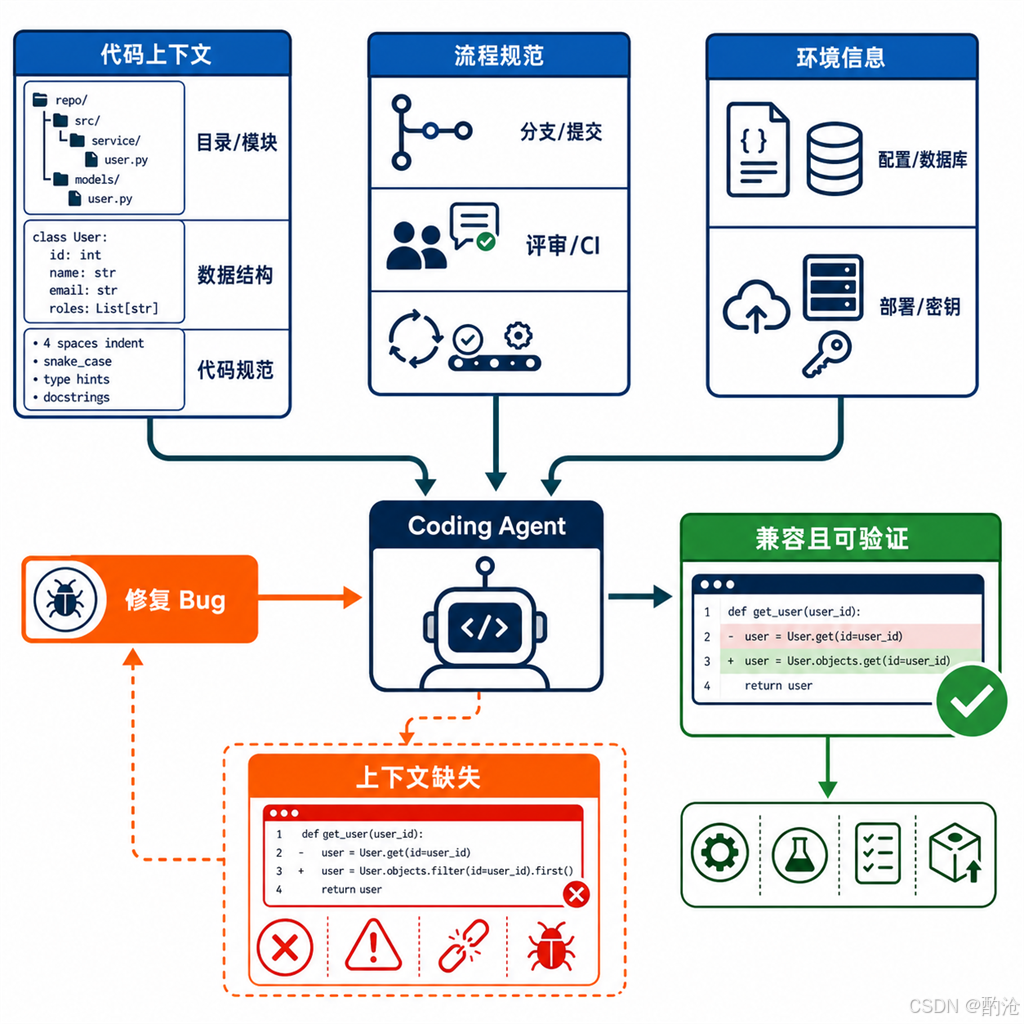
发布的大语言模型在基准测试中表现亮眼,进入具体业务场景后往往效果下滑。模型具备通用能力,执行具体任务需要依赖特定背景:产品架构、业务规则与内部约定。以 Coding Agent 处理帮我修复这个 bug为例,它依赖三类核心上下文信息:
- 实时代码上下文:代码库目录结构、模块职责划分、核心数据结构定义、代码规范。缺少这些,生成的代码极易与项目架构冲突。
- 流程规范:Git 分支策略、代码提交规范、代码审查流程、CI/CD 管线要求。缺少这些,Agent 可能直接向主分支提交未测试代码。
- 环境信息:开发环境配置、测试数据库连接地址、部署方式、API 密钥管理方式。缺少这些,本地通过的代码在测试环境会立即崩溃。
代码、流程与环境构成了 Agent 工作的最低信息需求。上下文工程负责系统性地设计、组织和提供完成任务所需的全部背景知识,第一步是将散落在老员工记忆与口头约定中的隐性知识显性化。
2 API消息结构无状态
上下文由四部分组成:静态前缀(系统提示词、工具定义)与动态增长区(对话历史、状态栏)。
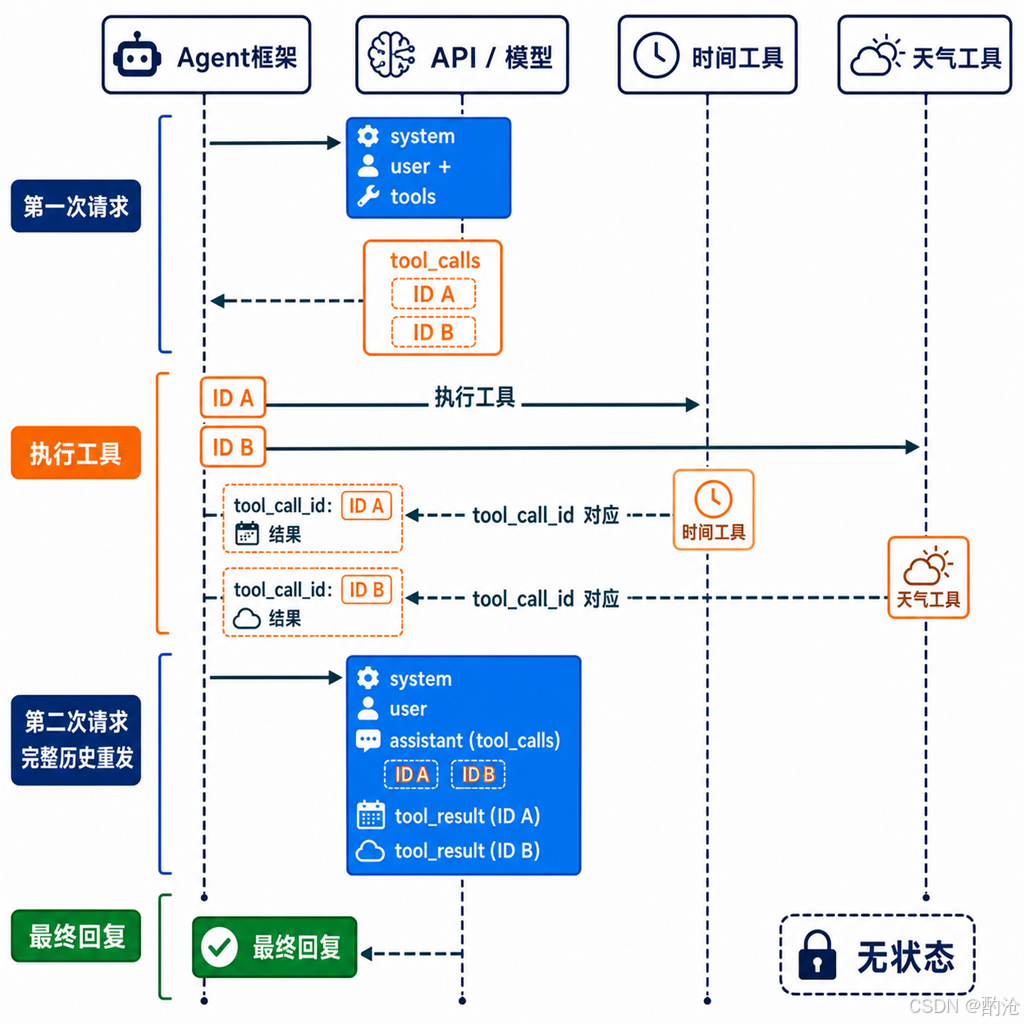
在 API 层面,上下文以消息列表的形式存在。以查询杭州时间和天气的任务为例:
第一次 API 调用,模型决定调用两个工具:
// ═══ Request sent to the API ═══
{
\”model\”: \”Qwen3-0.6B\”,
\”messages\”: [
{
\”role\”: \”system\”,
\”content\”: \”You are a helpful assistant. Use the provided tools…\”
},
{
\”role\”: \”user\”,
\”content\”: \”What\’s the current time and weather in Hangzhou?\”
}
],
\”tools\”: [ … ]
}
模型返回工具调用请求:
// ═══ Response returned by the API ═══
{
\”choices\”: [{
\”message\”: {
\”role\”: \”assistant\”,
\”content\”: null,
\”tool_calls\”: [
{
\”id\”: \”call_abc123\”, \”function\”: {
\”name\”: \”get_current_time\”, \”arguments\”: \”{\\\”timezone\\\”: \\\”Asia/Shanghai\\\”}\” } }</