数据库性能优化,网上文章多是「20 条 SQL 优化方案」「8 种实战方法」,看完还是不知道眼前这个故障该从哪下手。
因为真实的故障不是「按方法清单挑一条」,而是「先认出这是哪一类问题」。这篇我按一线最常见的五大场景,每个场景给你一条**「现象 → 证据 → 根因 → 处理 → 验证」**的排查链路,附可直接复制的诊断命令,最后再给你一张速查表。查故障的时候,对着用就行。
使用说明:先花 30 秒看懂这张表
排查任何数据库性能问题,先做两件事:
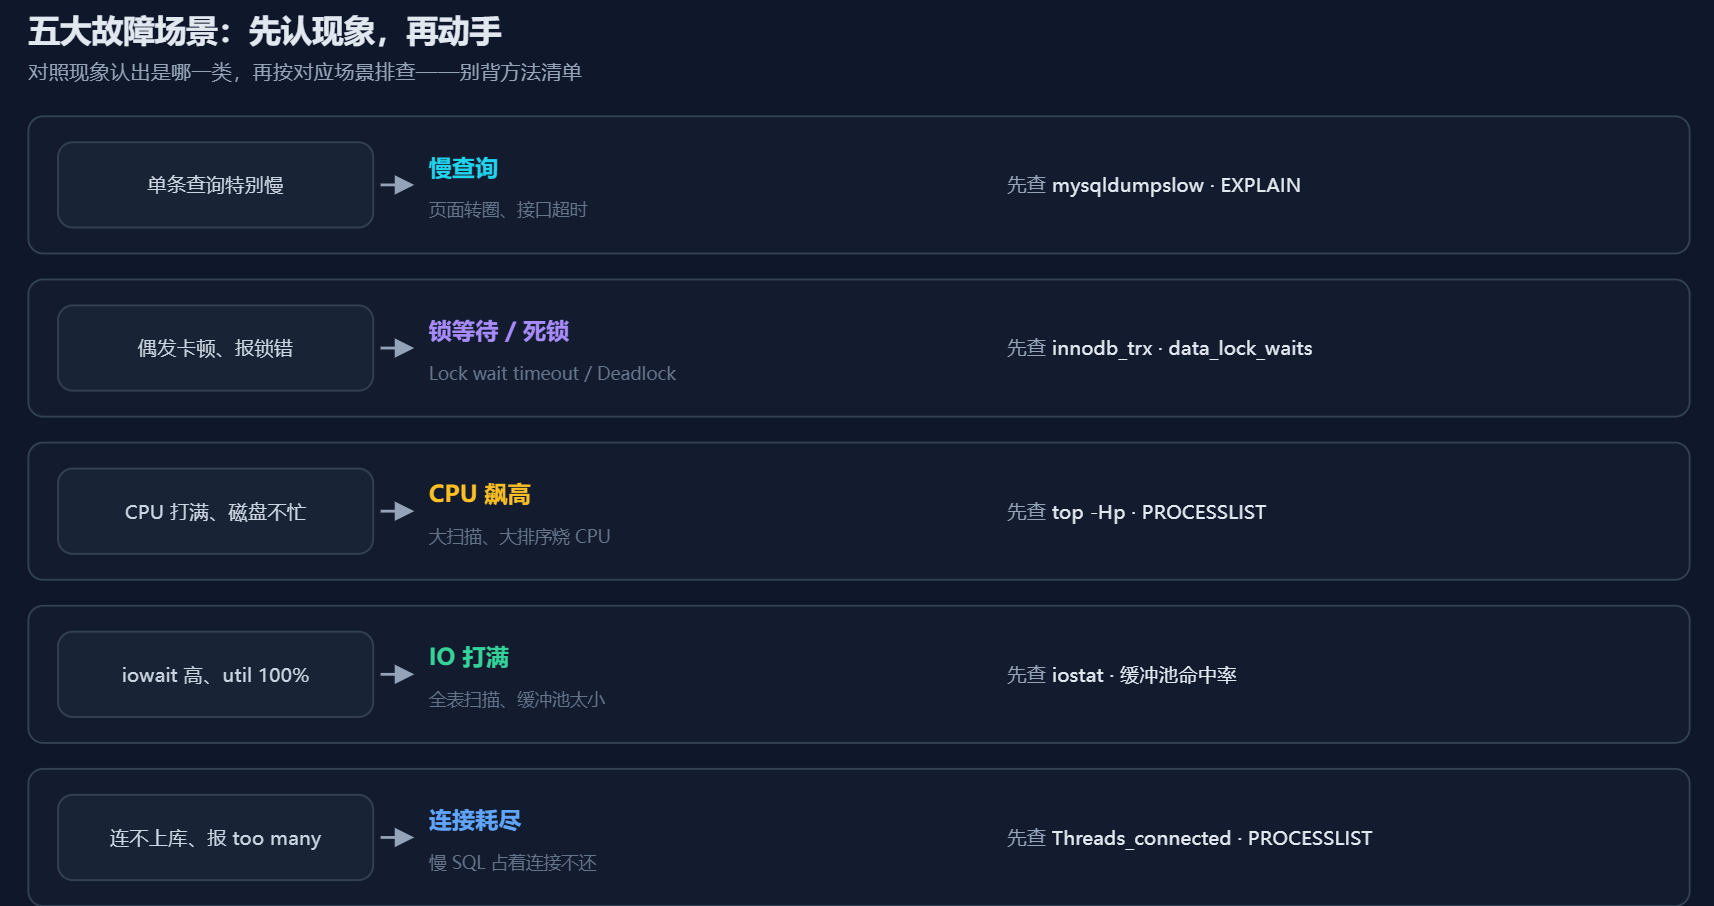
| 单条查询特别慢、页面转圈 | 场景一:慢查询 |
| 偶发卡顿、事务报锁等待/死锁 | 场景二:锁等待 |
| CPU 使用率持续飙高 | 场景三:CPU 飙高 |
| 磁盘 IO 打满、iowait 高 | 场景四:IO 打满 |
| 报「too many connections」、连不上库 | 场景五:连接耗尽 |
下面命令以 MySQL 为例,金仓数据库 KingbaseES 这类国产库思路一致,换个对应命令就行——金仓数据库高度兼容MySQL,EXPLAIN ANALYZE、锁视图、统计信息都能直接上手,信创项目里不用重学一套。
场景一:慢查询(慢 SQL)
现象:单个接口/页面慢,其他都正常,偶发或持续。
证据:
— 慢查询日志是否开启、阈值多少
SHOW VARIABLES LIKE 'slow_query_log%';
SHOW VARIABLES LIKE 'long_query_time';
— 谁正在跑、跑了多久
SHOW FULL PROCESSLIST;
# 把慢日志按耗时排序,挑最狠的下手
mysqldumpslow -s t -t 10 /var/log/mysql/slow.log
根因:绝大多数是 SQL 写得不好(全表扫描、索引失效、大偏移分页、SELECT *),剩下的是参数和资源问题。
处理:用 EXPLAIN 看执行计划,重点盯 type=ALL(全表扫描)、Using filesort、Using temporary;改 SQL 或加对索引。
验证:优化前后各跑一次 EXPLAIN,对比 rows 和实际耗时。
场景二:锁等待 / 死锁
现象:数据库整体不慢,但偶发卡顿;日志里出现 Lock wait timeout exceeded 或 Deadlock found。
证据:
— 当前事务和锁等待(MySQL 8.0)
SELECT * FROM information_schema.innodb_trx;
SELECT * FROM performance_schema.data_lock_waits;
— 最近一次死锁记录
SHOW ENGINE INNODB STATUS\\G
根因:长事务不提交、事务内加锁顺序不一致、大事务把行锁升级成范围锁。
处理:缩短事务(把不相关操作移出事务)、统一加锁顺序、能重试的重试;定位到持锁的事务,该杀就杀(KILL 前先确认)。
验证:观察锁等待数量归零,业务压测下不再报死锁。
场景三:CPU 使用率飙高
现象:top 看到 CPU 打满,但磁盘不忙、网络正常。
证据:
top -Hp $(pgrep -f mysqld) # 看哪个线程在烧 CPU
SHOW FULL PROCESSLIST; — 配合看是哪条 SQL
根因:大量全表扫描、排序/分组、在 SQL 里做大量计算,或并发突然升高。
处理:找到烧 CPU 的那条 SQL,用场景一的方法优化;别急着改参数——先证明是哪条 SQL 在烧。
验证:优化后 CPU 占用曲线回落,尖峰消失。
场景四:磁盘 IO 打满
现象:iostat 看到磁盘 util% 接近 100%,iowait 高,CPU 反而不高。
证据:
iostat -x 1 5
SHOW STATUS LIKE 'Innodb_buffer_pool_read%';
根因:缓冲池太小(命中率低,频繁读盘)、全表扫描导致的随机读、冷热数据没分层。
处理:先看是不是 SQL 全表扫描在刷盘,再评估缓冲池大小;冷数据归档、热数据留在内存。
验证:缓冲池命中率上升、磁盘 util% 回落、查询延迟下降。
场景五:连接数耗尽
现象:应用报 Too many connections,新连接连不上,已有的还正常。
证据:
SHOW VARIABLES LIKE 'max_connections';
SHOW STATUS LIKE 'Threads_connected';
SHOW FULL PROCESSLIST; — 看一堆 Sleep 还是慢 SQL 占着连接
根因:慢 SQL 把连接长时间占住、应用连接池没配上限或空闲回收、连接泄漏。
处理:优先治慢 SQL(治本),再调连接池(上限、空闲超时、最大等待),必要时才调 max_connections(治标,且要配套资源)。
验证:连接数曲线回落,Threads_connected 不再触顶。
五大场景速查表(收藏这张就够)
| 慢查询 | 单条查询慢 | 慢日志、执行计划 | mysqldumpslow、EXPLAIN |
| 锁等待/死锁 | 偶发卡顿、报锁错 | 当前事务、锁等待 | innodb_trx、data_lock_waits、SHOW ENGINE INNODB STATUS |
| CPU 飙高 | CPU 打满、磁盘不忙 | 烧 CPU 的线程/SQL | top -Hp、SHOW FULL PROCESSLIST |
| IO 打满 | iowait 高、util 100% | 缓冲池命中率、全表扫描 | iostat、Innodb_buffer_pool_read% |
| 连接耗尽 | 连不上库、报 too many | 连接数、持连接者 | max_connections、Threads_connected、SHOW FULL PROCESSLIST |
常见问题(FAQ)
数据库性能优化的方法有哪些?
从投入产出比排序:改 SQL > 加/改索引 > 调参数 > 动架构。先定位瓶颈是哪一类,再对症下药,不要上来就加机器。
如何定位并优化慢查询?
开慢查询日志 → mysqldumpslow 按耗时排序 → 挑最狠的 EXPLAIN 看执行计划 → 盯 type=ALL 和 rows → 改 SQL 或加索引 → 前后对比验证。
数据库 CPU 使用率过高如何排查?
top -Hp 找到烧 CPU 的线程,配合 SHOW FULL PROCESSLIST 定位到具体 SQL,再用 EXPLAIN 分析它为什么费 CPU(通常是大扫描、大排序)。别急着改参数。
高并发下如何减少锁冲突?
缩短事务(把无关操作移出事务)、统一加锁顺序、避免长事务、能重试的重试、必要时缩小锁粒度。
数据库什么时候需要分区或分库分表?
单表数据量大到索引和扫描都扛不住、写入吞吐超过单机上限时。分区解决「单表过大」,分库分表解决「单库扛不住」,但要先想清楚跨分片查询和分布式事务的代价。
数据库性能优化,别背方法清单,先认场景。认对了场景,一半的问题就已经定位了。 希望这份手册躺在你的收藏夹里,但最好一次都用不上。
我是DBA小马哥,十年一线数据库运维。写的东西都是生产环境里趟出来的,关注我,少踩坑。