Embodied‑BenchForge:面向具身智能评测基准构建的闭环智能体工作流
原文网页:https://arxiv.org/html/2609.13082v1
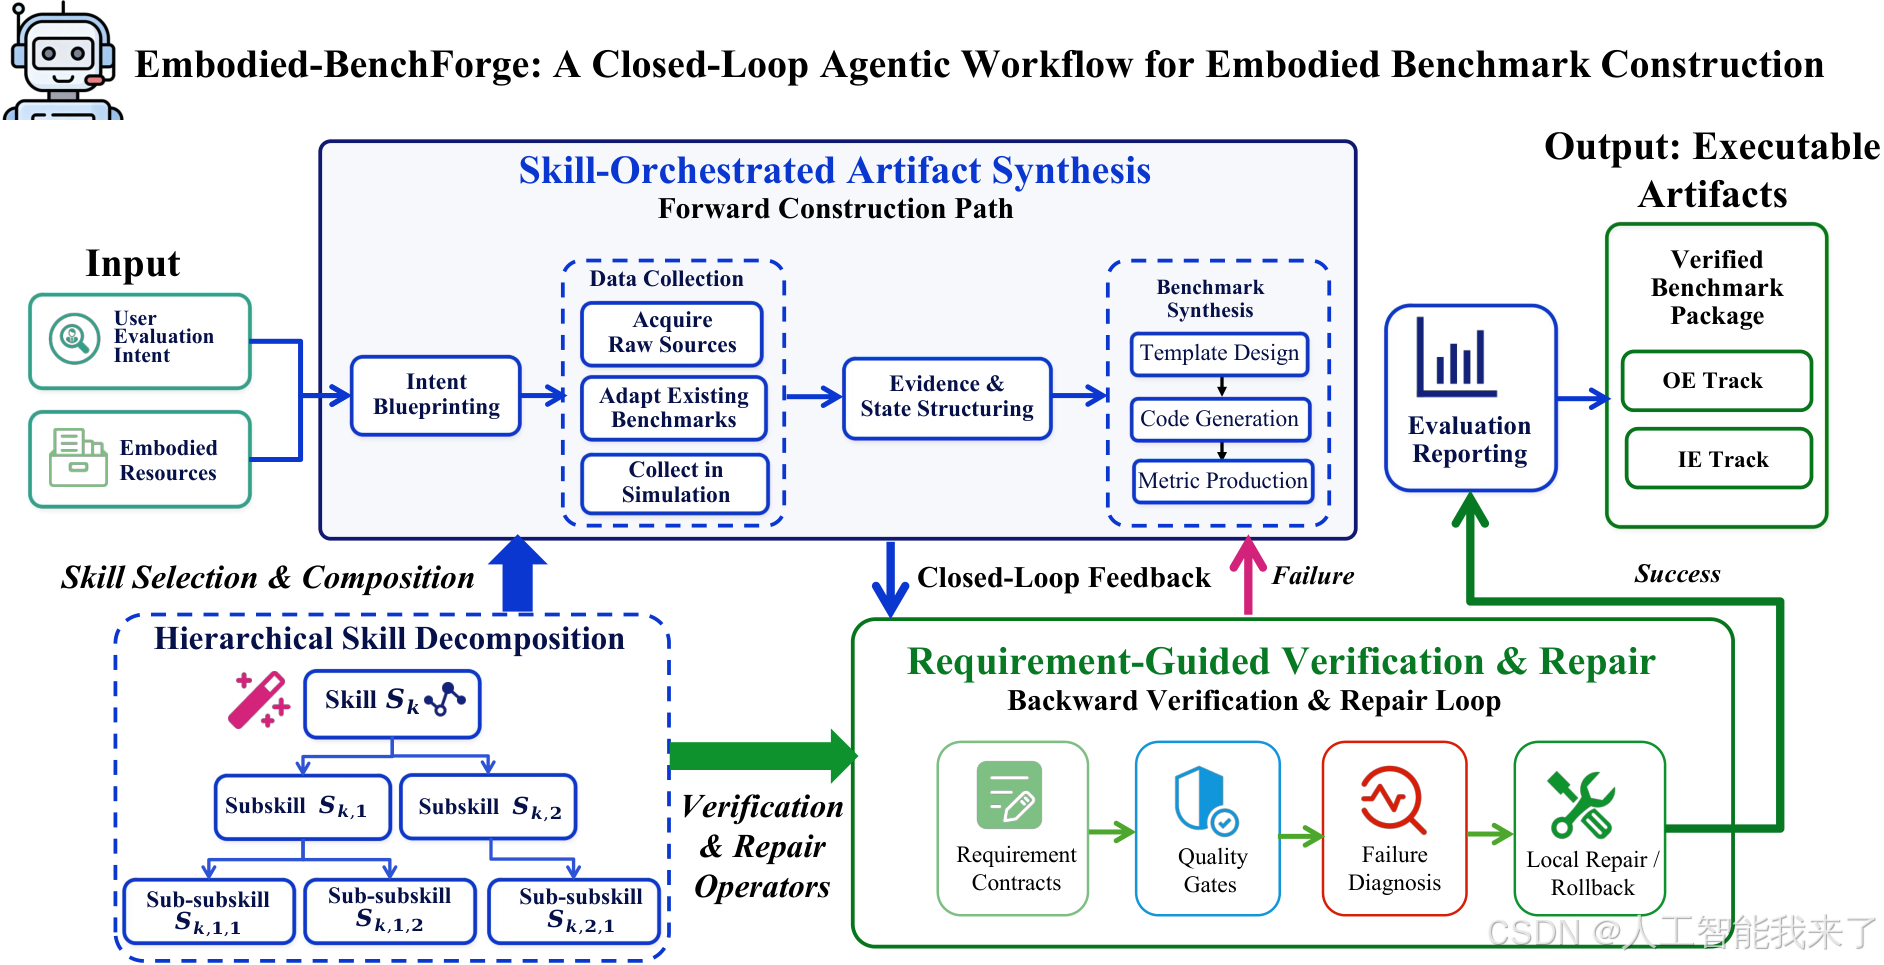
摘要 智能体系统为自动化构建具身评测基准提供了可行路径,但现有方案大多只能覆盖局部流程,且高度依赖预定义环境与任务集合。更关键的是,多步骤构建流程会产生存在依赖关系的中间制品;中间缺陷会不经校验直接向下游传递,污染最终基准。本文提出Embodied‑BenchForge,一套智能体框架,可以将用户指定的评测意图,完整转化为可执行的具身评测基准制品。本文将基准构建形式化为闭环基准合成(Closed‑Loop Benchmark Synthesis),融合正向制品合成与反向校验修复两大流程。
- 技能编排式制品合成:将类型化、可复用的技能组合成可执行工作流,同时维护制品依赖图,记录中间输出与相互依赖;
- 需求引导的校验与修复:为每一类制品绑定专属需求契约;校验失败时,依托溯源信息触发局部重执行或者上游回滚。
Embodied‑BenchForge产出两套评测赛道:离线问答赛道OE‑Track包含6套异构具身基准;交互式具身赛道IE‑Track包含220个完整可执行任务。对主流多模态大模型、具身智能体开展评测,证明该基准可以有效区分观测理解能力与闭环交互执行能力。质量评估、多组消融实验验证了基准质量以及校验‑修复模块的有效性;技能复用与修复案例分析证明框架具备局部恢复、跨基准复用能力。
关键词 具身AI;评测基准自动化构建;智能体工作流;闭环校验修复;技能编排
目录
- 2.1 具身基准与任务生成
- 2.2 自动化基准构建与校验
- 3.1 总览
- 3.2 技能编排式制品合成
- 3.3 需求引导的校验与修复
- 5.1 实验设置
- 5.2 评估指标
- 5.3 效率指标
- 5.4 构建质量与构建效率
- 5.4.1 制品质量
- 5.4.2 构建效率
- 5.5 基准评测效用
- 5.5.1 离线问答OE性能
- 5.5.2 交互式具身任务性能
- 5.6 构建机制消融实验
- 5.6.1 技能复用分析
- 5.6.2 系统级消融
- 5.6.3 流程质量控制消融
- 5.6.4 跨赛道能力诊断
- A.1 定义与共享闭环协议
- A.1.1 制品专属需求契约
- A.1.2 赛道专属质量关卡
- A.1.3 溯源引导修复协议
- A.2 离线问答赛道:校验与修复案例
- A.3 交互式具身赛道:执行与校验
1 引言
多模态大模型、视觉‑语言‑动作模型推动具身智能从单纯感知,拓展到空间推理、任务规划、闭环交互。对应的具身评测基准覆盖问答、导航、家庭机器人操作等场景。可靠评测是定位模型能力边界的关键,但基准构建工作高度依赖人工。
现有自动化基准构建方案存在两大核心痛点:
核心方案:闭环基准合成 Closed‑Loop Benchmark Synthesis。将正向的制品合成流程,和反向的校验、定位、局部修复结合。
- 正向:技能编排式制品合成,把构建操作封装为类型化可复用技能,依据评测意图组合成可执行工作流;维护制品依赖图,记录全部中间输出与依赖关系。
- 反向:需求引导的校验修复,为每类制品绑定结构、语义、执行类需求契约;校验失败时依托溯源信息,执行局部修复/上游回滚,仅重建受影响下游制品,保留其余已经校验通过的制品。
本文产出两套评测赛道:
评测11套开源/闭源模型,实验证明:该基准可以有效区分模型的观测理解能力和闭环执行完成任务能力。
本文贡献
| AutoBencher | ✅ | ‑ | ‑ | ‑ | △ |
| BenchAgents | ✅ | △ | △ | ‑ | △ |
| Code2Bench | ✅ | △ | ‑ | ✅ | △ |
| RoboGen | △ | △ | ‑ | ✅ | △ |
| A2Eval | △ | △ | △ | △ | ‑ |
| Embodied‑BenchForge | ✅ | ✅ | ✅ | ✅ | ✅ |
✅完整支持;△部分支持;‑不支持。△代表仅有校验,不支持选择性局部重建。
2 相关工作
2.1 具身基准与任务生成
经典具身基准:ALFRED、LIBERO、EmbodiedScan、EmbodiedBench、OpenEQA,覆盖场景理解、导航、机器人操作。这些基准质量高,但构建绑定特定模拟器、资源与schema。 自动化生成方向:ProcTHOR、RoboCasa生成场景;MimicGen生成机器人演示;Eureka/RoboGen用大模型生成任务与奖励函数。这类方案局限于固定模拟器内部,无法从用户高层评测意图出发,端到端产出完整基准包。
2.2 自动化基准构建与校验
Dynabench、BenchBuilder、AutoBencher依靠人机交互、声明式需求生成NLP评测数据;BenchAgents分阶段智能体工作流;BenchBench引入心理测量学IRT分析;Code2Bench面向软件任务做依赖与覆盖率校验。 具身领域A2Eval是从已有基准做子集筛选,不生成全新可执行任务。 具身基准构建额外要求:观测、环境状态、证据、可行动作、目标、可执行验证器之间保持严格一致性。Embodied‑BenchForge通过可复用构建技能、制品专属需求契约、溯源引导修复解决该问题。