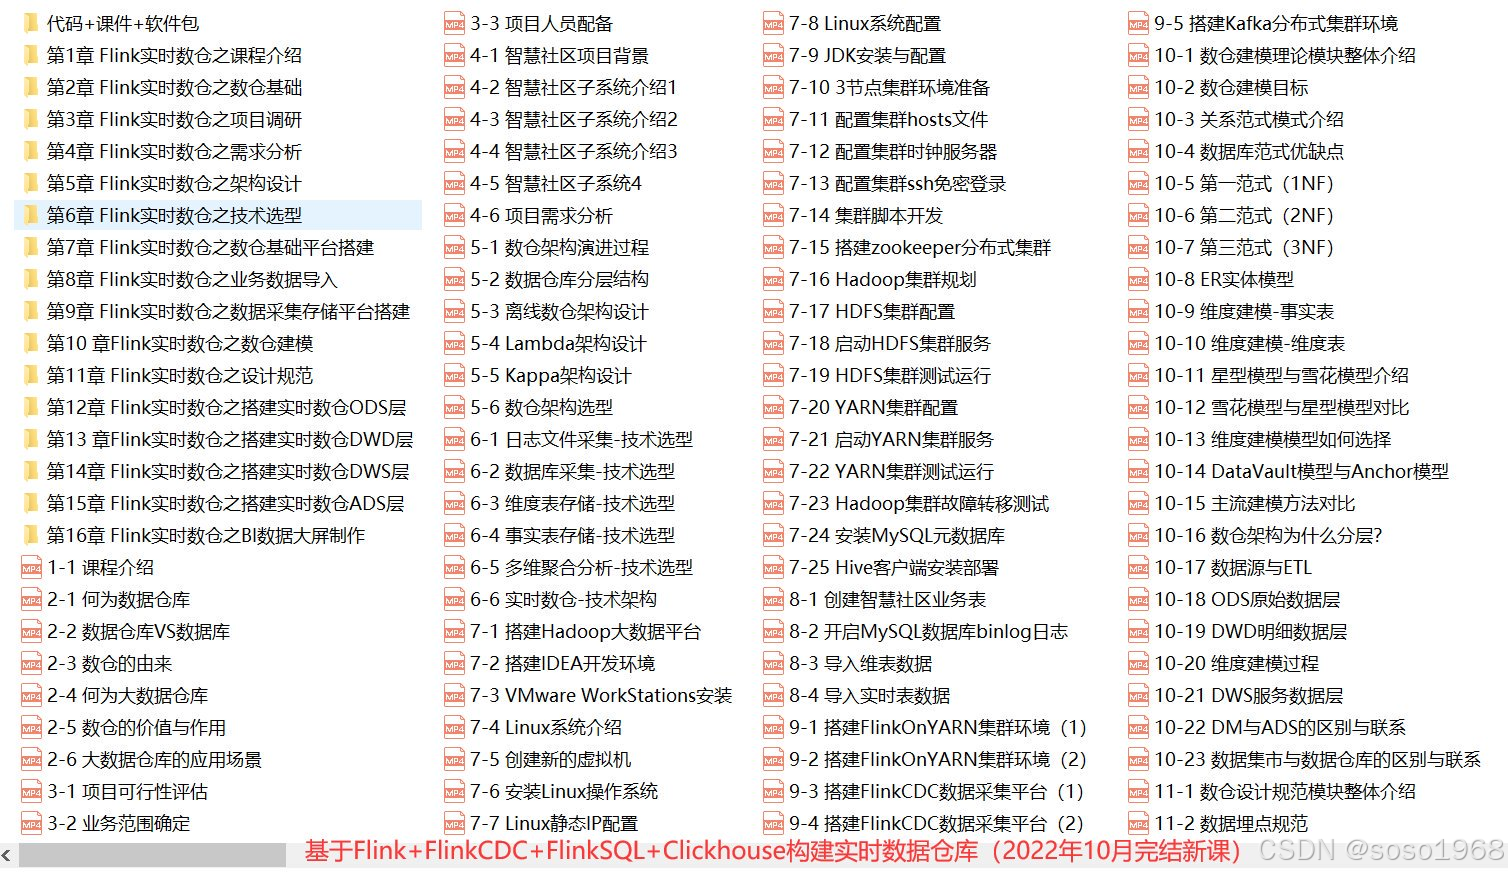
 文件链接: https://pan.baidu.com/s/1DGfYvCSmYSf60wo83-tMCg?pwd=1688 提取码: 1688
实时数仓的进阶知识,往往集中在组件语义差异和端到端一致性上。博文给出了 Flink + FlinkCDC + FlinkSQL + ClickHouse 的完整链路,但生产落地时仍需在以下几个方面做深度打磨 。
一、FlinkCDC:从 Demo 到生产的跳坑要点
FlinkCDC 的全量加增量同步机制并非开箱即用。配置 scan.incremental.snapshot.enabled=true 后,任务会分批读取全量数据,并在结束后自动切换 binlog。实战中经常遇到的坑位包括:
- server-id 必须唯一,且不能与 MySQL 从库冲突。多个 CDC 任务共用一个 server-id,会导致 binlog dump 连接被抢占,同步中断。
- 源库 binlog_row_image 必须设置为 FULL,否则更新前镜像缺失,Flink 在做 upsert 或需要旧值参与计算时会出错。
- 全量快照阶段如果表数据量极大,建议调大 scan.incremental.snapshot.chunk.size,但也要注意避免 chunk 过大导致锁表时间延长。
示例配置:
CREATE TABLE product (
id INT PRIMARY KEY NOT ENFORCED,
name STRING,
price DECIMAL(10,2)
) WITH (
'connector' = 'mysql-cdc',
'hostname' = '…',
'port' = '3306',
'username' = '…',
'password' = '…',
'database-name' = 'shop',
'table-name' = 'product',
'server-id' = '5401-5405',
'scan.incremental.snapshot.chunk.size' = '4096'
);
二、FlinkSQL:状态、时间与维表关联的隐性成本
FlinkSQL 虽然降低了开发门槛,但底层的状态管理和时间语义却容易被忽略。
状态 TTL 是双刃剑。对于双流 Join,TTL 过短会导致迟到数据无法关联,产生漏数;TTL 过长则占用大量堆外内存,甚至导致 Checkpoint 超时。建议按业务事件时间的最大乱序程度设置 table.exec.state.ttl。
时间语义的坑位更隐蔽。如果源表使用 TIMESTAMP 而不是 TIMESTAMP_LTZ,在 Flink 与 ClickHouse 时区不一致时,聚合结果会出现小时级偏移。统一使用 TIMESTAMP_LTZ,并在提交作业时指定 -Duser.timezone=Asia/Shanghai。
维表关联采用 Lookup Join 时,默认每条记录触发一次外部查询,对 MySQL 压力极大。推荐启用 PARTIAL 缓存并设置合理的 TTL:
CREATE TABLE dim_sku (
sku_id INT PRIMARY KEY,
sku_name STRING
) WITH (
'connector' = 'jdbc',
'url' = '…',
'table-name' = 'dim_sku',
'lookup.cache' = 'PARTIAL',
'lookup.cache.max-rows' = '20000',
'lookup.cache.ttl' = '20min'
);
三、ClickHouse:写入模型与查询建模的取舍
ClickHouse 擅长分析,却并不适合高频小写入。Flink 实时写入很容易触发 too many parts 异常。生产环境应尽量使用攒批写入,并控制每个 batch 的行数或大小。
| 逐条写入 | 实时性最高 | part 数量爆炸 | 不推荐 |
| 批量攒写 | 吞吐高、part 可控 | 延迟略有上升 | 实时大屏、报表 |
| Kafka 中转异步写入 | 削峰填谷、解耦 | 链路更长 | 高吞吐日志分析 |
在实时数仓的 DWS/ADS 层,常常使用 ReplacingMergeTree 实现按主键去重。但 MergeTree 的合并是异步的,不能依赖 FINAL 查询,因为 FINAL 会强制合并,查询性能大幅下降。更优方案是使用 argMax 或 GROUP BY 配合版本字段获取最新记录。
CREATE TABLE ads_order_summary
(
order_id UInt64,
user_id UInt64,
amount Decimal(10,2),
status String,
update_time DateTime,
version UInt32
)
ENGINE = ReplacingMergeTree(version)
PARTITION BY toYYYYMMDD(update_time)
ORDER BY (user_id, order_id);
分区键设计也直接影响查询效率。避免使用粒度太细的时间戳,否则会产生大量小分区;推荐按天分区,并在分区内使用排序键加速范围查询。
四、实时数仓分层与端到端一致性
博文提到参照离线数仓进行 ODS、DWD、DWS、ADS 分层,但实时链路对延迟敏感,分层过多会导致链路雪崩 。建议将 DWD 与 DWS 的计算尽量合并到同一个 Flink 作业中,减少中间落盘和状态重复存储。
端到端 Exactly-Once 是另一处容易被低估的难点。Flink 的 Checkpoint 只能保证流内精确一次,写入 ClickHouse 时通常采用“幂等写入 + 版本字段”实现最终一致。通过 ReplacingMergeTree 的记录版本控制,即使同一 Key 被多次写入,最终查询也能收敛到最新状态。
五、监控与排障优先级
实时数仓上线后,需要建立面向延迟和稳定性的监控指标。重点关注:
- Flink Checkpoint 的失败率与完成时间;
- CDC 消费位点与 MySQL 主从延迟;
- ClickHouse 的 part 数量和写入队列;
- Kafka 消费组 lag。
DDL 变更也是高频故障源。FlinkCDC 对新增字段等 schema evolution 支持有限,建议在源端做兼容性评估,并在 FlinkSQL 中尽量使用 MAP 或 JSON 类型容纳未来可能新增的字段,降低改表对作业的影响。
综上,从课程给出的架构骨架到生产级链路,中间隔着状态管理、写入吞吐、时间语义和一致性保障等大量工程细节 。进阶学习的目标不应局限于单个组件的 API,而是要建立端到端的链路思维,在延迟、成本和准确性之间找到平衡。
参考来源
- 【课程资料】基于Flink+FlinkCDC+FlinkSQL+Clickhouse构建实时数据仓库