文章目录
-
- 前言
- 一、Iris 是谁:3B 的小个子,背回了一张 82.2 分的卷子
-
- 1. 先别管参数,先看它怎么"记笔记"
- 2. 四个考场的成绩单
- 二、最反常的数字:中文考场上,35B 差点把 397B 打平
-
- 1. 0.3 分,一场学费 3600 亿参数的较量
- 2. 瓶颈从"知道得多"变成了"记得住"
- 三、同一个模型,三种活法:全留着、全清空、摘要续命
-
- 1. 对照实验怎么做的
- 2. 小模型反而涨得更多
- 四、数据构造:把"背题"这条路焊死
-
- 1. 实体图和描述性指代
- 2. 两道闸门
- 五、SFT-RL 攀升:把最难的错题回炉成教材
- 六、工程细节:断点续传,省下的都是算力
- 七、复利效应:为什么小个子能追上大个子
- 八、落地与边界:你要部署哪一只
-
- 1. 实用主义者的选择
- 2. 该泼的冷水
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看,
传送门https://blog.csdn.net/qq_74013365
前言
深夜十一点半,你工位上的咖啡已经凉了第三杯。你给一个号称"深度搜索"的智能体扔了个问题:某研究团队的三位核心作者,之前分别在哪些实验室、干过什么方向,后来为什么凑到了一起。这题得跨过四五个网页才能拼出来。
智能体开始表演了:打开第一个链接,标题正文记进脑子;打开第二个,发现线索不对,又记一笔;打开第三个,顺着引用接着跳。二十分钟后,它还在翻第 87 个页面,你屏幕右侧的工具调用记录已经滚出好几屏。
你等得起,它脑子里的显存配额等不起。等它终于停下来,给你的答案里混着三条过时信息——因为最早那条关键证据,早在第十轮就被它自己挤出了有效窗口。
这画面熟不熟悉?就像你非要同时开四十个浏览器标签页查"今晚吃什么",最后每个标签页都觉得自己是主角,而你的胃已经饿过了劲。
遇到这种事,多数人的第一反应是换更大的模型。可更大的模型更贵啊,而且搜索历史要是无限膨胀,大模型照样扛不住。真正该改的,是它记笔记的方式。
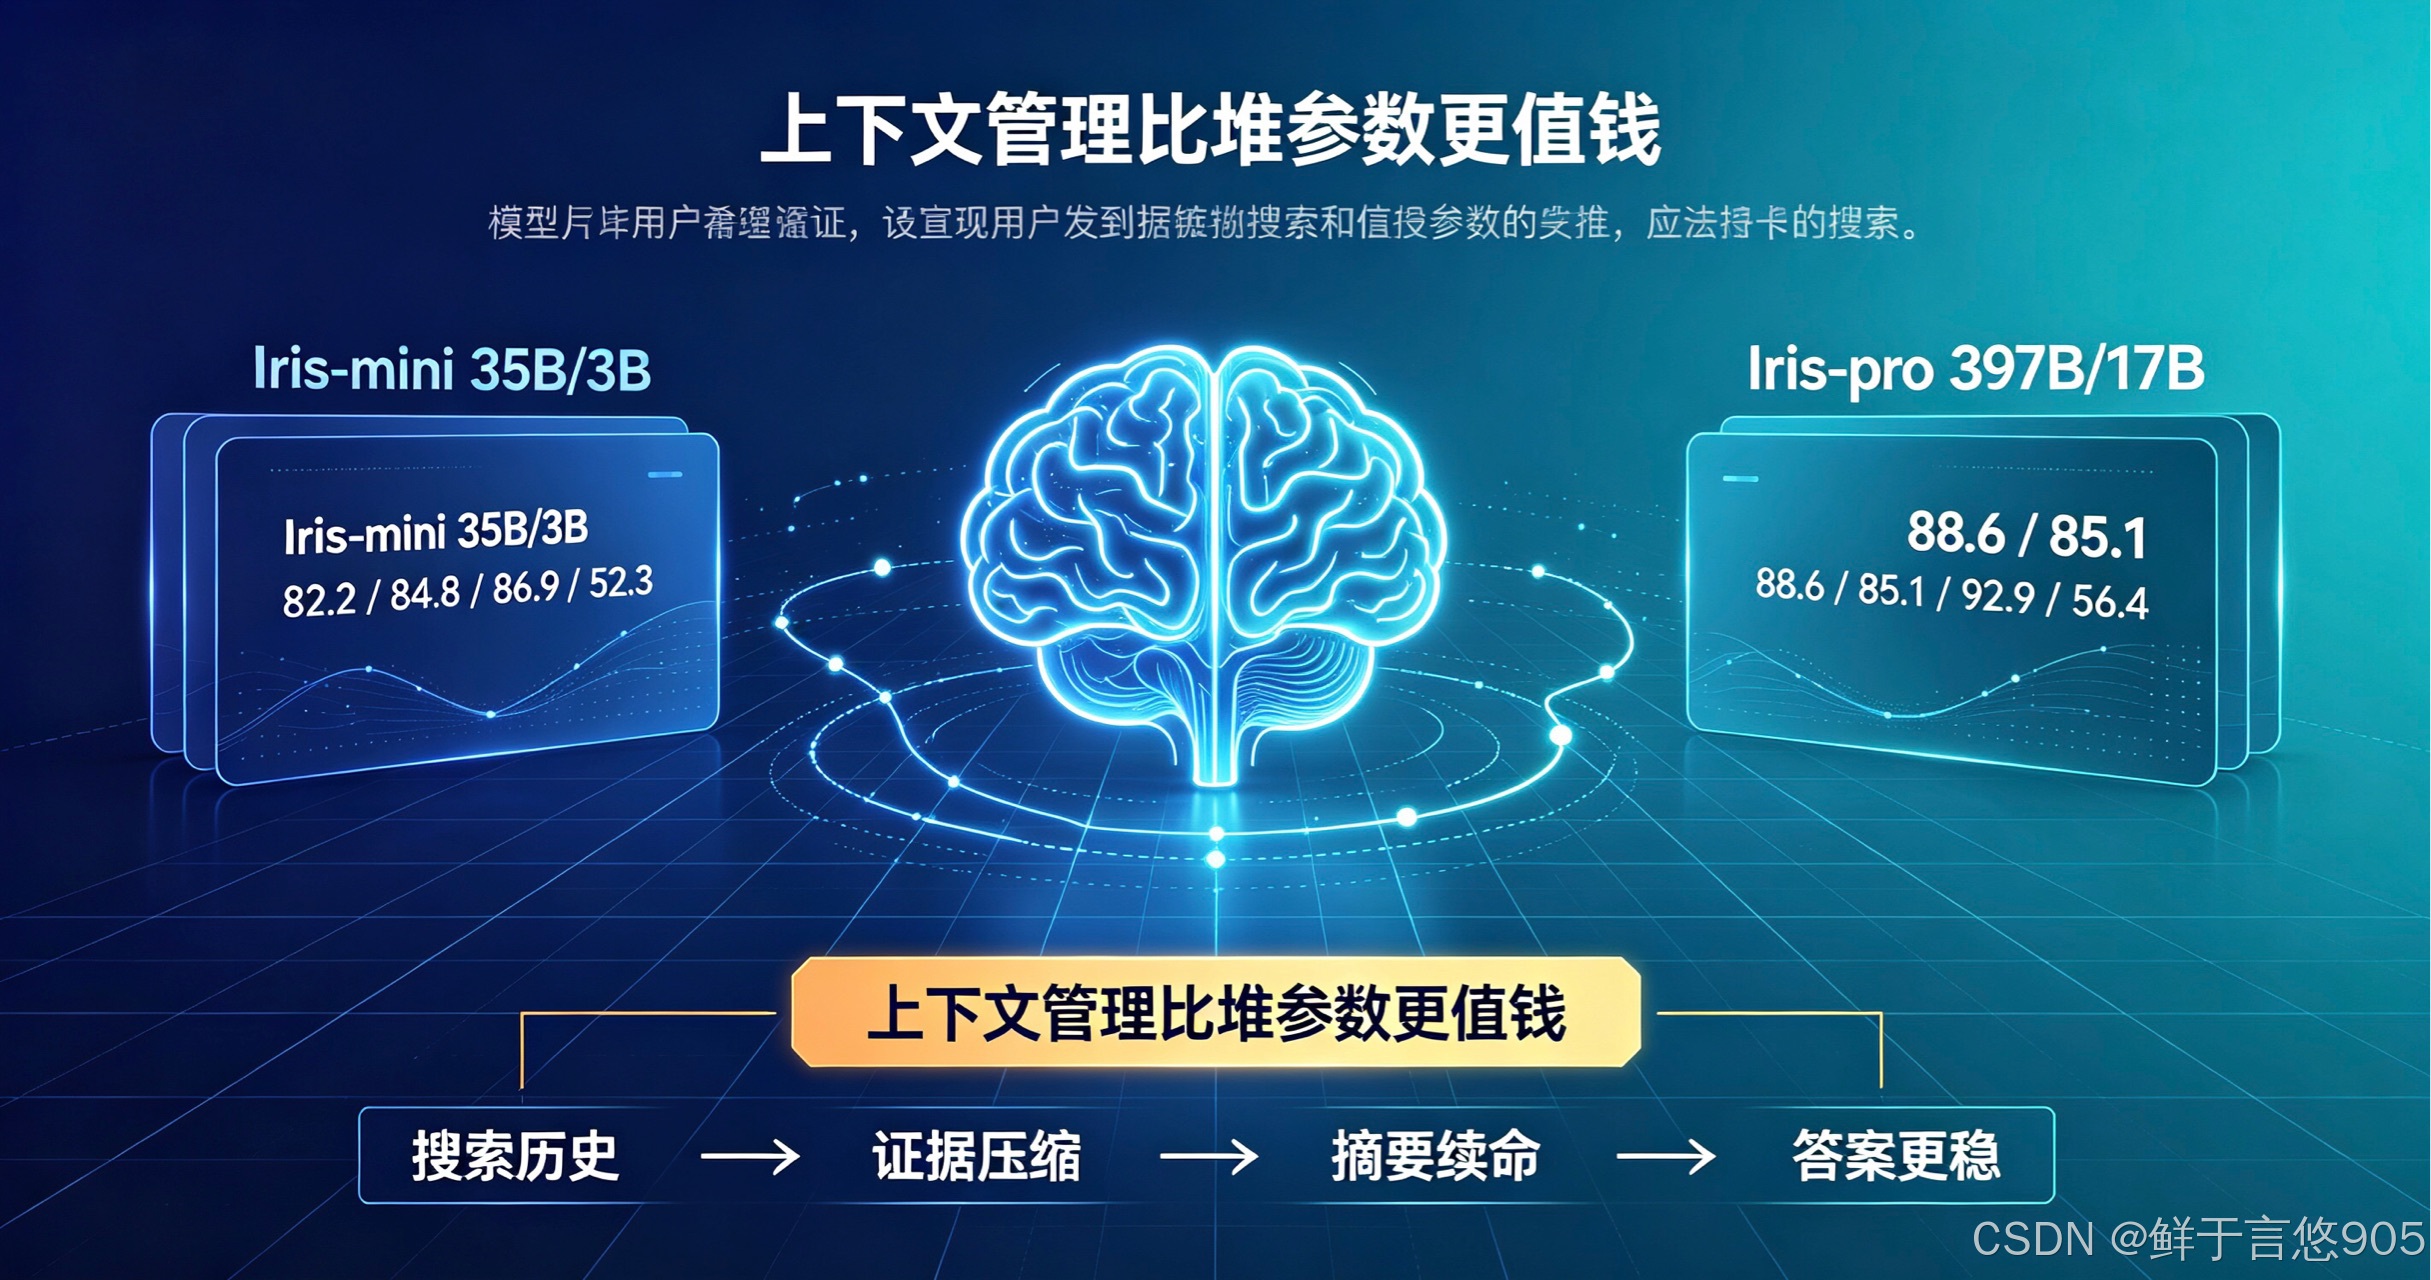
同一个模型,换一套整理搜索历史的策略,成绩波动可能比换个基座模型还大。小红书 AllSpark 团队开源的两个搜索智能体,正好用一组对照实验把这事讲透了:上下文管理,比堆参数更值钱。
一、Iris 是谁:3B 的小个子,背回了一张 82.2 分的卷子
1. 先别管参数,先看它怎么"记笔记"
2026 年,搜索智能体正处在一场转向里:从"框架编排"转向"端到端训练"。过去大家用提示词把搜索工具串起来,模型边调 API 边组织回答,它自己其实不懂怎么搜;现在更多团队直接为搜索行为本身训练模型,把"怎么搜、什么时候该放弃、哪些证据值得留"内化成权重。Iris 是这场转向里,第一个拿到同量级开源标杆成绩的模型组。
9 月 3 日论文挂上 arXiv,几天后 AllSpark Research 把两个搜索智能体的权重放上了 Hugging Face。小的 Iris-mini 从 Qwen3.6-35B-A3B 后训练而来,总参数 350 亿、推理时激活 3B;大的 Iris-pro 基座是 Qwen3.5-397B-A17B,总参数 3970 亿、激活 170 亿。都是混合专家结构,上下文窗口 256K,权重按 Apache 2.0 放出,评测 harness 也一并开源,谁都能原样复现。
3970 亿参数是什么概念?比我这辈子见过的参数加起来都多。但它激活的时候只动 170 亿,像极了开会时只有两个人发言、其余人负责鼓掌的部门例会。
2. 四个考场的成绩单
官方一口气报了四个基准:BrowseComp、BrowseComp-ZH、DeepSearchQA 和 HLE。BrowseComp 是公认最难啃的搜索基准之一,要求模型从整个公开互联网里挖出藏在多轮检索之后的答案;HLE 是前沿数学与科学问题集;DeepSearchQA 按检索能否答对计分。
开上上下文管理之后:Iris-mini 是 82.2、84.8、86.9、52.3;Iris-pro 是 88.6、85.1、92.9、56.4。俩模型都在各自参数档位里拿下了开源搜索智能体的最好成绩。
| BrowseComp | 82.2 | 88.6 | 6.4 |
| BrowseComp-ZH | 84.8 | 85.1 | 0.3 |
| DeepSearchQA(F1) | 86.9 | 92.9 | 6.0 |
| HLE | 52.3 | 56.4 | 4.1 |
二、最反常的数字:中文考场上,35B 差点把 397B 打平
1. 0.3 分,一场学费 3600 亿参数的较量
表格里最不符合直觉的是 BrowseComp-ZH 那一行:350 亿参数的小模型拿 84.8,3970 亿参数的大模型拿 85.1,只差 0.3 分。同一对模型在英文 BrowseComp 上的差距却有 6.4 分。
翻译成大白话:到了中文搜索这个战场,参数规模几乎没换来任何东西。
0.3 分是什么概念?相当于你考试只比学霸少 0.3 分,但人家为了这 0.3 分,多交了 3600 亿参数的学费。对一个习惯"更大就是更强"的行业来说,这个数字本身就是一条新闻。就像办了年卡却只去过一次的健身房——参数办了卡,能力没出勤。
2. 瓶颈从"知道得多"变成了"记得住"
为什么?官方给了一个解释方向:搜索智能体的瓶颈正在从"知道得多"转向"记得住"。英文页面结构规整、实体名密集,能力差距直接体现在知识广度上;中文检索路径更弯,同一条信息得跨过不同的表述习惯才能拼起来。这时候决定胜负的不是参数量,而是谁能在几百轮工具调用里把已经找到的证据组织好、不弄丢、不重复。
这也解释了 Iris 为什么把上下文管理当核心卖点——不是工程师闲着没事做优化,而是它真的卡着模型能力的上限。
三、同一个模型,三种活法:全留着、全清空、摘要续命
1. 对照实验怎么做的
最扎实的一组对照实验,是同一个模型配三种上下文管理策略。什么都不做,让几百轮搜索历史全留在上下文里;discard-all,上下文一超阈值就把积累的工具调用历史全清掉、从原问题重新开始;retry,把已经排除掉的线索先压成摘要、再继续往下走。
简化一下就是这样:
# 三种上下文管理策略的简化示意
def run_agent(question, policy):
history = []
while not converged(history):
step = model(question, history)
history.append(step)
if len(history) > MAX_STEPS:
if policy == "discard_all":
history = [] # 全清空,从原问题重来
elif policy == "retry":
history = [summarize(history)] # 线索压成摘要继续
return answer(history)
2. 小模型反而涨得更多
结论很直白:开了上下文管理,两个模型都涨分,而且 Iris-mini 涨得比 Iris-pro 多。对小模型来说,管住那条越滚越长的搜索历史,比把参数堆上去更有效。
细想也不意外:小模型预算紧张,上下文被无效历史占满时,真正有用的信息很快就排不进去了;大模型靠记忆扛得住,浪费得起。
翻译成人话:富人的钱包经得起乱放几张废票,穷人的钱包里每一格都得精打细算。同一个模型换个上下文策略,成绩波动比你换一个基座模型还大——这就是为什么 Iris 的成绩都按开、关两套口径分别报告,两个数字之间,隔着的就是这套策略的贡献。
四、数据构造:把"背题"这条路焊死
1. 实体图和描述性指代
比跑分更值得看的,是数据怎么造出来的。搜索智能体最怕的不是不会检索,而是靠背答案蒙对:训练数据里出现过的题目,模型记住了,考场上照着抄,分数虚高,一换真实场景就露馅。市面上不少搜索评测就是被这种数据污染拖垮的——考题泄了,分数自然好看。
这就像背了满分作文去高考,结果作文题是"我的父亲",你背的是"我的家乡",当场在考场里表演破防。
Iris 的数据构造,第一步就把这条造假之路堵死。官方从一个种子页面和它的外链里提炼实体图,沿着实体链编写多跳问题,保证答案要跳过好几个页面才能拼出来。关键一步是改写:把所有非答案实体改写成描述性指代。不问"A 公司的创始人 X",而问"那位提出某某方法、曾在某实验室任职的研究者"。
字符串匹配在这种问题下彻底失效。模型没法靠检索关键词碰巧命中答案,必须真的理解语义去搜,才能把问题里的描述和页面里的实体对上。想背题?先背下整张实体关系网。这门槛,比考公还高。
2. 两道闸门
数据还得过两道闸。先保留"闭卷答不出、给了证据能答对"的题目,天然排除那些本来就能背的;然后在轨迹层按正确性、搜索简并度和搜索深度过滤,再在回合层用一套从数据里归纳出来的评分准则过滤,最后才进入监督微调。
这套流程保证喂给模型的是真正需要检索能力的高质量样本,而不是随手可得的网页摘要。换个说法:买菜的人不挑最好看的菜,专挑最难洗的菜。
五、SFT-RL 攀升:把最难的错题回炉成教材
Iris 的训练是一个交替循环,官方给了个形象的名字:SFT-RL 攀升。监督微调和真实搜索环境里的强化学习轮流进行,每一轮 RL 里最难解决、且解决得最高效的回放,会被回喂给下一轮监督训练——相当于把最值钱的错题整理进下一版教材,模型在一个更接近现实的搜索环境里反复迭代,越攀越高。
这套循环对小模型尤其重要。Iris-mini 只有 35B 总参数、激活 3B,天生缺大模型的记忆广度,靠的就是这种"错了就回炉"的训练方式,把搜索轨迹里的关键动作逐步内化成自己的行为习惯。官方数据里小模型涨分幅度大于大模型,训练方法的功劳不亚于模型本身。
换句话说:别人还在同一个坑里摔第三遍的时候,它已经把错题集背得比教材还熟。Iris-mini 的成绩不是白捡的,是用更聪明的数据流换来的。
六、工程细节:断点续传,省下的都是算力
还有两个容易被忽略的工程决定。一是奖励评判器和观察摘要器直接跑在训练集群里,省掉了跨集群通信的开销;二是过长的 RL 回放会在请求级别被中断,下一步从"已提交的前缀"恢复。
搜索智能体的轨迹动辄几百轮工具调用,没有断点续传机制,一次中断就要从头再算。这感觉就像你打单机游戏打到最终 Boss 前,突然发现存档没了——前面几百轮全白打,血压当场拉满。这两个决定看起来是工程细节,恰恰是让 SFT-RL 攀升能真正跑起来的前提。
七、复利效应:为什么小个子能追上大个子
还有一个值得展开的细节:Iris 的上下文管理不是一次性生效的开关,而是贯穿整个检索过程的行为约束。每一次工具调用结束后,模型都要决定这段历史是原样保留、压缩成摘要,还是干脆丢弃。这个决定每轮都在做,几百轮下来,累积出的差距远比单轮看起来大。
好的策略让每一轮的上下文都保持干净,后面的检索站在更扎实的证据上继续;差的策略让每一轮都在消耗前面攒下的信息,越搜越笨。
这跟我们熬夜复习是一回事:前三天你还能分清"鸦片战争"和"甲午战争",到第四天,你已经分不清"鸦片战争"和"鸦片战争"的区别。你缺的不是脑子,是整理。
这就是"上下文管理比堆参数更值钱"的工程含义。堆参数解决的是单步能力,上下文管理解决的是整条轨迹的效率。对动辄几十上百轮工具调用的搜索任务来说,后者对最终答案质量的影响,往往超过前者的边际提升。小模型之所以能追平大模型,靠的正是把每一轮检索的边界条件都收拾干净。
八、落地与边界:你要部署哪一只
1. 实用主义者的选择
对想自己跑一套深度搜索的开发者来说,Iris-mini 是这次发布里最实际的东西。激活 3B 的搜索智能体,意味着中等规模显卡就能起步,配上那套上下文管理策略,单机就能跑起来,Apache 2.0 的授权也留足了商用空间。
不过上手之前记得先跑官方评测 harness 复现一轮基准,用实测数据确认它在你自己的任务上的表现,而不是只信自报分数。这跟买二手房先找验房师是一个道理——不能只听中介说"这房子风水好、格局妙、前任房主是学霸"。
2. 该泼的冷水
冷水也得泼:所有成绩目前都是团队自报,还没有第三方榜单或独立复测背书;训练流水线代码标注"即将放出";数据与训练配方没有明确时间表;基座依赖 Qwen 系,能力上限有一部分是继承来的。
“即将放出"这四个字,在 AI 圈的分量大概等于"等我瘦下来”。
跑分数字过几个月就会过时,但"上下文管理比堆参数更值钱"这条工程判断,大概会用得比模型本身久。下次再遇到搜索智能体"越搜越笨",你会知道,问题多半不在模型,而在它身后那条没人整理的搜索历史。
就像你家里永远找不到的那把钥匙——不是钥匙丢了,是你从来没给钥匙一个固定位置。
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看,传送门https://blog.csdn.net/qq_74013365