Python 数据管线重试机制设计:Tenacity 库在网络不稳定场景下的指数退避实战
在数据工程(ETL)与大模型 API 批量调用任务中,网络抖动与第三方接口瞬时限流是不可避免的物理现实:
- 抓取第三方开放数据时,对方服务器由于负载过高偶尔返回 HTTP 429(Too Many Requests)或 503(Service Unavailable);
- 跨机房同步数据库时,专线网络产生 1~2 秒的短暂丢包;
- 向向量数据库批量写入向量时,向量库内部正在进行后台索引合并,导致单次写入 RPC 超时。
很多初学者在编写 Python 任务时,重试逻辑通常写得非常粗暴:
# ❌ 错误示范:固定死循环重试,极易引发“重试风暴”压垮下游
for _ in range(3):
try:
call_api()
break
except:
time.sleep(1) # 固定间隔死等
这种机械的重试方式存在两个严重缺陷:
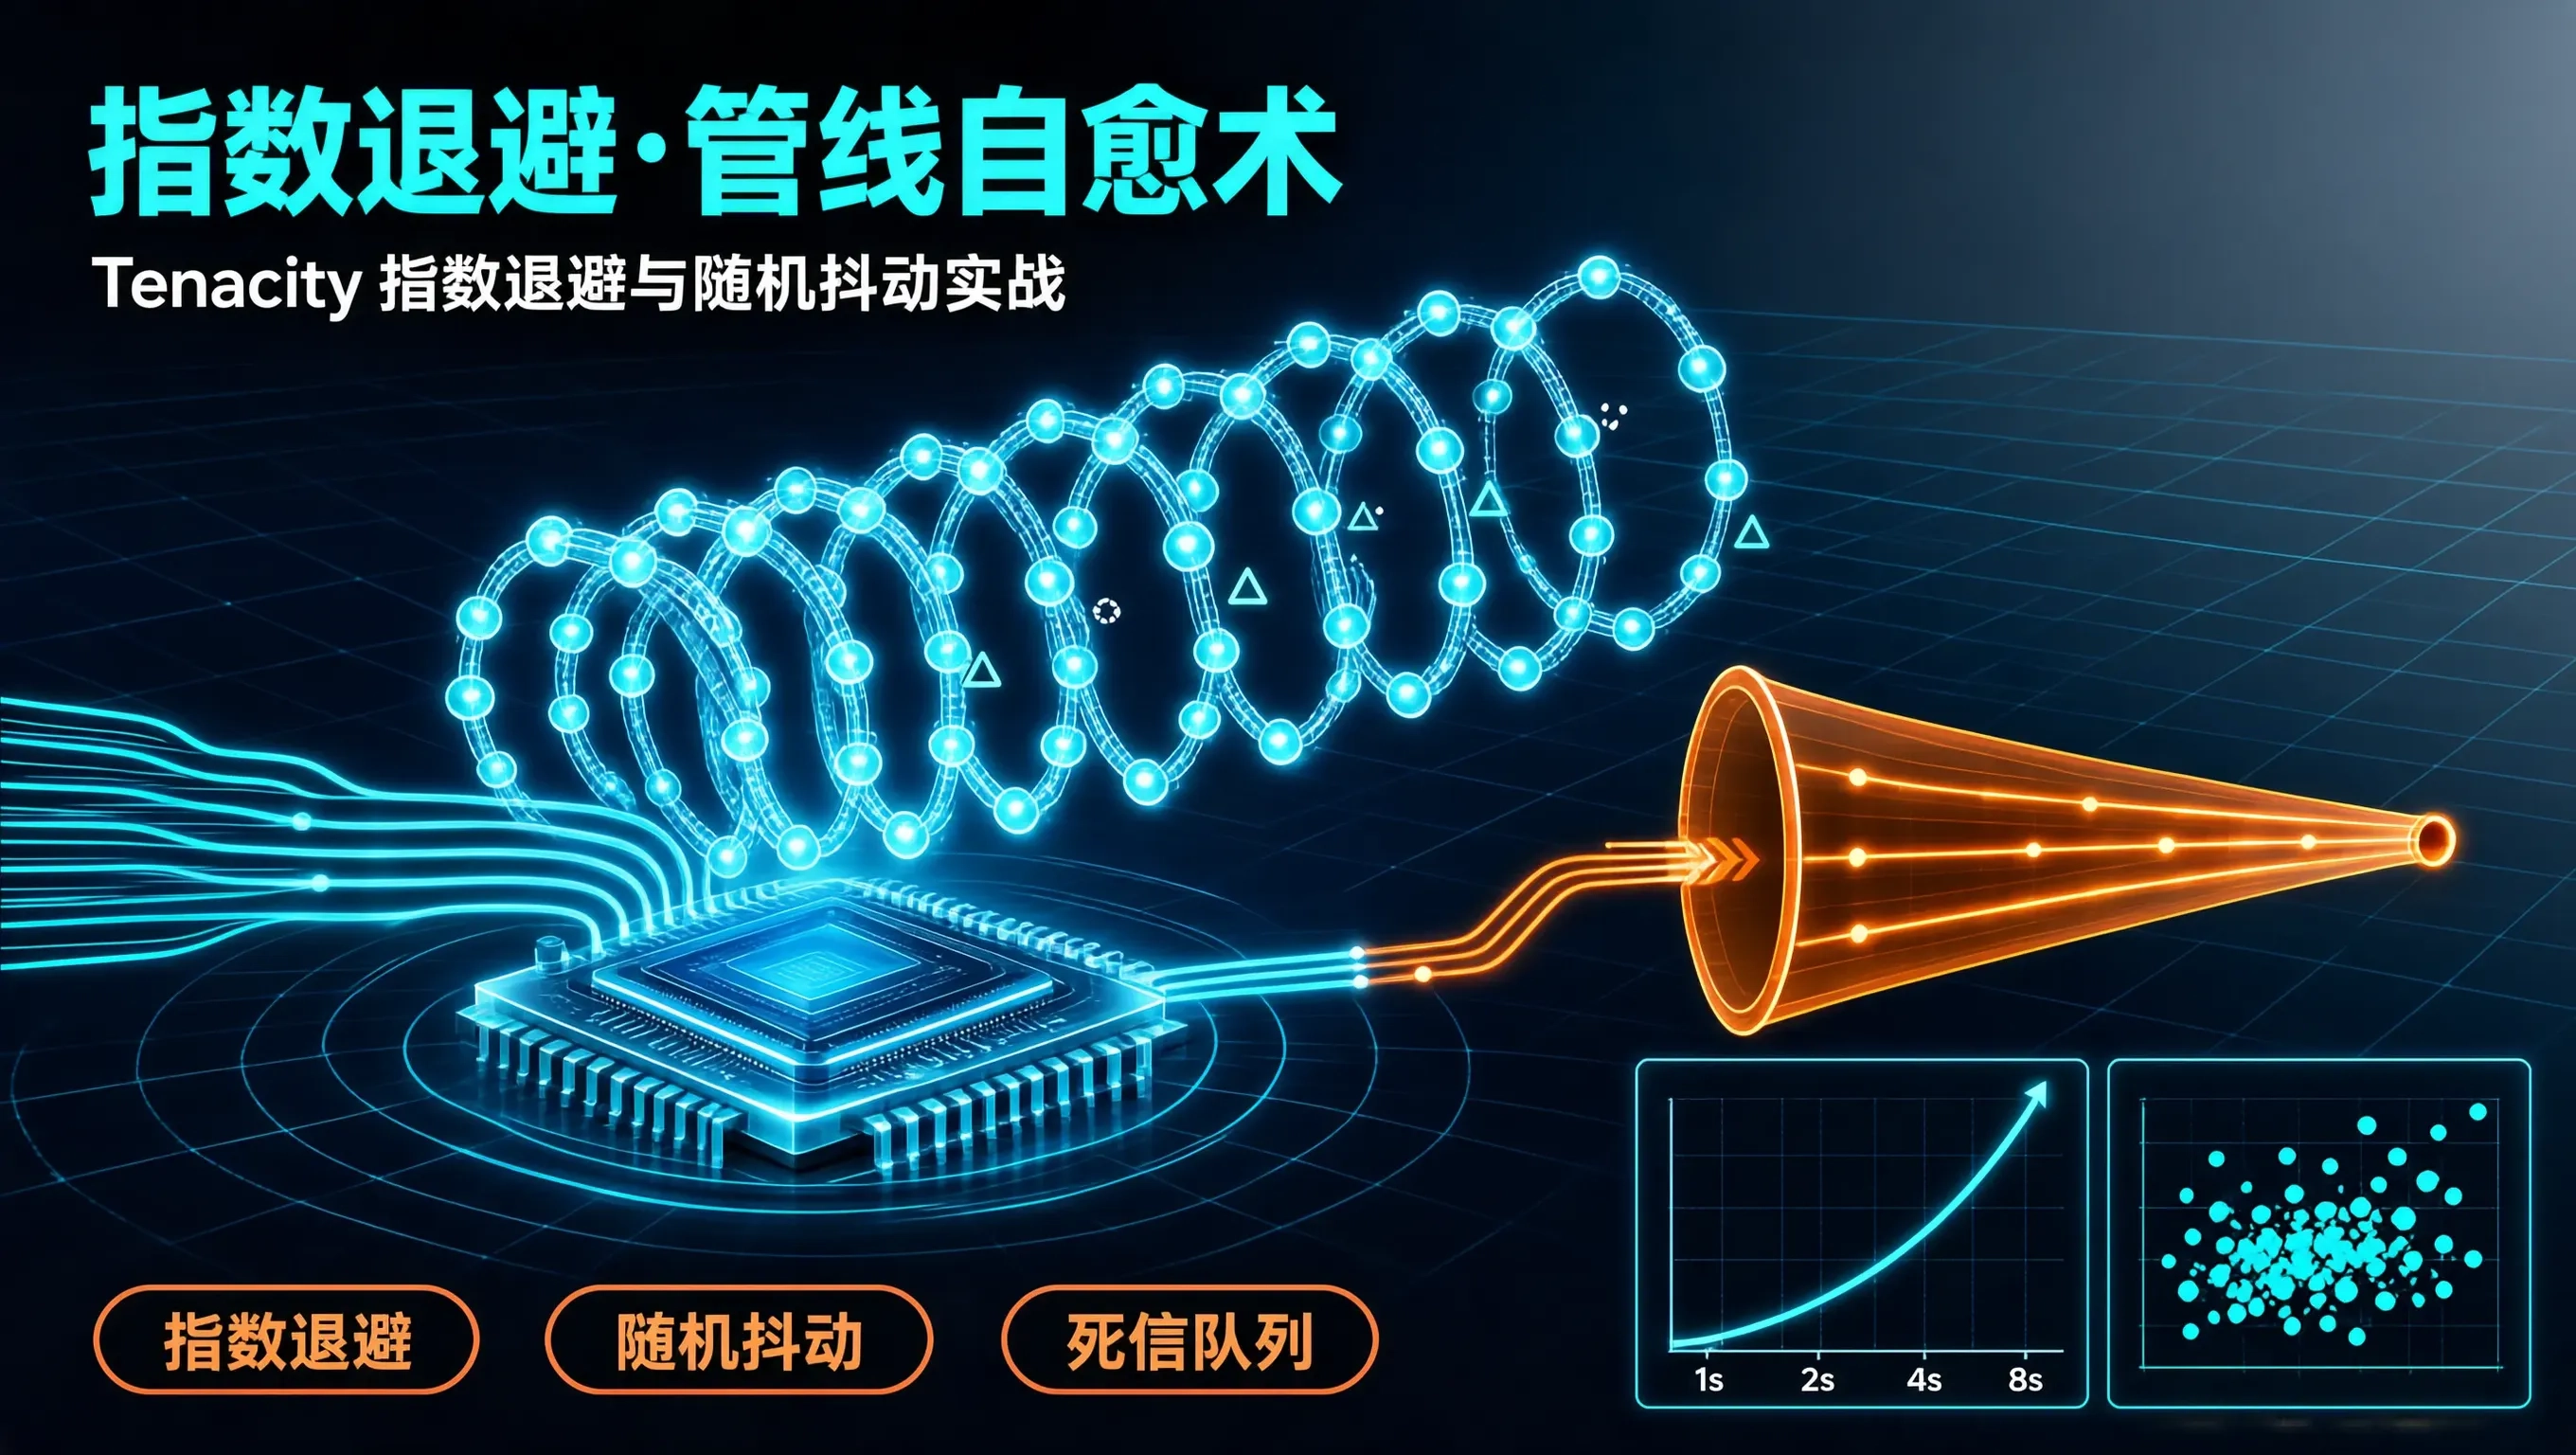
今天我们深入剖析工业级重试库 Tenacity 的核心实战,演示如何配置指数退避(Exponential Backoff)、随机抖动(Jitter)、条件重试与事后补偿回调。
一、指数退避与随机抖动(Full Jitter)的数学原理
flowchart LR
Req[初次请求失败] –> Sleep1[第 1 次重试: 等待 1s + 随机抖动]
Sleep1 –> Req2[重试再次失败]
Req2 –> Sleep2[第 2 次重试: 等待 2s + 随机抖动]
Sleep2 –> Req3[重试再次失败]
Req3 –> Sleep3[第 3 次重试: 等待 4s + 随机抖动 (指数级拉长退避时间)]
Sleep3 –> Success[下游压力平复,成功响应!]
为什么必须引入随机抖动(Jitter)?
如果多个并发 Worker 在同一时刻遇到下游网络闪断,如果单纯采用严格的指数退避(等待 $2^1, 2^2, 2^3$ 秒),所有 Worker 仍然会在第 2 秒、第 4 秒、第 8 秒完全同步地向服务端发起洪峰冲击!
引入全随机抖动(Full Jitter)后:$$\\text{Sleep} = \\text{random}(0, \\min(M, \\text{base} \\times 2^{\\text{attempt}}))$$把并发客户端的重试请求在时间轴上彻底打散,让下游平稳吸纳流量。
二、生产级 Tenacity 重试配置实操代码
import logging
import requests
from tenacity import (
retry,
stop_after_attempt,
wait_exponential,
wait_random,
retry_if_exception_type,
before_sleep_log,
retry_if_result
)
logger = logging.getLogger(__name__)
# 自定义非瞬态业务异常(不可重试)
class NonRetryableBusinessError(Exception):
pass
def is_transient_http_error(exception: Exception) -> bool:
"""仅针对网络抖动、超时以及 429/5xx 状态码进行重试"""
if isinstance(exception, requests.exceptions.Timeout) or \\
isinstance(exception, requests.exceptions.ConnectionError):
return True
if isinstance(exception, requests.exceptions.HTTPError):
status_code = exception.response.status_code
# 429 (限流) 或 5xx (服务端错误) 允许重试,4xx 客户端参数错误坚决不重试
return status_code == 429 or (500 <= status_code < 600)
return False
# 生产级装饰器定义
@retry(
# 1. 重试终止条件:最多重试 5 次
stop=stop_after_attempt(5),
# 2. 等待策略:指数退避 (初始 1 秒,最大 30 秒,翻倍系数 2) + 0~2秒全随机抖动 Jitter
wait=wait_exponential(multiplier=1, min=1, max=30) + wait_random(0, 2),
# 3. 触发重试的异常类型过滤:仅对瞬态网络异常重试
retry=retry_if_exception_type(requests.exceptions.RequestException),
# 4. 每次重试休眠前,自动打印结构化 Warning 日志并带上尝试轮次
before_sleep=before_sleep_log(logger, logging.WARNING),
# 5. 重试彻底失败后重新抛出原始异常,方便外层兜底
reraise=True
)
def fetch_remote_dataset_with_retry(api_url: str, payload: dict) -> dict:
logger.info(f"正在请求数据接口: {api_url}")
response = requests.post(api_url, json=payload, timeout=5.0)
response.raise_for_status()
data = response.json()
if data.get("code") == "INVALID_PARAM":
# 业务级不可恢复错误,直接抛出,触发立即阻断
raise NonRetryableBusinessError("参数非法,无需重试")
return data
三、与数据管线死信队列(Dead Letter Queue)结合
当 5 次重试全部耗尽依然失败时,不能让脚本直接崩溃抛出 Uncaught Exception,必须结合 Tenacity 的 retry_error_callback 将失败批次优雅分流至死信队列:
def on_retry_exhausted_fallback(retry_state):
"""当所有重试全部失败时的最终降级回调"""
exception = retry_state.outcome.exception()
args = retry_state.args
logger.error(f"[CRITICAL] 数据抽取任务已耗尽全部重试轮次,正在将参数写入死信队列: {args}, 异常: {str(exception)}")
# 将失败数据参数落盘至 SQLite 或 Redis DLQ 供后续人工补数
save_to_dead_letter_queue(args, str(exception))
# 返回兜底占位结构,保障上游管线主流程不中断
return {"status": "FAILED_FALLBACK", "records": []}
四、生产治理避坑原则
用 Tenacity 给数据管线装上弹簧,面对狂暴的网络抖动,系统才能在无声无息中完成自愈。