/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
【模型压缩】量化(Quantization)详解:从原理到 BERT 实战压缩
一句话总结:量化就是把模型的 FP32 高精度参数"降级"成 INT8 低精度整数,在精度几乎不掉的前提下,让模型体积缩小约 4 倍、推理速度大幅提升。
本文是黑马《文本分类实战项目》系列笔记之一。项目里用到的 BERT 模型,经过量化后体积从 390M 降到 145M、CPU 推理速度从 66ms 提升到 23ms,而精度只掉了不到 1 个百分点——量化为什么这么神奇?下面从原理到代码一步步讲透。
文章目录
- 【模型压缩】量化(Quantization)详解:从原理到 BERT 实战压缩
-
- 一、为什么需要模型压缩
- 二、什么是量化
-
- 2.1 一个形象的比喻:高清 → 模糊
- 2.2 量化的正式定义
- 2.3 量化的数学原理
- 三、三种主流量化方式
-
- 3.1 DQ:动态量化(训练后,最简单)
- 3.2 PTQ:静态量化(训练后,性价比最高)
- 3.3 QAT:量化感知训练(训练中,精度最高)
- 3.4 三种方式横向对比
- 四、CPU 与 GPU 怎么选
- 五、实战:BERT 文本分类模型量化
-
- 5.1 项目背景
- 5.2 动态量化完整代码
- 5.3 量化效果对比(项目实测数据)
- 5.4 结果分析
- 六、总结
- 七、面试常问
一、为什么需要模型压缩
先看一个真实的痛点。在文本分类项目里,我们训练了 4 种方案:随机森林、fasttext、BERT、LLM+Prompt,它们的"体积 + 响应时间"对比如下:
| 随机森林 | 1.47G(pkl) | 32ms 左右 |
| fasttext | 800M 左右(bin) | 1ms 左右 |
| BERT 预训练+微调 | 390M(pt) | CPU 60ms / GPU 25ms |
| LLM+Prompt | 无需本地存储(远程调用) | 1300ms 左右 |
BERT 精度最高(0.93 左右),但 390M 的体积在 CPU 上跑一次要 60ms。如果要把模型部署到移动端、嵌入式设备,或者要支撑高并发的线上服务,这个体积和速度就是瓶颈。
模型压缩的意义:在模型精度不受太大影响的情况下,尽可能让模型变得更小、更简单,最终提升推理速度。
BERT 模型压缩常见的有四种方式:
#mermaid-svg-GrHK1SIXH4zUYnHh{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-GrHK1SIXH4zUYnHh .error-icon{fill:#552222;}#mermaid-svg-GrHK1SIXH4zUYnHh .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-GrHK1SIXH4zUYnHh .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-GrHK1SIXH4zUYnHh .marker{fill:#333333;stroke:#333333;}#mermaid-svg-GrHK1SIXH4zUYnHh .marker.cross{stroke:#333333;}#mermaid-svg-GrHK1SIXH4zUYnHh svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-GrHK1SIXH4zUYnHh p{margin:0;}#mermaid-svg-GrHK1SIXH4zUYnHh .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster-label text{fill:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster-label span{color:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster-label span p{background-color:transparent;}#mermaid-svg-GrHK1SIXH4zUYnHh .label text,#mermaid-svg-GrHK1SIXH4zUYnHh span{fill:#333;color:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh .node rect,#mermaid-svg-GrHK1SIXH4zUYnHh .node circle,#mermaid-svg-GrHK1SIXH4zUYnHh .node ellipse,#mermaid-svg-GrHK1SIXH4zUYnHh .node polygon,#mermaid-svg-GrHK1SIXH4zUYnHh .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-GrHK1SIXH4zUYnHh .rough-node .label text,#mermaid-svg-GrHK1SIXH4zUYnHh .node .label text,#mermaid-svg-GrHK1SIXH4zUYnHh .image-shape .label,#mermaid-svg-GrHK1SIXH4zUYnHh .icon-shape .label{text-anchor:middle;}#mermaid-svg-GrHK1SIXH4zUYnHh .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-GrHK1SIXH4zUYnHh .rough-node .label,#mermaid-svg-GrHK1SIXH4zUYnHh .node .label,#mermaid-svg-GrHK1SIXH4zUYnHh .image-shape .label,#mermaid-svg-GrHK1SIXH4zUYnHh .icon-shape .label{text-align:center;}#mermaid-svg-GrHK1SIXH4zUYnHh .node.clickable{cursor:pointer;}#mermaid-svg-GrHK1SIXH4zUYnHh .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-GrHK1SIXH4zUYnHh .arrowheadPath{fill:#333333;}#mermaid-svg-GrHK1SIXH4zUYnHh .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-GrHK1SIXH4zUYnHh .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-GrHK1SIXH4zUYnHh .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-GrHK1SIXH4zUYnHh .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-GrHK1SIXH4zUYnHh .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-GrHK1SIXH4zUYnHh .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster text{fill:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh .cluster span{color:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-GrHK1SIXH4zUYnHh .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-GrHK1SIXH4zUYnHh rect.text{fill:none;stroke-width:0;}#mermaid-svg-GrHK1SIXH4zUYnHh .icon-shape,#mermaid-svg-GrHK1SIXH4zUYnHh .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-GrHK1SIXH4zUYnHh .icon-shape p,#mermaid-svg-GrHK1SIXH4zUYnHh .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-GrHK1SIXH4zUYnHh .icon-shape .label rect,#mermaid-svg-GrHK1SIXH4zUYnHh .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-GrHK1SIXH4zUYnHh .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-GrHK1SIXH4zUYnHh .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-GrHK1SIXH4zUYnHh :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
模型压缩
模型量化
模型蒸馏
模型剪枝
低秩分解
FP32 → INT8大模型变小数
教师模型→ 学生模型
移除冗余权重完整 → 残缺
大矩阵拆成小矩阵相乘
本篇文章只聚焦第一个方向:模型量化。
二、什么是量化
2.1 一个形象的比喻:高清 → 模糊
可以把模型量化理解成"高清图片变模糊图片":
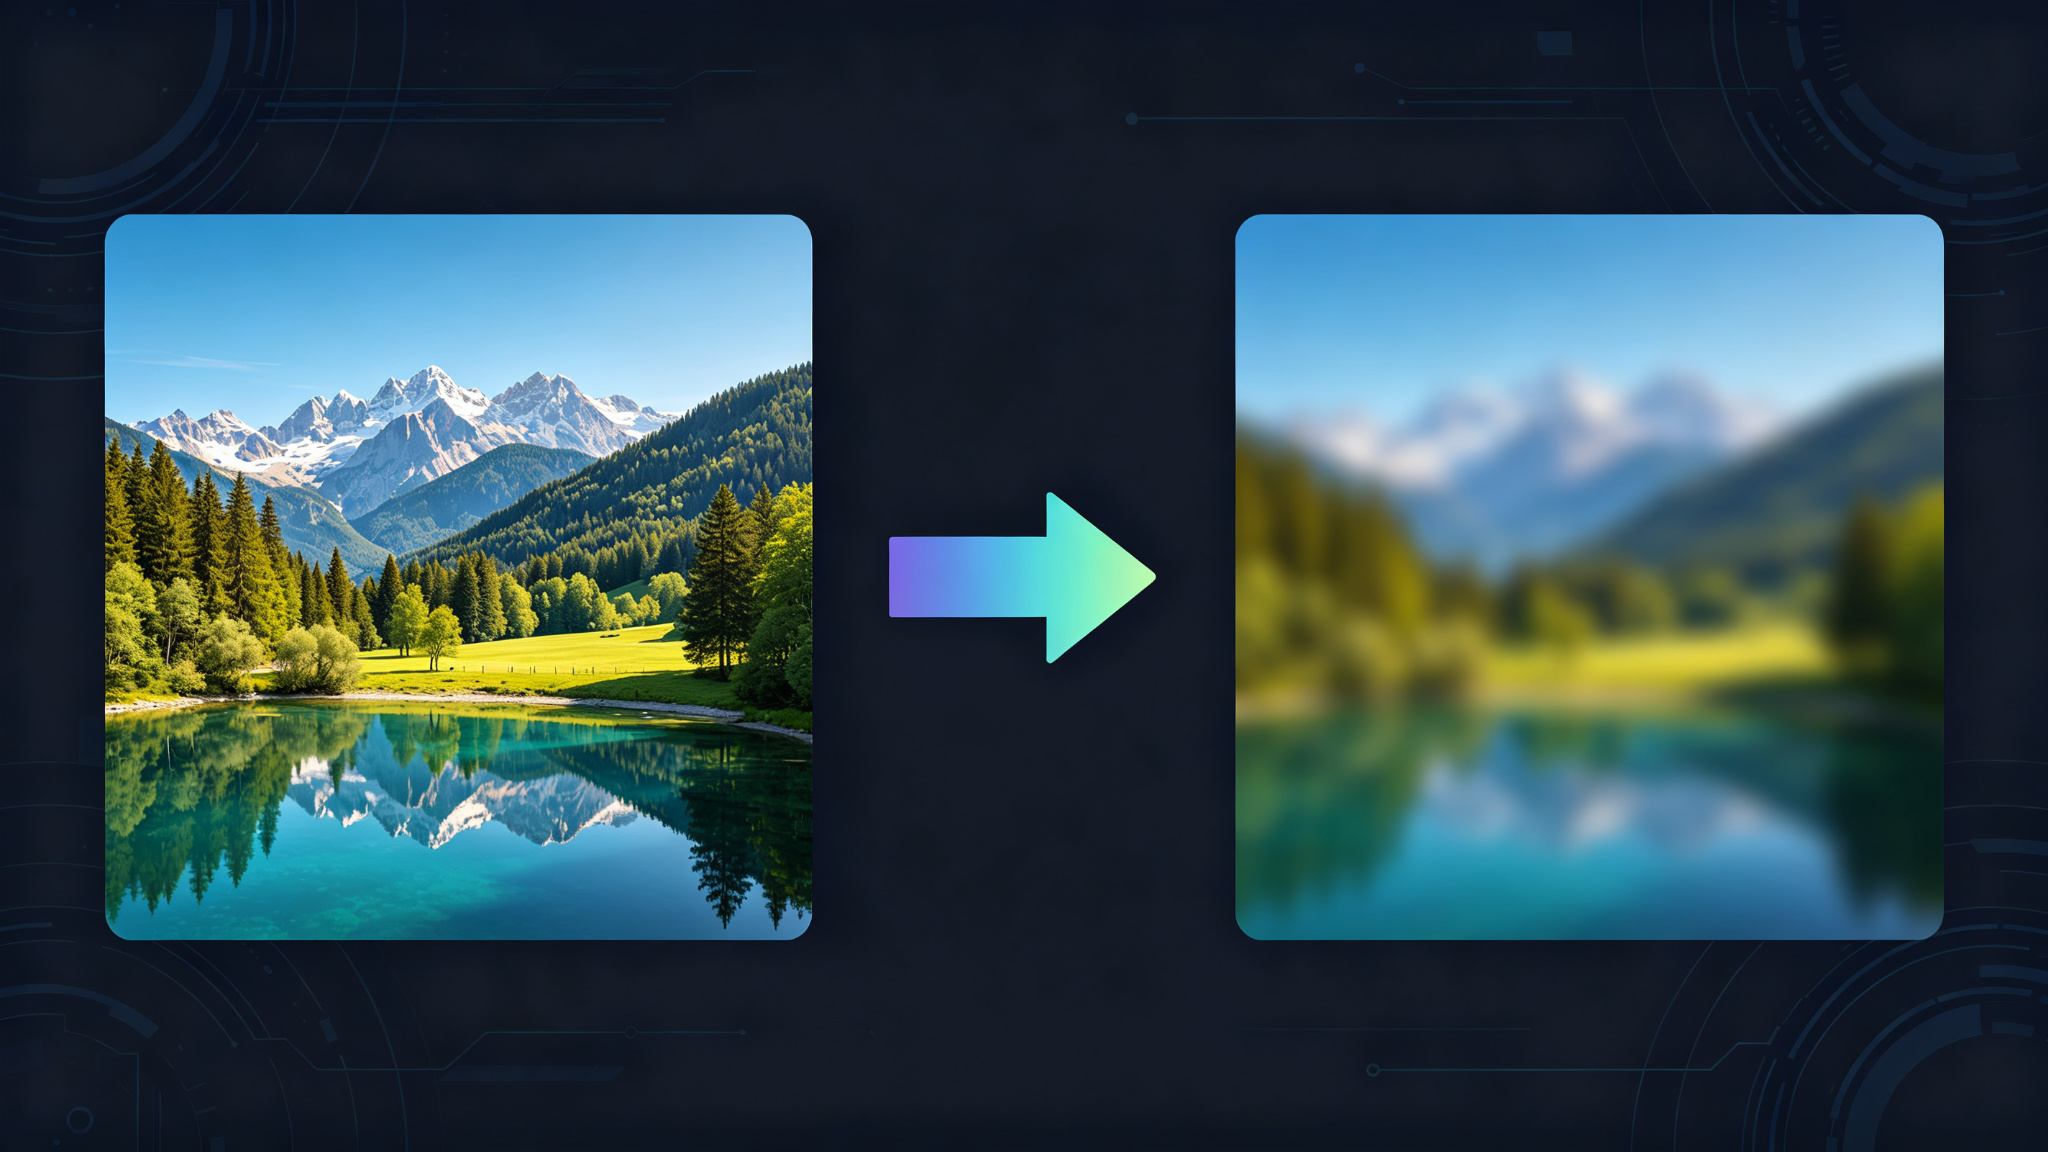
- 高清图(FP32):每个像素用 32 位浮点数表示,信息丰富,但文件大。
- 模糊图(INT8):每个像素只用 8 位整数表示,细节少了一些,但文件小、加载快。
人眼(模型的精度)几乎察觉不到模糊带来的差异,但文件体积(存储)和加载速度(推理)改善巨大——量化就是这个思路。
2.2 量化的正式定义
量化是模型压缩的技术之一,在对模型性能影响不大的情况下,尽可能减小模型参数的存储空间(float32 → qint8),最终提升推理速度。
关键点拆开看:
2.3 量化的数学原理
量化的本质是:用一个缩放因子(scale)和零点(zero_point),把连续的浮点数映射到离散的整数区间。
对称量化:正负范围对称,零点固定为 0,公式最简单:
q = round(r / scale)
scale = max(|r_max|, |r_min|) / 127
非对称量化:不要求对称,多了一个零点偏移,能充分利用 0~255 的全部范围,对分布不均匀的数据更友好:
q = round(r / scale + zero_point)
反量化(推理时把 INT8 结果还原成浮点)就是上面的逆运算:
#mermaid-svg-AHu2v2MMy1ynnZko{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-AHu2v2MMy1ynnZko .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-AHu2v2MMy1ynnZko .error-icon{fill:#552222;}#mermaid-svg-AHu2v2MMy1ynnZko .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-AHu2v2MMy1ynnZko .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-AHu2v2MMy1ynnZko .marker{fill:#333333;stroke:#333333;}#mermaid-svg-AHu2v2MMy1ynnZko .marker.cross{stroke:#333333;}#mermaid-svg-AHu2v2MMy1ynnZko svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-AHu2v2MMy1ynnZko p{margin:0;}#mermaid-svg-AHu2v2MMy1ynnZko .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-AHu2v2MMy1ynnZko .cluster-label text{fill:#333;}#mermaid-svg-AHu2v2MMy1ynnZko .cluster-label span{color:#333;}#mermaid-svg-AHu2v2MMy1ynnZko .cluster-label span p{background-color:transparent;}#mermaid-svg-AHu2v2MMy1ynnZko .label text,#mermaid-svg-AHu2v2MMy1ynnZko span{fill:#333;color:#333;}#mermaid-svg-AHu2v2MMy1ynnZko .node rect,#mermaid-svg-AHu2v2MMy1ynnZko .node circle,#mermaid-svg-AHu2v2MMy1ynnZko .node ellipse,#mermaid-svg-AHu2v2MMy1ynnZko .node polygon,#mermaid-svg-AHu2v2MMy1ynnZko .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-AHu2v2MMy1ynnZko .rough-node .label text,#mermaid-svg-AHu2v2MMy1ynnZko .node .label text,#mermaid-svg-AHu2v2MMy1ynnZko .image-shape .label,#mermaid-svg-AHu2v2MMy1ynnZko .icon-shape .label{text-anchor:middle;}#mermaid-svg-AHu2v2MMy1ynnZko .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-AHu2v2MMy1ynnZko .rough-node .label,#mermaid-svg-AHu2v2MMy1ynnZko .node .label,#mermaid-svg-AHu2v2MMy1ynnZko .image-shape .label,#mermaid-svg-AHu2v2MMy1ynnZko .icon-shape .label{text-align:center;}#mermaid-svg-AHu2v2MMy1ynnZko .node.clickable{cursor:pointer;}#mermaid-svg-AHu2v2MMy1ynnZko .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-AHu2v2MMy1ynnZko .arrowheadPath{fill:#333333;}#mermaid-svg-AHu2v2MMy1ynnZko .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-AHu2v2MMy1ynnZko .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-AHu2v2MMy1ynnZko .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-AHu2v2MMy1ynnZko .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-AHu2v2MMy1ynnZko .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-AHu2v2MMy1ynnZko .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-AHu2v2MMy1ynnZko .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-AHu2v2MMy1ynnZko .cluster text{fill:#333;}#mermaid-svg-AHu2v2MMy1ynnZko .cluster span{color:#333;}#mermaid-svg-AHu2v2MMy1ynnZko div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-AHu2v2MMy1ynnZko .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-AHu2v2MMy1ynnZko rect.text{fill:none;stroke-width:0;}#mermaid-svg-AHu2v2MMy1ynnZko .icon-shape,#mermaid-svg-AHu2v2MMy1ynnZko .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-AHu2v2MMy1ynnZko .icon-shape p,#mermaid-svg-AHu2v2MMy1ynnZko .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-AHu2v2MMy1ynnZko .icon-shape .label rect,#mermaid-svg-AHu2v2MMy1ynnZko .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-AHu2v2MMy1ynnZko .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-AHu2v2MMy1ynnZko .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-AHu2v2MMy1ynnZko :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
FP32 权重4 字节
× scale + zero_point(量化)
INT8 整数1 字节
存储 / 矩阵计算
(反量化)r = scale × (q – zero_point)
FP32 输出
精度损失主要来自 round() 的舍入误差——这也是量化感知训练(QAT)存在的意义:让模型在训练时就学会适应这种舍入误差。
三、三种主流量化方式
根据"量化的时机"和"量化哪些东西",常见的有三种方式:
#mermaid-svg-NlbcYGvIt3qPUuE9{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-NlbcYGvIt3qPUuE9 .error-icon{fill:#552222;}#mermaid-svg-NlbcYGvIt3qPUuE9 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-NlbcYGvIt3qPUuE9 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .marker.cross{stroke:#333333;}#mermaid-svg-NlbcYGvIt3qPUuE9 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-NlbcYGvIt3qPUuE9 p{margin:0;}#mermaid-svg-NlbcYGvIt3qPUuE9 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster-label text{fill:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster-label span{color:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster-label span p{background-color:transparent;}#mermaid-svg-NlbcYGvIt3qPUuE9 .label text,#mermaid-svg-NlbcYGvIt3qPUuE9 span{fill:#333;color:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .node rect,#mermaid-svg-NlbcYGvIt3qPUuE9 .node circle,#mermaid-svg-NlbcYGvIt3qPUuE9 .node ellipse,#mermaid-svg-NlbcYGvIt3qPUuE9 .node polygon,#mermaid-svg-NlbcYGvIt3qPUuE9 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .rough-node .label text,#mermaid-svg-NlbcYGvIt3qPUuE9 .node .label text,#mermaid-svg-NlbcYGvIt3qPUuE9 .image-shape .label,#mermaid-svg-NlbcYGvIt3qPUuE9 .icon-shape .label{text-anchor:middle;}#mermaid-svg-NlbcYGvIt3qPUuE9 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .rough-node .label,#mermaid-svg-NlbcYGvIt3qPUuE9 .node .label,#mermaid-svg-NlbcYGvIt3qPUuE9 .image-shape .label,#mermaid-svg-NlbcYGvIt3qPUuE9 .icon-shape .label{text-align:center;}#mermaid-svg-NlbcYGvIt3qPUuE9 .node.clickable{cursor:pointer;}#mermaid-svg-NlbcYGvIt3qPUuE9 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .arrowheadPath{fill:#333333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NlbcYGvIt3qPUuE9 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-NlbcYGvIt3qPUuE9 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NlbcYGvIt3qPUuE9 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster text{fill:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 .cluster span{color:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-NlbcYGvIt3qPUuE9 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-NlbcYGvIt3qPUuE9 rect.text{fill:none;stroke-width:0;}#mermaid-svg-NlbcYGvIt3qPUuE9 .icon-shape,#mermaid-svg-NlbcYGvIt3qPUuE9 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NlbcYGvIt3qPUuE9 .icon-shape p,#mermaid-svg-NlbcYGvIt3qPUuE9 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-NlbcYGvIt3qPUuE9 .icon-shape .label rect,#mermaid-svg-NlbcYGvIt3qPUuE9 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NlbcYGvIt3qPUuE9 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-NlbcYGvIt3qPUuE9 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-NlbcYGvIt3qPUuE9 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
训练后
训练中
QAT 量化感知训练前向/反向传播中插入伪量化节点模拟 INT8 舍入误差
DQ 动态量化只量化权重激活动态计算无需校准数据
PTQ 静态量化权重 + 激活都量化需要校准数据集统计激活动态范围
精度最高、成本最高
最简单、省心、只对权重生效
性价比最高、推理最快
3.1 DQ:动态量化(训练后,最简单)
- 核心思想:训练结束后,在推理时动态地把权重从 FP32 实时转成 INT8 计算,算完再转回 FP32。
- 特点:只量化权重,激活值(每层的输入输出)推理时动态计算,所以叫"动态"。
- 优点:不需要校准数据集,不需要重新训练,一行 API 搞定。
- API:
import torch
# 只量化指定的层类型(线性层、Embedding 层)
quantized_model = torch.quantization.quantize_dynamic(
model, # 原始 FP32 模型
{torch.nn.Linear, torch.nn.Embedding}, # 要量化的层
dtype=torch.qint8 # 量化成 8 位整数
)
⚠️ 注意:设备必须是 CPU。 PyTorch 原生的 torch.quantization 只支持 CPU 推理。
3.2 PTQ:静态量化(训练后,性价比最高)
- 核心思想:训练结束后,准备一个小型的校准数据集(几百条样本就够),输入模型做前向传播,预先统计每一层激活值的动态范围(最大值、最小值),算出最优的量化缩放参数。这个过程叫校准。
- 特点:校准完成后,权重和激活值都被量化成 INT8,推理时省去了动态转换的开销,速度比 DQ 更快。
- 步骤:prepare(插入量化节点)→ 喂校准数据 → convert(真正量化)。
import torch
model.eval()
# 1. 配置量化方式(fbgemm 面向 x86 CPU;qnnpack 面向 ARM)
model.qconfig = torch.quantization.get_default_qconfig('fbgemm')
# 2. 插入量化节点,准备校准
torch.quantization.prepare(model, inplace=True)
# 3. 用校准数据集前向传播,统计激活值范围
with torch.no_grad():
for texts, labels in calibration_dataloader: # 几百条数据即可
model(texts)
# 4. 真正执行量化
torch.quantization.convert(model, inplace=True)
3.3 QAT:量化感知训练(训练中,精度最高)
- 核心思想:在模型训练/微调阶段,就在网络的前向和后向传播中插入伪量化节点(Fake Quantize)。它模拟了 INT8 量化带来的数值截断和舍入误差,让模型在训练过程中就"学会"适应这种精度损失。
- 特点:训练完成后,把这些伪量化节点替换为真正的量化算子,导出 INT8 模型。因为误差被提前纳入训练,精度损失最小,有时甚至能略高于原始 FP32 模型。
- 代价:需要重新训练/微调,成本最高。
import torch
model.train()
# 1. 使用 QAT 专用的 qconfig
model.qconfig = torch.quantization.get_default_qat_qconfig('fbgemm')
# 2. 准备 QAT(把普通层替换为带伪量化节点的层)
torch.quantization.prepare_qat(model, inplace=True)
# 3. 正常训练/微调若干轮次(伪量化节点模拟 INT8 误差)
for epoch in range(epochs):
for texts, labels in dataloader:
loss = criterion(model(texts), labels)
optimizer.zero_grad()
loss.backward()
optimizer.step()
# 4. 训练完转成真正的 INT8 模型
model.eval()
torch.quantization.convert(model, inplace=True)
3.4 三种方式横向对比
| 量化时机 | 训练后 | 训练后 | 训练中 |
| 是否需要校准数据 | ❌ 不需要 | ✅ 需要(几百条) | ❌ 不需要 |
| 是否需要重新训练 | ❌ 不需要 | ❌ 不需要 | ✅ 需要 |
| 量化对象 | 只量化权重 | 权重 + 激活 | 权重 + 激活 |
| 推理速度 | 较快 | 最快 | 最快 |
| 精度 | 损失较小 | 损失可控 | 损失最小(甚至更高) |
| 实现成本 | 极低(一行 API) | 中 | 高 |
| 适用场景 | 快速部署、模型以线性层为主 | 追求推理速度的线上服务 | 精度敏感、能接受重训练 |
四、CPU 与 GPU 怎么选
很多人以为量化只跟 GPU 有关,其实恰恰相反:
- CPU 是量化的主战场:PyTorch 原生 torch.quantization 只支持 CPU 推理,配合 AVX512 等指令集,INT8 能获得显著加速。
- GPU 上 PyTorch 原生不支持 PTQ:NVIDIA 显卡请用 Torch-TensorRT,流程是:
- 校准:用 modelopt.torch.quantization 在 GPU 上跑一遍校准数据,插入伪量化节点;
- 编译:用 torch_tensorrt.compile 把模型编译成 TensorRT 引擎,获得真正的 INT8 加速。
这也是为什么很多项目里"量化后 GPU 反而没变快甚至变慢"——没有对应的 INT8 kernel 和引擎,量化转换反而增加了额外开销。
五、实战:BERT 文本分类模型量化
5.1 项目背景
在《文本分类实战项目》中,我们训练了 BERT 模型做新闻标题分类(训练数据 18w,10 个类别),基线精度 0.93 左右。模型以 torch.nn.Linear 和 torch.nn.Embedding 层为主,非常适合做动态量化。
5.2 动态量化完整代码
import torch
# 加载训练好的 FP32 BERT 模型
model = torch.load(config.bert_model_path, map_location='cpu')
model.eval()
# 动态量化:一行 API,量化 Linear 和 Embedding 层
quantized_model = torch.quantization.quantize_dynamic(
model,
{torch.nn.Linear, torch.nn.Embedding},
dtype=torch.qint8
)
# 保存量化后的模型(145M)
torch.save(quantized_model, config.bert_quantized_model_path)
5.3 量化效果对比(项目实测数据)
| 精度 | 0.93 | 降低不到 1 个百分点 | 基本无损 |
| 模型体积 | 390M | 145M | 减小约 63% |
| CPU 推理速度 | 0.066 秒 | 0.023 秒 | 快约 3 倍 |
| GPU 推理速度 | 23ms | 23ms 左右 | 无明显变化甚至更慢 |
5.4 结果分析
💡 经验总结:CPU 部署、追求体积和速度 → 量化首选;GPU 部署 → 优先考虑蒸馏或 TensorRT 量化。
六、总结
| 量化的本质 | FP32 → INT8,用 4 倍体积压缩换轻微精度损失 |
| DQ 动态量化 | 训练后,只量化权重,一行 API,最省心 |
| PTQ 静态量化 | 训练后,权重+激活都量化,需要校准数据,性价比最高 |
| QAT 量化感知训练 | 训练中插入伪量化节点,精度最高,成本最高 |
| CPU vs GPU | 原生量化只支持 CPU;GPU 走 Torch-TensorRT |
| 本项目效果 | 390M → 145M,CPU 66ms → 23ms,精度不掉 1 个点 |
模型量化是部署环节的"神技",但它不是万能的:精度敏感的模型建议用 QAT 或蒸馏,追求 GPU 极致加速建议用 TensorRT。下一篇可以继续聊聊模型蒸馏(教师模型 → 学生模型,本项目把它压到了 25.3M),感兴趣的同学关注一下。
七、面试常问
本文数据来源于《文本分类实战项目》实际训练与部署记录,图片为示意配图。