目录
一、这次我怎么测:不看玄学,只看能不能用
二、第一组:电商产品展示,重点看“商品会不会乱变”
示例提示词
三、第二组:人物情绪短片,重点看表情和动作自然不自然
示例提示词
四、第三组:连续镜头,重点看人物和场景能不能接得上
示例提示词
五、第四组:复杂运动,重点看“别突然违背常识”
示例提示词
六、成本、参考图和最后选择
最近我集中试了一轮 AI 视频生成,主要对比的是Seedance 2.0 Fast和MiniMax H3。
一开始,我只是想看看谁的画面更惊艳。但真正测下来之后,我发现 AI 视频工具不能只看第一眼的观感。对于内容创作、广告、电商短片,或者短剧分镜来说,更关键的问题其实是:
-
角色能不能稳住;
-
商品会不会变形;
-
镜头是否听话;
-
返工次数多不多;
-
最后能不能真的拿去剪辑和交付。
这次我按照实际创作流程,重点测试了四类场景:电商产品展示、人物情绪短片、连续镜头、复杂运动。
一、这次我怎么测:不看玄学,只看能不能用
我的测试方法比较简单:同一主题下,两边使用相近提示词;部分场景加入参考图,观察模型能不能稳住人物、商品和风格;最后再从成片率、返工成本和剪辑可用性来判断。
我现在越来越觉得,AI 视频不应该完全变成“抽卡”。一个模型偶尔出一条神片当然很开心,但如果十次里只有一次能用,真做项目会非常累。每一次失败都不只是浪费时间,也是在消耗预算和交付周期。
这也是我关注 Seedance 2.0 Fast 的原因。它现在 720P 分辨率下的价格已经降到比较容易尝试的区间,按刊例 75 折计费后,最低约0.6 元/秒。对经常需要批量生成、反复试镜头的人来说,这个变化很实际。
二、第一组:电商产品展示,重点看“商品会不会乱变”
第一个场景我选了电商产品展示。
电商视频不是只要好看就行,商品本身必须稳定。像香水、鞋子、咖啡机这类产品,如果比例变了、材质变了,或者细节被模型重新设计,画面再高级也不能直接用。
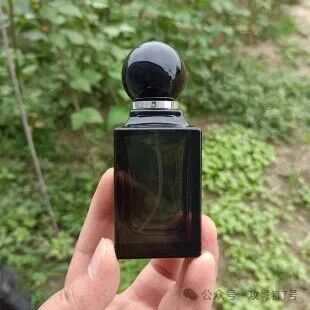
这组测试里,我准备了一张深色玻璃香水瓶参考图,然后分别让两个模型生成 5 秒左右的产品广告镜头。
示例提示词
参考图中的黑色玻璃香水瓶保持外观一致,放在深灰色石材台面上。镜头从左侧缓慢推近,瓶身有细腻高光,背景是低饱和的暖色灯光和轻微水汽。整体质感高级、真实、适合奢侈品香水广告。不要改变瓶子的形状,不要增加多余文字,不要让瓶身变形。
两个模型各生成 1 条视频,参数为:720P 分辨率、9:16 比例、5 秒、无声。
生成结果如下:
| Seedance 2.0 Fast | H3 |
|
seedance-2-0-fast测评1 |
H3测评1-1 |
这一组里,两个模型对“保持产品外观”的表现都不错。瓶子的轮廓、材质和高光基本能跟着参考图走,镜头推进也比较自然。
仔细看,H3 对轻微水汽的表现更精准一些;Seedance 2.0 Fast 在水汽表现上稍微弱一点,但整体画面看起来更真实。
所以如果是商品类内容,尤其是客户给了明确产品图的情况,我会更倾向 Seedance 2.0 Fast。它的表现不一定每个细节都最突出,但整体真实感更适合交付类内容。
三、第二组:人物情绪短片,重点看表情和动作自然不自然
第二组我测的是人物情绪短片。
这类内容看起来简单,其实很容易翻车。人物视频最怕的不是大动作,而是小动作:眼神飘、嘴角僵、手部不自然、转头时五官变形,都会让人一下出戏。
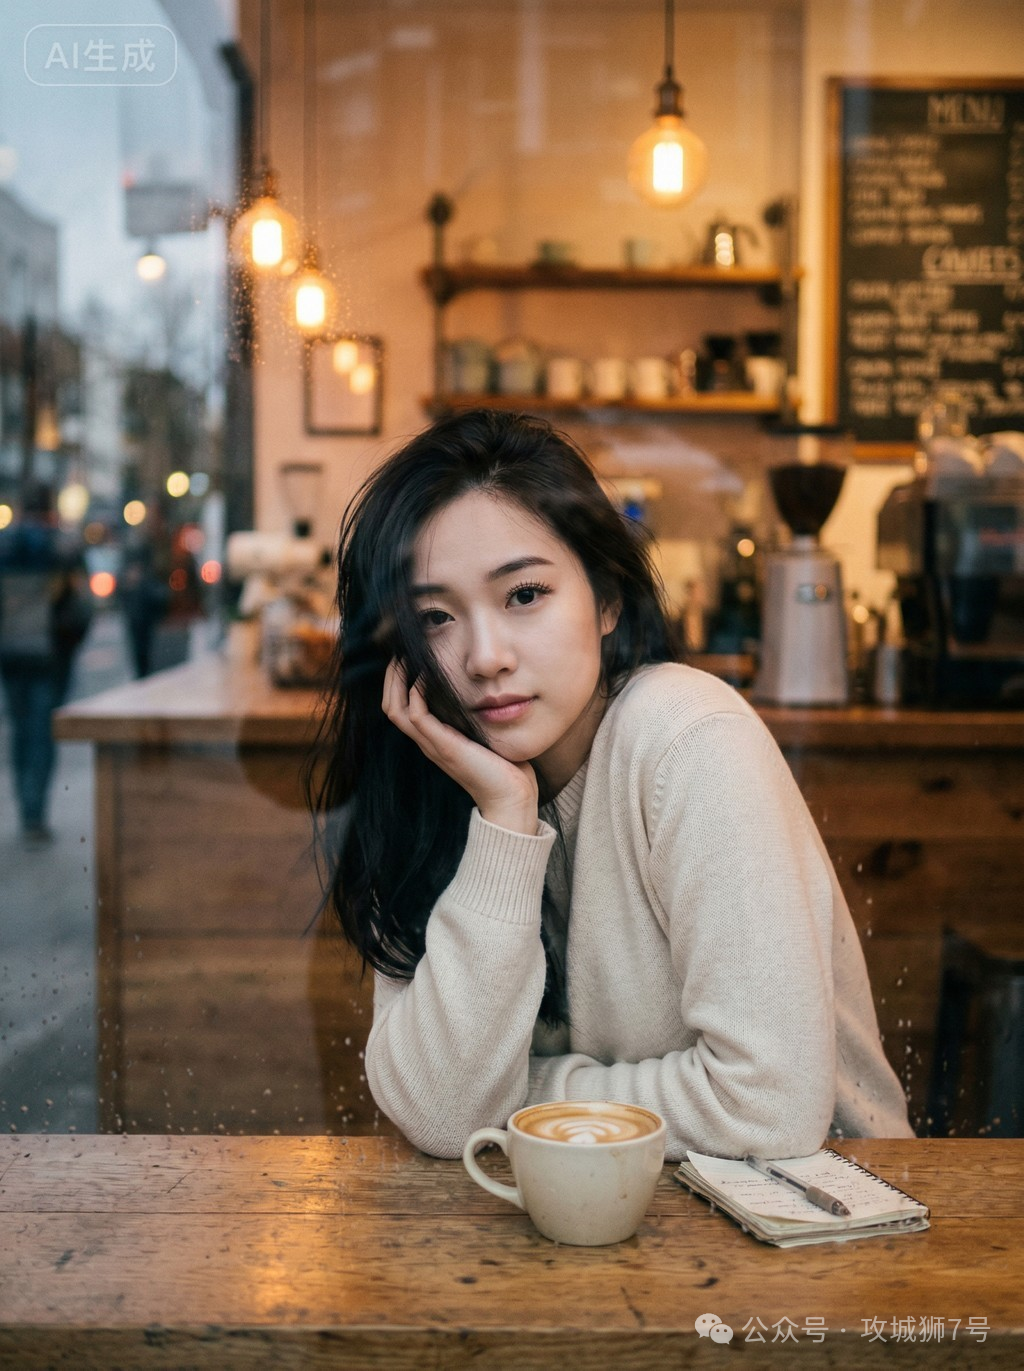
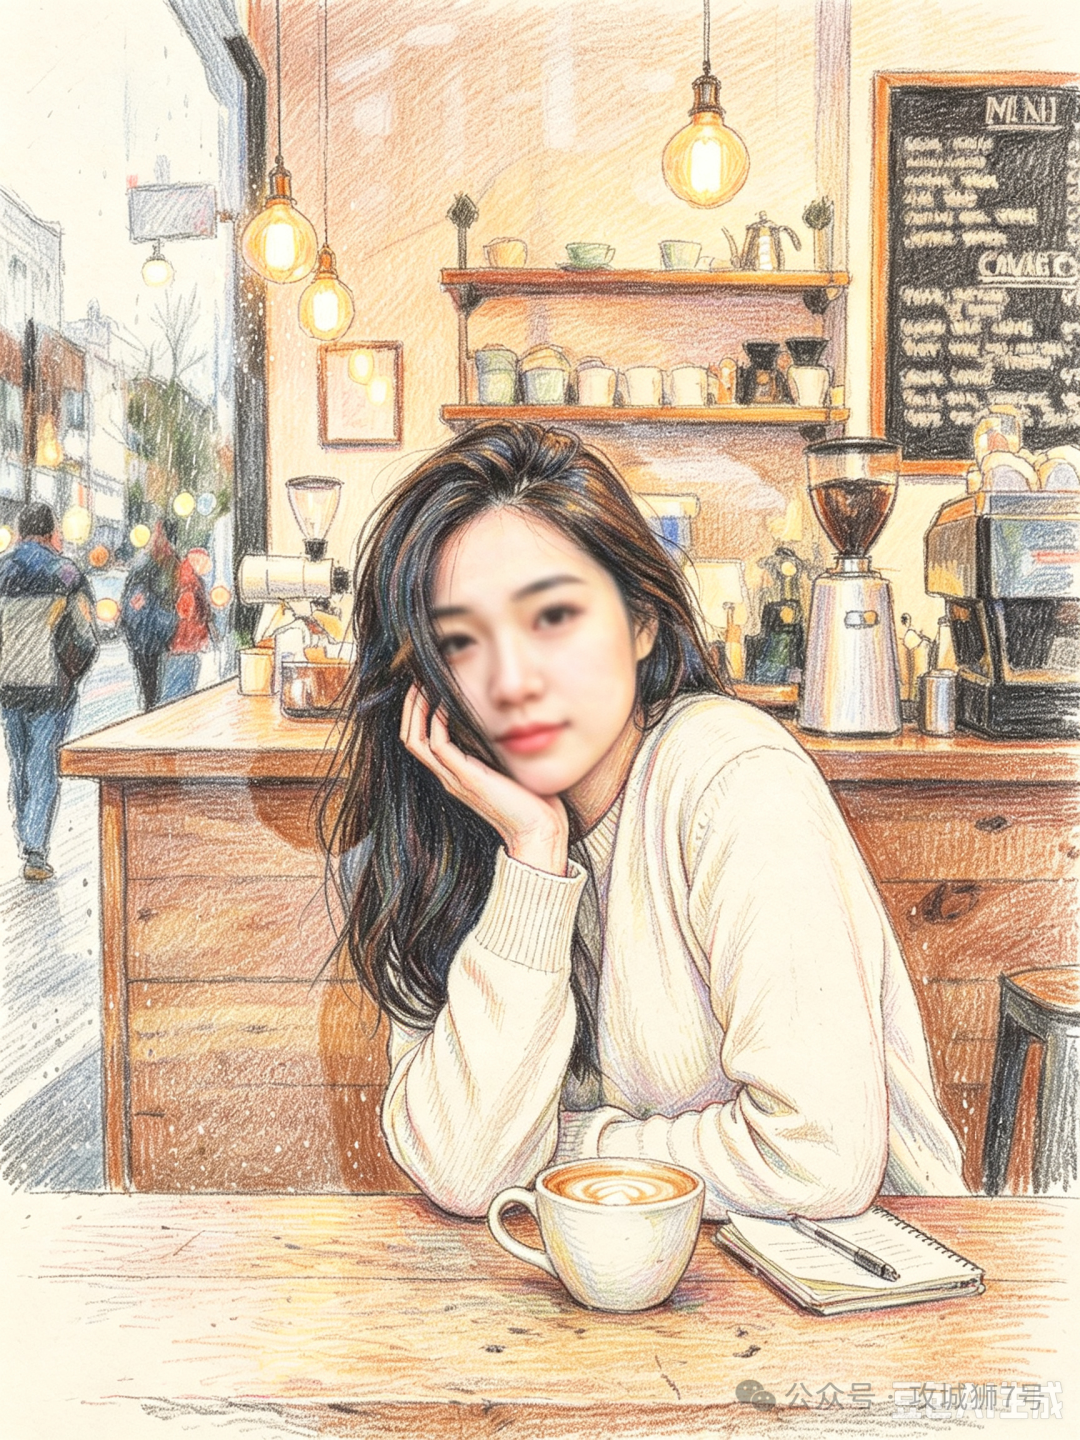
我准备了一张人物参考图:一个穿灰色毛衣的女生坐在咖啡馆窗边,光线比较柔和。然后让模型生成“看到消息后情绪变化”的镜头。
示例提示词
参考图中的女生保持面部特征和穿着一致,坐在咖啡馆靠窗的位置。她低头看手机,看到一条消息后先愣住,然后轻轻笑了一下,抬头看向窗外。镜头固定,中近景,下午自然光,情绪细腻,不夸张,不要做大幅度表演。人物五官保持稳定,手部动作自然。
这一次我发现,Seedance 2.0 Fast 对图像版权要求更严格一些。原参考图无法直接使用,最后只能把参考图转成彩铅风格后再生成视频。
生成结果如下:
|
Seedance 2.0 Fast |
H3 |
|
seedance-2-0-fast测评2 |
H3测评2 |
这一组测试下来,H3 生成的视频更贴合实际女孩的面貌;Seedance 2.0 Fast 则更贴合参考图里的周边环境。
光影方面,H3 对人物的处理更好一些,比如光线在面部和衣服上的变化更明显。至于“看到消息后愣一下”的表情,H3 看起来也更能表现出来一点。
整体情绪实现上,两者差距没有拉得特别大,但侧重点不太一样:H3 更贴近人物本身,Seedance 2.0 Fast 更能保持环境氛围。
四、第三组:连续镜头,重点看人物和场景能不能接得上
AI 视频真正难的不是生成一条 5 秒视频,而是生成一组能剪在一起的视频。
比如短剧里,夫妻两人的互动对话,如果每条里脸、衣服、房间布局都变一点,剪起来就会很痛苦。
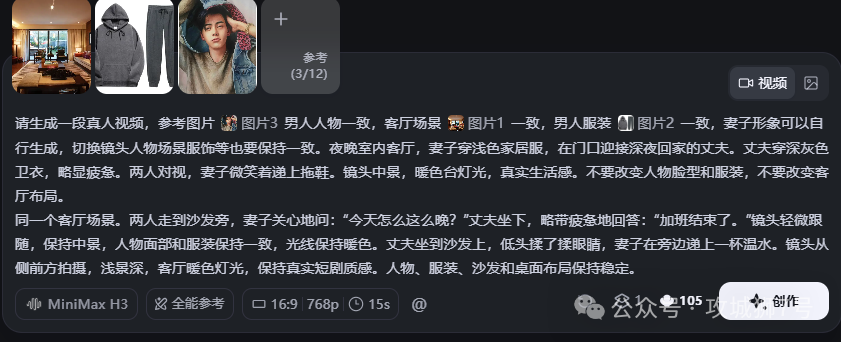
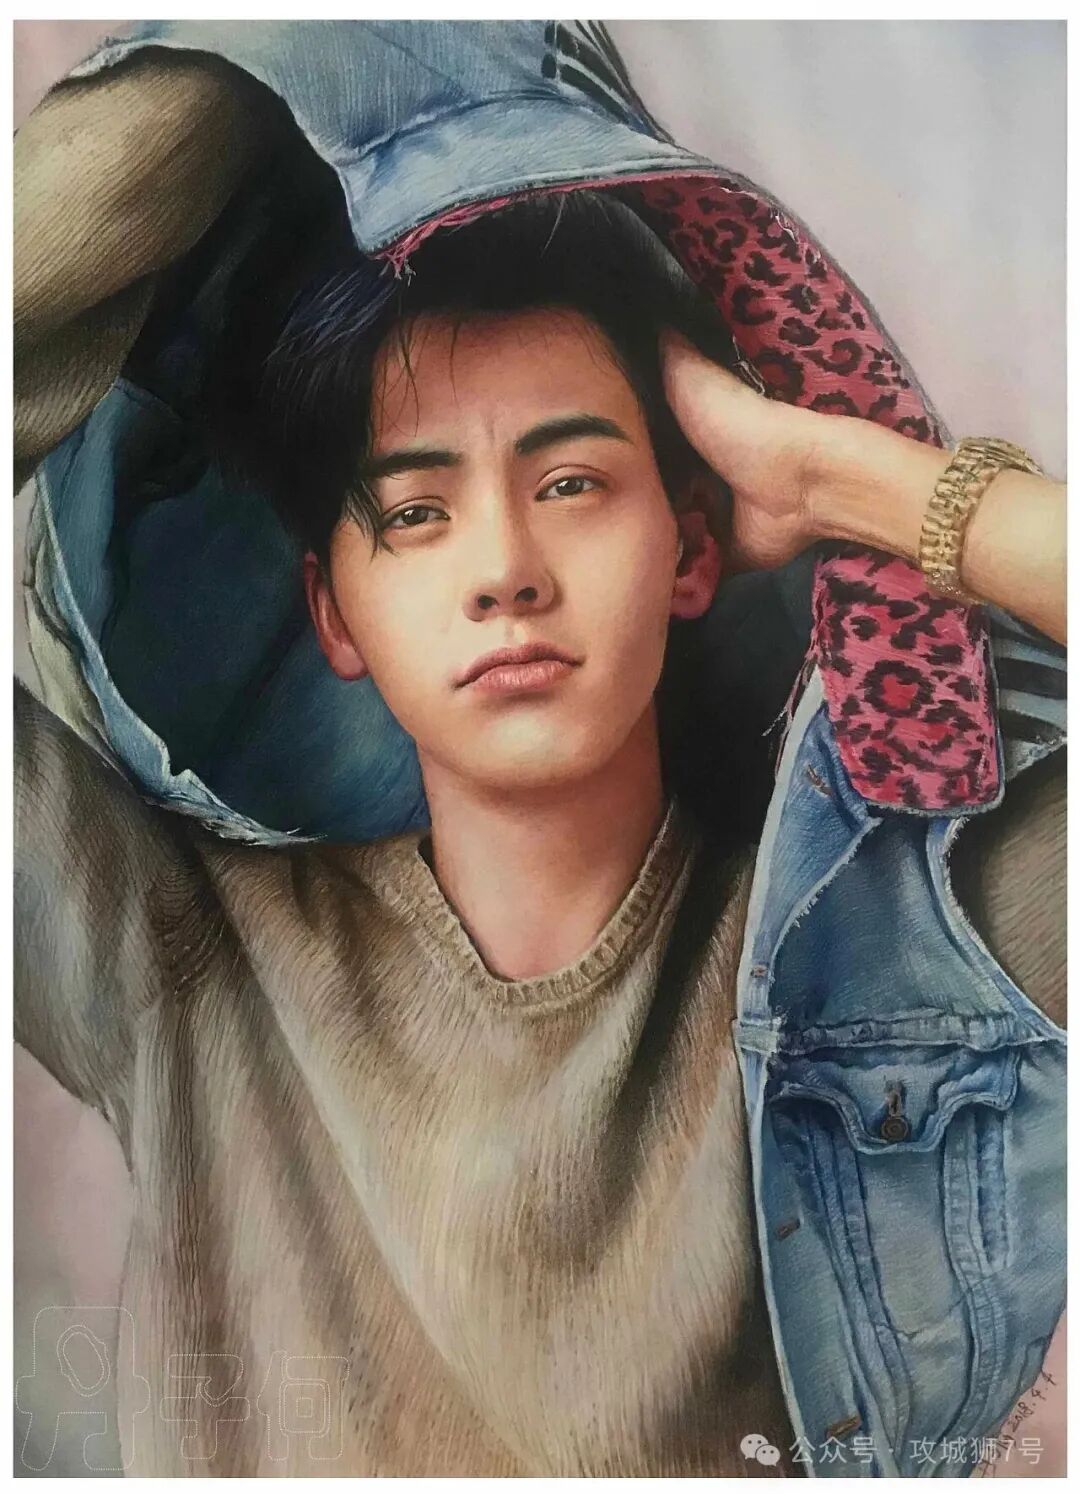
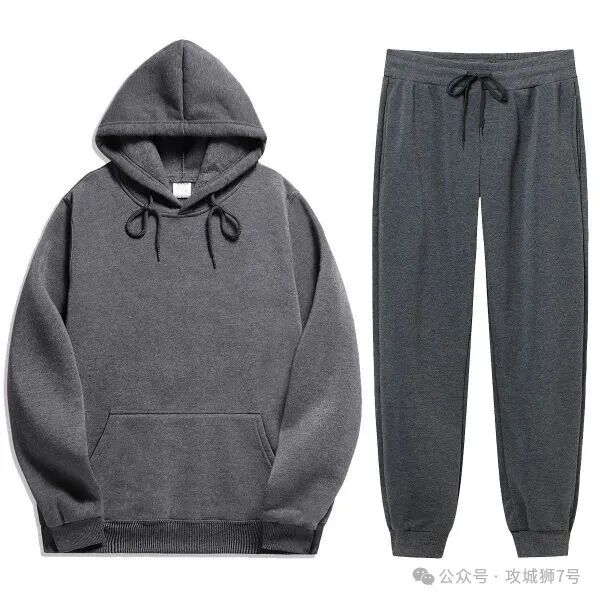
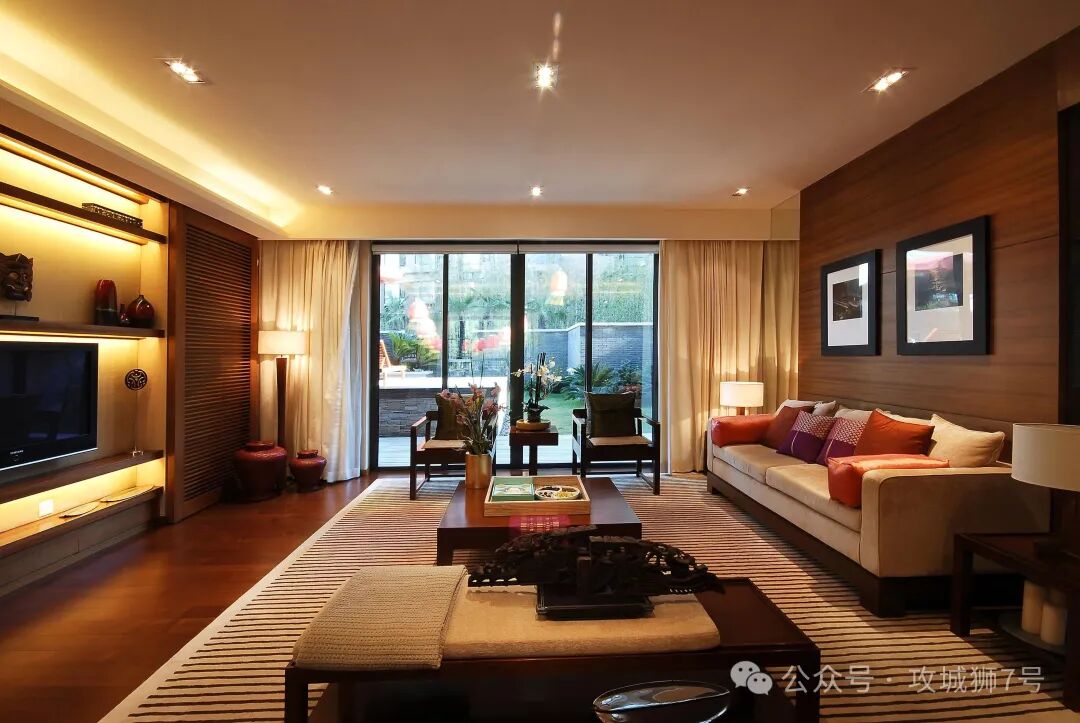
这组我设定了一个更生活化的夫妻互动场景:男生深夜回家,妻子在门口迎接,有简短对话,随后坐下。参考素材包括男生正面图、服装细节图和客厅场景图。这样做的目的,是看模型能不能更好地把握双人角色的一致性和剧情连贯性。
示例提示词
请生成一段真人视频,参考图片男人人物一致,客厅场景一致,男人服装一致,妻子形象可以自行生成,切换镜头人物场景服饰等也要保持一致。夜晚室内客厅,妻子穿浅色家居服,在门口迎接深夜回家的丈夫。丈夫穿深灰色卫衣,略显疲惫。两人对视,妻子微笑着递上拖鞋。镜头中景,暖色台灯光,真实生活感。不要改变人物脸型和服装,不要改变客厅布局。同一个客厅场景。两人走到沙发旁,妻子关心地问:“今天怎么这么晚?”丈夫坐下,略带疲惫地回答:“加班结束了。”镜头轻微跟随,保持中景,人物面部和服装保持一致,光线保持暖色。丈夫坐到沙发上,低头揉了揉眼睛,妻子在旁边递上一杯温水。镜头从侧前方拍摄,浅景深,客厅暖色灯光,保持真实短剧质感。人物、服装、沙发和桌面布局保持稳定。
参考图如下:
|
|
|
|
两个模型原计划各生成 1 条视频,参数为:720P 分辨率、16:9 比例、15 秒、有声。
但测试下来,Seedance 2.0 Fast 对素材和文字的版权问题比较严格。参考图转成彩铅风格也不行,去掉所有参考图也不行,Web 端始终提示版权相关问题。
甚至使用 API 调用方式生成,仍然提示版权问题:
{'id': 'cgt-20260814181211-7x4hh', 'model': 'doubao-seedance-2-0-fast-260128', 'status': 'failed', 'error': {'code': 'OutputVideoSensitiveContentDetected.PolicyViolation', 'message': 'The request failed because the output video may be related to copyright restrictions. Request id: 02178670233414500000000000000000000ffffac1777f63c6880'}, 'created_at': 1786702334, 'updated_at': 1786702489, 'service_tier': 'default', 'execution_expires_after': 172800, 'generate_audio': True, 'draft': False, 'priority': 0, 'output_format': 'mp4'}
最后,Seedance 2.0 Fast 只能改成下面这版更强调“原创虚构”的提示词:
生成一段原创电影叙事片段,夜晚现代客厅空间,暖色台灯和柔和室内灯光。画面中是两个原创虚构亚洲角色,男性三十岁左右,穿深灰色宽松连帽卫衣和深色休闲裤,神情疲惫;女性二十八岁左右,穿米白色浅色家居服,长发自然披散,表情温柔。男人回到家中,女人在门口迎接,微笑递上拖鞋,两人短暂对视。镜头采用中景,浅景深,光影自然。随后两人走到沙发区域,女人关心地问:“今天怎么这么晚?” 男人坐下回答:“加班结束了。” 镜头轻微跟随人物移动,尽量保持角色外观、服装、发型、客厅布局、沙发位置和桌面物品一致。男人坐到沙发上低头揉眼睛,女人从旁边递上一杯温水,镜头从侧前方拍摄,保持中景,暖色光线,连续叙事稳定,原创虚构人物,不对应任何真实人物,不模仿真实事件,不复刻现有影视作品。
H3 在这组里宽松一些,可以继续沿用前面的提示词和参考图片,并没有因为版权问题拒绝生成。
最终生成结果如下:
|
Seedance 2.0 Fast |
H3 |
|
seedance-2-0-fast测评3 |
H3测评3 |
因为这组测试里,两边使用的提示词并不完全一致,参考图也只有 H3 用上了,所以不能把结果简单理解成完全同条件对比。
但就最终视频来看,在同一个人物、同一个场景,以及多镜头连续性方面,两者表现都不错。H3 对参考图和提示词的处理更宽松,因此更贴近我最初提供的素材和描述;Seedance 2.0 Fast 虽然限制更多,但在情绪表现和场景展示细节上也有自己的优势。
五、第四组:复杂运动,重点看“别突然违背常识”
最后我测了一个容易翻车的场景:玻璃杯被碰倒,水洒出来,人物伸手去扶。
这个场景难在动作链条:杯子要倒得合理,水流不能太假,手部动作也要自然。
示例提示词
真实生活场景,木质餐桌上有一个透明玻璃杯,杯中有半杯水。人物的手不小心碰到杯子,杯子向右侧倾倒,水自然洒到桌面上,人物立刻伸手去扶。镜头近景拍摄,轻微手持感,但不要剧烈晃动。水流和杯子的运动符合真实物理规律,手部动作自然,不要出现多余手指。
这类场景目前没有哪个模型能百分百完美表现出来。各自生成结果如下:
|
Seedance 2.0 Fast |
H3 |
|
seedance-2-0-fast测评4 |
H3测评4 |
但这组里,Seedance 2.0 Fast 给我的结果更贴合一点。虽然它也有明显瑕疵,比如对“不小心碰倒水杯”的理解还不够准确,但它对“杯子碰倒—水洒出—手伸过去”这个过程的理解还算可以,甚至出现了一个慢动作镜头。
相比之下,H3 的表现更生硬一些,也更不符合我原本想要的逻辑。它看起来更像是主动把水碰倒,而不是“不小心碰倒”后的自然反应。
六、成本、参考图和最后选择
一轮连续测试下来,Seedance 2.0 Fast 总共花了将近 20 元。
H3 这次看起来成本更低,是因为我使用了免费额度完成测试。单看价格信息,MiniMax H3 是 768P、按秒计费,价格为0.50 元/秒。
生成速度方面,两者差不多,H3 甚至更快一点。
如果只看这次测试,我的感受是:Seedance 2.0 Fast 不是每一条都最“炸”,但它更稳、更真实,尤其适合需要反复出片、需要控制返工成本的内容生产场景。
H3 值得欣赏的是它对参考图和提示词的包容度更高一些。在需要尽量贴合参考素材,或者希望少遇到输入限制的场景里,它会更顺手。
所以我的结论不是简单地说谁完全压过谁,而是:
-
Seedance 2.0 Fast 更适合追求连贯稳定、真实、可剪辑、可交付的场景;
-
MiniMax H3 更适合重视参考图兼容度、提示词自由度的场景。