文章标签:Kafka、消息队列、大数据、中间件、分布式
阅读难度:零基础入门
一、前言:为什么要学Kafka?
在当下分布式微服务架构、大数据实时计算的技术生态中,消息队列是必不可少的核心中间件。而 Apache Kafka 凭借高吞吐、低延迟、高可用、持久化存储、可流式处理的优势,成为互联网大厂实时数据传输、日志采集、服务解耦的首选中间件。
相比于RabbitMQ、RocketMQ,Kafka最大的特点是主打高并发、海量日志、实时数据流,广泛应用于日志分析、实时计算、系统削峰、服务异步解耦等场景。
本文将从零开始,带你彻底搞懂Kafka的核心架构、核心概念、工作原理、分区副本机制、投递策略及实战场景,全程干货无废话,适合收藏复盘!
二、Kafka是什么?核心定位
Kafka 是 Apache 基金会下的一款分布式、分区化、可复制的流式消息队列/分布式流处理平台,使用 Scala+Java 开发。
核心定位:实时数据流的存储、传输与处理
三大核心能力:
-
消息队列:实现服务解耦、异步通信、流量削峰
-
数据存储:持久化消息日志,支持海量数据落地
-
流式处理:配合Flink/Spark实现实时计算
三、Kafka整体架构(重点!附架构图)
先看懂整体架构,再学细节事半功倍。Kafka的整体架构非常清晰,核心由5大角色组成。
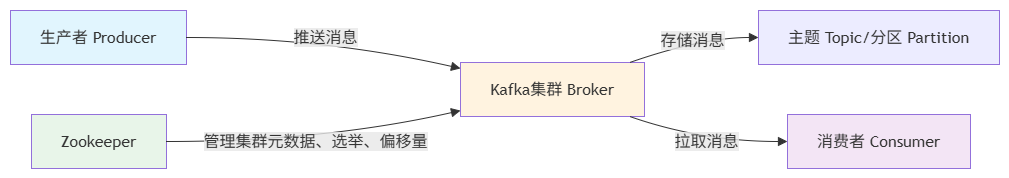
3.1 五大核心角色详解
1. Producer(生产者)
消息的发送方,负责向Kafka集群的指定Topic推送消息,支持批量发送、异步发送、分区策略路由。
2. Consumer(消费者)
消息的接收方,主动从Kafka集群拉取消息消费,支持消费者组模式,实现负载均衡。
3. Broker(服务节点)
Kafka的服务节点,一个Kafka集群由多个Broker组成。每个Broker独立处理读写请求、存储消息数据,无主从区分(新版本)。
4. Topic(主题)
消息的逻辑分类,生产者向指定Topic发消息,消费者订阅指定Topic消费消息。Topic是逻辑概念,不存储数据,数据存储在分区中。
5. Zookeeper(协调组件)
负责管理Kafka集群元数据、Broker状态监控、Leader副本选举、消费者偏移量管理、集群负载均衡等。(Kafka 2.8+ 支持KRaft,可脱离ZK运行)
四、Kafka核心概念(面试高频)
4.1 Partition 分区
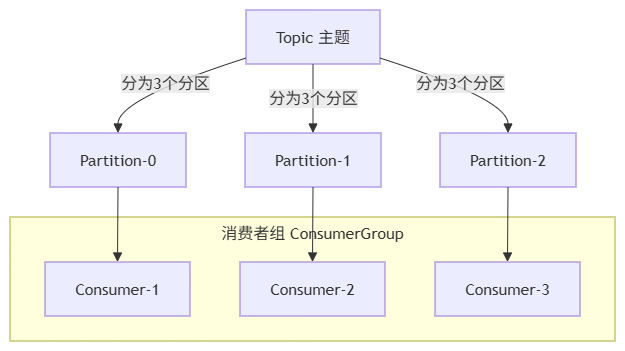
Topic的物理拆分单元,一个Topic可以分为多个Partition,分区是Kafka并发、高吞吐的核心关键。
核心特点:
-
分区内消息有序,分区之间无序
-
分区数量决定Topic的最大并发消费能力
-
每个分区只会被同一个消费者组内的一个消费者消费
4.2 Replica 副本
为了保证高可用,每个分区会配置多个副本,分为Leader副本 和 Follower副本。
-
Leader副本:负责处理所有读写请求
-
Follower副本:被动同步Leader数据,不处理客户端请求,Leader宕机后自动选举新Leader
4.3 Offset 偏移量
分区内消息的唯一序号,是消费者消费消息的标记。消费者每次消费完消息后,会提交Offset,记录当前消费到的位置,重启后可继续消费,不会重复/漏消费。
4.4 ConsumerGroup 消费者组
多个消费者组成一个消费者组,组内消费者互斥消费(一条消息只会被组内一个消费者消费),组间消费者独立消费(广播效果)。
五、Kafka消息投递与存储原理
5.1 消息发送流程
生产者创建消息,指定Topic、消息内容、key
根据分区策略(key哈希/轮询/随机)选择目标分区
消息先写入生产者缓冲区,批量打包发送
Broker接收消息,写入对应分区日志文件
返回ACK确认,生产者确认发送成功
5.2 ACK应答机制(面试重点)
Kafka提供三种ACK机制,适配不同可靠性场景:
-
acks=0:生产者发送后无需等待ACK,吞吐量最高,可靠性最低,可能丢消息
-
acks=1(默认):等待Leader副本写入成功即返回ACK,兼顾性能与可靠性
-
acks=-1/all:等待Leader+所有Follower副本同步完成后返回ACK,可靠性最高,性能最低
5.3 消息持久化机制
Kafka所有消息都会持久化到磁盘,而非内存缓存。消息以日志分段文件(log-segment)存储,默认保留7天,过期自动清理。支持消息回溯消费,只要消息未过期,消费者可通过修改Offset重新消费历史数据。
六、Kafka高可用机制
Kafka通过分区副本机制 + Leader选举机制实现集群高可用。
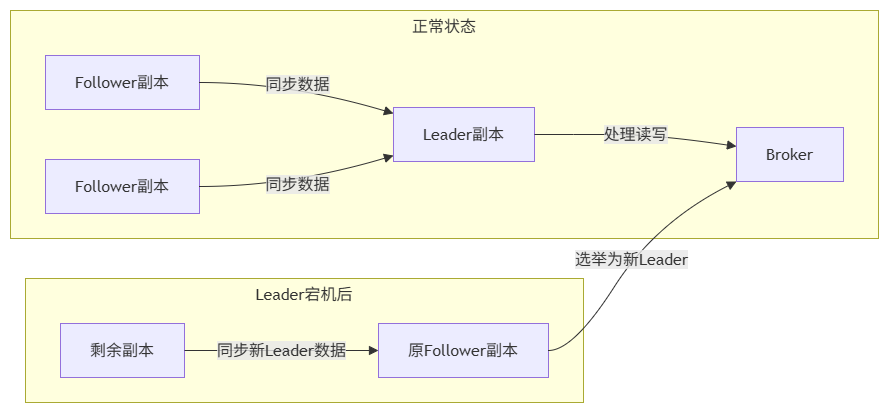
当Leader副本所在Broker宕机,ZK会感知节点状态,触发副本选举,从存活的Follower副本中选出新的Leader,集群无需停机,实现7*24高可用。
-
ISR = In-Sync Replicas 同步副本集合 与 Leader 副本保持数据同步的副本列表,Leader 自身一定在 ISR 内。 判断标准:在 replica.lag.time.max.ms(默认 30s)内持续拉取 Leader 最新消息,没有长时间滞后。
-
OSR = Out-of-Sync Replicas 失步 / 落后副本集合 同步严重滞后于 Leader 的 Follower 副本。 成因:网络卡顿、Broker GC、磁盘 IO 繁忙,长时间无法追上 Leader。
-
AR (所有分配副本) = ISR + OSR
正常稳定状态:OSR 为空,AR=ISR+OSR
七、Kafka核心应用场景
7.1 服务解耦
微服务之间通过Kafka通信,无需直接调用接口,上下游服务完全解耦,一方服务宕机不影响另一方。
7.2 流量削峰
秒杀、大促等高并发场景,瞬时流量巨大,通过Kafka缓存请求消息,消费者匀速消费,避免后端服务被打垮。
7.3 日志采集与分析
后端服务、Nginx、APP端的海量日志统一推送至Kafka,再由Flink/Spark实时消费分析,实现日志监控、异常告警、用户行为分析。
7.4 实时数据同步
数据库Binlog日志同步、数据仓库实时入仓、跨系统数据同步等场景。
八、Kafka vs RabbitMQ vs RocketMQ 对比
|
Kafka |
高吞吐、海量数据、持久化、流式处理 |
不严格保证消息有序、延迟略高 |
日志采集、实时计算、大数据场景 |
|
RabbitMQ |
延迟低、可靠性高、路由灵活 |
吞吐低,不适合海量数据 |
业务消息投递、订单、通知场景 |
|
RocketMQ |
高吞吐、高可靠、支持事务消息 |
社区生态略弱于Kafka |
电商业务、金融业务、高可靠业务场景 |
九、Kafka如何保证消息可靠性(面试必问)
在消息队列的实际生产场景中,可靠性主要解决三个问题:消息不丢失、消息不重复消费、消息不乱序。Kafka 通过「生产者保障 + 集群存储保障 + 消费者保障」三层机制,完整实现消息高可靠投递。
9.1 如何保证消息不丢失
消息丢失分为三个阶段:生产者发送阶段丢失、Broker 存储阶段丢失、消费者消费阶段丢失,Kafka 针对性解决。
1. 生产者端:防止发送丢失
-
关闭acks=0模式:不使用无应答发送,避免消息发送出去但Broker未落地导致丢失。
-
开启重试机制 retries:网络抖动、临时异常时自动重试发送,规避瞬时网络问题。
-
使用acks=1 / acks=all:核心业务使用 acks=all,必须等Leader和所有Follower副本同步完成才返回成功,杜绝Leader刚写入就宕机丢数据。
-
捕获回调异常:业务代码中添加send回调,异常消息手动落库、补发,避免静默丢失。
2. Broker服务端:防止存储丢失
-
分区副本机制:每个分区配置多个副本,数据多节点冗余存储,单节点宕机不丢数据。
-
Leader选举机制:Leader宕机后,ISR同步列表中的Follower立刻升级为新Leader,保证数据可用性。
-
禁止未同步副本参与选举:仅ISR列表内的副本可参选Leader,保证新Leader拥有最全数据。
-
持久化落盘机制:消息默认落地磁盘,而非纯内存缓存,重启不丢失。
3. 消费者端:防止消费丢失
-
核心原因:自动提交offset模式下,程序还没消费完,offset已提交,重启后跳过消息,造成“消息丢失”。
-
解决方案:关闭自动提交 enable-auto-commit=false,业务消费成功后手动提交offset。
9.2 如何保证消息不重复消费
Kafka不保证 Exactly-Once 原生语义,网络重试、消费者重启、rebalance 都会导致消息重复消费,业务层需要幂等保障。
常用幂等方案:
-
全局唯一Key幂等:每条消息携带唯一业务ID,消费前查询数据库/Redis是否已处理,存在则直接跳过。
-
Kafka生产者幂等:开启 idempotent=true,解决生产者重试导致的消息重复写入。
-
事务消息:跨分区、跨会话场景使用Kafka事务,实现精准一次投递。
9.3 如何保证消息有序性
-
全局无序、分区有序:Kafka 仅能保证 同一个分区内消息有序,多分区无法保证全局有序。
-
有序场景解决方案:需要有序的业务数据,通过 固定key哈希 路由到同一个分区,保证消息顺序消费。
-
消费有序保障:单分区只能被一个消费者消费,规避多线程并发乱序问题。
9.4 生产级可靠性最佳配置总结
生产者可靠配置:
-
acks=all
-
retries=3
-
开启幂等性 idempotent=true
消费者可靠配置:
-
enable-auto-commit=false(手动提交)
-
业务成功后再提交offset
-
业务层实现幂等消费
集群可靠配置:
-
副本数 replication-factor >=2
-
最小同步副本数 min.insync.replicas >=2
十、其他常见面试题总结(高频)
Kafka为什么速度快? 答:顺序磁盘读写、批量发送、零拷贝技术、分区并发、页缓存机制。
Kafka分区有序、全局无序怎么理解? 答:单个分区内消息先进先出有序,多个分区之间无法保证全局有序。
消费者组的作用? 答:实现消费负载均衡,提高消费并发能力,实现消息广播/单播。
Kafka如何保证消息不丢不重复? 答:通过副本机制+acks机制保证不丢;通过手动提交offset、幂等性消费保证不重复。
十一、总结
本文完整梳理了Kafka的架构、核心概念、工作原理、高可用机制、场景与对比,覆盖了入门学习和面试的核心知识点。
简单总结Kafka的核心优势:高吞吐适合海量数据、持久化可回溯、分布式高可用、适配大数据实时流式计算,是目前大数据、后端开发必备的中间件技能。
后续会更新Kafka环境搭建、Java代码实战、调优方案、故障排查教程,感兴趣可以关注收藏!
十二、SpringBoot整合Kafka实战(极简可运行)
前面我们掌握了Kafka的理论架构、核心原理与高可用机制,本节带来SpringBoot + Kafka 极简实战代码,包含Maven依赖、YAML配置、生产者发送消息、消费者监听消息完整代码,开箱即用,直接部署即可测试。
环境版本说明:SpringBoot 2.7.x / Kafka 2.x 集群,适配绝大多数企业项目环境。
11.1 引入Maven依赖
在pom.xml中引入SpringBoot整合Kafka的核心依赖,无需额外冗余包:
<!– springboot整合kafka核心依赖 –>
<dependency>
<groupId>org.springframework.kafka</groupId>
<artifactId>spring-kafka</artifactId>
</dependency>
11.2 application.yaml 完整配置
配置Kafka集群地址、生产者参数、消费者参数,适配生产级基础配置,兼顾性能与可靠性:
spring:
kafka:
# kafka集群地址,多个节点用逗号分隔
bootstrap-servers: 127.0.0.1:9092
# 生产者配置
producer:
# 消息发送应答机制,默认1,兼顾性能和可靠性
acks: 1
# 发送失败重试次数
retries: 3
# 批量发送消息大小
batch-size: 16384
# 缓冲区内存大小
buffer-memory: 33554432
# key、value序列化方式
key-serializer: org.apache.kafka.common.serialization.StringSerializer
value-serializer: org.apache.kafka.common.serialization.StringSerializer
# 消费者配置
consumer:
# 默认消费者组
group-id: default-group
# 开启自动提交offset
enable-auto-commit: true
# 自动提交offset时间间隔
auto-commit-interval: 1000
# 首次消费策略:latest(消费最新消息) / earliest(消费历史未消费消息)
auto-offset-reset: earliest
# key、value反序列化方式
key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
value-deserializer: org.apache.kafka.common.serialization.StringDeserializer
11.3 Kafka消息生产者代码
封装通用消息发送工具类,支持发送普通字符串消息,代码简洁、可直接复用:
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.stereotype.Component;
import javax.annotation.Resource;
/**
* Kafka消息生产者
*/
@Component
public class KafkaProducerService {
// 注入kafka模板工具类
@Resource
private KafkaTemplate<String, String> kafkaTemplate;
/**
* 发送普通消息
* @param topic 主题名称
* @param message 消息内容
*/
public void sendMessage(String topic, String message) {
// send方法异步发送消息
kafkaTemplate.send(topic, message);
}
/**
* 发送带key的消息(key用于分区路由)
* @param topic 主题
* @param key 消息key
* @param message 消息内容
*/
public void sendMessageWithKey(String topic, String key, String message) {
kafkaTemplate.send(topic, key, message);
}
}
11.4 Kafka消息消费者监听代码
通过 @KafkaListener 注解实现消息监听,订阅指定Topic,实时消费消息,企业最常用写法:
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.springframework.kafka.annotation.KafkaListener;
import org.springframework.stereotype.Component;
/**
* Kafka消息消费者
*/
@Component
public class KafkaConsumerListener {
/**
* 监听指定topic消息
* @param record 消费消息记录
*/
@KafkaListener(topics = "test-topic")
public void listen(ConsumerRecord<String, String> record) {
// 获取消息主题、分区、偏移量、消息内容
String topic = record.topic();
String value = record.value();
long offset = record.offset();
// 业务消费逻辑
System.out.println("Kafka消费成功:");
System.out.println("主题:" + topic);
System.out.println("偏移量:" + offset);
System.out.println("消息内容:" + value);
}
}
11.5 测试接口(验证收发消息)
编写测试接口,启动项目后调用接口,即可完成消息发送与消费测试:
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;
import javax.annotation.Resource;
@RestController
public class KafkaTestController {
@Resource
private KafkaProducerService kafkaProducerService;
@GetMapping("/kafka/send")
public String sendMsg(@RequestParam String msg) {
// 向test-topic主题发送消息
kafkaProducerService.sendMessage("test-topic", msg);
return "消息发送成功!内容:" + msg;
}
}
11.6 实战测试步骤
本地启动Kafka服务,保证 127.0.0.1:9092 服务正常运行;
启动SpringBoot项目,自动加载Kafka配置、注册监听;
访问接口 http://localhost:8080/kafka/send?msg=hello kafka;
查看控制台,可打印出消费日志,证明收发消息成功。
11.7 代码核心说明
-
消息发送:基于KafkaTemplate异步发送,性能高效,支持重试机制,保证消息发送可靠性;
-
消息监听:@KafkaListener是SpringBoot封装的核心注解,简化消费者开发;
-
Offset提交:配置自动提交,适合普通业务;金融、订单等精准业务可改为手动提交Offset;
-
分区路由:带key的消息会根据key哈希路由到固定分区,保证同key消息有序。