如果你在用 OpenAI、Anthropic、Gemini、Bedrock 多家 LLM,迟早会撞到三个问题:API Key 散落各处、某家挂了得手动切、预算没法按团队分账。Bifrost 就是来解决这三件事的——一个进程跑起来,给你一个统一的 OpenAI 兼容入口,背后挂多少家 Provider 都行。
这篇教程走完一遍:从 Docker 部署到腾讯轻量云主机、添加 Provider、配 Routing Rules、建 Virtual Keys,到最后用 base_url + key 把任意 OpenAI/Anthropic SDK 接进来。
一、Bifrost 是什么
Bifrost 是 Maxim HQ 开源的高性能 AI Gateway,Go 写的,Apache 2.0 协议,GitHub 仓库在 maximhq/bifrost。它做的事可以用一句话说清:
把 23+ 家 LLM Provider 塞到一个 OpenAI 兼容的 HTTP API 后面,让你换模型像换函数参数一样简单。
几个关键事实:
- 统一入口:所有 Provider 走 /v1/chat/completions 一个端点,请求/响应格式严格对齐 OpenAI 规范
- 23+ Provider:OpenAI、Anthropic、AWS Bedrock、Google Vertex、Azure、Cerebras、Cohere、Mistral、Ollama、Groq、OpenRouter、vLLM……
- 零配置启动:拉镜像就跑,没有 Provider 也能起来,配置全在 Web UI 里点
- Gateway 形态 + Go SDK 形态:HTTP 适合多语言接入,Go SDK 适合嵌入 Go 应用做内嵌部署
- < 100 µs 开销:5,000 RPS 压测下平均增加 11 µs 延迟(官方数据,t3.xlarge)
- 6.9k stars:社区已经在跑生产
一句话定位:Bifrost 是 LLM 层的 Nginx。Nginx 把后端服务统一到 HTTP 入口,Bifrost 把多家 LLM 统一到 OpenAI 入口。
架构总览: 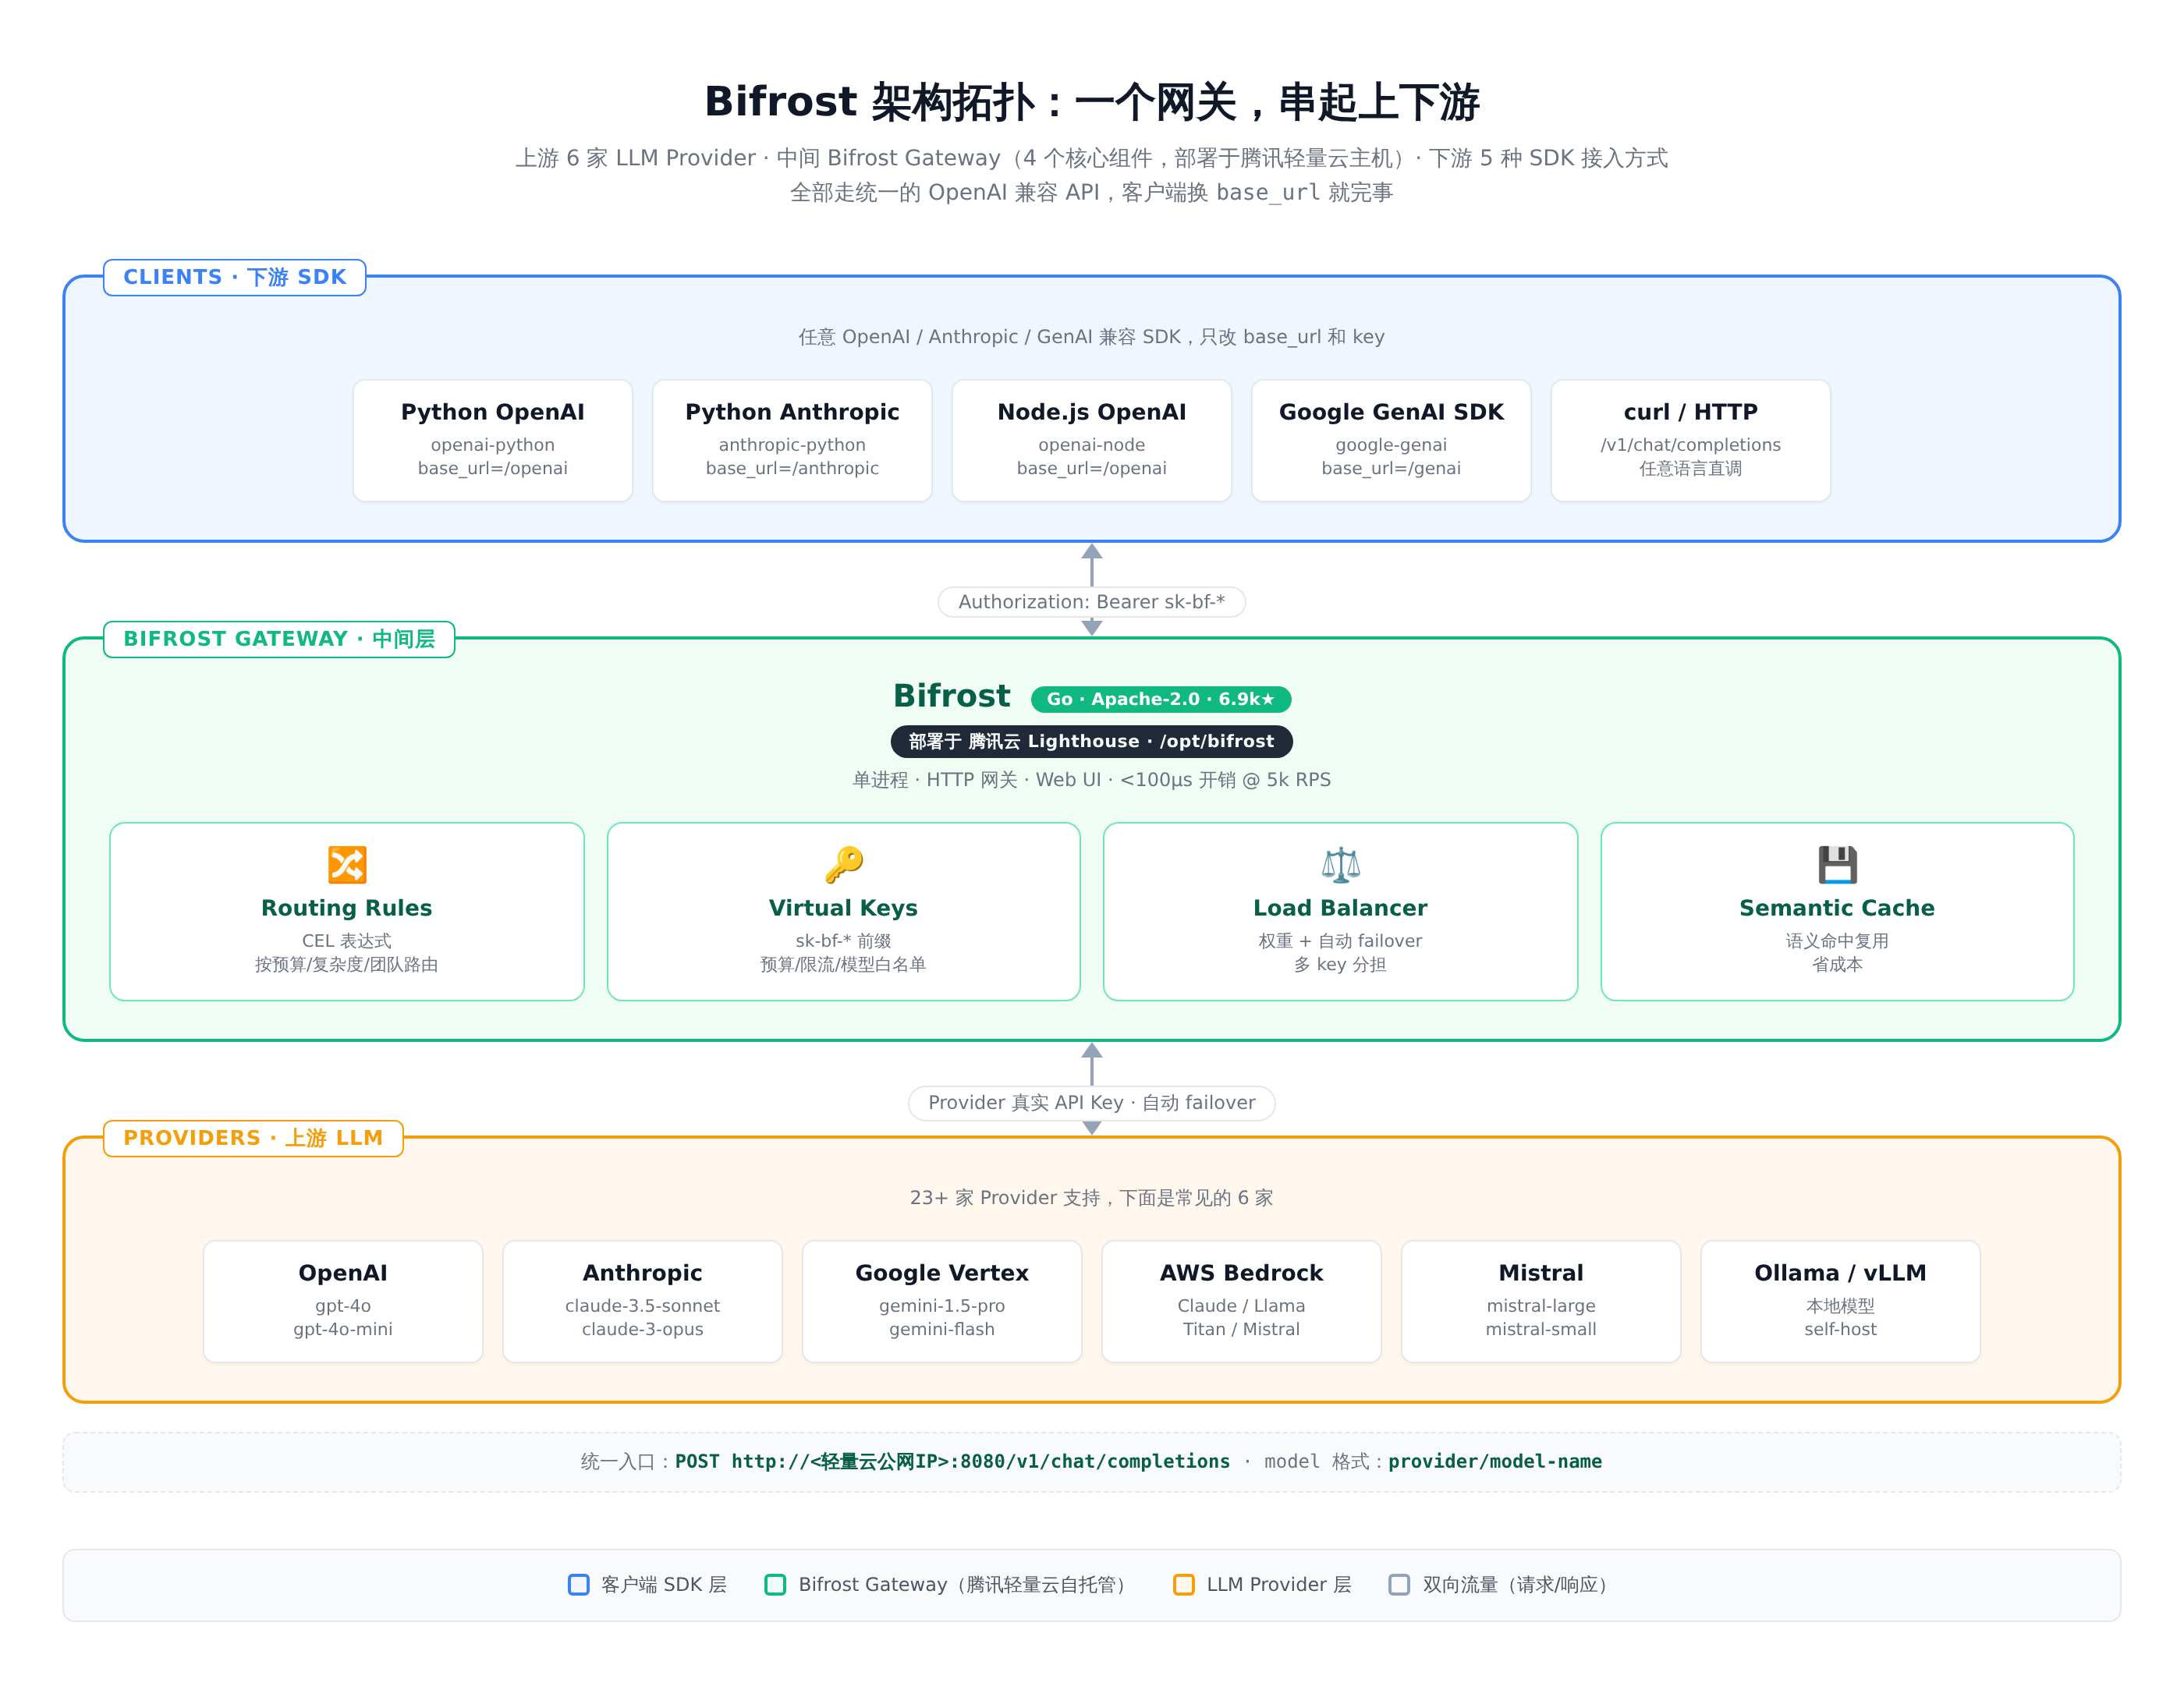
上图展示了本教程要搭建的完整链路——上游 6 家 LLM Provider,中间是部署在腾讯轻量云主机上的 Bifrost Gateway(含 Routing Rules / Virtual Keys / Load Balancer / Semantic Cache 四个核心组件),下游是 5 种 SDK 接入方式。所有调用走统一的 http://<轻量云公网IP>:8080/v1/chat/completions 入口,客户端换 base_url 就完事。
二、为什么选择 Bifrost
LLM Gateway 这个赛道不是没有别的选项——LiteLLM 是最常见的那个。Bifrost 值得一试的理由有四条:
1. 性能是硬指标
官方数据 50x faster than LiteLLM(5k RPS 下 11 µs vs LiteLLM 的几百 µs 级别)。Go + 单进程架构,相比 Python 写的 LiteLLM 在高并发下延迟稳定得多。如果你的 QPS 已经压到 LiteLLM 开始抖,Bifrost 是直接的升级路径。
2. 零配置 + Web UI
启动不需要写 YAML,不背 config 文件。Docker 起来就是一个 Web 控制台——加 Provider、配 Key、设预算、看日志,全在 UI 里。配完了再决定要不要落成 config.json 做 GitOps。
3. Governance 是原生设计,不是后加的
Virtual Keys(虚拟密钥)、Teams、Customers、Budgets、Rate Limits——这些是企业级多团队共用的核心能力,Bifrost 在第一版就有,不是社区 PR 加的补丁。一个 Key 一个预算一个限流一个 allowed models 列表,给团队发 Key 这件事终于不用自己拿表格记。
4. Drop-in Replacement
你的代码已经在用 OpenAI SDK?换 base_url 就行,不用改一行业务代码。Anthropic SDK、Google GenAI SDK、LangChain、LiteLLM SDK 都有对应的 drop-in 路径。
反过来说,什么时候不要选 Bifrost:
- 只用一家 Provider(OpenAI 重度用户)——直接用官方 SDK 更省事
- 你的团队是 Python 重度用户,且对延迟不敏感——LiteLLM 也够用
- 想要纯 SDK 嵌入不走 HTTP——Bifrost 虽然有 Go SDK,但你如果不是 Go 项目意义不大
三、横向对比:Bifrost 与同类项目
LLM Gateway/中转站这个赛道不止 Bifrost 一家。在你决定用 Bifrost 之前,至少应该看一眼这几个最常见的同类项目,理解它们各自的定位差异——选错工具的代价比不选工具更高。
3.1 速览对比表
| Bifrost | Go | Apache 2.0 | 高性能生产级 Gateway | <100µs 延迟、CEL 动态路由、复杂度自动识别 | 生产级、对延迟敏感的多 Provider 场景 |
| LiteLLM | Python | MIT | 开发者友好的 LLM Proxy + SDK | Python 生态深、100+ Provider、文档好 | Python 项目、开发期调试、对延迟不敏感 |
| One-API | Go | MIT | API Key 管理中转站 | 老牌(15k+ stars)、稳定、UI 简洁 | 个人/小团队 key 聚合管理 |
| New-API | Go | MIT | One-API 衍生 + 商业化能力 | 充值码、按量计费、渠道健康检测 | 想搭小型 API 中转 SaaS |
| OpenRouter | SaaS | 闭源 | 商业 API 聚合 SaaS | 零部署、按 token 付费、含免费模型 | 不想自托管、要快速接入 |
注:sub-api 等 One-API 衍生项目(New-API、Sub-API 等)共享同一类定位——以"渠道管理 + key 分发 + 计费"为核心,Bifrost 在这一维度上不如它们完整,但路由策略和性能远远超出。下面对比会拆开讲。
3.2 关键差异:Gateway vs 中转站
One-API / New-API / Sub-API 这一系本质是"API 中转站":它们的核心设计目标是"把多个上游 Provider 的 Key 聚合起来,给下游用户分发"——重点是分发和计费,路由策略是配角。
- 渠道(Channel)= 上游 Provider + Key
- 令牌(Token)= 给下游用户发的虚拟 Key
- 核心功能:充值、计费、用量统计、渠道健康检测、令牌管理
Bifrost 是"Gateway":核心设计目标是"在多 Provider 之间做高性能路由决策"——重点是路由和治理,计费是配角。
- Provider = 上游 + Key
- Virtual Key = 给下游的虚拟 Key
- 核心功能:CEL 动态路由、复杂度识别、自动 failover、负载均衡、Virtual Key 治理
这个定位差异在选型时是第一判断点:如果你的需求是"我要做一个小型 API 转售 SaaS,给每个用户充钱、按 token 计费、有充值码"——选 New-API,Bifrost 在这件事上做不好也不打算做好。如果你的需求是"我有 5 个 LLM Provider,要让生产应用的高 QPS 请求在它们之间智能路由、自动 failover、按团队分预算"——选 Bifrost,New-API 在这件事上做不深。
3.3 路由策略深度对比
| 直接路由(model 前缀选 Provider) | ✅ | ✅ | ✅ |
| 权重负载均衡 | ✅ | ✅ | ✅ |
| 自动 failover | ✅ | ✅ | New-API ✅ / One-API ❌ |
| 静态按团队路由 | ✅ Governance Routing | ✅ Router Rules | ✅ 分组 |
| 动态 CEL 表达式路由 | ✅ 独家 | ❌ | ❌ |
| 按复杂度自动路由 | ✅ 独家 | ❌ | ❌ |
| 按预算阈值切换 | ✅ | ❌ | ❌ |
| 按 Header/参数路由 | ✅ | ✅ 部分 | ❌ |
Bifrost 在路由策略上的差异化主要在 CEL 表达式和复杂度识别——这两条是其他项目都没有的。如果你只是想"OpenAI 挂了切 Anthropic",One-API/New-API 也够;如果你想"REASONING 复杂度的请求走 Claude Sonnet,SIMPLE 的走 GPT-4o-mini,并且 OpenAI 预算超 80% 自动切"——只有 Bifrost 能做。
3.4 Virtual Key 治理对比
| 虚拟 Key 发放 | ✅ sk-bf-* | ✅ | ✅ Token |
| 按 Key 限流 | ✅ RPM/TPM 双限 | ✅ | ✅ |
| 按 Key 预算 | ✅ 美元预算 + 重置周期 | ✅ | ✅ 充值额度 |
| 按 Key 限模型 | ✅ allowed_models | ❌ | ✅ 模型分组 |
| 按 Key 路由策略 | ✅ provider_configs + Routing Rules | ❌ | ✅ 分组 |
| 按 Key 设过期时间 | ✅ 30min-7d + 自定义 | ✅ | ✅ |
| 充值码 / 钱包 | ❌ | ❌ | ✅ 独家 |
| 按客户/团队组织 | ✅ Team + Customer | ❌ | ✅ 分组 |
Bifrost 在治理上更偏企业多团队:Team、Customer、Virtual Key 三层组织结构是原生设计。New-API 更偏 SaaS 化运营:充值、钱包、计费模型更完整。两者方向不同。
3.5 选型建议(按场景)
场景 1:个人/小团队,3-5 人共用,主要想统一管 Key、看用量 → 选 One-API 或 New-API。简单、稳定、UI 清晰,能解决 80% 问题。Bifrost 对你来说性能过剩、路由策略过剩。
场景 2:想搭一个 API 中转 SaaS,给外部用户充值付费 → 选 New-API。充值码、按量计费、用户钱包这些商业化能力是它的差异化。Bifrost 在这件事上不打算做。
场景 3:生产级应用,高 QPS,多 Provider,需要智能路由和自动 failover → 选 Bifrost。CEL 动态路由、复杂度识别、<100µs 延迟这些能力其他项目都没有。LiteLLM 也能用但延迟和稳定性差一档。
场景 4:Python 项目,开发期调试,对延迟不敏感 → 选 LiteLLM。Python 生态深、文档好、Provider 覆盖广,开发期最快上手。生产上线再看要不要换 Bifrost。
场景 5:完全不想自托管,按 token 付费给商业服务 → 选 OpenRouter。零部署,但放弃了对 Provider Key 的控制权和数据流过的链路。
Bifrost 真正的甜蜜点是:生产级 + 多 Provider + 对延迟和路由策略有要求。在这个甜蜜点内,它确实是目前最好的选择。出了这个甜蜜点,其他项目可能更合适。
四、在腾讯轻量云主机上部署 Bifrost
Bifrost 是单进程 Go 服务,对资源消耗很轻——2 核 2G 的轻量云主机就能跑起来。这一节用腾讯云轻量应用服务器(Lighthouse)+ Ubuntu Server 22.04 LTS 走一遍完整部署流程。其他 Linux 主机(CVM / 阿里云 / 自建)流程基本一致,跳过 4.1 直接从 4.2 开始即可。
4.1 在腾讯轻量云主机上准备环境
实例规格推荐:
购买入口:腾讯云控制台 → 轻量应用服务器 → 新建实例 → 镜像选 Ubuntu Server 22.04 LTS 64位,地区选离你最近的(国内用户选广州 / 北京 / 上海)。计费方式选包年包月(长期跑)或按量计费(短期测试)。
开放 8080 端口:
实例创建后默认只开了 SSH(22) 和部分常用端口,Bifrost 要用的 8080 需要手动放行:
轻量云的"防火墙"是边界防火墙,相当于云主机对外的第一道关;实例内的 ufw / iptables 是第二道。生产部署时两层都要看:sudo ufw allow 8080/tcp 确保系统层放行。如果你用 CVM 而不是轻量云,对应的概念叫"安全组"而不是"防火墙"。
SSH 连接 + 安装 Docker:
腾讯云控制台有一键 WebShell,但本地 SSH 体验更好:
# 在你本地终端
ssh ubuntu@<你的公网 IP>
# 默认密钥登录;首次需在控制台重置密码或上传公钥
进入实例后装 Docker(官方一键脚本,含 docker compose plugin):
curl -fsSL https://get.docker.com | sudo sh
sudo usermod -aG docker $USER
newgrp docker
docker –version && docker compose version
配置腾讯云镜像加速(重要,不然拉 Bifrost 镜像会慢到怀疑人生):
sudo tee /etc/docker/daemon.json <<EOF
{
"registry-mirrors": ["https://mirror.ccs.tencentyun.com"]
}
EOF
sudo systemctl restart docker
docker info | grep -A 2 "Registry Mirrors"
mirror.ccs.tencentyun.com 是腾讯云内网 Docker 镜像加速——走内网不消耗公网流量,国内拉镜像速度可以飙到 50 MB/s+。
4.2 一行命令版(先跑起来)
docker run -d –name bifrost -p 8080:8080 maximhq/bifrost
10 秒后浏览器打开 http://<轻量云公网 IP>:8080(在 Lighthouse 控制台 → 实例详情 → 公网 IP 复制),看到 Bifrost 的 Web 控制台,部署完成。
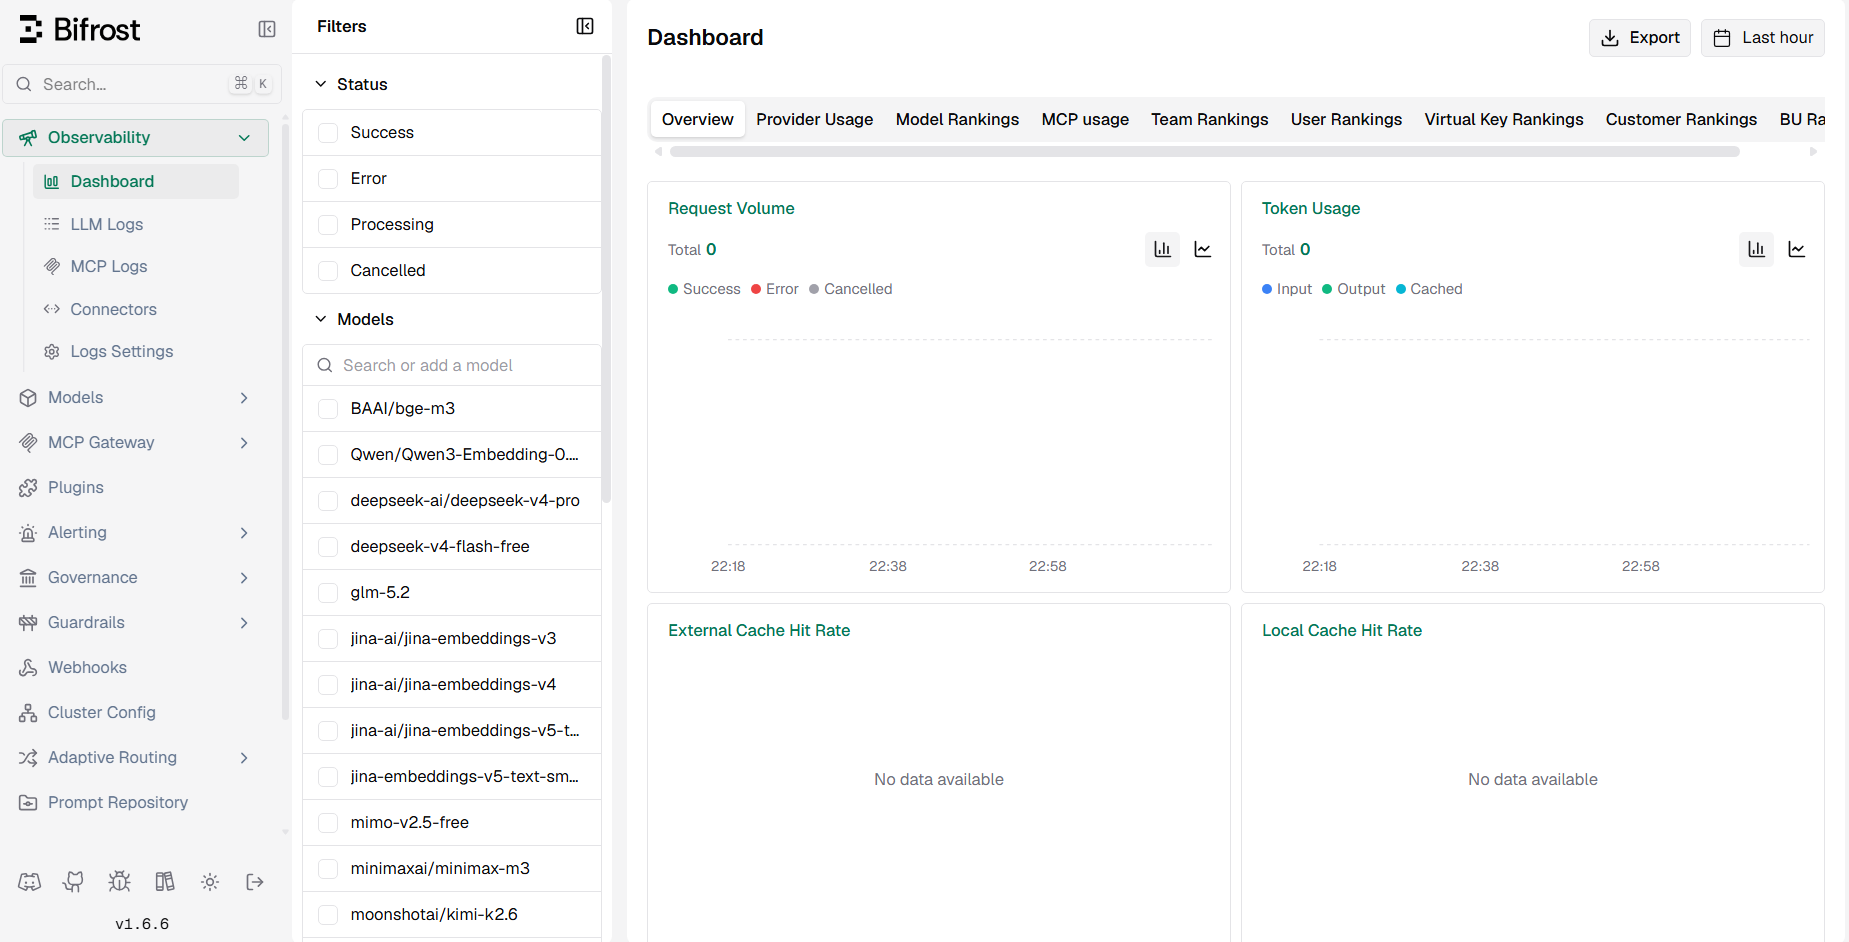
但这样跑有个问题——容器删了配置就丢了。生产用必须挂 volume。
4.3 带数据持久化的版本(推荐)
# 在你打算长期存放配置的目录里
mkdir -p ./bifrost-data
docker run -d \\
–name bifrost \\
-p 8080:8080 \\
-v $(pwd)/bifrost-data:/app/data \\
-e LOG_LEVEL=info \\
-e LOG_STYLE=pretty \\
–restart unless-stopped \\
maximhq/bifrost
关键参数说明:
| -p 8080:8080 | 把容器 8080 端口暴露到宿主机 |
| -v $(pwd)/bifrost-data:/app/data | 把宿主机的 ./bifrost-data 挂载为 Bifrost 的 app-dir——所有 config.json、config.db、logs.db 都在这下面 |
| -e LOG_LEVEL=info | 日志级别(debug/info/warn/error) |
| -e LOG_STYLE=pretty | 日志风格(pretty 适合人看,json 适合收集) |
| –restart unless-stopped | 容器挂了自动拉起,但手动 stop 不会 |
指定版本(生产建议锁版本,别用 latest):
docker pull maximhq/bifrost:v1.3.9
docker run -d –name bifrost -p 8080:8080 -v $(pwd)/bifrost-data:/app/data maximhq/bifrost:v1.3.9
4.4 docker compose 版(适合长期维护)
在 ./bifrost-data 同级目录建一个 docker-compose.yml:
version: "3.9"
services:
bifrost:
image: maximhq/bifrost:v1.3.9
container_name: bifrost
ports:
– "8080:8080"
volumes:
– ./bifrost–data:/app/data
environment:
– LOG_LEVEL=info
– LOG_STYLE=pretty
restart: unless–stopped
启动:
docker compose up -d
docker compose logs -f bifrost # 看实时日志
4.5 验证部署
容器起来后,先在 SSH 会话里跑一个不带认证的探测请求(Bifrost 默认不强制 auth):
curl http://localhost:8080/health
# {"status":"ok"}
或者直接打 chat completions(还没配 Provider,会报 401/404,但说明端口通了):
curl -X POST http://localhost:8080/v1/chat/completions \\
-H "Content-Type: application/json" \\
-d '{
"model": "openai/gpt-4o-mini",
"messages": [{"role": "user", "content": "ping"}]
}'
再从你本地机器打公网 IP 验证轻量云防火墙 + Bifrost 都放行了:
curl http://<轻量云公网 IP>:8080/health
# 本地返回 {"status":"ok"} 就说明外部可访问
如果本地打不通但 SSH 内能通——99% 是轻量云防火墙没放行 8080,回 4.1 第三步检查。
看到 “no provider configured” 之类的报错就对了——下一步加 Provider。
五、在 Lighthouse 上增加 Provider
Bifrost 配 Provider 有两种姿势:Web UI 适合首次上手,config.json 适合 GitOps 化管理。
5.1 Web UI 方式(推荐首次)
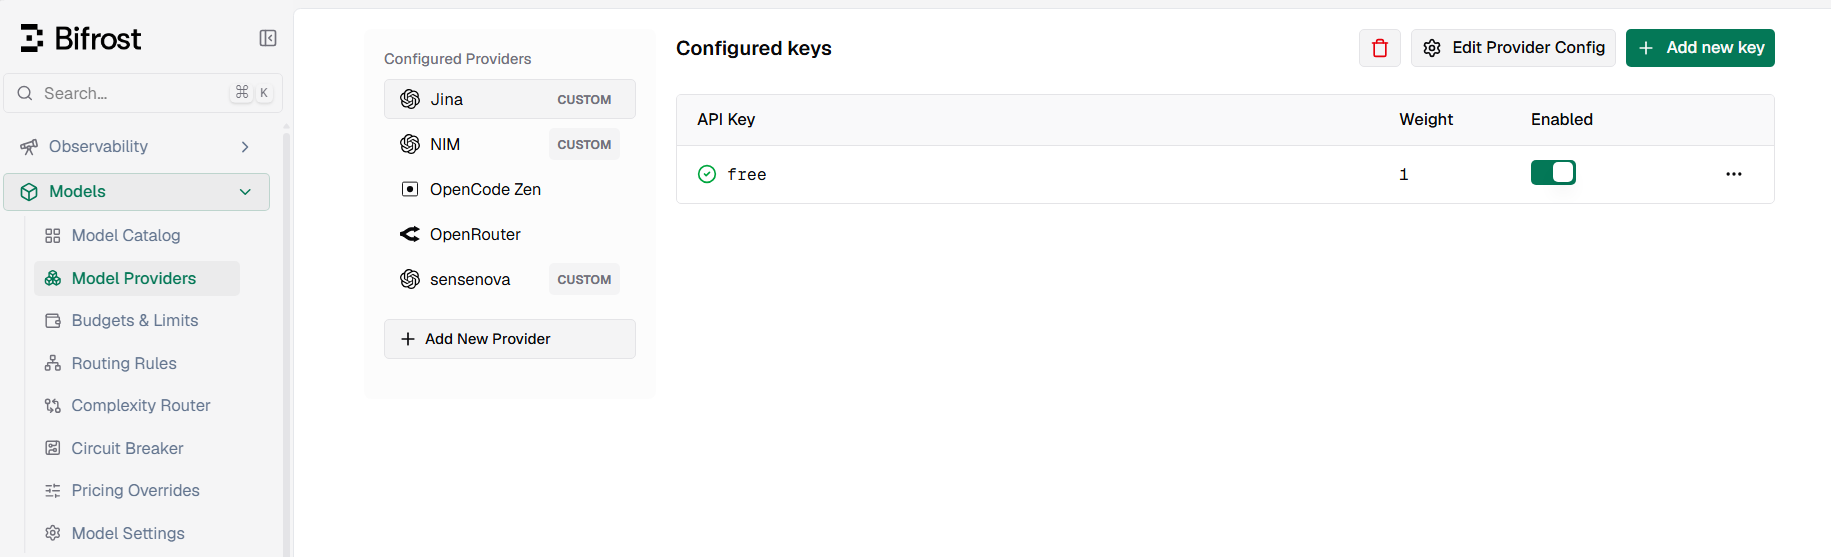
- Name:openai-primary(任意标识,后续 Routing Rules 引用)
- API Key:你的 sk-…(或填 env.OPENAI_API_KEY,让 Bifrost 从环境变量取)
- Models:可以勾选 gpt-4o-mini、gpt-4o、gpt-4-turbo,或者留空让 Bifrost 自动从 /v1/models 拉
- Weight:1.0(多 Key 时的负载权重,单 Key 默认 1.0)
重复这个过程加 Anthropic:
加完两家之后,回到控制台首页能看到两个 Provider 在线,状态都应该是绿色。
5.2 config.json 方式(GitOps)
在 ./bifrost-data/ 下放一个 config.json:
{
"$schema": "https://www.getbifrost.ai/schema",
"providers": {
"openai": {
"keys": [
{
"name": "openai-primary",
"value": "env.OPENAI_API_KEY",
"models": ["gpt-4o-mini", "gpt-4o", "gpt-4-turbo"],
"weight": 1.0
}
]
},
"anthropic": {
"keys": [
{
"name": "anthropic-primary",
"value": "env.ANTHROPIC_API_KEY",
"models": ["claude-3-5-sonnet-20241022", "claude-3-opus-20240229"],
"weight": 1.0
}
]
}
},
"config_store": {
"enabled": true,
"type": "sqlite",
"config": {
"path": "./config.db"
}
}
}
然后让容器读到这两个环境变量:
docker run -d \\
–name bifrost \\
-p 8080:8080 \\
-v $(pwd)/bifrost-data:/app/data \\
-e OPENAI_API_KEY=sk-xxx \\
-e ANTHROPIC_API_KEY=sk-ant-xxx \\
–restart unless-stopped \\
maximhq/bifrost
config.json 和 Web UI 的关系(这个比较绕,必须看清楚):
- config_store.enabled: true(默认)→ 文件作启动种子,UI/API 改的会进 SQLite 数据库;之后通过 UI 改的配置不会回写到 config.json,但会持久化在 DB
- config_store.enabled: false → 文件即唯一真相,UI 配置不可用,改 config.json 必须重启容器
如果你想要 “GitOps + UI 能改” 两边都要,就保持 enabled: true,但理解 config.json 是 bootstrap 不是实时同步源。
5.3 验证 Provider 配置成功
# 列出当前所有 Provider
curl http://localhost:8080/api/providers
# 测试 OpenAI 路由
curl -X POST http://localhost:8080/v1/chat/completions \\
-H "Content-Type: application/json" \\
-d '{
"model": "openai/gpt-4o-mini",
"messages": [{"role": "user", "content": "Hello, Bifrost!"}]
}'
第一次调用成功返回 JSON,说明 Provider 配通了。注意 model 字段的写法:provider/model-name——这个前缀是 Bifrost 路由的依据,省了前缀 Bifrost 会去 Model Catalog 自动找唯一 Provider,但显式写更稳。
六、配置 Routing Rules
加了 Provider 之后,请求怎么走?默认情况下:你写 openai/gpt-4o-mini 就走 OpenAI,写 anthropic/claude-3-5-sonnet 就走 Anthropic——这是直接路由。
但生产场景往往需要更细的控制:
- “复杂任务走 Claude,简单任务走 GPT-4o-mini”
- “OpenAI 预算超 80% 时切到 Anthropic”
- “团队 A 的请求只走 OpenAI,团队 B 只走 Anthropic”
这些就用 Routing Rules。Bifrost 提供两种路由方式:
6.1 Governance-based Routing(静态、配置型)
这是通过 Virtual Key 上的 provider_configs 字段控制的——给某个 VK 配几个 Provider、各自的 weight 和 allowed_models,请求过来按权重切。适合"按团队分账"这种稳定的路由策略。
后面第 7 节创建 Virtual Key 时会看到 provider_configs 字段。
6.2 Dynamic Routing Rules(CEL 表达式、动态型)
这是真正灵活的部分。Bifrost 用 CEL (Common Expression Language) 写动态路由规则,请求过来时实时求值决定走哪个 Provider。
可用的 CEL 变量(常用):
| model / provider | 请求的模型/当前 Provider |
| headers["x-tier"] | 请求头 |
| params["version"] | 查询参数 |
| team_name / customer_id / virtual_key_name | 组织上下文 |
| budget_used / tokens_used / request | 容量指标(0-100 百分比) |
| complexity_tier | 自动分类的复杂度:SIMPLE / MEDIUM / COMPLEX / REASONING |
6.3 创建一条 Routing Rule(API 方式)
假设场景:当 OpenAI 预算用量超过 80%,自动切到 Anthropic。
curl -X POST http://localhost:8080/api/routing-rules \\
-H "Content-Type: application/json" \\
-d '{
"name": "failover-when-openai-budget-high",
"description": "When openai budget_used > 80%, route to anthropic",
"scope": "global",
"priority": 10,
"enabled": true,
"condition": "budget_used > 80 && provider == \\"openai\\"",
"action": {
"provider": "anthropic",
"model": "claude-3-5-sonnet-20241022"
}
}'
字段说明:
- scope:global / customer / team / virtual_key——优先级从低到高
- priority:同 scope 内数值小的先求值
- condition:CEL 表达式,匹配则触发 action
- action.provider / action.model:目标路由
6.4 一个更复杂的例子:按复杂度路由
复杂任务(REASONING)走 Claude Sonnet,简单任务走 GPT-4o-mini。
curl -X POST http://localhost:8080/api/routing-rules \\
-H "Content-Type: application/json" \\
-d '{
"name": "complexity-based-routing",
"scope": "global",
"priority": 20,
"enabled": true,
"condition": "complexity_tier == \\"REASONING\\" || complexity_tier == \\"COMPLEX\\"",
"action": {
"provider": "anthropic",
"model": "claude-3-5-sonnet-20241022"
}
}'
Bifrost 会在路由前先分析 prompt 复杂度(通过长度、关键词、推理密度等启发式判定),然后决定走哪家。这个能力是 Bifrost 区别于其他 Gateway 的核心差异化之一。
6.5 查看和管理规则
# 列出所有规则
curl http://localhost:8080/api/routing-rules
# 删除某条
curl -X DELETE http://localhost:8080/api/routing-rules/{rule_id}
Web UI 也有 Routing Rules 页面,可视化编辑,不需要写 CEL。 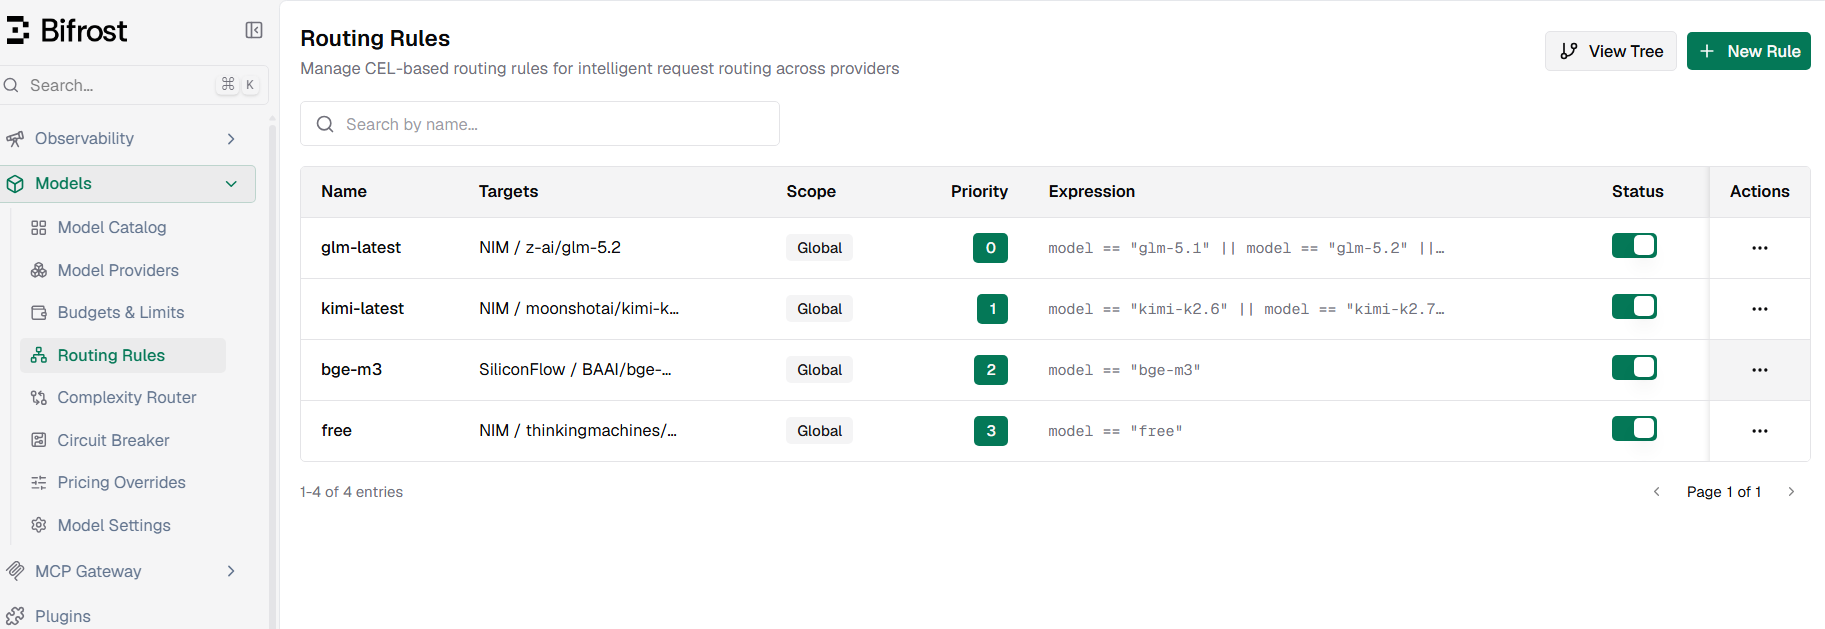
6.6 一个重要细节:作用域优先级
Routing Rules 按 scope 分层求值,先匹配先终止:
VirtualKey scope(最高)→ Team → Customer → Global(最低)
请求带 VK 时:先查 VK scope 的规则,匹配就终止;不匹配再查 Team scope,依此类推。所以你可以在 Global 写默认路由,在 VK scope 写例外——不需要在每条规则里写 if team == …。
七、创建 Virtual Keys
Virtual Key(简称 VK)是 Bifrost 的核心治理单元——发给下游应用或团队的"虚拟 API Key"。一个 VK 上可以挂:允许的 Provider + 模型清单 + 预算 + 限流 + 团队归属。
7.1 为什么需要 Virtual Key
直接把你 OpenAI 的 sk-xxx 发给团队用,问题:
- 没法按团队分账
- 没法限流,有人猛调把额度烧光
- 想换 Provider 要让所有人改 Key
- 想下线某个团队的访问权要全网通知换 Key
VK 解决这一切:你拿 OpenAI 的 Key 在 Bifrost 后端,给前端发 sk-bf-xxx 形式的 VK。要换 Provider?改 VK 的 provider_configs,下游 API 不用改一行。
7.2 Web UI 创建(推荐首次)
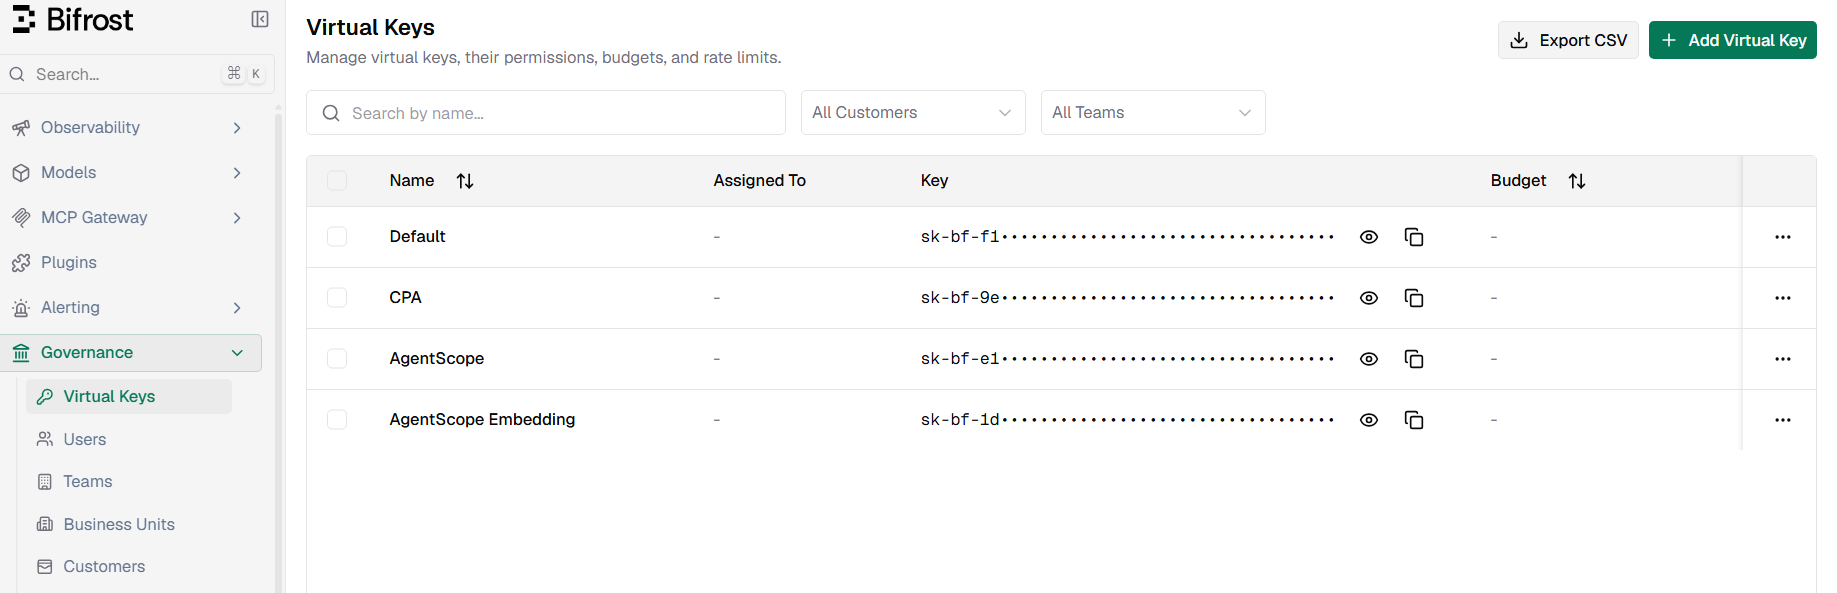
| Name | engineering-api | 标识,便于管理 |
| Max Limit | 100.00 | 月度预算上限(美元) |
| Reset Duration | 1M | 1m / 1h / 1d / 1w / 1M / 1Y |
| Token Limit | 10000 | 每小时 token 上限 |
| Token Reset | 1h | token 限流重置周期 |
| Request Limit | 100 | 每分钟请求上限 |
| Request Reset | 1m | 请求限流重置周期 |
| Team | 选一个团队(可选) | 和 Customer 互斥 |
| Customer | 选一个客户(可选) | 和 Team 互斥 |
| Expiry | Never 或选时长 | Key 过期时间 |
在 Provider Configs 区域挂 Provider:
- 选 openai,weight 0.5,allowed_models 可选
点 Create Virtual Key
7.3 几个关键点
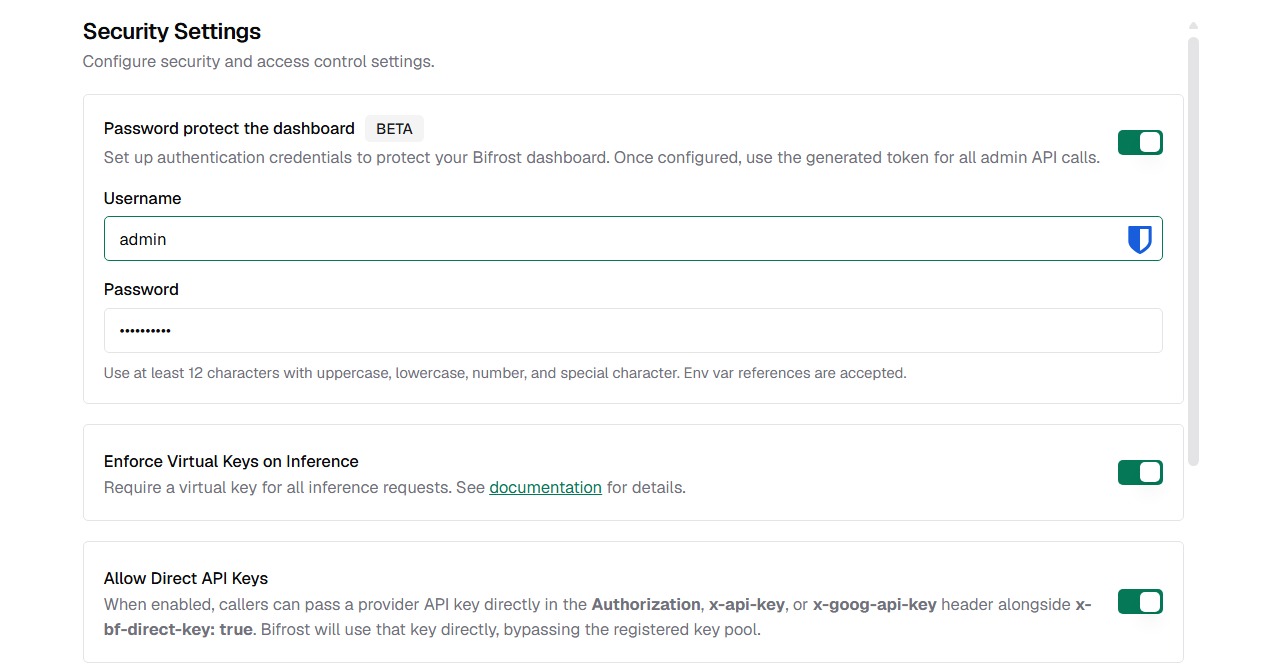
Settings > Security
- 设置用户名和访问密码
- Enforce Virtual Keys on Inference 以及Allow Direct API Keys 开关要打开
八、接入方式:base_url + key + model
VK 拿到了,下一步就是把 Bifrost 接到你的应用代码里。核心就三个参数:base_url、key、model。 前两个之前已经讲过,model 字段的写法直接决定路由行为,必须单独拎出来说清楚。
8.1 model 参数:三种写法
接入 Bifrost 时,model 字段的写法直接决定路由行为,有三种:
写法 1:provider/model-name(推荐,显式路由)
最稳的写法。前缀直接告诉 Bifrost 走哪个 Provider,不依赖 Catalog 解析:
model: "openai/gpt-4o-mini"
model: "anthropic/claude-3-5-sonnet-20241022"
model: "vertex/gemini-2.0-flash"
model: "bedrock/anthropic.claude-3-5-sonnet-20241022-v1:0"
跨 SDK 通用,所有端点(/v1、/openai、/anthropic)都能识别。生产建议只用这种写法。
写法 2:纯模型名(依赖 Model Catalog 自动解析)
写 gpt-4o-mini 不带前缀,Bifrost 会查 Model Catalog 找到唯一支持的 Provider 再路由。风险:如果多个 Provider 都支持同名模型(比如 OpenAI 和 Azure OpenAI 都有 gpt-4o),解析会失败或选错。仅建议调试时用。
写法 3:Drop-in 端点下的原生模型名(最无缝)
走 /openai、/anthropic、/genai 这种 drop-in 端点时,模型名按 SDK 原生写法即可——gpt-4o-mini、claude-3-5-sonnet-20241022、gemini-2.0-flash,不需要前缀。适合从原生 SDK 无痛迁移到 Bifrost,业务代码零改动。
| /v1/* | provider/model-name(写法 1) | 多 Provider 混用、生产部署 |
| /openai/* | gpt-4o-mini(写法 3) | 从 OpenAI SDK 无痛迁移 |
| /anthropic/* | claude-3-5-sonnet-20241022(写法 3) | 从 Anthropic SDK 无痛迁移 |
| /genai/* | gemini-2.0-flash(写法 3) | 从 Google GenAI SDK 无痛迁移 |
怎么选:从零搭——用写法 1;从原生 SDK 迁移——用写法 3;写法 2 只在调试时用。
8.2 通用接入(OpenAI 兼容)
不管你用什么语言/SDK,只要支持 OpenAI API 规范,都能接:
- base_url:http://localhost:8080/v1(或 http://your-host:8080/v1)
- api_key:你的 sk-bf-xxx Virtual Key
直接 curl 测试:
curl -X POST http://localhost:8080/v1/chat/completions \\
-H "Content-Type: application/json" \\
-H "Authorization: Bearer sk-bf-xxx-your-virtual-key" \\
-d '{
"model": "openai/gpt-4o-mini",
"messages": [{"role": "user", "content": "Hello!"}]
}'
8.3 Python OpenAI SDK
from openai import OpenAI
client = OpenAI(
base_url="http://localhost:8080/v1",
api_key="sk-bf-xxx-your-virtual-key"
)
response = client.chat.completions.create(
model="openai/gpt-4o-mini", # Bifrost 用 provider/model 格式路由
messages=[{"role": "user", "content": "Hello, Bifrost!"}]
)
print(response.choices[0].message.content)
或者用 Drop-in URL(更短,Bifrost 专门给 OpenAI SDK 做的兼容路径):
client = OpenAI(
base_url="http://localhost:8080/openai", # 注意是 /openai 不是 /v1
api_key="sk-bf-xxx-your-virtual-key"
)
两条路径效果一样,/v1 是 OpenAI 规范的统一入口(请求里带 provider/ 前缀),/openai 是给 OpenAI SDK 的 drop-in 入口(更无缝)。
8.4 Python Anthropic SDK
from anthropic import Anthropic
client = Anthropic(
base_url="http://localhost:8080/anthropic", # Drop-in URL
api_key="sk-bf-xxx-your-virtual-key"
)
response = client.messages.create(
model="anthropic/claude-3-5-sonnet-20241022",
max_tokens=1024,
messages=[{"role": "user", "content": "Hello!"}]
)
8.5 Node.js OpenAI SDK
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "http://localhost:8080/v1",
apiKey: "sk-bf-xxx-your-virtual-key"
});
const response = await client.chat.completions.create({
model: "openai/gpt-4o-mini",
messages: [{ role: "user", content: "Hello!" }]
});
console.log(response.choices[0].message.content);
8.6 不同请求头的支持
Bifrost 接受 5 种 Key 请求头,任意一种都能识别 VK:
| Authorization: Bearer sk-bf-* | OpenAI 风格(最常用) |
| x-api-key: sk-bf-* | Anthropic 风格 |
| x-goog-api-key: sk-bf-* | Google Gemini 风格 |
| api-key: sk-bf-* | Azure OpenAI 风格 |
| x-bf-vk: sk-bf-* | Bifrost 原生(兼容旧版 VK 不带前缀) |
这意味着:不管你原代码用哪种 SDK 风格,都只要改 base_url、填 VK 当 api_key、用 Bifrost 的 provider/model 格式指定 model(或走 drop-in 端点保留原模型名),业务代码改动最小化。
8.7 验证接入成功
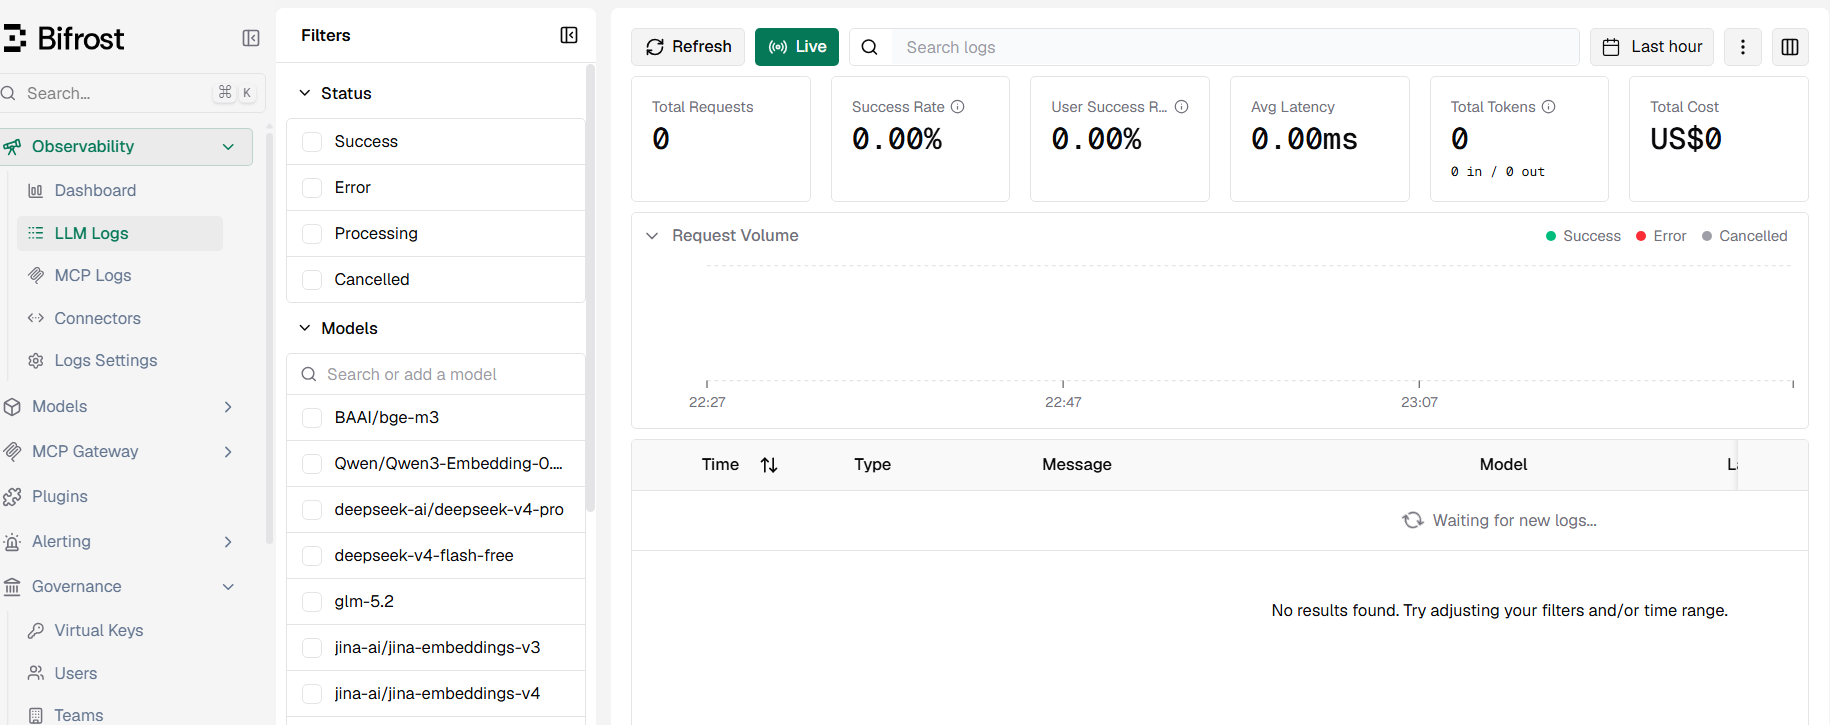
调用一次后,回 Bifrost 控制台看 Logs 页面——能看到这次请求的:
- 走的哪个 Provider
- 用的哪个模型
- token 用量
- 花了多少钱
- 走了哪条 Routing Rule(如果命中)
- VK 当前的预算消耗比例
如果调用失败,控制台日志里也会有详细错误——这是用 Gateway 的隐性收益:所有调用都被观测,比直接打 Provider 透明得多。
进一步阅读
- 官方文档:docs.getbifrost.ai
- GitHub 仓库:maximhq/bifrost(6.9k stars,活跃维护)
- Discord 社区:官方 Discord(社区支持)
- 性能白皮书:Performance Analysis(5k RPS 压测细节)
本文基于 Bifrost v1.3.9 撰写,Docker 镜像版本可能更新,建议以官方文档为准。