阅读对象:正在搭建知识库问答、企业文档助手、医疗/法律/金融领域检索增强应用,但发现“检索到的内容不对”“答案经常幻觉”“Token 成本高得离谱”的开发者。
阅读收益:本文不会只讲概念,而是沿着一份真实的 RAG 优化实验代码,逐步拆解智能分块、QA 生成优化、高级召回策略、RAG 后处理工程优化四大环节,给出可运行代码、实验结果、调优建议和工程落地清单。
一、先看清问题:为什么你的 RAG 总是“答非所问”?
很多人把 RAG 想成一件很简单的事:
文档 -> 切块 -> 向量化 -> 存入向量库 -> 用户提问 -> 向量检索 -> 拼进 Prompt -> 大模型回答
这条链路在 Demo 上能跑通,一旦进入真实业务,就会暴露出几个高频问题:
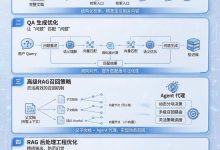
RAG 的优化从来不是单一技巧,而是一套系统工程。本文会围绕下面四个层次展开:
- 精确召回策略:文档怎么切,检索入口怎么建。
- QA 生成优化:如何让“问题”去匹配“问题”。
- 高级 RAG 召回策略:父子文档、Agent 代理分块等更灵活的方法。
- RAG 后处理工程优化:重排序、上下文压缩、Prompt 控制与幻觉防范。
你不需要一次用上所有技巧,但需要理解每个技巧解决什么问题、代价是什么,以及什么时候该用。 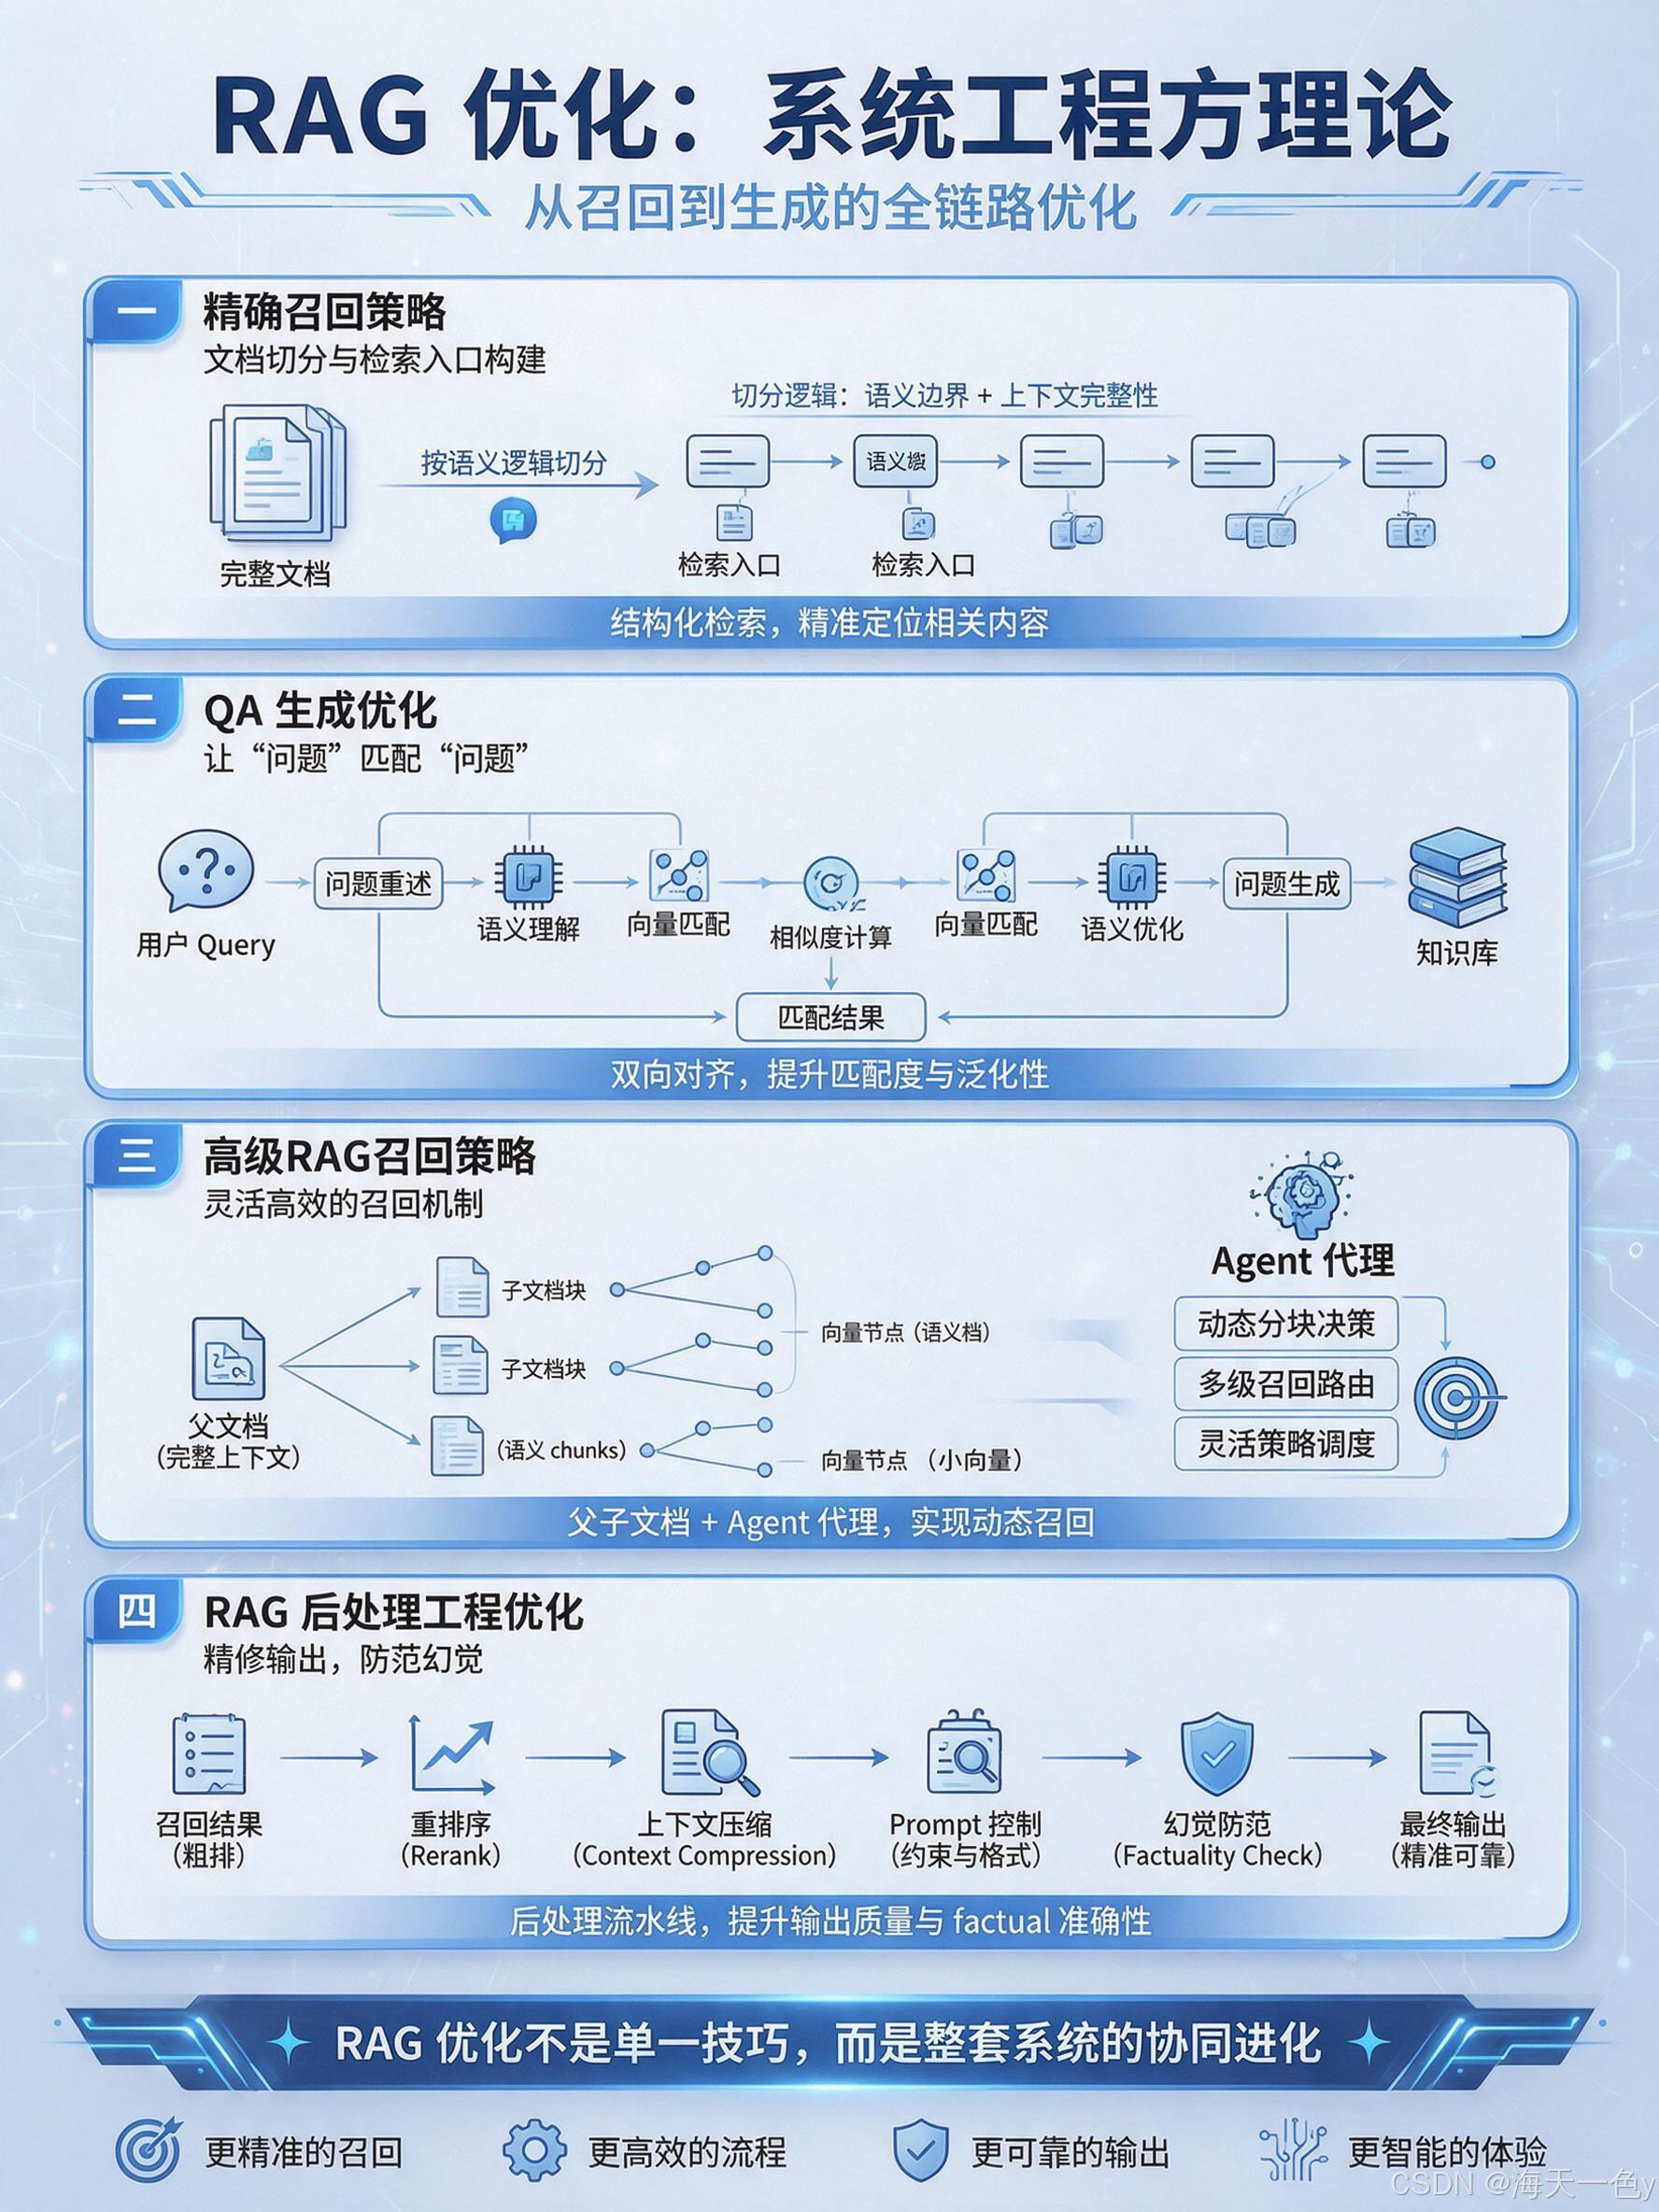
二、智能分块:不要把一本好书随机撕成碎片
RAG 的源头是文档分块。分块质量直接决定了检索的上限。如果最相关的答案被切坏,后面无论换多强的模型、做多复杂的检索都很难完全救回来。
2.1 固定长度分块:最简单,但问题也最多
CharacterTextSplitter 是最直观的切法:按预设字符数切割,不考虑文本逻辑。
from langchain_text_splitters import CharacterTextSplitter
sample_text = (
\”LangChain was created by Harrison Chase in October 2022. \”
\”It provides a framework for developing applications \”
\”powered by language models. The library is known \”
\”for its modularity and ease of use. \”
\”One of its key components is the TextSplitter class, \”
\”which helps in document chunking.\”
)
text_splitter = CharacterTextSplitter(
separator=\” \”,
chunk_size=100,
chunk_overlap=20,
length_function=len
)
docs = text_splitter.create_documents([sample_text])
print(f\”Total number of documents: {
len(docs)}\”)
for i, doc in enumerate(docs):
print(f\”Document {
i}:\”)
print(doc.page_content)
print()
运行后得到 4 个块。可以明显看到,每个块都是按照空格附近的边界进行拼接,句子经常被截断:
Document 0:
LangChain was created by Harrison Chase in October 2022. It provides a framework for developing
Document 1:
for developing applications powered by language models. The library is known for its modularity and
chunk_size 和 chunk_overlap 是最重要的两个参数:
- chunk_size 太小,上下文不足,模型无法完整理解概念。
- chunk_size 太大,会引入噪声,降低检索信噪比,同时增加 API 成本。
- 常见取值通常围绕嵌入模型的最佳输入长度设计,例如 256、512、1024。
- chunk_overlap 一般取 chunk_size 的 10% 到 20%,用来缓解边界切断问题。
但重叠并不能从根本上解决语义断裂。它只是让相邻块之间保留一些重复内容,当某个句子恰好落在边界附近时,至少还能被两个块同时覆盖。
2.2 递归字符分块:在字符切分之上增加优先级
RecursiveCharacterTextSplitter 是 LangChain 里更推荐的通用方案。它不是随便找到一个空格就切,而是按照分隔符优先级递归切分,默认顺序是:
[\”\\n\\n\”, \”\\n\”, \” \”, \”\”]
也就是先尽量按段落切,再按换行切,再按空格切,最后才按字符硬切。
from langchain_text_splitters import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=100,
chunk_overlap=20,
)
docs = text_splitter.create_documents([sample_text])
for i, doc in enumerate(docs):
print(f\”— Chunk {
i + 1} —\”)
print(doc.page_content)
对于普通文本,递归分块通常比固定长度分块更稳。它优先保留自然边界,能在不引入额外模型成本的情况下显著减少“一句话被从中间砍断”的概率。
不过,递归分块仍然不理解文档结构。真正的文档往往有标题、列表、表格、代码块、对话轮次。如果我们知道这些结构,就应该利用它。
2.3 结构感知分块:利用 Markdown 标题和 HTML 标签
如果知识库是 Markdown 文档、HTML 页面或富文本,最好的边界往往就是标题层级。
例如一篇技术手册:
# Chapter 1: The Beginning
## Section 1.1: The Old World
This is the story of a time long past.
## Section 1.2: A New Hope
A new hero emerges.
# Chapter 2: The Journey
## Section 2.1: The Call to Adventure
The hero receives a mysterious call.
我们可以用 MarkdownHeaderTextSplitter 按标题层级切分:
from langchain_text_splitters import MarkdownHeaderTextSplitter
headers_to_split_on = [
(\”#\”, \”Header 1\”),
(\”##\”, \”Header 2\”),
]
markdown_splitter = MarkdownHeaderTextSplitter(
headers_to_split_on=headers_to_split_on
)
md_header_splits = markdown_splitter.split_text(markdown_document)
for split in md_header_splits:
print(f\”Metadata: {
split.metadata}\”)
print(split.page_content)
print(\”-\” * 20)
输出会把标题写入 metadata,并把同一小节的内容保留在同一个块里:
Metadata: {\’Header 1\’: \’Chapter 1: The Beginning\’, \’Header 2\’: \’Section 1.1: The Old World\’}
This is the story of a time long past.
这样做至少有三个好处:
- 检索时可过滤:用户问“第二章”,系统可以先按标题缩小范围。
- 上下文完整:同一小节内容不会被拆到多个块。
- 元数据更丰富:后续重排序、引用来源展示时都能用上。
2.4 按对话轮次分块:适合客服、访谈和会议纪要
客服对话、访谈记录、会议纪要等场景,如果按固定字符切分,很容易把同一轮问答拆散,或者把不同说话人混在一起。
一个更合理的方式是按“轮次”切分:
dialogue = [
\”Alice: Hi, I\’m having trouble with my order.\”,
\”Bot: I can help with that. What\’s your order number?\”,
\”Alice: It\’s 12345.\”,
\”Alice: I haven\’t received any shipping updates.\”,
\”Bot: Let me check… It seems your order was shipped yesterday.\”,
\”Alice: Oh, great! Thank you.\”,
]
def chunk_dialogue(dialogue_lines, max_turns_per_chunk=3):
chunks = []
for i in range(0, len(dialogue_lines), max_turns_per_chunk):
chunk = \”\\n\”.join(dialogue_lines[i: i + max_turns_per_chunk])
chunks.append(chunk)
return chunks
chunks = chunk_dialogue(dialogue)
for i, chunk in enumerate(chunks):
print(f\”— Chunk {
i + 1} —\”)
print(chunk)
结果会保留“用户问题 + 客服回答”这样的完整交互。这类结构感知分块不需要调用 LLM,逻辑简单,但实际效果常常比盲目调 chunk_size 要好。
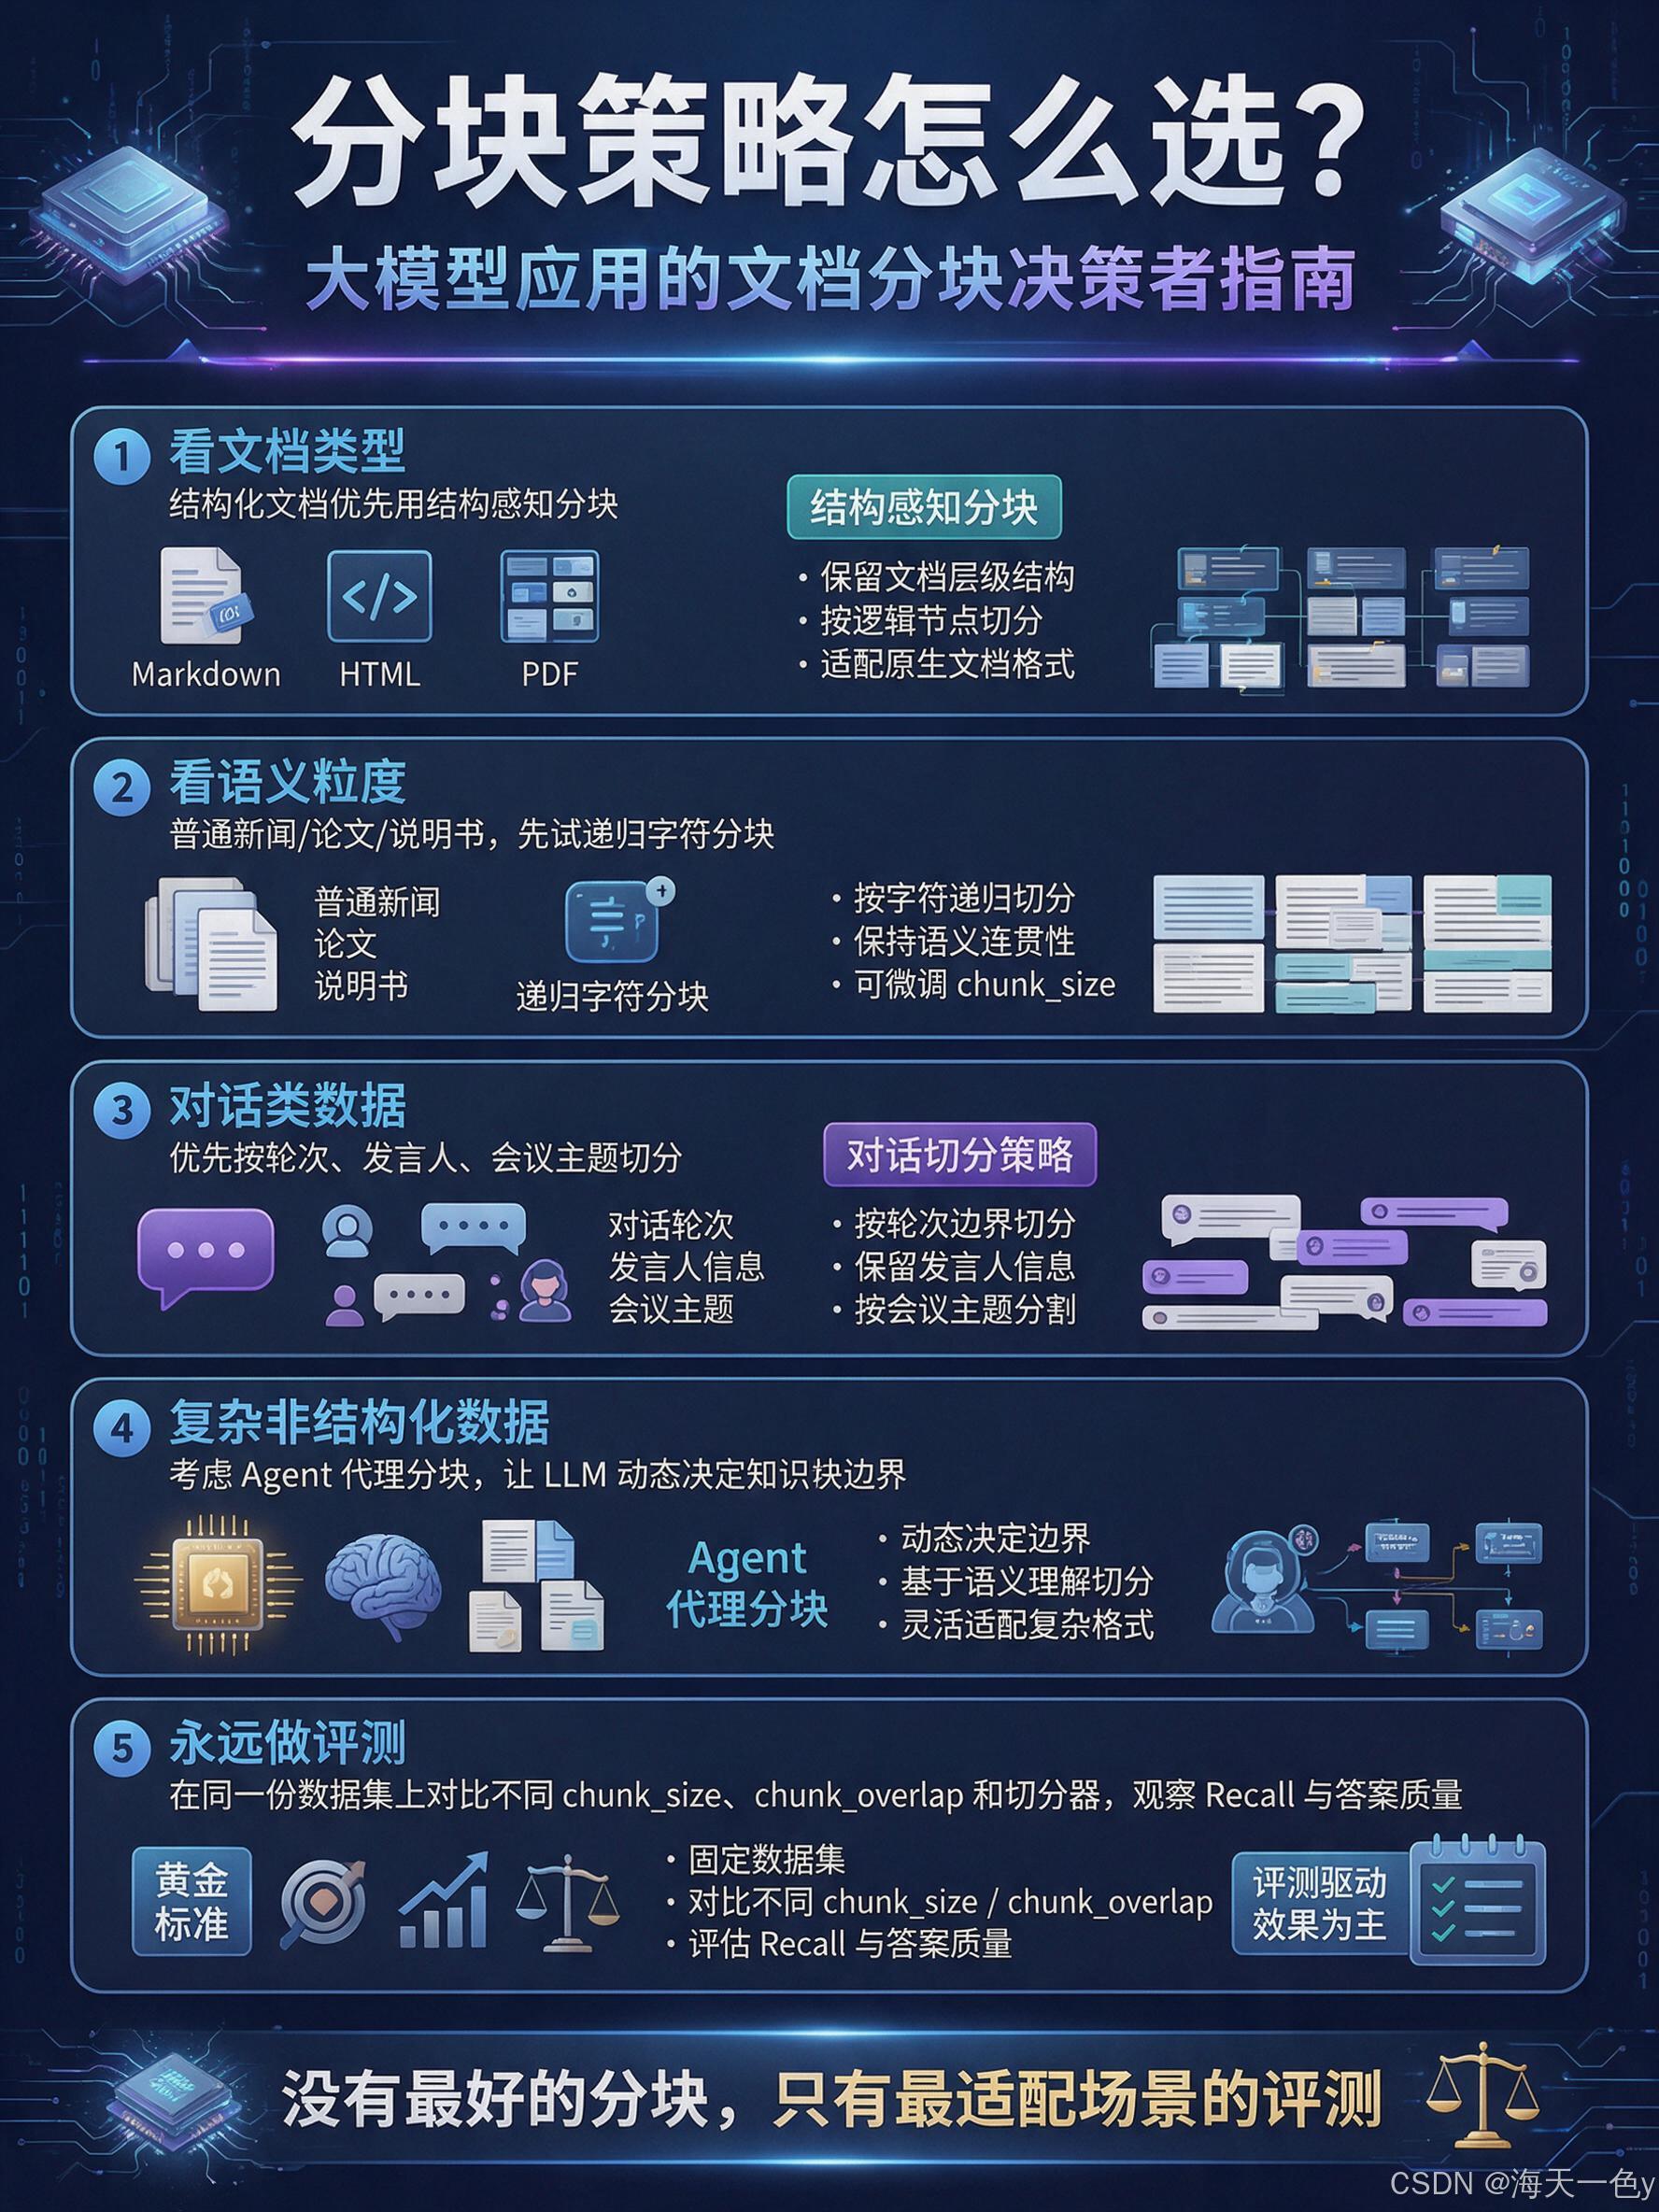
2.5 分块策略怎么选?
一个简单决策顺序:
三、QA 生成优化:让“问题”去匹配“问题”
智能分块解决的是“文档怎么切”。但还有一个更隐蔽的问题:用户提问方式与文档陈述方式存在语义鸿沟。
比如库里有一句:
糖尿病患者建议控制碳水摄入,增加低糖蔬菜和优质蛋白。
用户却可能问:
小明的爸爸👨 60 岁血糖 10,一日三餐具体吃什么?
如果直接用用户问题去匹配陈述文档,向量相似度可能不高。但如果我们提前用 LLM 为文档生成几个“用户可能提出的问题”,再让用户问题去匹配这些问题,命中率会大幅提升。
3.1 核心思想:为每个文档块创建多个检索入口
QA 生成优化通常这样工作:
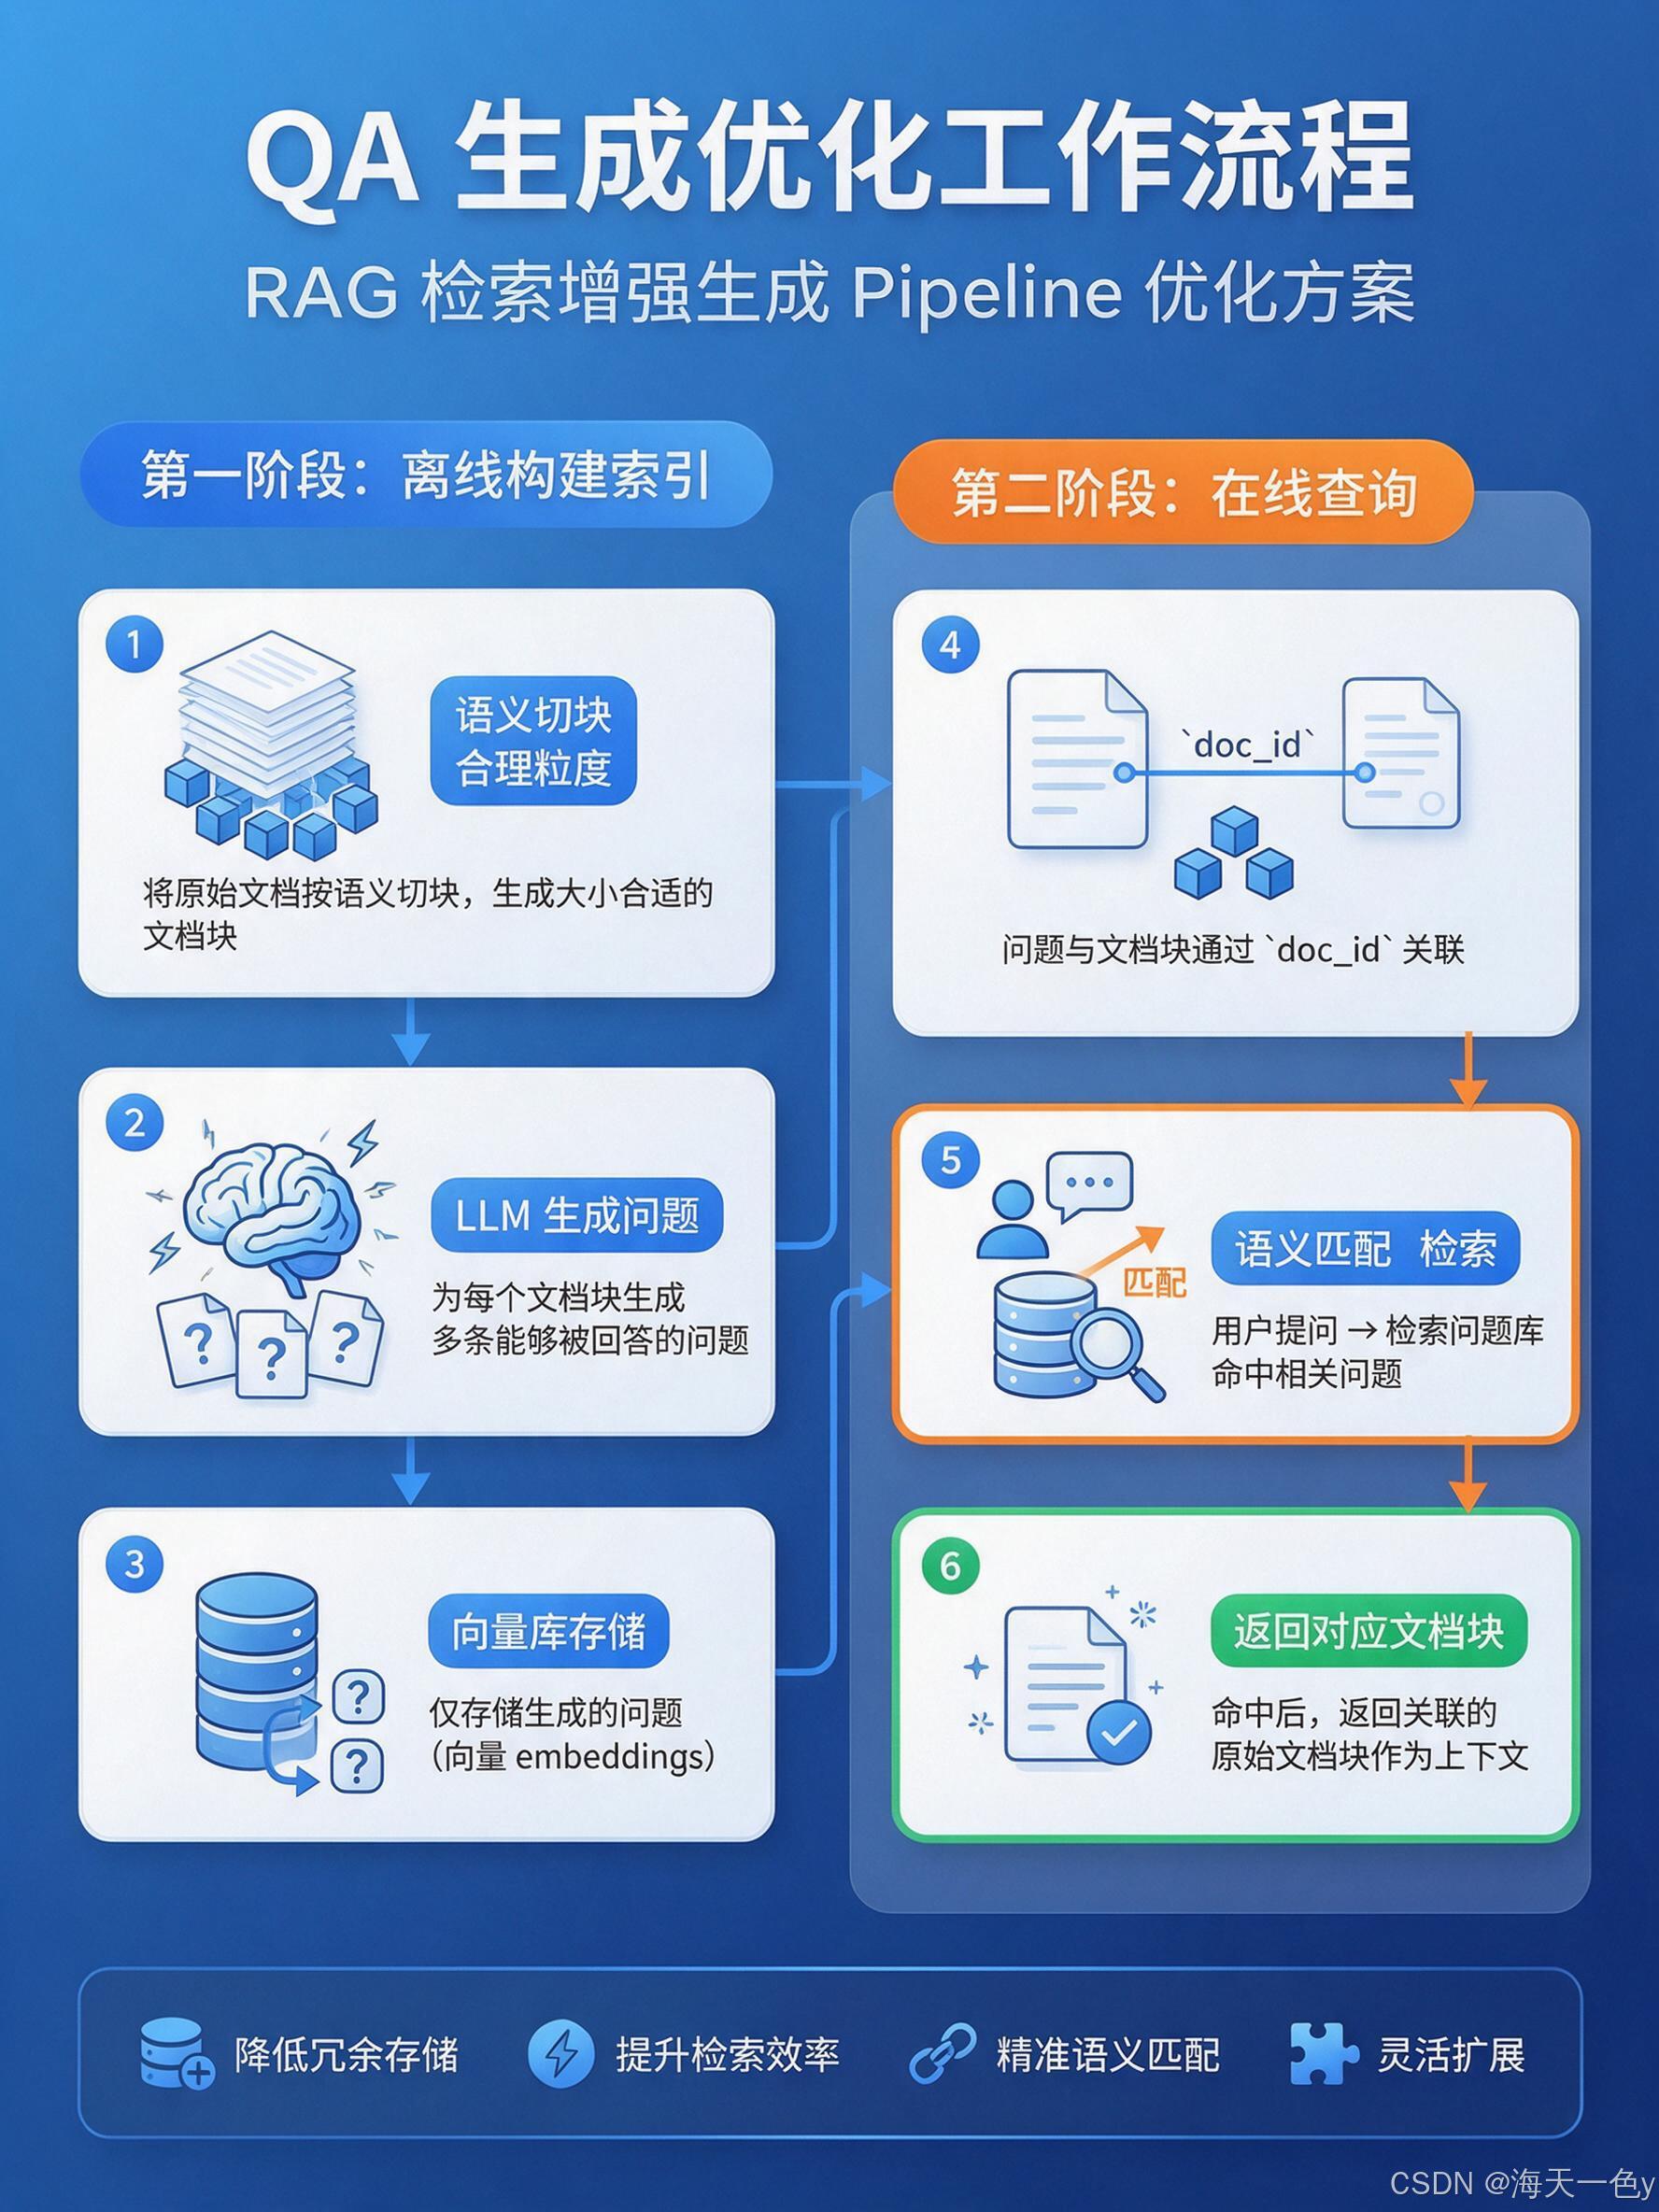
这相当于为一个知识点创造了多个不同角度的入口。即使用户措辞刁钻,只要能和其中一条代理问题匹配,就能找到答案。
3.2 环境与模型准备
工程代码里通常会从环境变量读取密钥,并封装嵌入模型。下面是一个典型的 OpenAI 兼容接口封装:
import os
from openai import OpenAI
from langchain.embeddings.base import Embeddings
class OpenAIEmbeddings(Embeddings):
def __init__(self, client, model=\’doubao-embedding-vision-251215\’):
self.client = client
self.model = model
def embed_documents(self, texts):
embeddings = []
for t in texts:
resp = self.client.multimodal_embeddings.create(
input=[{
\”type\”: \”text\”, \”text\”: t}],
mode