Apache Flink 端到端 Exactly-Once 一致性深度实战:两阶段提交(2PC)Sink 协议与 Kafka 事务机制剖析
在金融级实时交易对账、计费结算与风控流计算系统中,数据一致性语义(Delivery Guarantees) 是技术团队绝对无法妥协的核心底线:
- At-Most-Once(最多一次):发生崩溃时允许丢数据,严重违背金融合规;
- At-Least-Once(至少一次):发生崩溃时数据回放重算,导致下游报表金额与订单数量发生严重的重复累加翻倍资损;
- Exactly-Once(精确一次):哪怕整个流计算集群发生网络分区、节点宕机闪退,系统恢复后全链路计算结果与“没有发生过任何故障”完全一致,不重不漏!
然而,很多流计算工程师存在一个致命的认知盲区:“只要在 Flink 中开启了 enableCheckpointing(),整个系统就自然实现了 Exactly-Once。”
这是极其严重的误解!Flink 内部的 Checkpoint 仅仅保障了 Flink 内部算子状态的 Exactly-Once。如果下游 Sink(如写入 Kafka 或 MySQL)在 Checkpoint 成功之前已经将数据裸写出去,当 Flink 故障回滚到上一个检查点重新发射数据时,下游就会不可避免地收到重复的脏数据!
如何才能实现真正的 端到端(End-to-End)Exactly-Once?两阶段提交协议(2PC)是如何与 Flink Checkpoint Barrier 协同工作的?
本文深入剖析端到端一致性三大支柱、两阶段提交协议物理时序,并给出生产级 Java Flink Kafka 事务性端到端精确一次实战代码。
一、流计算三种消息传递语义全景对比矩阵
| 1. At-Most-Once (最多一次) | 发生故障直接丢弃未处理数据 | ❌ 严重丢失 | 零重复 | 极低(吞吐最高) | IoT 传感器高频温度丢帧监控 |
| 2. At-Least-Once (至少一次) | 恢复时重放 Source 位点重新计算 | 零丢失 | ❌ 严重重复(金额累加翻倍) | 中等 | 对重复不敏感的简单日志清洗 |
| 3. End-to-End Exactly-Once (端到端精确一次 – 黄金标准) | 基于 2PC 两阶段提交事务协同回滚,实现状态与外部存储原子同步 | ✅ 零丢失 | ✅ 零重复 | 较高(需外部组件支持事务) | 企业级核心交易对账、计费结算、风控审计 |
二、端到端 Exactly-Once 的三大物理支柱架构
要实现端到端精确一次,整个链路上的所有组件必须同时满足以下三大基石条件:
[1. 可重放的 Source] [2. 强一致状态引擎] [3. 事务性/幂等 Sink]
(如 Kafka Offset / Flink CDC) (Flink RocksDB + Checkpoint) (Kafka 2PC 事务 / MySQL 幂等)
| | |
v v v
故障恢复时可精准回退 Chandy-Lamport 算法 未正式 Commit 前处于预提交状态,
消费位点 (Seek to Offset) Barrier 对齐生成全局一致快照 崩溃时可原子回滚 (Rollback)
三、Flink 两阶段提交协议(2PC)与 Checkpoint 协同底层时序
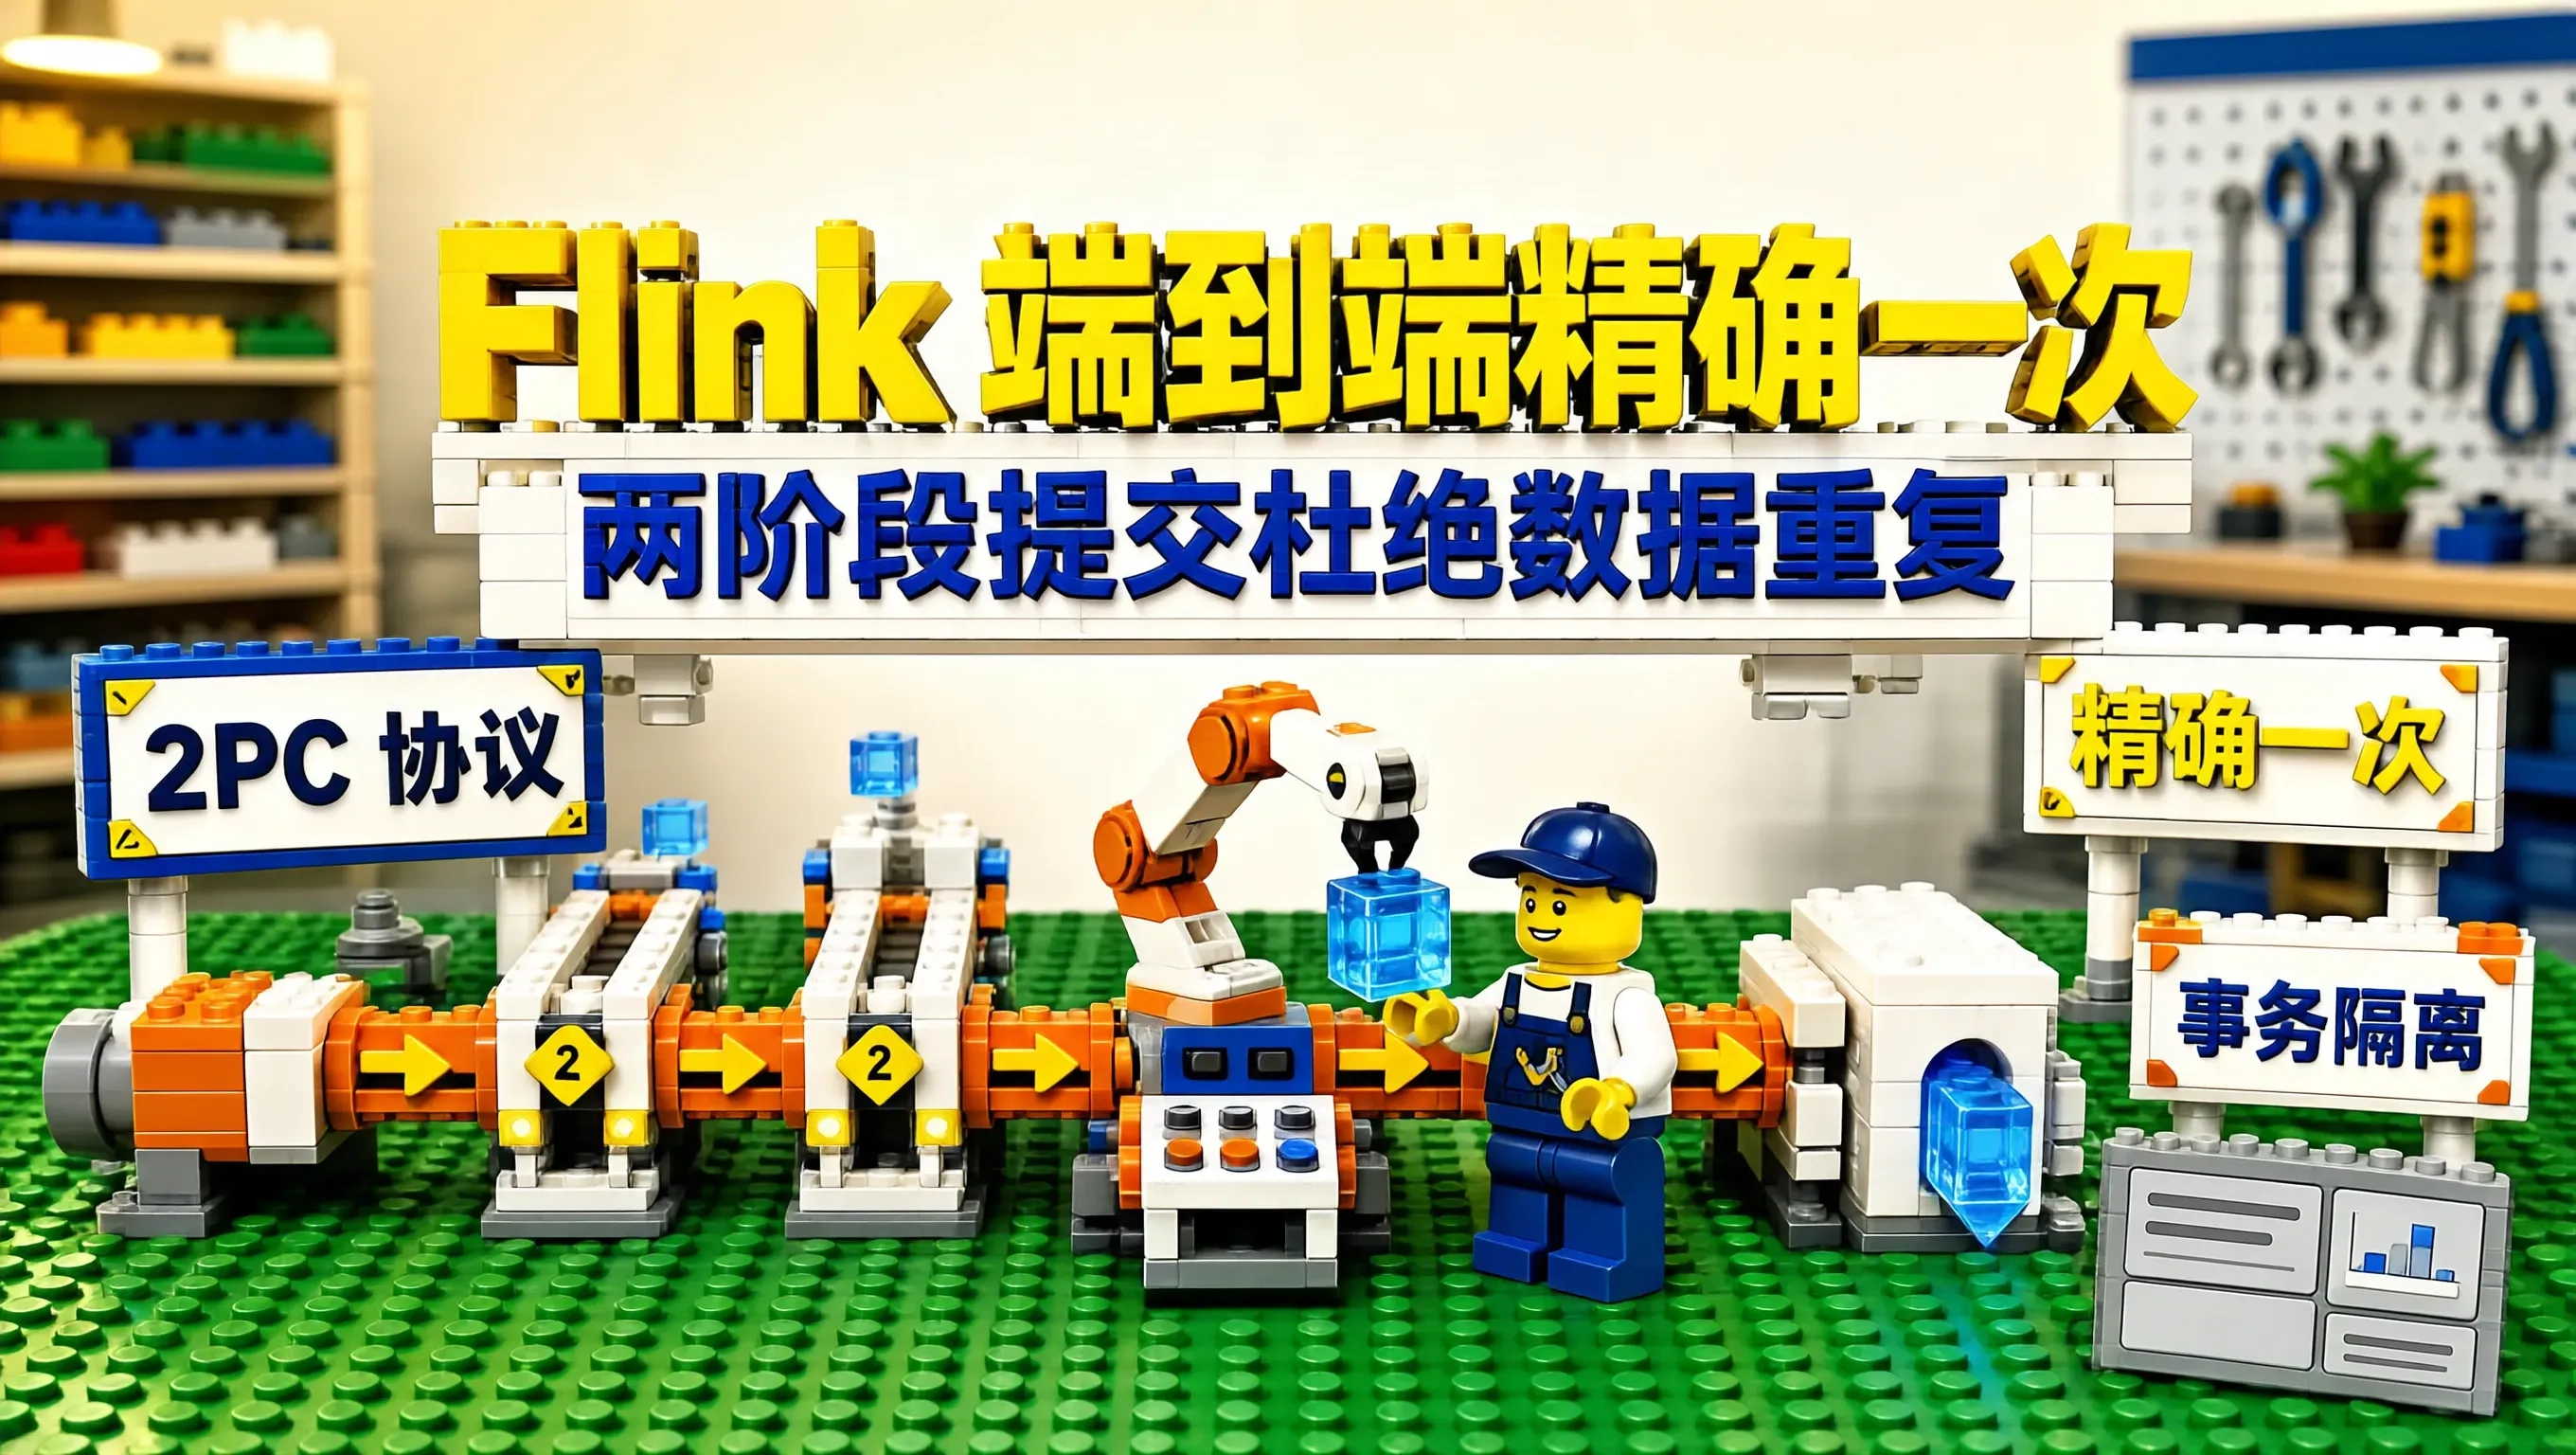
Flink 官方提供了 TwoPhaseCommitSinkFunction 抽象基类。当 Flink 与 Kafka 事务(Kafka Transactions)结合时,整个两阶段提交协议在底层经历如下流转:
[JobManager (协调者 Coordinator)] [TaskManager / KafkaSink (参与者)]
| |
| ===== 1. 触发 Checkpoint ➔ 注入 Barrier 元组 =====> |
| | 🌟 Phase 1: 预提交 (Pre-Commit)
| | – 结束当前 Kafka 事务 Transaction_1 (进入预提交状态)
| | – 开启全新 Kafka 事务 Transaction_2 接收新流入数据
| | – 将 Transaction_1 的事务 ID 写入 Flink Checkpoint 状态中
| | – 异步上传本地状态快照至 S3/HDFS
| |
| <==== 2. 所有算子状态备份成功 ➔ 响应 ACK 给 JM ======= |
| |
+———————————————–+ |
| 🌟 JobManager 判定本次 Checkpoint 成功固化! | |
+———————————————–+ |
| | 🌟 Phase 2: 正式提交 (Commit)
| ===== 3. 向所有 Sink 广播 Checkpoint 成功信号 =====> | – 调用 `kafkaProducer.commitTransaction()` 正式提交!
| | – 下游 Kafka 消费者 (read_committed) 此时才正式可见该批数据!
🚨 故障回滚机理:若在第 2 步到第 3 步之间某个 TaskManager 意外崩溃,JobManager 将不会发出 Commit 广播。重启恢复时,Flink 会从上次成功的 Checkpoint 读取未提交的 Transaction ID,并调用 kafkaProducer.abortTransaction() 强行回滚放弃该事务,彻底根绝数据重复!
四、生产级 Java Flink Kafka 端到端 Exactly-Once 事务配置与实战
下面的 Java 实现演示了如何使用最新的 Flink 1.15+ KafkaSink 结合严格事务语义(DeliveryGuarantee.EXACTLY_ONCE)与 Kafka 消费端隔离级别配置。
package com.engine.flink.exactlyonce;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend;
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.CheckpointConfig;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import java.util.Properties;
public class EndToEndExactlyOnceKafkaJob {
public static void main(String[] args) throws Exception {
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// ————————————————————-
// 1. 核心 Checkpoint 生产参数硬化配置
// ————————————————————-
// 开启精确一次 Checkpoint 模式
env.enableCheckpointing(30_000, CheckpointingMode.EXACTLY_ONCE);
CheckpointConfig cpConfig = env.getCheckpointConfig();
cpConfig.setMinPauseBetweenCheckpoints(10_000);
cpConfig.setCheckpointTimeout(120_000); // 2 分钟超时
cpConfig.setMaxConcurrentCheckpoints(1); // 2PC 模式下必须严格限制并发 CP 为 1
// 配置增量 RocksDB 状态后端
env.setStateBackend(new EmbeddedRocksDBStateBackend(true));
cpConfig.setCheckpointStorage("s3a://corp-flink-checkpoints/financial_stream/");
// ————————————————————-
// 2. 构建可重放的 Kafka Source
// ————————————————————-
KafkaSource<String> source = KafkaSource.<String>builder()
.setBootstrapServers("kafka-broker.corp.com:9092")
.setTopics("ods_user_payments")
.setGroupId("flink_financial_group")
.setStartingOffsets(OffsetsInitializer.earliest())
.setValueOnlyDeserializer(new SimpleStringSchema())
.build();
DataStream<String> inputStream = env.fromSource(source, WatermarkStrategy.noWatermarks(), "KafkaSource");
// ————————————————————-
// 3. 业务状态计算 (过滤、清洗与核心财务去重)
// ————————————————————-
DataStream<String> processedStream = inputStream
.filter(record -> record != null && !record.isEmpty())
.map(record -> "[VERIFIED_TRANSACTION] " + record);
// ————————————————————-
// 4. 🌟 构建支持两阶段提交 (2PC) 的 KafkaSink (DeliveryGuarantee.EXACTLY_ONCE)
// ————————————————————-
Properties kafkaSinkProps = new Properties();
// ⚠️ 极其重要: Kafka Broker 事务超时时间默认是 15 分钟,此处必须设置大于 Checkpoint Timeout
kafkaSinkProps.setProperty("transaction.timeout.ms", "900000"); // 15 分钟
KafkaSink<String> exactOnceSink = KafkaSink.<String>builder()
.setBootstrapServers("kafka-broker.corp.com:9092")
.setRecordSerializer(
KafkaRecordSerializationSchema.builder()
.setTopic("dwd_financial_verified")
.setValueSerializationSchema(new SimpleStringSchema())
.build()
)
// 启用两阶段提交 EXACTLY_ONCE 保证
.setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
// 注入专属事务前缀 (防止多作业冲突)
.setTransactionalIdPrefix("flink-financial-tx-")
.setKafkaProducerConfig(kafkaSinkProps)
.build();
processedStream.sinkTo(exactOnceSink);
System.out.println("🚀 [INIT] Flink 端到端 Exactly-Once 事务流水线初始化完毕!");
env.execute("EndToEndExactlyOnceKafkaJob");
}
}
五、生产避坑与 Kafka 事务调优红线
在生产中落地 Flink + Kafka 两阶段提交 Exactly-Once 时,必须坚守以下四项落地原则:
通过深刻理解 Flink Checkpoint 内部状态机与外部存储两阶段提交(2PC)的协同博弈机理,结合生产级事务超时与消费隔离参数调优,企业流计算团队能够构建出坚如磐石的金融级端到端 Exactly-Once 一致性防线,彻底消除分布式故障带来的数据丢失与重复资损隐患。