一:问题
开发过程中遇到一个比较有意思的问题,记录一下完整的排查过程。
系统架构比较简单:
前端
↓
Nginx :9999
↓
Spring Boot :8080
上传文件时,接口出现了一个比较奇怪的现象:
第一次请求返回 413 Request Entity Too Large,紧接着再次请求却变成了 404 Not Found。
而且接口路径本身是正确的,正常情况下这个接口一直都可以访问。
问题就变成了:
为什么同一个接口,第一次是 413,后面又变成了 404?
二:排查
1. 先定位 413 到底是谁返回的
首先想到的是文件上传大小限制。
HTTP 413 Request Entity Too Large(现在更常见的描述是 413 Content Too Large)通常意味着:
请求体超过了服务端允许的最大大小。
整个请求链路中可能存在多个限制:
客户端
↓
Nginx
↓
Tomcat
↓
Spring Boot
↓
Controller
因此第一步就是:
绕过 Nginx,直接访问后端 8080。
例如:
curl http://127.0.0.1:8080/api/xxx
上传同一个文件进行测试。
测试结果:
直接访问 8080:正常
访问 Nginx 9999:异常
这时候基本可以确定:
问题发生在 Nginx 这一层,而不是 Spring Boot Controller。
如果直连 8080 正常,而经过 9999 就返回 413,那么重点就应该检查 Nginx 的请求体大小限制。
2. 检查 Nginx 的 client_max_body_size
查看 Nginx 配置:
nginx -T
或者直接搜索:
nginx -T | grep -n client_max_body_size
发现原来的 Nginx 配置中没有设置:
client_max_body_size
Nginx 默认的请求体大小限制通常是:
1 MB
而当前接口需要上传较大的文件,因此超过限制后,Nginx 直接返回:
413 Request Entity Too Large
请求甚至不会到达 Spring Boot。
解决方法
可以针对上传接口所在的 location 配置:
location ^~ /api/ {
client_max_body_size 200M;
proxy_pass http://127.0.0.1:8080/api/;
proxy_redirect default;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header Authorization $http_authorization;
}
然后检查配置:
nginx -t
确认:
syntax is ok
test is successful
再重新加载:
nginx -s reload
3.为什么又出现 404?
按照正常逻辑,修改 client_max_body_size 后,413 应该解决。
但是当时还遇到了另外一个现象:
第一次请求出现 413,之后再次请求却出现 404。
而且这个 404 返回的页面也是 Nginx 默认的:
<html>
<head>
<title>404 Not Found</title>
</head>
<body>
<center><h1>404 Not Found</h1></center>
<hr>
<center>nginx/1.27.4</center>
</body>
</html>
这说明至少有一个请求没有正常进入后端 Controller,而是在 Nginx 层就结束了。
于是开始进一步排查。
4.排查 HTTP 长连接和连接复用
一个值得验证的方向是:
是否和 HTTP Keep-Alive / TCP 连接复用有关?
因为浏览器、Axios、curl 等 HTTP 客户端通常都会复用 TCP 连接。
为了验证这一点,可以让客户端每次请求都关闭连接。
例如使用 curl:
curl -H "Connection: close" …
如果使用 Axios,也可以临时关闭 Agent 连接复用,例如:
axios({
url: '/api/xxx',
method: 'post',
data: formData,
// 根据具体运行环境配置 Agent
});
Node.js 环境下可以进一步检查 HTTP Agent 的连接复用情况。
这个测试的目的不是直接证明“连接被污染”,而是:
通过关闭连接复用,观察 413 → 404 的现象是否消失。
如果关闭 Keep-Alive 后问题明显变化,就说明连接复用值得重点调查。
5.发现一个值得关注的 Nginx 配置
继续检查 Nginx 配置时,发现了这样一行:
keepalive_timeout 60000s;
这个配置非常夸张。
60000 秒 ≈ 16.7 小时
也就是说,Nginx 可以让 HTTP Keep-Alive 连接保持非常长的时间。
通常没有特殊需求的话,并不需要把这个值设置得这么大。
例如:
keepalive_timeout 65s;
或者根据实际业务场景配置一个合理的值。
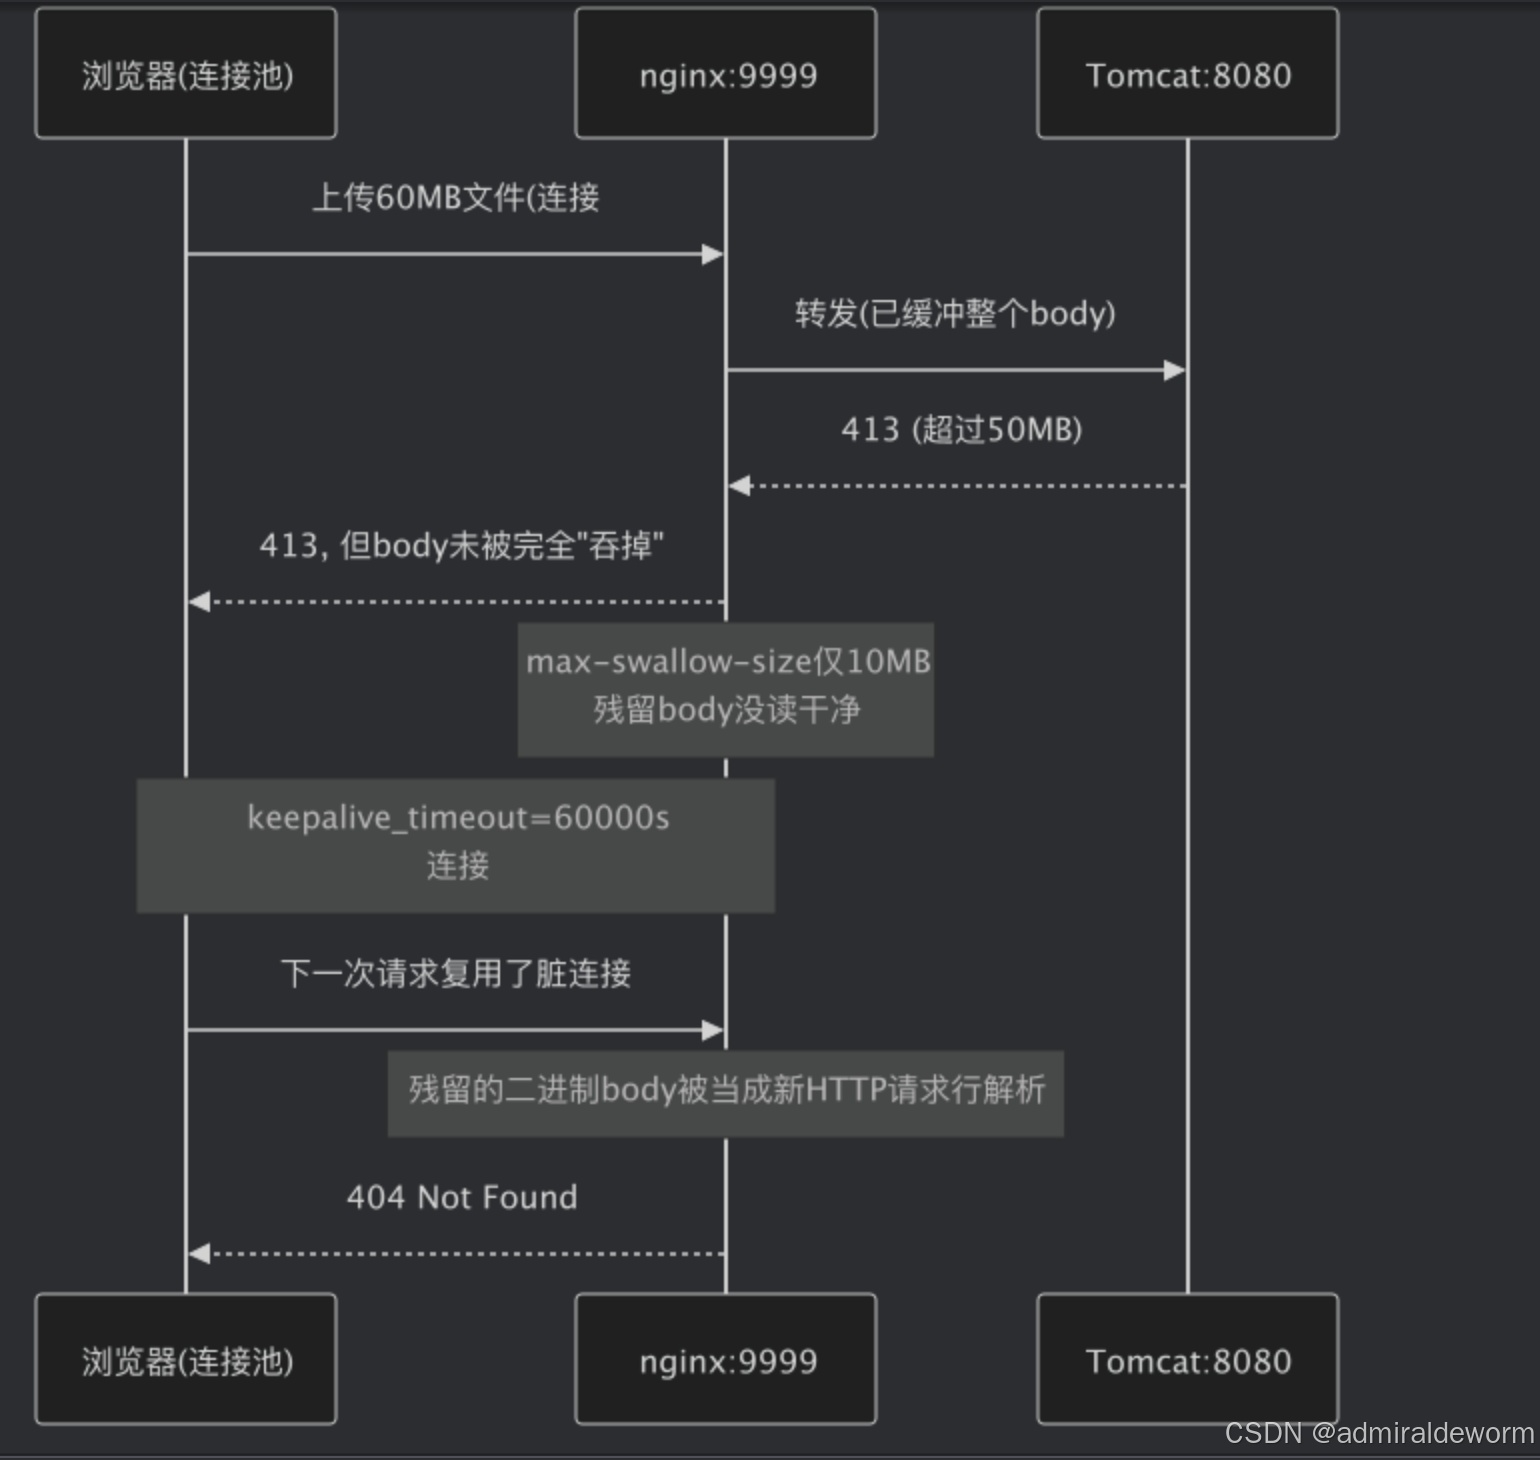
因为 keepalive_timeout 高达 16 小时,一条被 413 中断、body 没读干净的连接会长时间滞留在连接池里被反复复用,残留字节被当成新请求解析 → 404。等这条连接最终超时/被关闭后,再试又恢复正常。
四:思路
这次问题可以总结成下面的排查链路:
上传大文件
│
▼
经过 Nginx :9999
│
├── 请求体超过 Nginx 限制
│
▼
413 Request Entity Too Large
│
▼
检查 client_max_body_size
│
▼
发现没有配置
│
▼
Nginx 默认限制约 1MB
│
▼
增加 client_max_body_size
例如:
location ^~ /api/ {
client_max_body_size 200M;
proxy_pass http://127.0.0.1:8080/api/;
}
同时检查:
keepalive_timeout 65s;
不要无特殊需求设置成:
keepalive_timeout 60000s;
五:本质
一句话概括:"大文件 + 连接复用"问题
- 413 (Payload Too Large):请求体超过了某一层的大小限制,请求根本没进入你的 Controller(imageUpload 方法都没执行)。
- 404 (Not Found):服务端把收到的字节当成了一个"不存在的路径"。
它们交替出现,是典型的 HTTP keep-alive 长连接被"污染" 导致的:
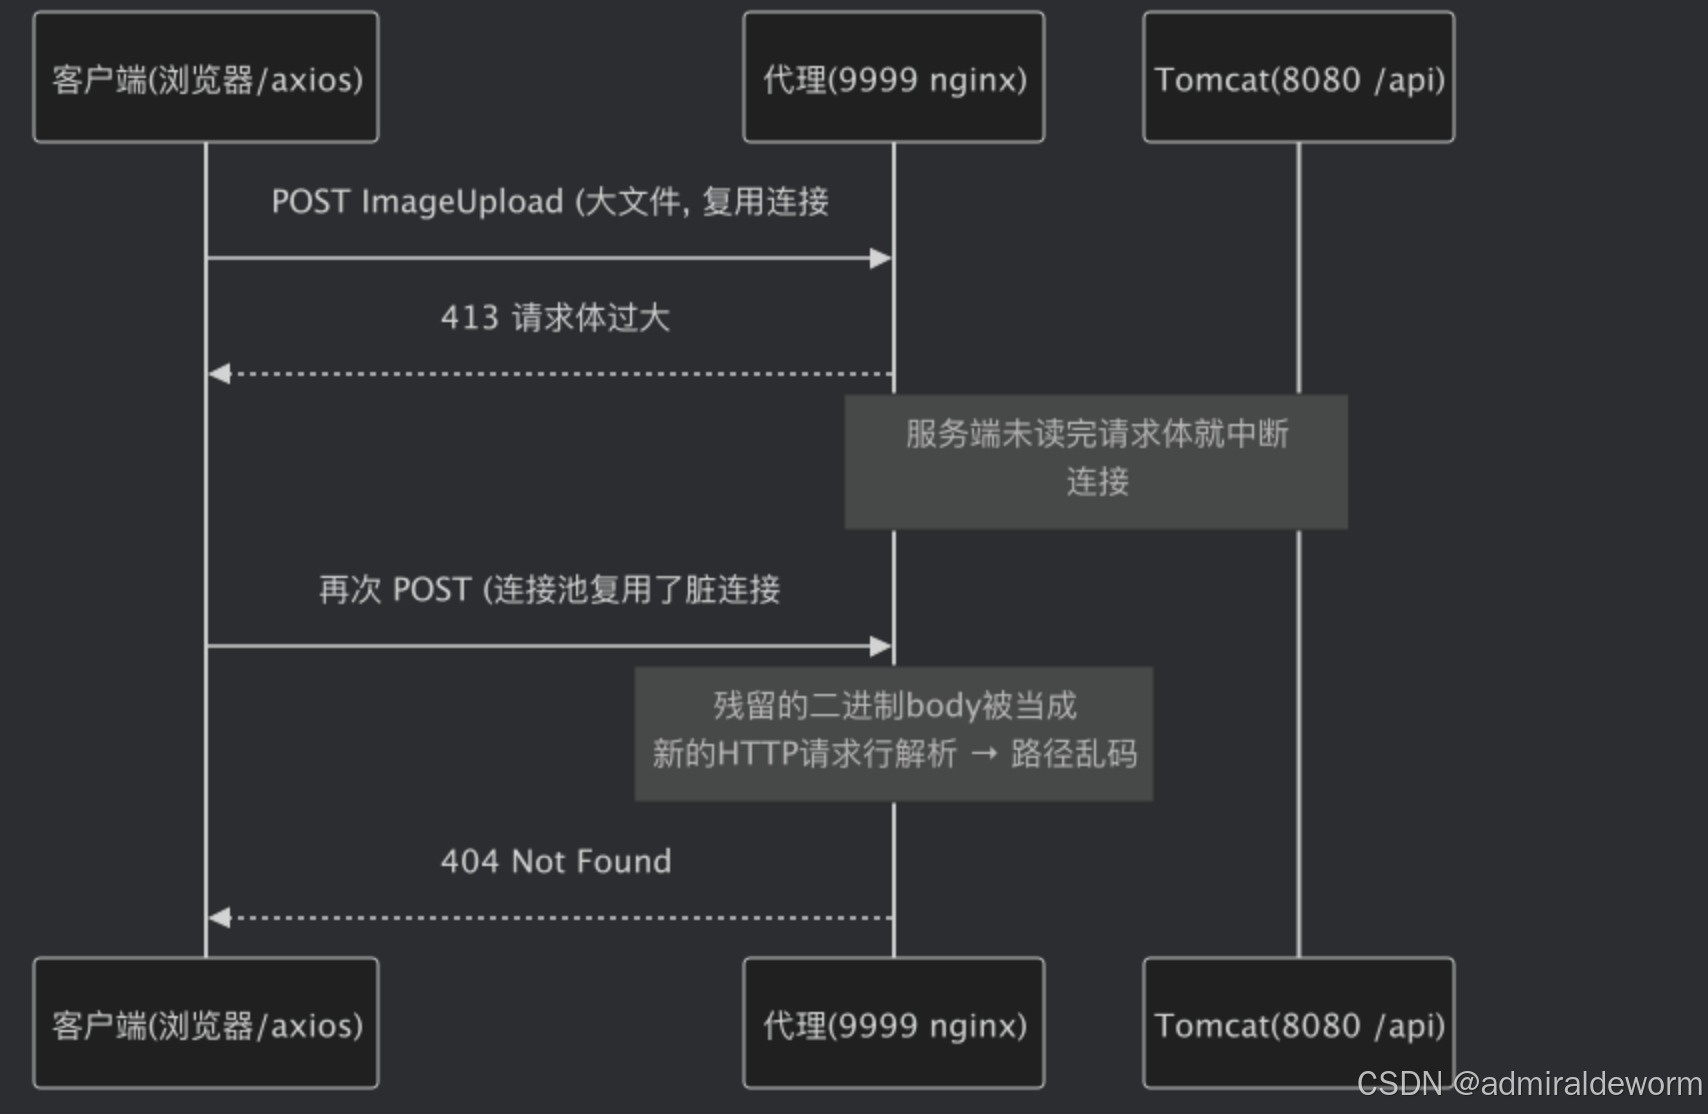
核心机制:当上传文件超过限制时,服务端(nginx 或 Tomcat)直接返回 413 并中断,但没有把请求体读完/吞掉。客户端的连接池认为这条 keep-alive 连接还能用,于是复用它发下一个请求;此时上一个请求残留的 multipart 二进制字节还留在 TCP 流里,被服务端当成新请求的"请求行"去解析,路径自然对不上 → 返回 404。等这条脏连接被彻底关闭后,再试又恢复正常。这就是你说的"有时 413,再调用又变 404"