📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 AI | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 篇36 留了句话——线程划分地址空间,本质上就是在划分页表。这句话的分量,要把页表拆开才掂得出来。线程(二)接着把它拆开——物理内存怎么管,虚拟地址怎么一步步变成物理地址。从 4KB 起步,依次拆页框、两级页表、MMU 翻译、缺页中断,TLB 收口。
一、资源都按 4KB 划分
1.1 分页解决什么问题
多个进程同时跑,物理内存怎么分?最直觉的方案:每个进程分一块连续内存。问题立刻就来——进程 A 明明只用了 200MB,却占着 1GB;想缩也缩不掉,别人用不上,它自己也挪不走。
更难受的在后面:进程退出后,内存里留下东一块西一块的空洞。新进程明明总量够,却找不到一块连续的地方放——这就是碎片。根子上的病因就一个字:连。凡是要求连续分配,碎片早晚找上门。 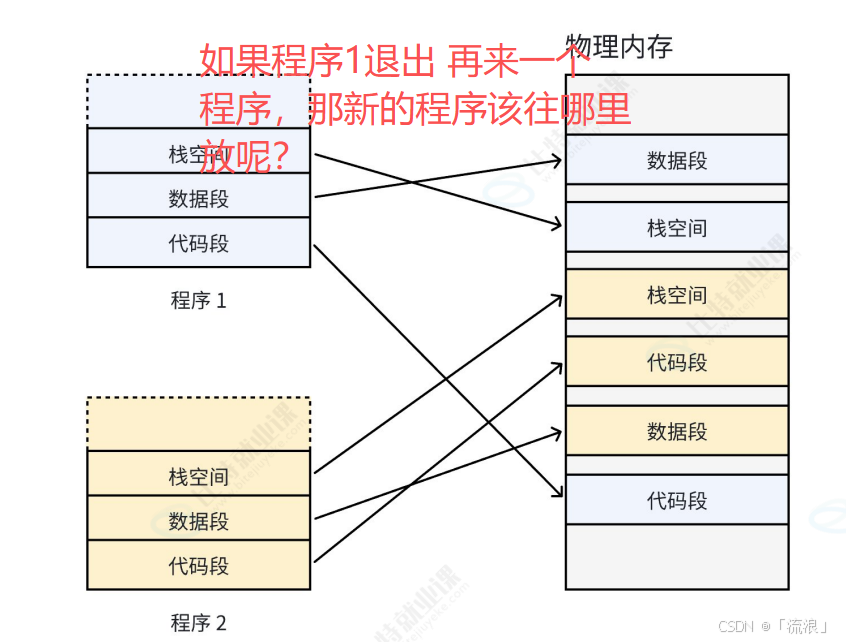
分页的思路是把「连续」从物理世界搬走:虚拟地址空间保持连续,物理内存切成 4KB 的小块,哪里有空放哪里,中间靠一张映射表把两边对上——这张表就是页表。进程看到的还是连续地址,物理内存却被用得干干净净。 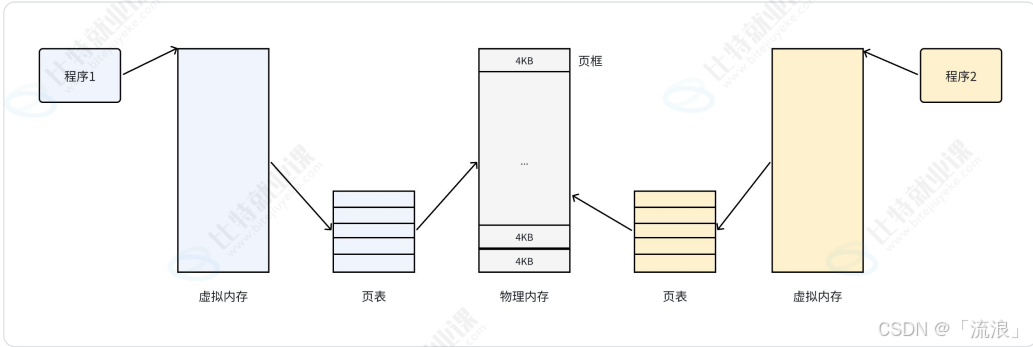
于是第一个结论出来了:整个体系的基本粒度是 4KB。而且这一刀不是随便切的,往下看它出现在多少个地方。
1.2 磁盘和内存,处处是 4KB
【衔接篇20】先看磁盘这一头。篇20 拆文件系统时讲过:磁盘硬件的最小读写单位是扇区(传统 512B),文件系统格式化时把连续 8 个扇区封装成 4KB 的块,文件哪怕只有 1 字节也要占一整块。所以磁盘上的数据,天然就是按 4KB 存的。 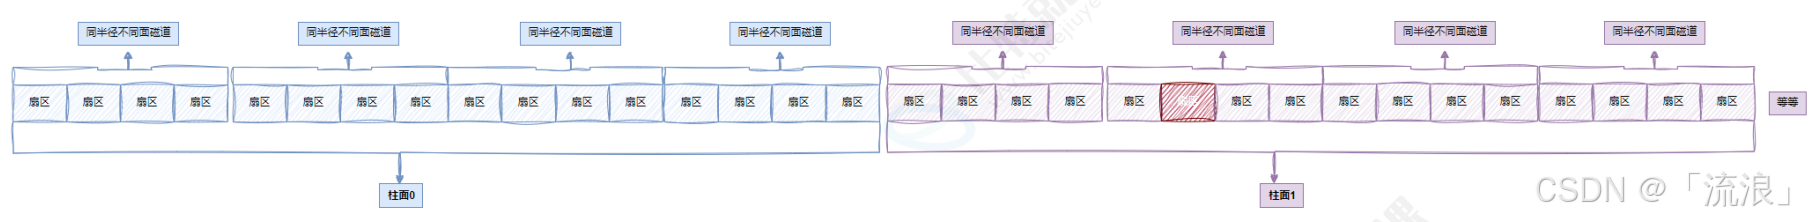
可执行程序本身就是文件——它躺在磁盘上的时候,就已经按 4KB 一段一段排好了。
再看内存这一头。内存的使用单位是字节,但管理单位是 4KB:物理内存被切成一个一个 4KB 的块,这个块就叫页框(也叫页帧)。
两头对齐之后,磁盘和内存之间的 IO 交换也以 4KB 为单位:一次搬一页,不多不少。这个 4KB 的粒度是操作系统定的,磁盘、内存、交换,全线统一。
1.3 处处 4KB 的连锁现象
粒度统一的好处是处处对得上。前面几篇反复出现过的现象,现在可以串成一条线:
| 写时拷贝 | 父子进程共享物理页,写入时按页复制 | 篇11 / 篇16 |
| 共享内存 | shmget 申请的物理内存以页为单位 | 篇25 |
| ELF 程序加载 | section 合并成 segment,按 4KB 对齐装入内存 | 篇21 / 篇22 |
| 文件存储 | 文件系统按 4KB 块分配空间 | 篇20 |
为什么这些操作全以页为单位?因为映射和分配的最小单位就是页——对齐粒度,才能一次到位。物理内存被切成了页框,接下来就该看操作系统怎么管这一大堆页框了。
二、OS 用数组管理页框
2.1 先描述 struct page
老规矩,操作系统管理任何资源都是两步:先描述,再组织——篇11 讲进程时立过这个方法论,管页框同样适用。
描述页框的结构体叫 struct page:物理内存里每一个 4KB 页框,都对应一个 struct page。它有三个核心参数:
- flags:状态位。记录页框当前的状态,比如 PG_locked(正在被内核操作,先锁住)、PG_uptodate(数据已就绪)等
- _mapcount:引用计数。有多少个虚拟地址映射到了这个页框——共享内存、共享库的页,这个计数会大于 1
- virtual:这个页框对应的虚拟地址,内核想访问页框内容时走它
/* include/linux/mm_types.h */
struct page {
/* 原子标志,有些情况下会异步更新 */
unsigned long flags;
union {
struct {
/* 换出页列表,例如由 zone->lru_lock 保护的 active_list */
struct list_head lru;
/* 如果最低位为0,则指向 inode
* address_space,或为NULL
* 如果页映射为匿名内存,最低为置位
* 而且该指针指向 anon_vma 对象
*/
struct address_space* mapping;
/* 在映射内的偏移量 */
pgoff_t index;
/* 由映射私有,不透明数据
* 如果设置了 PagePrivate,通常用于 buffer_heads
* 如果设置了 PageSwapCache,则用于 swp_entry_t
* 如果设置了 PG_buddy,则用于表示伙伴系统中的阶
*/
unsigned long private;
};
struct { /* slab, slob 和 slub 分配器 */
union {
struct list_head slab_list; /* 复用 lru 字段 */
struct { /* 部分页(partial pages) */
struct page* next;
#ifdef CONFIG_64BIT
int pages; /* 剩余的页数 */
int pobjects; /* 大约的对象数量 */
#else
short int pages;
short int pobjects;
#endif
};
};
struct kmem_cache* slab_cache; /* 不适用于 slob */
/* 双字对齐边界 */
void* freelist; /* 第一个空闲对象 */
union {
void* s_mem; /* slab:第一个对象的地址 */
unsigned long counters; /* SLUB 分配器使用 */
struct { /* SLUB 分配器 */
unsigned inuse : 16; /* 已使用的对象数目 */
unsigned objects : 15; /* 总对象数目 */
unsigned frozen : 1; /* 是否冻结 */
};
};
...
};
};
union {
/* 内存管理子系统中映射的页表项计数,用于表示页是否已经映射,
* 还用于限制逆向映射搜索 */
atomic_t _mapcount;
unsigned int page_type;
unsigned int active; /* SLAB 分配器使用 */
int units; /* SLOB 分配器使用 */
};
...
#ifdef defined(WANT_PAGE_VIRTUAL)
/* 内核虚拟地址(如果没有映射则为NULL,即高端内存) */
void* virtual;
#endif /* WANT_PAGE_VIRTUAL */
...
}
2.2 再组织 mem_map 数组
每个页框都有了描述符,接下来把它们组织起来。4GB 物理内存 ÷ 4KB = 1048576 个页框,于是用一个数组把所有描述符串起来:
struct page *mem_map[1048576]——数组下标就是页框编号,对页框的管理,从此变成对数组的管理。
操作系统管页框,面临的核心问题就一个:哪些 4KB 被占用了,哪些还空着?答案就在 struct page 的 flags 里——每个描述符都记着自己的状态:占用、空闲、保留。分配内存时扫数组找状态为空闲的项,释放时把状态改回去。
#define PG_locked 0 /* 页已加锁,别碰它 */
#define PG_error 1 /* 页发生错误 */
#define PG_referenced 2 /* 页最近被访问过 */
#define PG_uptodate 3 /* 页内容已从磁盘读全,数据是完整的 */
#define PG_dirty 4 /* 页是脏的,内容被改过还没写回 */
#define PG_lru 5 /* 页在 LRU 回收链表上 */
#define PG_active 6 /* 页在活跃链表上,最近常用 */
#define PG_slab 7 /* slab 调试用 */
#define PG_checked 8 /* 内核 2.5 早期就该删掉的残留 */
#define PG_arch_1 9 /* 架构相关,平台自定义 */
#define PG_reserved 10 /* 该页保留,不分配给用户空间 */
#define PG_private 11 /* ->private 字段里有东西(缓冲头等) */
#define PG_writeback 12 /* 页正在回写磁盘 */
#define PG_nosave 13 /* 系统休眠/恢复时使用 */
#define PG_compound 14 /* 这是复合页的一部分(巨型页) */
#define PG_swapcache 15 /* 交换页:private 字段存的是 swp_entry_t */
#define PG_mappedtodisk 16 /* 页在磁盘上已经分配了块 */
#define PG_reclaim 17 /* 等着被尽快回收 */
#define PG_nosave_free 18 /* 空闲页,不应该被写回 */
#define PG_buddy 19 /* 页是空闲的,挂在伙伴系统链表上 */
这个数组模型是 32 位下最直白的形态,对应内核文档里的 FLATMEM(平坦模型);现代 64 位机器物理内存布局不连续,内核改用 SPARSEMEM 把数组按区块管理——但思想没变:一个页框一个 struct page,管理结构跟上物理布局。
2.3 数组带来的红利
数组组织还有一个隐藏好处:知道下标,就等于知道物理地址。第 index 个页框的起始物理地址 = index × 4KB——下标和物理地址之间只隔一个乘法。
再算上页内偏移,完整的公式是:物理地址 = 页框起始地址 + 页内偏移。管理结构和物理布局严格对齐,这就是用数组组织描述符的回报。
三、申请物理内存的流程
3.1 申请流程就两步
把前面两章拼起来,申请物理内存的全过程就两步:
第一步,查 mem_map 数组,找到一个状态为空闲的 page——这一步解决「物理内存从哪来」。
第二步,建立页表映射——把虚拟地址和这个 page 背后的物理页框对上,这一步解决「虚拟地址怎么够到它」。映射建立好,这块内存才能用。申请多大内存,就走多少轮这个流程,每轮对应一个 4KB 页。
3.2 文件缓存场景,一个页框挂在多个数据结构里
读文件时,数据从磁盘搬进内存缓存起来,同样按 4KB 页存放。这些 page 除了在 mem_map 数组里有一席之地,还会挂进一棵按「文件偏移」组织的树里(基数树),树的 slots 指向 page——下次按偏移一查,直接命中缓存,不用再读磁盘。
struct radix_tree_node {
unsigned int height; /* 从这层往下还有几层 */
unsigned int count; /* slots 里有多少个非空项 */
struct radix_tree_node *parent; /* 父节点指针 */
void *slots[RADIX_TREE_MAP_SIZE]; /* 核心:存东西的槽位数组 */
/* 标签位图,用来快速查"所有脏页""所有正在回写的页" */
unsigned long tags[RADIX_TREE_MAX_TAGS][RADIX_TREE_TAG_LONGS];
};
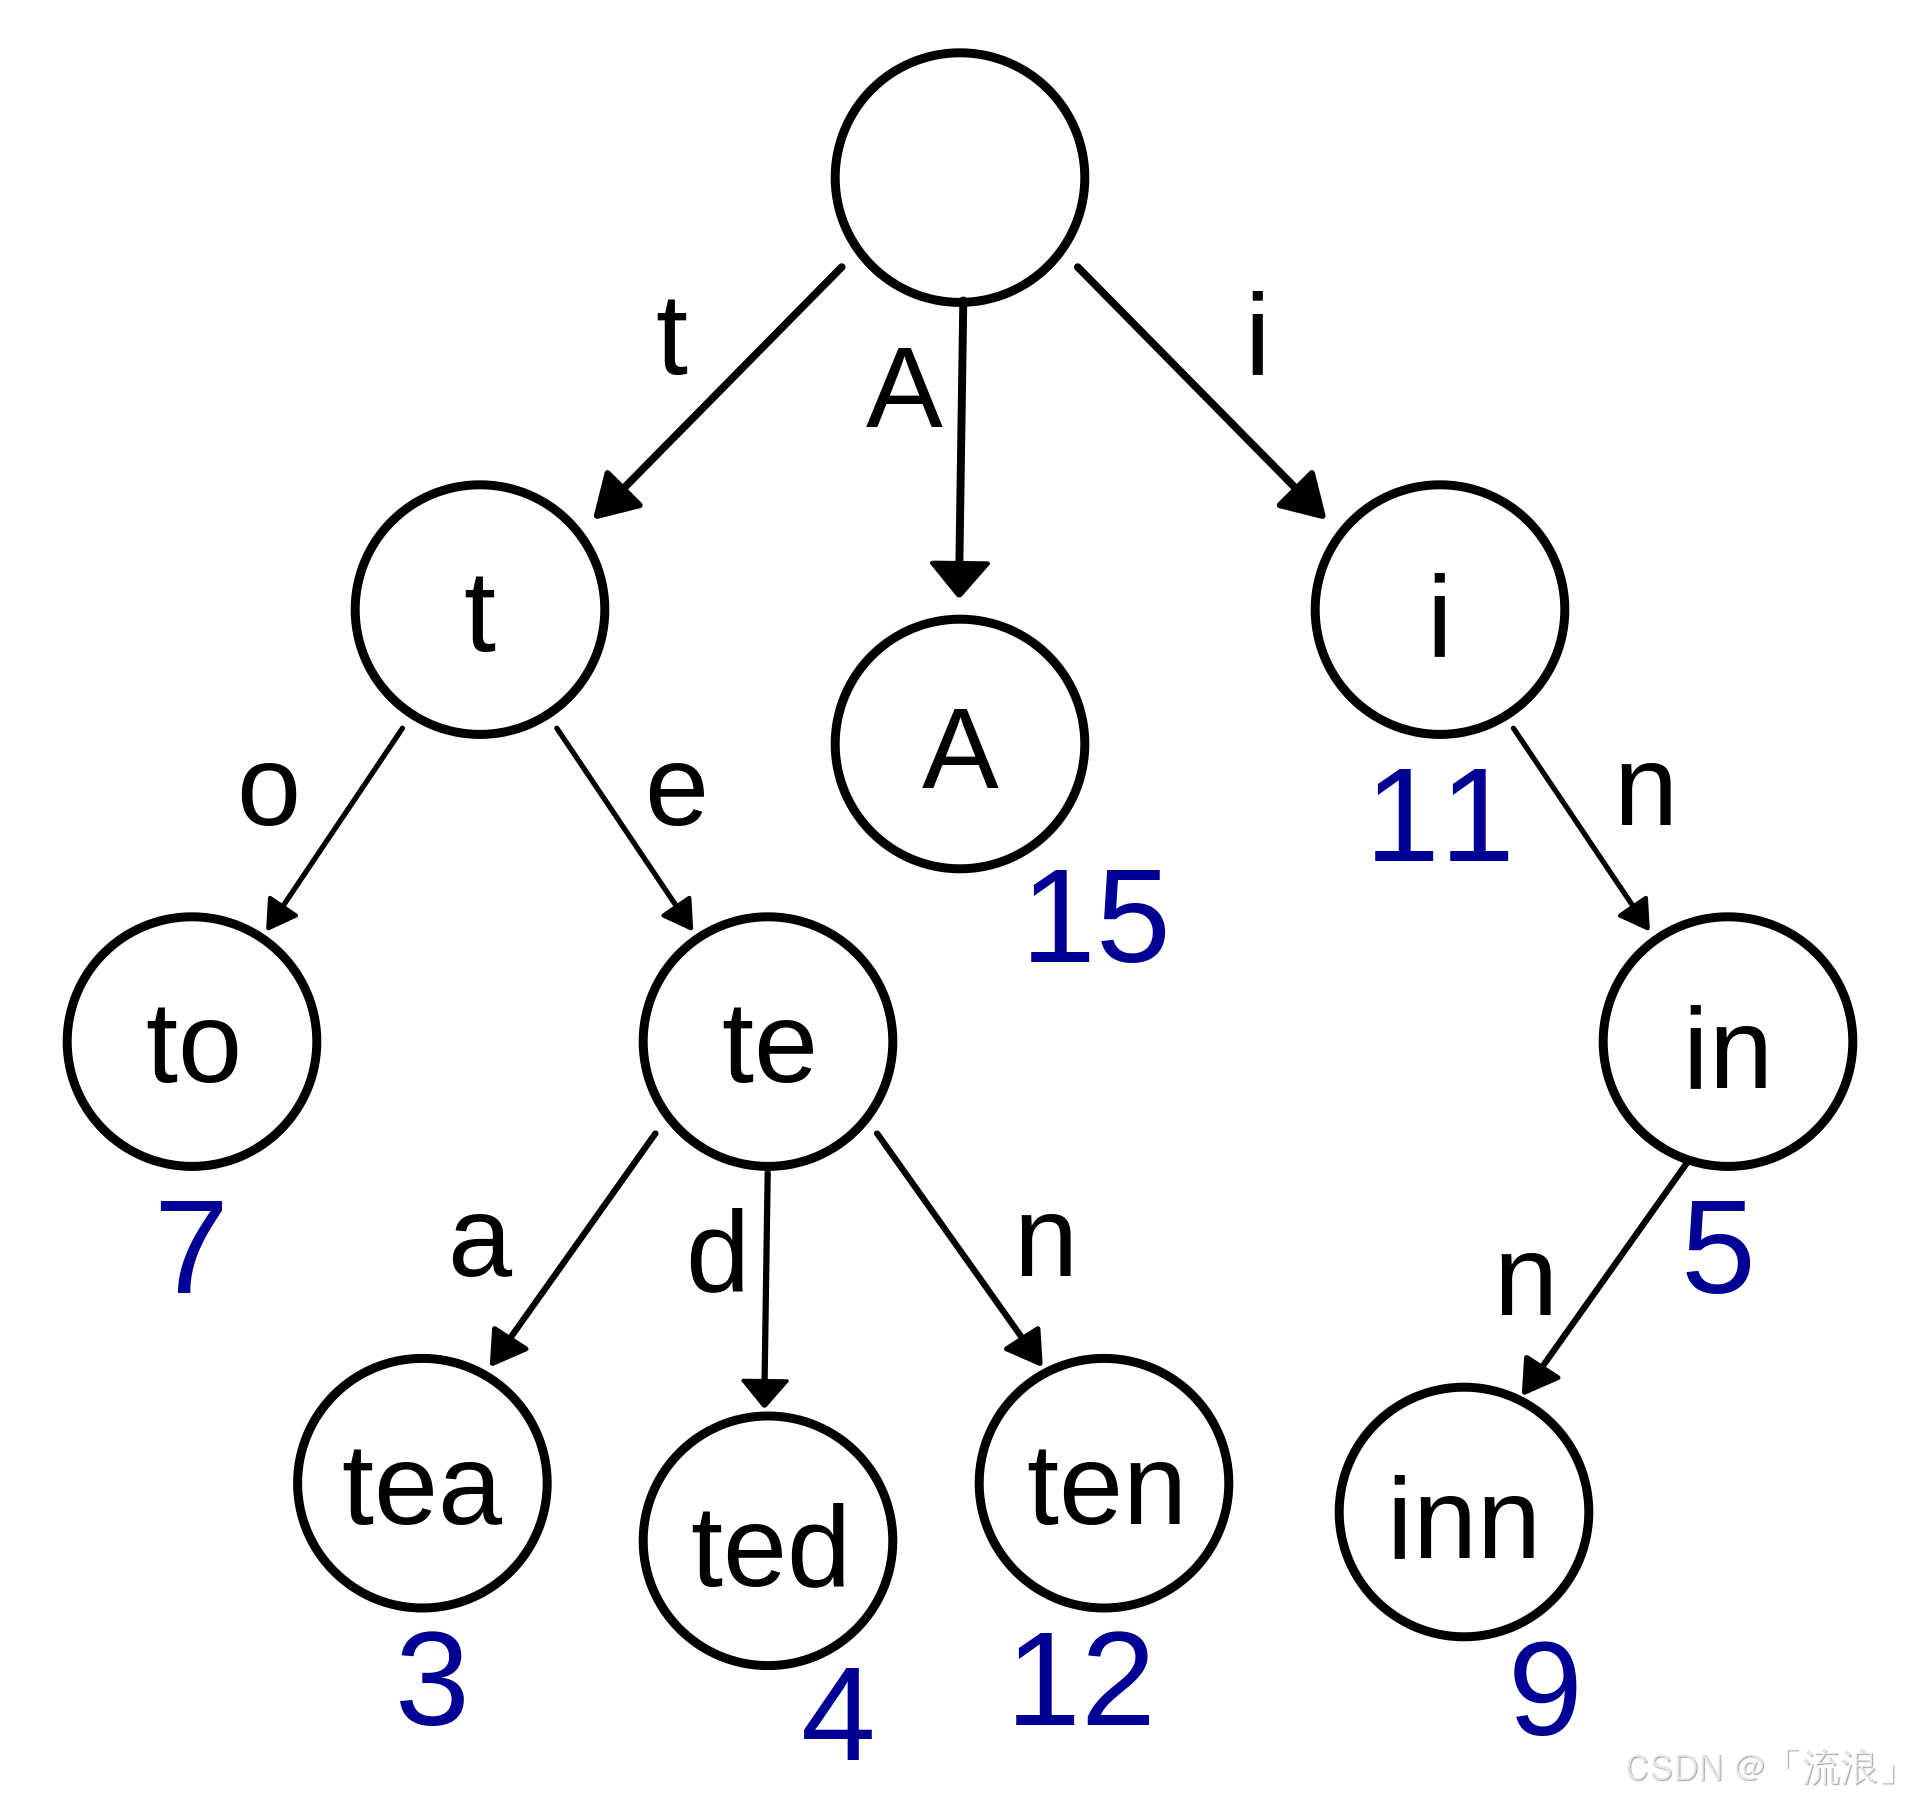
注意这里的关键事实:同一个页框,同时存在于多个数据结构中——mem_map 数组里挂着一份,文件缓存树里挂着一份,进程的页表里还要映射一份。三条线各自管理自己关心的维度,但指的是同一块 4KB 物理 内存。
补一句真实内核的演进:这棵缓存树早期叫 radix-tree,Linux 4.20 起换成了 XArray——接口更简洁、并发更友好,一页多挂的组织思想不变。
四、32 位下的两级页表
4.1 页表到底长什么样
先纠正一个直觉:页表不是一张表,而是一套。页目录存放下级页表的地址,页目录里的内容被称为表项,表项指向页表;页表里面是页的地址,指向真正的页框。 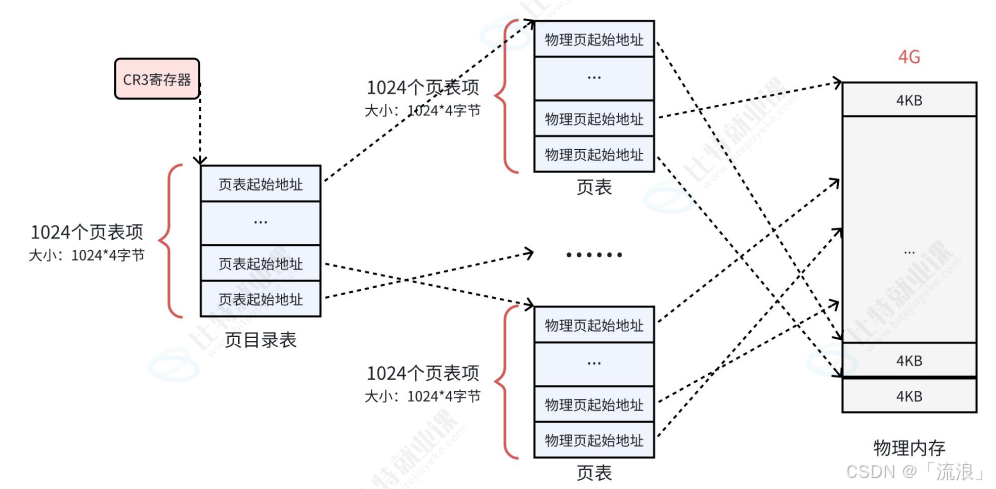
每个表项占 4 字节。页目录和页表本身也各占一个 4KB 页框——记住这个细节,马上要算账。
4.2 只用一张页表行不行
既然是映射表,为什么不干脆用一张大表把 4GB 全映射完?算笔账:4GB ÷ 4KB = 1048576 个页,每项 4B,一张全量表 = 1048576 × 4B = 4MB。这 4MB 是每进程一份,而且三个雷全踩:
- 太占内存:100 个进程什么都不干,光页表就吃掉 400MB
- 必须连续存放:一张大表要按下标索引,得占 4MB 连续物理内存——第一章刚骂过的连续分配老毛病又犯了
- 大多用不到:程序有局部性,实际活跃的地址区间很小,绝大多数表项建了从来没人查
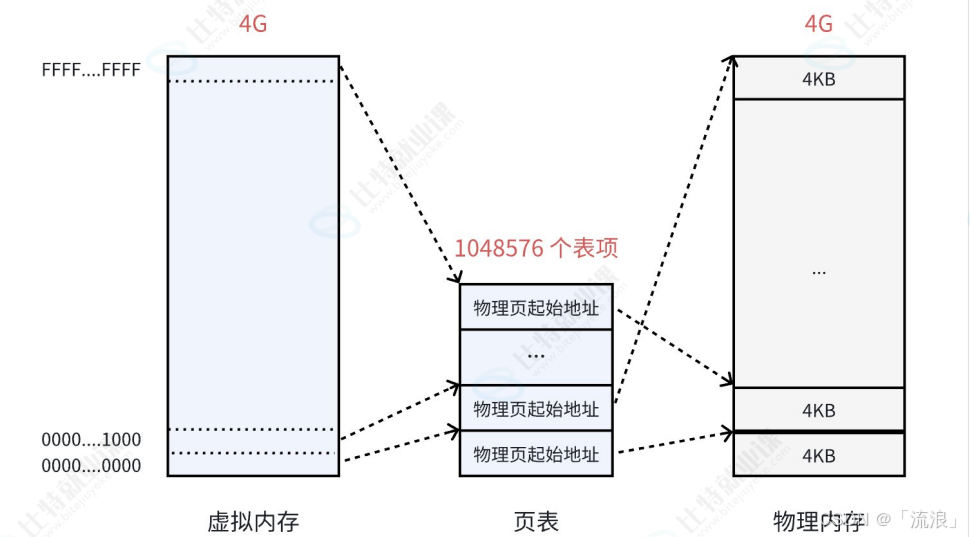
两级方案反着来:页目录常驻,只占 4KB;页表按需建——进程用到哪段虚拟地址,才为那段建页表。没用到的地址区间,页目录里对应的表项空着,下面整整一张 4KB 页表都省了。
| 固定开销 | 4MB / 进程 | 页目录 4KB + 按需的页表 |
| 存放要求 | 4MB 连续物理内存 | 每张表 4KB,各占一个页框 |
| 空地址区间 | 照样建满表项 | 表项空置,页表根本不建 |
4.3 虚拟地址划分 10 加 10 加 12
两级体系下,32 位虚拟地址被切成三段:高 10 位是页目录索引,中间 10 位是页表索引,低 12 位是页内偏移(Intel SDM Vol.3A 的 32 位分页格式)。
为什么各是 10 位?页目录、页表都是 4KB 页框,里面装 4KB ÷ 4B = 1024 个表项,寻址 1024 个下标正好要 10 位。这也回应了 4.1 的细节:一张页表本身就占一个页框——1024 项 × 4B = 4KB,分毫不差。
那为什么低 12 位不用翻译?两个原因叠出来。【衔接篇21/22】 其一,从 ELF 文件的角度:程序加载时 section 合并成 segment、按 4KB 对齐装入内存——页内的排布在加载时就定死了。
其二,从局部性原理的角度:程序一段时间内只密集访问少数几页。翻译要解决的问题是「哪一页」(高 20 位),而「页内第几个字节」这件事,虚拟地址和物理地址天然一致——数据整页搬过来的,页内排布没变,低 12 位直接照抄。 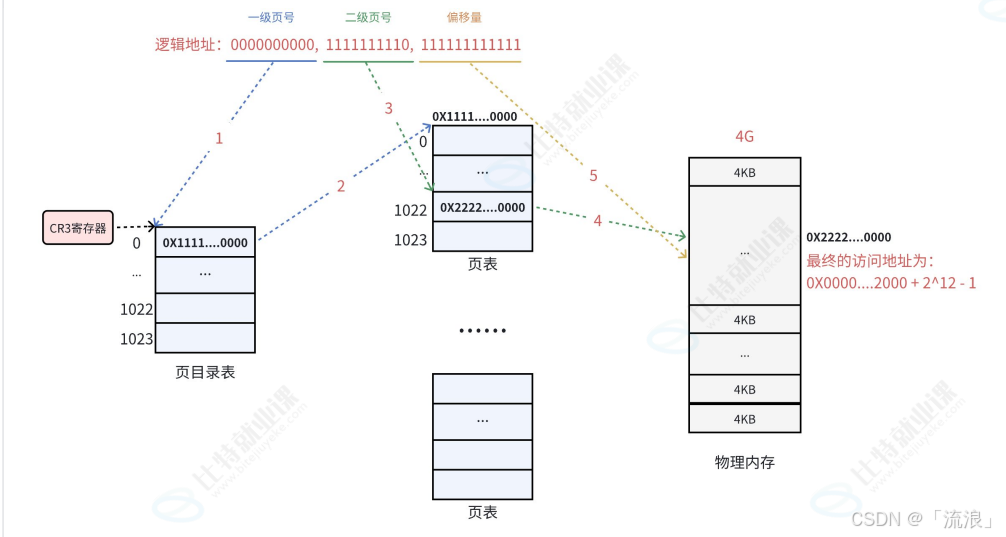
4.4 虚拟地址是索引,物理地址是目标
每个进程都有一套自己的「页目录 + 页表」映射体系,规则一句话:虚拟地址是索引,物理地址是目标。拿虚拟地址的高 20 位当索引,在页目录和页表里逐级查,查出页框号;拼上原样保留的低 12 位偏移,得到物理地址。
写成公式:物理地址 = 页框地址 + 虚拟地址低 12 位。和 2.3 的数组红利对照着看:页框地址 = 页框号 × 4KB,两条路殊途同归。
4.5 线程划分地址空间,本质上就是划分页表
【衔接篇36】 篇36 讲线程时留了句压箱底的话,现在底牌可以掀了:线程进行资源划分,本质是划分地址空间,获得一段合法的虚拟地址——在本质,就是在划分页表。一个线程「拥有」多少资源,就看映射体系里多少页表项指向了它有权访问的页框。
同理,线程进行资源共享,本质是共享虚拟地址——在本质,就是共享页表条目。同一进程的线程们看到的「同一份地址空间」,落到硬件上就是:大家的地址翻译用的是同一套页表。篇36 的所有结论,在这张映射体系里全部落地。
五、MMU 翻译和 CR3控制
5.1 翻译分两个阶段
虚拟地址到物理地址的翻译,分两个阶段。第一阶段:拿虚拟地址的高 20 位查映射体系,找到对应的页框。
第二阶段:取虚拟地址低 12 位作为页内偏移,在页框内访问具体字节。两步拼起来,就是 4.4 的公式落到了硬件上。
这个翻译不是软件干的——CPU 内部有个专门硬件叫 MMU(内存管理单元),页表查询、地址拼接全自动完成。软件只负责把页表建好、把 MMU 指对地方。
5.2 CR3 指向当前进程的页目录
- CR3 是 CPU 里的一个控制寄存器,专门存 “当前进程的页表在哪”。
每个进程一套映射体系,那 MMU 翻译时查的是「当前进程」的那套——怎么知道当前是谁?CPU 里的 CR3 寄存器存着当前进程页目录的物理地址,它是进程的硬件上下文之一。
所以进程切换时,上级页表也要切换:内核调度代码里,切换地址空间的动作就是换 CR3(真实内核路径是 switch_mm() → load_cr3(next->pgd))。CR3 一换,整套页表就换了,同一个虚拟地址立刻翻译到不同的物理内存——这就是进程隔离在硬件层的开关。
【衔接篇12】 篇12 讲调度切换时列过上下文切换的开销,这里补上最重的一块:换 CR3 不只是写一个寄存器,还会让 MMU 里的翻译缓存大面积作废(第七章展开)。进程切换贵,贵有贵的道理。
5.3 同进程线程切换,不换 CR3
顺着推一个延伸结论:同一进程的线程切换,CR3 根本不用动。线程共享地址空间(篇36),也就是共享 mm_struct、共享页目录——切换前后 MMU 查的是同一套页表。
线程切换比进程切换快,这是其中一层硬道理:省掉页表切换,翻译缓存也不用作废。篇36 对比表里的「切换开销小」,到这里有了完整的硬件解释。
六、缺页中断建立映射
6.1 缺页异常怎么触发
MMU 翻译时查页表,如果发现表项的 PRESENT 位是 0——这页根本不在物理内存里,翻译走不下去。CPU 立刻触发缺页异常(页错误,#PF),暂停当前指令,陷入内核。 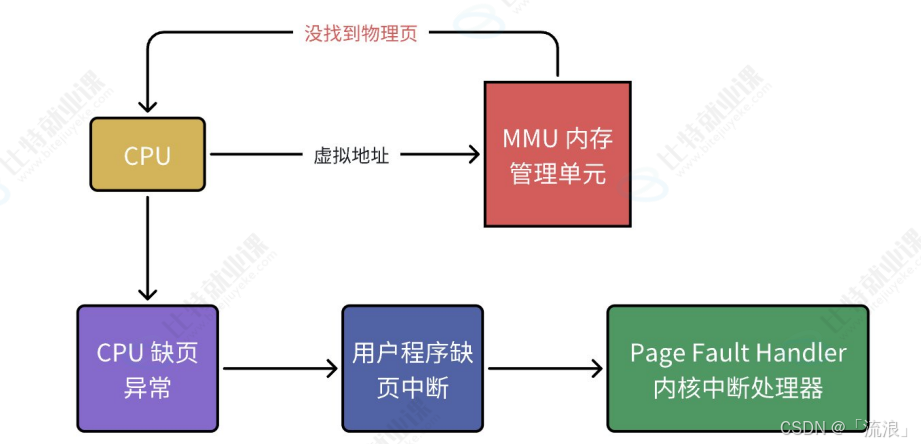
内核接手后走完整流程:找到空闲 page(数据在磁盘上的先把数据搬进来)→ 填写物理页框地址 → 补上页表映射 → 重新执行刚才触发缺页的那条指令。这次翻译就通了。
6.2 缺页的三种情况
同样是缺页,内核的处理天差地别,分三种情况:
- Major 缺页(硬缺页):页框不在内存,数据还在磁盘上——必须先读盘再建映射,要等 IO,慢
- Minor 缺页(软缺页):页框其实已经在内存里了,比如共享库别的进程早就加载过——只缺映射,建好映射就完事,快
- Invalid(无效访问):访问的地址根本不合法,越界野指针都算——没得救,内核发 SIGSEGV,段错误杀进程。信号怎么递达、默认动作是什么,信号系列(篇29–35)已经讲透
6.3 三类建映射的场景
把本篇出现的场景收拢一下——写时拷贝、缺页中断、内存申请,三件事看起来不同,内核动作却是同一件:建页表、建映射。
| 内存申请 | malloc / shmget 拿到内存后首次访问 | 查数组找空闲 page,填映射 |
| 缺页中断 | 访问的页不在物理内存 | 读盘或复用已有页框,补映射 |
| 写时拷贝 | 父子进程写共享页 | 按页复制新页框,改映射指向 |
映射一建立,虚拟到物理就通了。这三类场景贯穿了进程、通信、线程几条主线——它们都是页表体系的不同入口。
6.4 顺手看穿 malloc 的底层
用 6.1 的机制回看 malloc:它只是给你登记了一段虚拟地址,物理页一个都没分。等你真正读写那块内存,缺页异常触发,内核这才分配物理页、建立映射——这叫按需分配。
这也解释了为什么 malloc 一个大内存块「秒完成」:账先记上,钱在你真花的时候才扣。面试里「malloc 的内存物理上立刻就有了吗」——答案就藏在缺页异常里。
七、多级页表和 TLB
7.1 多级页表的代价
多级页表在减少连续存储需求、减少储存空间的同时,降低了查询效率。两级映射要查两次表,64 位系统普遍四级甚至五级——每次查询都是实打实的内存访问。
省空间和快,天生是一对矛盾:表拆得越碎越省,查得就越慢。矛盾不能靠歪门邪道化解,只能靠硬件加一层缓存——于是就有了 TLB。
7.2 TLB 工作原理
TLB(快表) 是 MMU 里的一小块高速缓存,缓存最近用过的页表项。翻译时 MMU 先查 TLB:命中——直接拿到页框号,页目录页表一个都不用碰;未命中——老老实实走多级查询,查完把结果填进 TLB,同一页下次再访问就是命中。 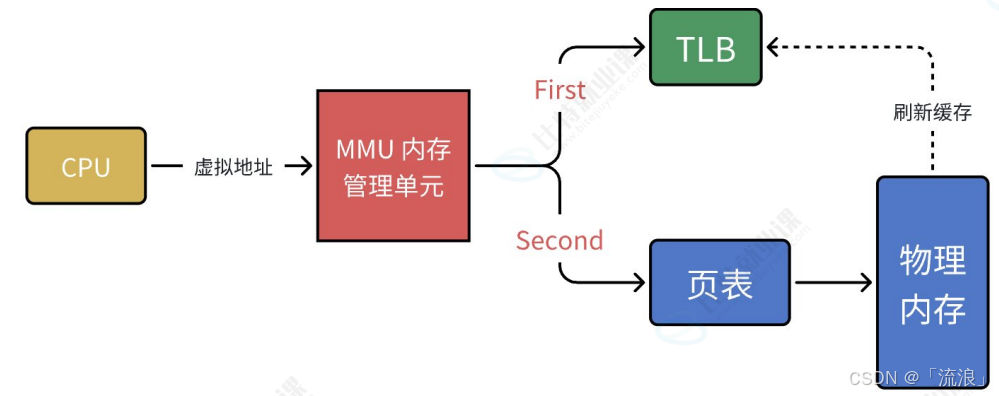
TLB 什么时候失效?5.2 埋的伏笔在这收:进程切换换 CR3,翻译缓存跟着作废——新进程的映射体系和旧进程完全不同,旧缓存必须清掉。所以切换频繁的系统 TLB 命中率会抖。现代 CPU 用 PCID 给每个地址空间打标签,切换时可以不全刷。
八、全篇总结
收拢成一条线。粒度线:4KB 贯穿磁盘块、页框、IO 交换、写时拷贝、共享内存、segment 加载——处处对齐,一次到位。
- 管理线:先描述(struct page:flags / _mapcount / virtual),再组织(mem_map[1048576]),管理页框 = 管理数组;下标 × 4KB 直接算出物理地址
- 映射线:单级全量表 4MB / 进程且要求连续,两级方案页目录常驻 4KB、页表按需建;地址切 10 + 10 + 12,高 20 位翻译、低 12 位透传
- 硬件线:MMU 两阶段翻译;CR3 存当前进程页目录,进程切换换 CR3,同进程线程切换不换
- 建映射三场景:内存申请、缺页中断、写时拷贝——内核动作同一件;缺页分 Major / Minor / Invalid 三种处理
- 效率线:多级页表省空间但查询变慢,TLB 缓存表项补回速度,换 CR3 时缓存作废
到这里,篇36 的线程共享地址空间、篇15 的虚拟地址空间,全部在页表这套体系里接上了地气。
九、面试官爱问(带答案)
9.1 为什么用两级页表,不用一张大表?
答(推导):一张全量表要 4GB÷4KB×4B = 4MB,每进程一份、必须连续存放,而局部性原理决定大多表项没人查。两级方案页目录常驻 4KB,页表按需建,没用到的地址区间连页表都不存在——省内存、免连续、贴局部性。
9.2 32 位下虚拟地址怎么一步步变成物理地址?
答(推导 · 已对照面经,转述):虚拟地址切三段——高 10 位索引页目录(CR3 提供页目录基址),中 10 位索引页表,低 12 位是页内偏移。MMU 先查 TLB,未命中则走两级查表得到页框号,最后物理地址 = 页框地址 + 低 12 位偏移,偏移不做翻译直接透传。
9.3 什么是缺页中断?触发后发生了什么?
答(推导 · 已对照面经,转述):MMU 查页表发现 PRESENT 位为 0(页不在物理内存),CPU 触发 #PF 异常陷入内核。内核分情况处理:Major 缺页读盘建映射,Minor 缺页只建映射,Invalid 直接 SIGSEGV 杀进程。处理完填好页表项,重新执行触发缺页的指令。
9.4 TLB 是什么?为什么快?什么时候失效?
答(推导 · 面经高频,转述):TLB 是 MMU 内部缓存页表项的高速缓存。命中时一步拿到页框号,省掉多级查表的多次内存访问,所以快。进程切换写入 CR3 时旧翻译缓存作废(非全局项全部清空);现代 CPU 的 PCID 机制按地址空间打标签,可避免全量刷新。
9.5 malloc 之后物理内存立刻就有了吗?
答(推导):没有。malloc 只登记虚拟地址区间,物理页按需分配——首次访问触发缺页异常,内核才分配物理页并建立映射。这也是 malloc 大块内存很快、而首次访问变慢的原因。
9.6 为什么线程切换比进程切换快?
答(推导):同进程线程共享 mm_struct 和页表(共享地址空间),切换时 CR3 不用换、TLB 不用作废;进程切换要换 CR3,翻译缓存大面积失效,之后一段时间的查表开销都会上升。
9.7 同一个物理页框,内核里有几份管理数据?
答(推导):至少三处——mem_map 数组里的 struct page 描述符(全局唯一),文件缓存树(基数树)里挂一份,映射它的每个进程页表里还有表项。struct page 的 _mapcount 记录被映射次数,共享内存和共享库的页计数大于 1。
9.8 缺页了就一定要读磁盘吗?
答(推导 · 已对照面经,转述):不一定。Major 缺页才读盘(数据只在磁盘);Minor 缺页页框已在内存(共享库、共享内存场景),只需建立映射;Invalid 根本不处理,直接 SIGSEGV。三者开销相差数量级,也是性能分析里区分 major/minor fault 的原因。
💬 从磁盘上的一个 4KB 块,到页框、struct page、两级页表,再到 MMU 的一次翻译——篇36 那句「线程划分地址空间本质是划分页表」,到这里真正落了地。你写的每一行代码访问的每一个地址,背后都是这套机制在兜底。觉得有收获,点个赞再走。