当 AI 说起人话,数据却失语了——智能数据库的语言学
一句话主旨 2026 年,大模型终于把"人话"说得滴水不漏,但企业数据还没学会"被读懂"。本文借符号学的三把刀——语法学、语义学、语用学——切开数据库五十年历史:1970 年,Codd 教会了数据造句;2026 年,DolphinDB 与 DolphinX 开始教会数据被读懂。结构、时间、空间之后,智能数据库的第四块拼图,是语义。
系列说明 本系列四篇各占一个正交维度:《当数据库长出大脑》讲结构(五层架构解剖),《三百年时延坍缩史》讲时间,《数据的引力》讲空间。本篇补上第四个维度——意义:智能与数据之间隔着的三层语言关系。结构 × 时间 × 空间 × 意义,四篇互不重叠。
序章 | 一问三不知:直播间里那道无人能答的题
2026 年 8 月 20 日晚,DolphinDB 与 EMQ 的联合直播《打造 AI 时代更轻、更实时的数据底座》进行到中段,出现了这样一个瞬间。一位运维人员向 Agent 提问:
“过去 24 小时哪些设备温度异常?”
主持人的回答值得整段抄录——一个能进入生产环境的企业级 Agent,需要清楚知道:数据在哪里、传感器表是什么、字段和单位是什么、异常阈值如何定义,以及是否需要结合告警和维修记录进行综合判断。
五个"知道",没有一个与模型有关,全部与语言有关:字段叫 WZ_TD_03 还是 temp_sensor_3?单位是摄氏度还是开尔文?"异常"是超过 85℃ 还是偏离工况基线两个标准差?这些信息不在数据里——它们在数据字典的某页 PDF 里,在三年前离职的工程师的笔记里,在老师傅的肌肉记忆里。
数据不缺数值,缺释义。
这不是某一家企业的疏漏,而是整个行业五十年的结构性欠账。符号学家查尔斯·莫里斯(Charles W. Morris)在 1938 年的《符号学基础》中,把一切符号系统切为三层(Morris, Foundations of the Theory of Signs, 1938):
用这把刀切开数据库五十年,会看到一个安静的事实:
过去五十年,数据库工业把语法学做到了极致;语义学被外包给了文档与"老师傅",语用学被外包给了口口相传。只要提问的还是人类,这套安排勉强运转——因为人类自带语义与语用。当提问者换成 AI,两笔欠账一次性到期。
本文讲三件事:一部只有语法的数据库史(第一章)、一部正在补写的词典(第二章)、以及一场正在发生的语用革命(第三章),最后抵达整座工厂说同一种语言的现场(第四章)。
第一章 | 语法学(1970–2016):数据学会了造句,却不知自己在说什么
1.1 Codd 颁布的第一部语法
1970 年 6 月,IBM 研究员埃德加·科德(E. F. Codd)在《美国计算机学会通讯》发表《大型共享数据库的数据关系模型》(Codd, CACM, 1970, 13(6): 377–387)。在此之前,数据的世界是"导航式"的:程序必须知道数据躺在磁盘的哪个角落、沿哪条指针链行走——数据的物理栖身之处,与提问者的意图,被迫使用同一种语言。
Codd 的洞见是一次彻底的语法革命:把物理存储与逻辑结构分离,一切数据皆可表述为"关系"(表),一切访问皆可表述为关系代数的运算。主语(FROM 哪张表)、谓语(WHERE 什么条件)、宾语(SELECT 哪些列)——SQL 从此成为一门严格的形式语言,落在乔姆斯基层级(Chomsky, 1956)的上下文无关文法之内,机器可以精确解析、优化、执行。1986 年,ANSI 将其立为美国国家标准(ANSI X3.135)。
有一个常被忽略的细节:SQL 的前身名叫 SEQUEL——Structured English Query Language,“结构化英语查询语言”(Chamberlin & Boyce, SIGMOD, 1974)。数据库行业从第一天起就想让数据库"说人话",但当年的技术只容得下"结构化"三个字,容不下"英语"——自然语言被驯化成了形式语言,人则被要求去学机器的话。这个未兑现的承诺,一等就是五十二年。
1.2 时序数据库:时间的变位法
此后半个世纪,语法学一路添砖加瓦。最丰富的一支方言,长在时间上。
时序数据需要的远不止 SELECT 与 WHERE:窗口聚合是时态,asof join 是过去完成时,会话窗口是断句,乱序修正是不规则动词的变位。时序数据库因此成为数据语法学最精密的分支——它把"时间语法"从查询语言下沉到了计算引擎。DolphinDB 以高性能分布式时序数据库为内核(DB-Engines 时序数据库类别全球排名第五、国内第一),内置 2000+ 时序分析函数、流批一体,本质上是给"何时发生"颁发了一整套完整的词法与句法。
但恰恰是这套最精密的语法,暴露了语法的天花板。
1.3 语法的天花板
看一张完全合法的表:
ts device WZ_TD_03
2026.08.20T14:23:01 PLC-2024 85.7
2026.08.20T14:23:02 PLC-2024 86.1
语法无懈可击:时间戳精度到秒,字段类型正确,主键有序。但 WZ_TD_03 是什么?装在哪套装置上?85.7 的单位是什么?意味着正常还是报警?——语法一个字也回答不了。
于是五十年来,语义被外包了:外包给数据字典文档(三个月后悄然过期),外包给 ETL 作业里的注释,最终外包给一句"去问老王"。老王,就是企业的活体数据字典。
语法解决"怎么问",语义解决"问的是什么",语用解决"谁在问、为何问"。前五十年,数据库工业把第一件事做到了极致,把后两件事留给了口口相传——直到 AI 进厂,替所有人交卷。
第二章 | 语义学:给数据库编一部词典,把罗塞塔石碑刻进库里
2.1 语义税:那张 80% 的账单
语义的欠账值多少钱?EMQ 联合直播给出了第一手的度量。DolphinDB 解决方案总监林亮基于客户调研指出:
企业智能化团队 80% 的时间耗费在底层数据基建上——打通实时数据通道、对齐数据元信息、清洗杂乱数据、准备复杂技术栈;仅剩 20% 留给业务模型调优与价值闭环。
细读这份清单:四项开销里,"对齐数据元信息"是编词典,"清洗杂乱数据"是正音注疏——那张 80% 的基建税单,一半以上其实是语义税。 行业以为自己在为算力付费,其实一直在为释义付费。
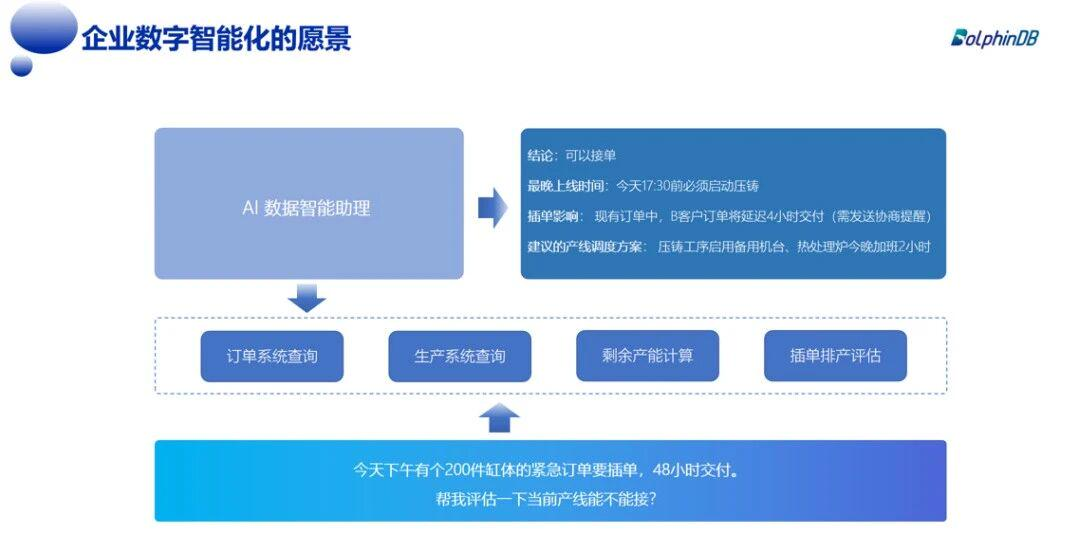
图片来源:DolphinDB 官方公众号《直播回顾 | DolphinDB × EMQ:打造 AI 时代更轻、更实时的数据底座》(2026.08.23)
2.2 罗塞塔石碑:词典必须刻在数据旁边
语义学如何入库?两百年前有一块石头给出过答案。
1799 年,尼罗河三角洲的罗塞塔镇出土一块石碑:同一段诏书,以埃及圣书体、埃及世俗体、古希腊文三种文字并列刻写。正是这块"平行文本",让让-弗朗索瓦·商博良在 1822 年借古希腊文这把已知语言的钥匙,破译了失传一千余年的圣书体——埃及三千年历史从此可读。
罗塞塔石碑的启示只有一条,却常被违反:
**破译的前提,是"未知文字"与"已知文字"刻在同一块石头上。**原始数据是圣书体,字段描述是希腊文——分开放的"数据字典",等于把罗塞塔石碑凿成三块,分藏三家博物馆,然后指望破译者跑着看。
2026 年 7 月发布的 DolphinDB V3.00.6,做的是把石碑刻回一块石头上的事:表字段描述从 256 字节扩展到 1024 字节,新增 Catalog 与 Schema 层级描述——业务知识以元数据形式沉淀进数据库本身,Agent 即刻读懂任何一张表。配合外部表能力实时接入 MySQL、SQL Server 等历史系统,官方给出的落地要诀正是"统一数据字典:一次性维护好元信息后,AI 可从 DolphinDB 统一理解内部表与外部源"。
这是数据库五十年历史上第一次:语义学从"文档的附录",升格为"库的一等公民"。
2.3 双引擎:词法与语义的复调
有了词典,还要有检索信道。这里藏着自然语言问数最深的暗礁:用户嘴里的"温度异常",与字段名 WZ_TD_03 之间没有任何词法重叠——纯关键词检索在此彻底失灵,必须靠语义向量找近邻;反过来,“85℃”"PLC-2024"这类精确术语,又只有词法匹配才能保证不错位。
这不是新问题,而是信息检索领域的经典结论:BM25 一族的词法检索(Robertson & Zaragoza, 2009)与稠密向量语义检索(Karpukhin et al., Dense Passage Retrieval, EMNLP 2020)各有盲区,工业界的答案是混合检索。DolphinDB 官网 AI 页对 DolphinMind 智能体的架构描述正是这一结论的产品化——“混合检索 + 多路召回 + 重排序”,语义与词法双重检索,确保每一个答案"查有实据、消除幻觉"。其底层是 TextDB(全文与词法)+ VectorDB(向量与语义)双引擎,全程库内运行,无需外置向量库。
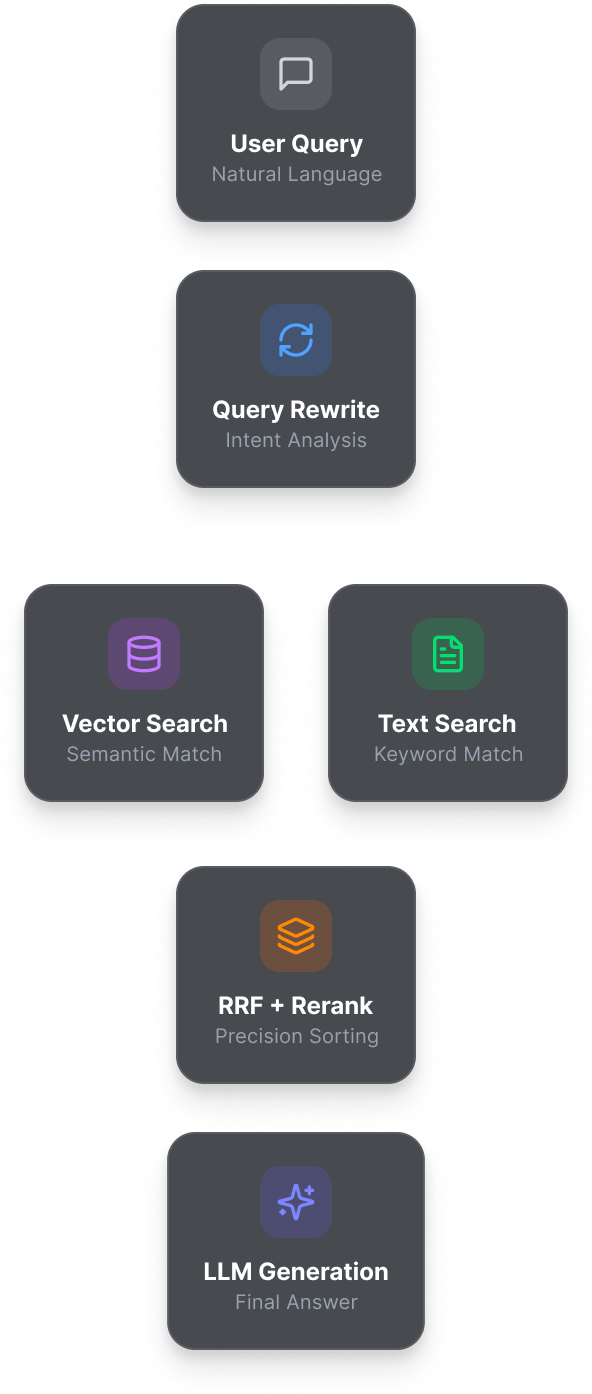
图片来源:DolphinDB 官网 AI 产品页《下一代 AI 实时计算与数据的基础设施》
第三章 | 语用学:同一句话,总行和支行听见不同的答案
3.1 意义即用法
语义学之上还有一层。维特根斯坦在《哲学研究》第 43 节写下那句著名的话:“一个词的意义,在于它在语言中的使用。”(Wittgenstein, Philosophical Investigations, 1953, §43)
数据库世界对这句话早有体感。同一句"查一下客户 A 的持仓"——总部分析师问,是研究;支行客户经理问,是服务;监管员问,是核查。同一句话,说话人不同,合法边界不同,答案本就应当不同。 传统系统里,这件事靠"为每个角色各开发一套报表"来实现:语义没变,语用被硬编码在界面里——僵硬、昂贵、永远追不上组织的变化。
3.2 以人定权:语用的第一次原生表达
DolphinX(内嵌于 DolphinDB V3.00.6 的企业级 Agent 开发与治理平台)给出的答案是权限继承:DolphinX 复用 DolphinDB 完善的权限管理体系,Agent 调用任何能力时,自动继承当前操作用户的权限。总部分析师与支行客户经理用同一个 Agent 问同一句话,得到天然不同的答案——这不是缺陷,这是语用学第一次被数据库原生表达:意义因人而异,且差异服从同一套权限语法。这套权限体系已在头部金融机构与电网企业运行多年,细粒度覆盖库、表、函数、任务、技能与 MCP 工具,支持角色继承与多租户隔离。
3.3 组织的语用学:记忆、技能与那本越写越厚的笔记
比"因人而异"更深的一层,是"因组织而异"——同一个词,在这家企业里有只有自己人才懂的用法。DolphinX 把这种组织语用做成了三类可积累的资产:
-
长期记忆:会话闲置 6 小时后自动提炼"业务规则、踩坑经验、用户偏好",分为 Agent 公共记忆与用户私有记忆,来源可追溯——组织开始把"我们这儿的话这么说"沉淀为资产。
-
Skill 技能体系:内置 20+ 官方 Skill(Dlang 智能编程、数据导入、策略回测、机器学习、金融业务、流计算、运维等,开源在 GitHub)。Skill 的本质不是"工具",而是制度化的语用——策略回测必须规避"未来函数"偏差、FICC 定价有行业惯例:这些不是数据的语义(数据是什么),是组织的语用(我们怎么用它)。
-
Obsidian 知识笔记(2026 年 7 月上线插件市场):跑完分析,一行代码把结论写成结构化笔记——因子 IR、换手率、交易信号,自动追加进当日日记;一个月后,30 条分析记录直接交给 AI 写季报。官方的一句话说得极准:“你不是在保存数据,而是在为 AI 搭建一个可以长期使用的记忆库。” 这是在给语义(字段)之外,补上语用(结论、标签、上下文)的沉淀。
3.4 问责的语用:审计即留痕
语用的最后一环是责任。DolphinX 的全链路审计让每一次提问都成为时间轴上的事实:谁、何时、问了什么、读了哪条数据、调用了哪个 Skill、模型返回了什么。半年后发现某份报告有误,工程师可以逐帧回放。
语用学三支柱:以人定权(意义因人而异)、记忆与技能(意义因组织而异)、审计留痕(意义可追责)。三者齐备,AI 才从"会答话"走到"敢担责"。
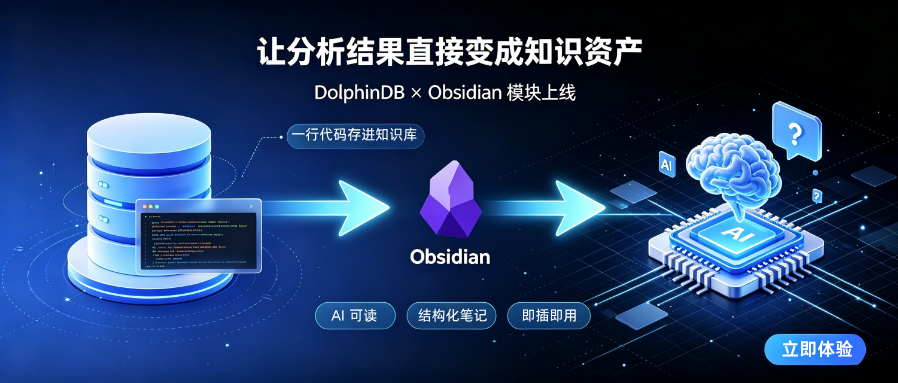
图片来源:DolphinDB 官方公众号《DolphinDB × Obsidian:把你的数据变成 AI 能读的知识库》(2026.07.15)
图片来源:DolphinDB 官网《V3.00.6 & V2.00.19 正式发布!》(2026.07.08)
第四章 | 通天塔施工记:当整座工厂开始说同一种语言
4.1 机器的方言
《创世记》里,人类合力建塔通天,神变乱了他们的语言,工程自此停摆。工业企业不需要读这则寓言——它们生活在寓言里:PLC 说 Modbus,SCADA 说 OPC UA,MES 说自家的 SQL 方言,行情网关说二进制私有协议,日志说 JSON。AI 进厂的第一天,撞上的不是算力墙,是巴别塔。
传统的解法是翻译再翻译:业务系统 → 消息系统 → 流处理 → ETL → 数据存储 → 分析平台 → AI/BI。六级链路,每一跳都是一次翻译,每一次翻译都在丢语义、加延迟、添故障点——语义税的又一种征收方式。
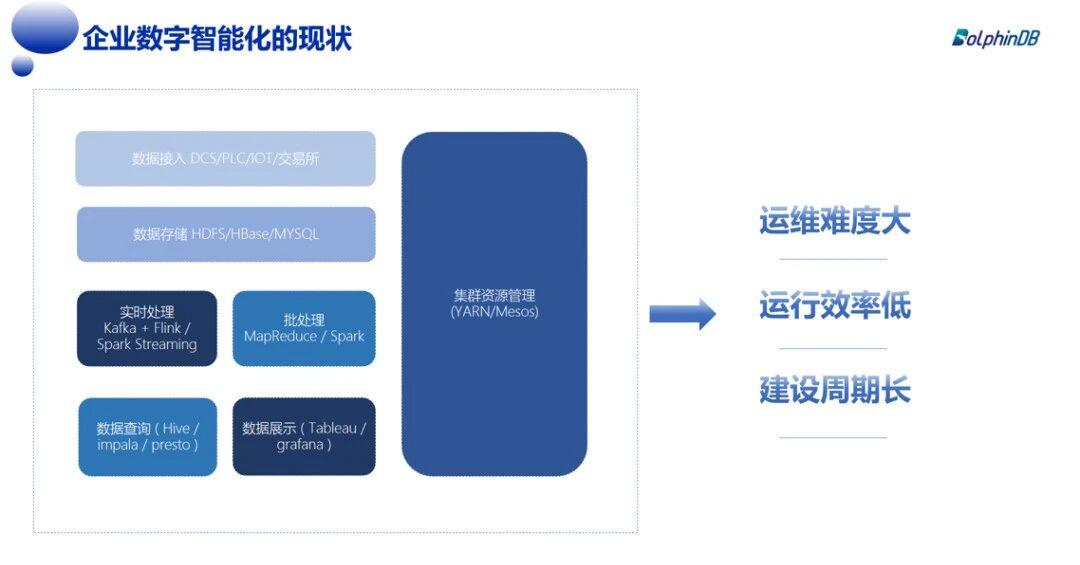
图片来源:DolphinDB 官方公众号《直播回顾 | DolphinDB × EMQ》(2026.08.23)
4.2 三跳,与一部统一的词典
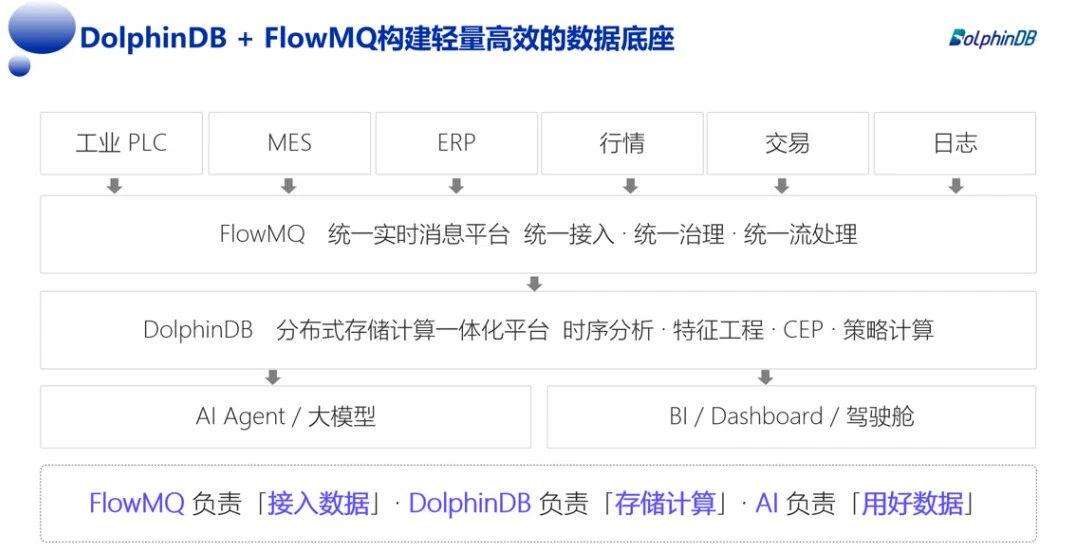
2026 年 8 月,DolphinDB 与 EMQ 的联合方案把六级坍缩为三跳:
数据源(PLC / SCADA / MES / ERP / IoT)→ FlowMQ → DolphinDB → AI / BI / Dashboard
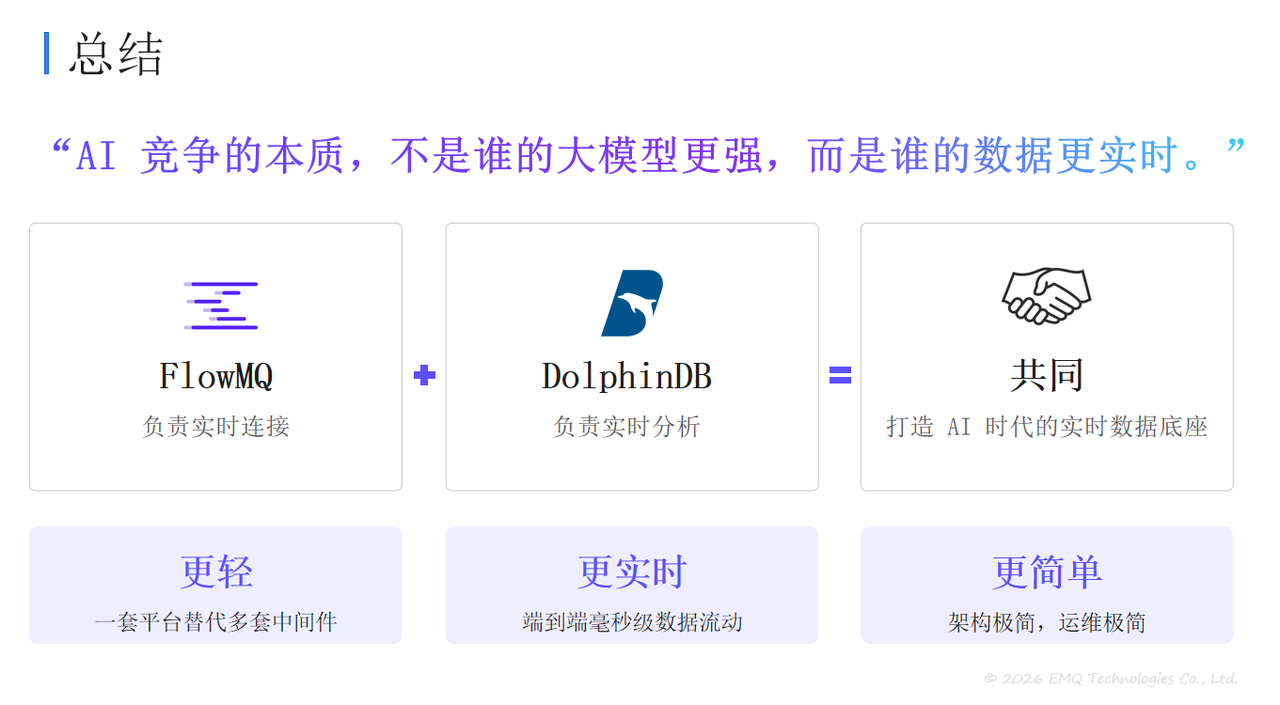
分工是一句官方的原话:"FlowMQ 负责接入数据,DolphinDB 负责存储计算,AI 负责用好数据。"用本文的语言学视角重读,这一次坍缩恰好发生在两个语言层面:
-
机器方言的归一:FlowMQ 以一个引擎支持发布订阅、队列、流处理三种范式,原生兼容 MQTT、Kafka、AMQP、NATS 四种协议(已验证单集群 1GB/s 吞吐、200 万 msg/s,长连接 P50 < 1ms)——设备各说各话没关系,进了消息层就是同一种话。
-
数据语义的归一:DolphinDB 以多模态存储引擎加外部表统一接入多源数据,配合第二章的统一数据字典——AI 从一个入口理解全厂,工业数据库的语义承载力在此兑现:千亿级时序表关联十万级业务表,库内百毫秒到秒级完成。
而语义在此处与实时性会合——意义也有保质期。"异常"的定义随工况漂移,智能问数需要当下上下文。作为流批一体的实时计算平台,DolphinDB 让"刚发生的语义"与"十年的语义"用同一句话查询,特征计算时延最低可达微秒级。语义的供给,必须赶在语义过期之前。
落地的速度感来自电力研究院的案例:原本需要数月的数据底座选型与技术调研,被压缩到一周内完成部署、导入 600 多张业务表并进入调试——前提恰是本文第二章与第三章的两件事:数据质量与字段注释清晰(语义),业务算法沉淀为技能(语用)。
智能物联网综合管理平台的"综合"二字,至此有了语言学注脚:不是把子系统拼得更全,而是让全厂第一次说同一种语言——机器方言在 FlowMQ 归一,数据语义在 DolphinDB 归一,人机对话在 DolphinX 归一。
图片来源:DolphinDB 官方公众号《直播回顾 | DolphinDB × EMQ》(2026.08.23)
图片来源:DolphinDB 官方公众号《直播回顾 | DolphinDB × EMQ》(2026.08.23)
终章 | 语言的归还:五十年后,数据库开口作答
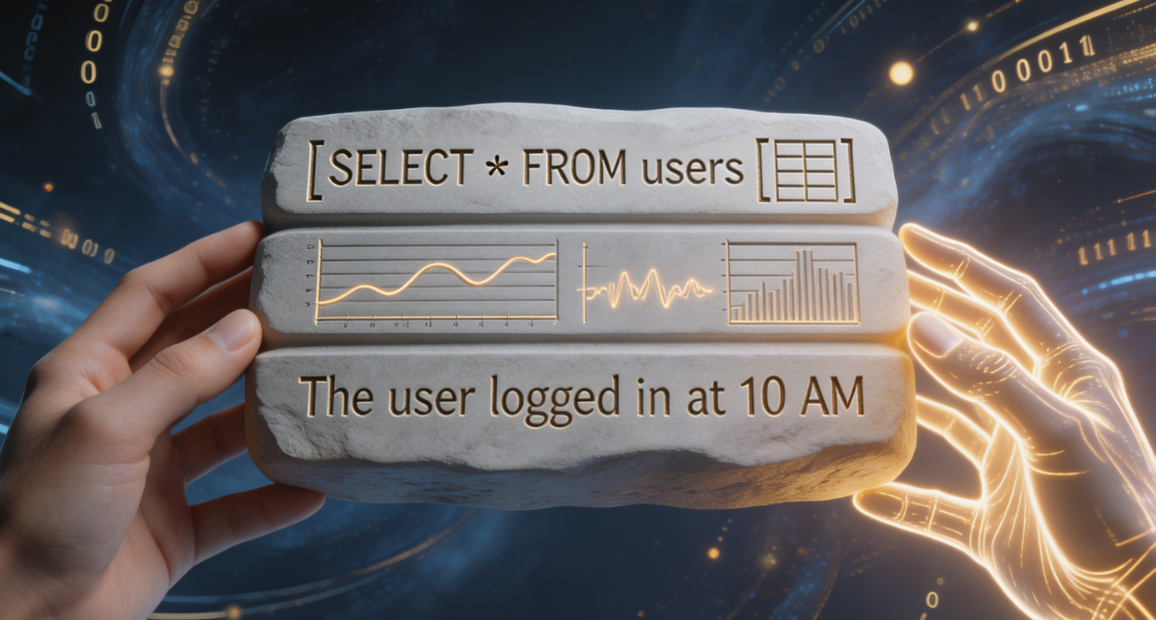
回望这五十年,数据库史其实是一部人类学机器语言的历史:COBOL 要学,SQL 要学,Python 要学,Dlang 要学。维特根斯坦在《逻辑哲学论》里写道:“我的语言的界限,意味着我的世界的界限。”(Tractatus, 5.6)——SQL 的界限,曾经就是数据世界的界限:不会写 SQL 的人,被挡在数据世界之外;而 1974 年那个想让数据库说英语的承诺(SEQUEL,Structured English Query Language),始终只兑现了前半个词。
2026 年,方向第一次反转。DolphinX 部署后,业务用户在 Web 界面以自然语言即可建库建表、导入数据、查询分析、编写脚本、排查问题——不是人迁就机器的语言,而是机器搬进了人类的语言。
但这次"归还"是有条件的:自然语言进门的前提,是数据库先学会"被读懂"。语法,五十年前就毕业了;语义,正在入库(1024 字节的字段描述、统一数据字典、双引擎 RAG);语用,正在沉淀(权限继承、长期记忆、Skill 资产、全链路审计)。三者合流之处,才是名副其实的智能数据库:
时序数据库给出时间的语法,实时计算平台给出毫秒的语速,入库的元数据给出语义,继承的权限给出语用——四者同库,数据库才真正开口作答。
这不是概念,而是正在被度量的现实:官网实测中,AI Agent 辅助下迭代效率提升 174%、正确率 97%(Gemini 3.0 实测,2025.11);2026 年 8 月,从三亚荣盛业基金的量化投研全流程,到中信证券金融创新服务会议上的范式探讨,这条路线仍在加速。
所以,回到直播间里那道曾无人能答的题——"过去 24 小时哪些设备温度异常?"它的答案从来不在模型里,而在一部词典、一套权限、一本越记越厚的组织笔记里。
五十年前,Codd 让数据有了语法;今天,智能数据库让数据有了意义。当 AI 说起人话,数据库终于开始作答——而这一次,人不必再先学会机器的语言。
FAQ
Q1:数据字典早就有了,与这次的"语义入库"有何本质区别?
A:传统数据字典是给人看的文档——物理上与数据分离,更新永远滞后于 schema,AI 够不着。V3.00.6 把字段描述(扩至 1024 字节)与 Catalog/Schema 层级描述作为库内元数据的一等公民,随库演进入、被 Agent 检索即得。前者是图书馆里的注释本,后者是刻在石碑上的平行文本。
Q2:自然语言问数与 Text-to-SQL 是一回事吗?
A:不是。Text-to-SQL 只完成语法学——把一句话翻译成合法的查询。生产级的智能问数还需要语义学(字段含义、单位、阈值来自数据字典)与语用学(提问者的权限、组织的惯例)。只做翻译的方案,会在"85.7 是报警吗"这类问题上原形毕露。
Q3:权限继承让同一个问题对不同人给出不同答案,不会损害可信度吗?
A:恰恰相反。答案因身份而异正是合规的要求(最小权限原则);保持一致的是方法与证据链——同样的提问走同样的检索与执行路径,差异只在权限边界,且每一次调用全程留痕、可回放审计。可追责的差异,比无差异的泄露可信得多。
关键字索引:时序数据库 | 工业数据库 | 智能数据库 | 实时计算平台 | 智能物联网综合管理平台 | DolphinDB | DolphinX | 语义学 | 语用学 | 数据字典 | 元数据 | RAG | Text-to-SQL | 权限继承 | Skill | MCP | 长期记忆 | Obsidian | FlowMQ | 混合检索