目录
-
- 一、第一次打开:先等索引
- 二、日常三个高频操作
- 三、大仓里真正救命的:改之前先看影响面
- 四、踩过的几个坑
- 五、什么情况下我不用它
- 六、小结
先交代背景,不然「好不好用」没有参照系。
我手上这个项目是个平台服务,Go 后端三万两千行左右,前端 React 一万六千行,internal 下面二十八个包,数据库迁移文件五十多个。不算大仓,但也到了「我不可能记住所有调用关系」的规模——尤其是半年前写的那些包,现在打开基本等于读别人的代码。
用 wescode 有一段时间了,这篇记一下日常真正高频的几个操作,以及踩过的坑。不讲功能列表,只讲我实际怎么用。
一、第一次打开:先等索引
装完打开项目,状态栏会开始跑 CKG 索引。我这个规模大概十几秒,之后就是增量更新了。
这里有个坑我一开始就踩了:索引没跑完就开始问,答案会明显不准。因为这时候图还没建完,AI 拿到的上下文是残缺的。表现是它会说「没有找到相关调用」,而你明明知道有。
所以我现在的习惯是打开项目先去倒杯水,回来看状态栏没进度条了再开工。切分支之后也一样,改动多的话会触发一批增量更新,等几秒再问。
判断索引好没好,最简单的办法是随便点开一个函数,看编辑器上方有没有显示引用数。有了就说明图建起来了。
二、日常三个高频操作
Cmd+L:带项目上下文的问答
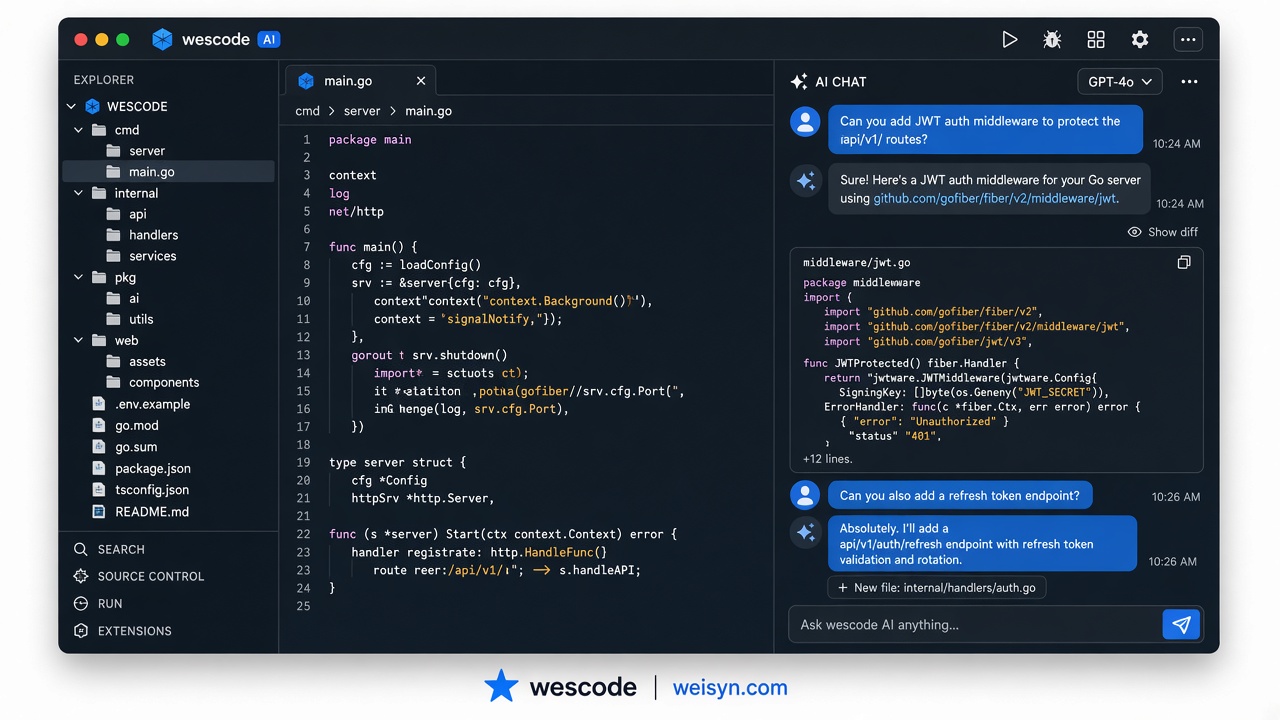
这个我用得最多。和普通 AI 对话的区别在于它知道项目结构,不用我手动贴代码。
比较典型的用法是接手陌生模块。比如我要动 internal/org 这个包(组织管理,一千三百行的 handler),直接问「这个包的职责边界是什么,谁在调用它」,wescode 会基于调用图给出结构性的回答,而不是把文件内容复述一遍。
输入框里可以用 @ 引用具体文件或符号。我一般会明确 @ 一下要讨论的文件,比让它自己猜准得多。
Cmd+K:就地改代码
选中一段按 Cmd+K,输入指令直接在原位改。适合小范围修改:补错误处理、改个命名、把一段逻辑抽成函数。
比 Chat 顺手的地方在于不用复制粘贴——改完直接是 diff 预览,接受或拒绝。我用它做得最多的是「把这段重复的参数校验抽出去」这类机械活。
这里提一个我很在意的细节:wescode 读的是编辑器里的内容,不是磁盘上的。也就是说我改了几行还没保存,直接让它继续改,它能看到我刚写的。这个听起来理所当然,但不是所有工具都这么做——有些是直接读文件,你没保存它就看不见,改出来的东西会把你刚写的覆盖掉。
Ctrl+Shift+K:Agent 模式
需要跨文件操作时才开。比如「给所有 handler 补上统一的请求日志」这种,Agent 会自己找文件、改、必要时跑命令。
我的经验是:改动超过三个文件才值得开 Agent,否则不如 Cmd+K 一个个来更可控。 Agent 跑起来之后要盯着,尤其是它要执行命令的时候。跑完一定逐个看 diff,不要直接全部接受——这条对任何 AI 编程工具都成立。
三、大仓里真正救命的:改之前先看影响面
前面那些提效是次要的,对我来说 wescode 真正不可替代的是这个场景。
上个月要改钱包扣费的金额精度,从「分」改成「毫」。函数本身二十行,十分钟能改完。难的是确认谁受影响。
以前的做法是 grep:
grep -rn "Charge" . –include="*.go"
几十条命中,里面混着注释、测试夹具、日志字符串。得一个个打开确认哪些是真正的调用点,半小时起步,而且做完心里还是没底——万一有通过接口间接调用的呢?
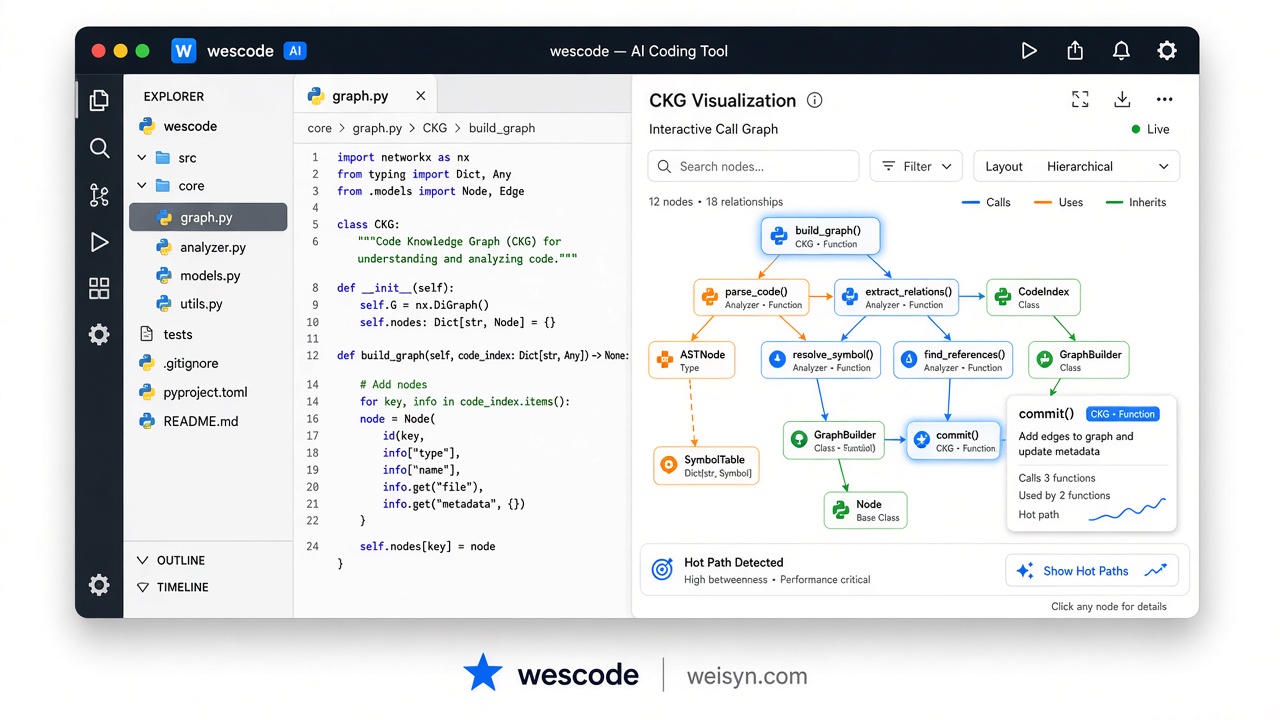
现在的做法是选中函数,让 wescode 做影响分析。它走的是调用图,给出来的是这样的结构:
Charge
├── 直接调用
│ ├── HandlePurchase
│ ├── HandleTopupDeduct
│ └── settleUsageLoop
├── 接口实现
│ └── Wallet ← billing.Service、promo.Service
└── 下游
├── ledger.Append 流水精度要一起改
└── cron: nightly_reconcile.yaml
关键是最后两项。ledger.Append 那个我知道,但 cron 里那个对账任务我是真忘了——它读的是同一批数据,精度变了不改就会对不上账。如果靠 grep,我大概率会漏掉,然后在月底对账时发现。
这就是我说的「不可替代」:它找的不是提到这个词的地方,是结构上依赖它的地方。这两件事差别很大,尤其在有接口、有间接调用的代码里。
四、踩过的几个坑
动态语言的分析深度不如静态语言
我这个项目是 Go 为主,调用图很准。但前端那部分 TypeScript 虽然也支持,涉及到动态属性访问、运行时注入的地方,图就会有缺口。
这不是实现偷懒,是动态语言的调用关系本来就难静态确定——obj[key]() 这种写法,静态分析没法知道 key 是什么。所以我现在的习惯是:Go 那边的影响分析结果我基本信,前端那边只当参考,还是会自己再确认一遍。
大文件不要指望
超过一定体积的文件(我记得是 1MB 左右)不会做内容同步。我有个生成的数据文件,改了没保存时 AI 读到的还是旧版本。后来想明白了这是有意为之——几 MB 的文件全量同步,内存和性能都受不了。
实际影响不大,因为那种体积的文件通常也不是手写的。知道有这回事就行。
Agent 模式别放手不管
前面说过一次,这里再强调。我有次让 Agent 批量改一批 handler,跑完扫了一眼觉得没问题就全接受了,结果有两个文件它把错误处理的语义改了——原来是 wrap 之后往上抛,它改成了记日志然后返回 nil。编译过、测试也过,因为那两个分支没有测试覆盖。
后来是 code review 时同事发现的。从那之后我养成习惯:Agent 跑完先 git diff 整体看一遍,再决定接受。
多开项目时注意窗口对应关系
每个工作区有独立的索引和上下文,物理隔离的,这点很好——不会串。但我一开始没搞清楚,在 A 项目的窗口里问 B 项目的事,得到的答案自然驴唇不对马嘴。搞清楚一个窗口对应一个项目就行。
五、什么情况下我不用它
说点实在的。
小项目没必要。 几千行的脚本或者小服务,全文搜索加上自己的记忆就够了,建图那点收益覆盖不了心智成本。我自己写小工具的时候还是直接用 VS Code。
纯写新代码的时候差别不大。 从零写一个新模块,没有存量代码要理解,也没有影响面要确认,这时候各家 AI 工具的体验差不多,主要看模型本身。
需要大量视觉调试的前端活儿。 调样式、改布局这类,结构化理解帮不上忙,还是得肉眼看效果。
它真正值的场景就一个:存量代码多、改动要确认影响面、改错了代价高。 如果你的日常不是这样,那用什么工具区别都不大。
六、小结
用下来最大的感受是:AI 编程工具的差距,现在已经不在「能不能写出代码」上了。模型那层大家用的其实差不多,Claude、GPT、DeepSeek 换着来,生成质量没有数量级差别。
差距在写之前和写之后——写之前它知不知道这个改动会波及什么,写之后你有没有办法确认它没改坏。 这两件事靠更大的上下文窗口解决不了,得靠对代码结构的确定性建模。
对我来说,wescode 值的地方就是把「改之前先搞清楚影响面」这件事从半小时压到了几秒钟,而且比我手动找得全。其他的提效都是附带的。
如果你也在维护存量比较多的项目,这个思路值得试试——不一定非要用哪个工具,但「先建图再动手」比「先改了再说」靠谱得多。