文章目录
- 一、项目整体流程
- 二、环境准备
- 三、原理:MediaPipe Hands 与 21 个手部关键点
-
- 3.1 什么是 MediaPipe Hands
- 3.2 21 个关键点的坐标含义
- 3.3 为什么用"关键点坐标"而不是原始图像
- 四、第一步:手势数据采集
-
- 4.1 完整代码(`1_hand_gesture_collector.py`)
- 4.2 使用方法
- 4.3 采集建议
- 五、第二步:模型训练与评估
-
- 5.1 完整代码(`2_gesture_recognizer.py`)
- 5.2 特征构造:63 维向量
- 5.3 训练集/测试集划分
- 5.4 StandardScaler 标准化
- 5.5 四个传统机器学习模型对比
- 5.6 模型评估指标
- 六、第三步:实时手势识别
-
- 6.1 运行方式
- 6.2 实时识别流程
- 七、总结
一、项目整体流程
整个项目分为三个阶段,对应两个脚本:
摄像头画面
│
▼
[脚本1] MediaPipe 检测手部 21 个关键点
│ 按数字键 0~4 采集
▼
JSON 文件(gesture_data/<类别>/xxx.json)
│
▼
[脚本2] 读取 JSON → 展平为 63 维特征向量
│ 划分训练/测试集 → StandardScaler 标准化
▼
训练 KNN / SVM / 决策树 / 随机森林
│ 选准确率最高的模型
▼
best_gesture_model.pkl + scaler.pkl + confusion_matrix.png
│
▼
[脚本2 –recognize] 摄像头实时识别并显示手势与置信度
共定义 5 个手势类别:
| 0 | fist | 拳头 |
| 1 | open_hand | 张开的手 |
| 2 | point | 食指指向 |
| 3 | peace | 剪刀手(V 字) |
| 4 | ok | OK 手势 |
二、环境准备
主要依赖如下:
| opencv-python | 摄像头读取、图像显示、绘制文字 | pip install opencv-python |
| mediapipe | 手部 21 关键点检测 | pip install mediapipe |
| numpy | 数值计算、时间戳 | pip install numpy |
| scikit-learn | 数据集划分、标准化、四种分类模型、评估指标 | pip install scikit-learn |
| joblib | 模型与标准化器的保存/加载 | 随 scikit-learn 自动安装 |
| matplotlib | 绘制混淆矩阵 | pip install matplotlib |
| seaborn | 混淆矩阵热力图美化 | pip install seaborn |
三、原理:MediaPipe Hands 与 21 个手部关键点
3.1 什么是 MediaPipe Hands
MediaPipe 是 Google 开源的跨平台多媒体机器学习 pipeline 框架。其中的 Hands 模块可以实时检测并追踪单只或双手的 21 个三维关键点,速度快,对普通摄像头也能流畅运行。
它内部其实由两个模型协同工作:
代码中这样初始化:
with mp_hands.Hands(
static_image_mode=False, # 视频流模式,开启追踪
max_num_hands=1, # 最多检测 1 只手
min_detection_confidence=0.7, # 检测置信度阈值
min_tracking_confidence=0.7) as hands:
- static_image_mode=False:表示输入是视频流,会启用追踪,更快;如果处理静态图片应设为 True。
- max_num_hands=1:本项目只识别单手手势。
- 两个 min_*_confidence=0.7:置信度低于 0.7 就认为没有检测到。
3.2 21 个关键点的坐标含义
MediaPipe Hands 返回的 21 个关键点按固定编号排列:
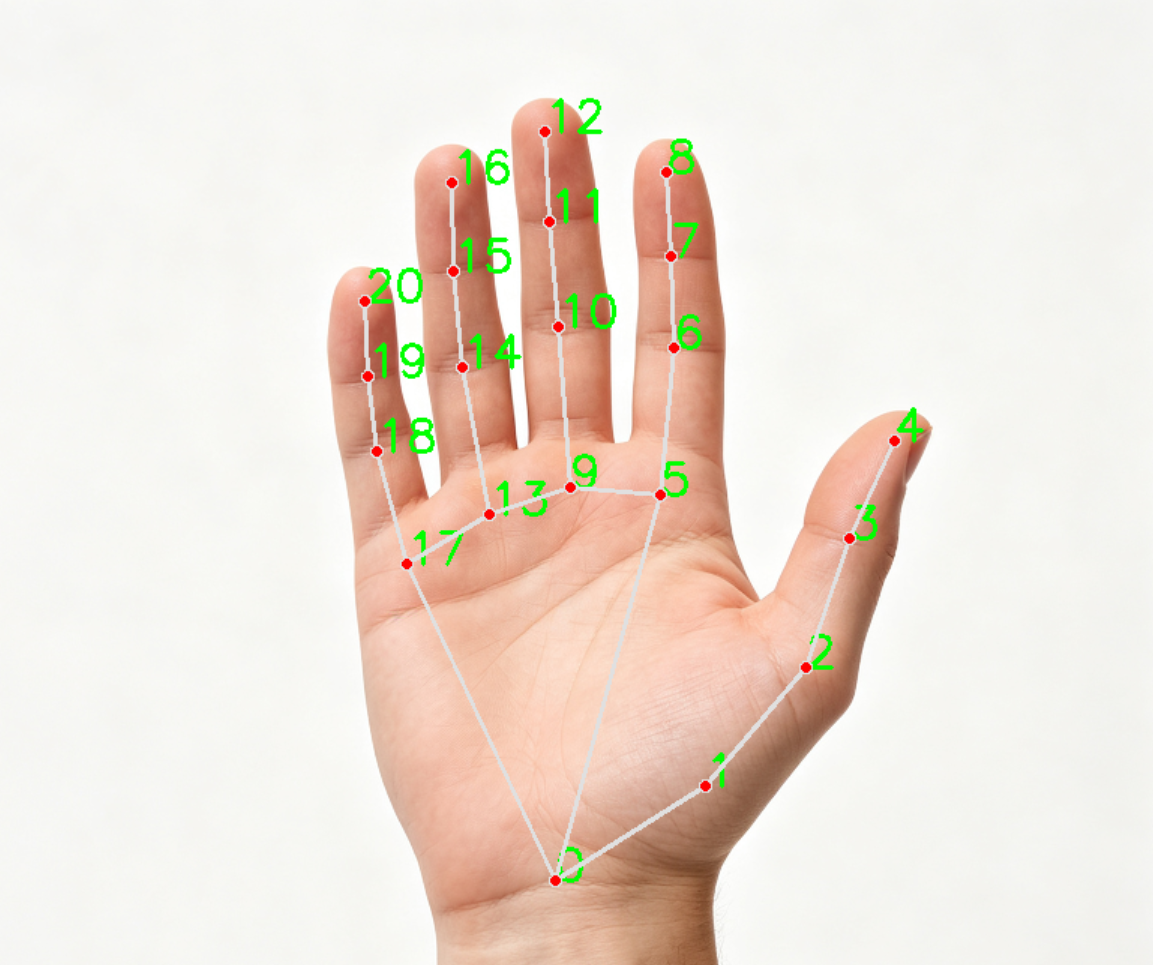
- 0:手腕(Wrist)
- 1~4:拇指(从指根到指尖:CMC、MCP、IP、TIP)
- 5~8:食指(MCP、PIP、DIP、TIP)
- 9~12:中指
- 13~16:无名指
- 17~20:小指
每个关键点包含三个坐标:x、y、z。需要特别注意:
- x、y 是归一化坐标,除以图像 宽度/高度 后取值在 [0, 1] 之间,因此与图像分辨率无关;
- z 表示该点相对于手腕的深度,数值越小代表离摄像头越近,它没有固定的归一化范围。
正因为 x, y 已经是归一化坐标,同一手势在不同距离、不同位置下手部关键点的相对形状基本不变,所以把 21 个点的 (x, y, z) 直接展平就能得到一个 63 维的特征向量,用来表示手势。
3.3 为什么用"关键点坐标"而不是原始图像
相比直接把整帧图像喂给 CNN,关键点坐标有几个明显优势:
便可以做到"不训练神经网络、只用传统机器学习"也能达到不错效果。
四、第一步:手势数据采集
4.1 完整代码(1_hand_gesture_collector.py)
import cv2
import mediapipe as mp
import numpy as np
import os
import json
# 初始化 MediaPipe 手部检测
mp_hands = mp.solutions.hands
mp_drawing = mp.solutions.drawing_utils
# 手势类别和保存路径
GESTURE_CLASSES = {
0: "fist", # 拳头
1: "open_hand", # 张开的手
2: "point", # 指向
3: "peace", # 剪刀手
4: "ok" # OK 手势
}
DATA_DIR = "gesture_data"
# 创建数据目录
for cls in GESTURE_CLASSES.values():
os.makedirs(os.path.join(DATA_DIR, cls), exist_ok=True)
def collect_gesture_data():
"""采集手势数据,提取 21 个关键点的三维坐标"""
cap = cv2.VideoCapture(0) # 使用默认摄像头
# 显示手势类别说明
print("手势类别:")
for key, value in GESTURE_CLASSES.items():
print(f"{key}: {value}")
print("按对应的数字键收集数据,按 q 退出")
# 初始化计数器,记录每个类别的样本数量
counters = {cls: 0 for cls in GESTURE_CLASSES.values()}
with mp_hands.Hands(
static_image_mode=False,
max_num_hands=1,
min_detection_confidence=0.7,
min_tracking_confidence=0.7) as hands:
while cap.isOpened():
ret, frame = cap.read()
if not ret:
print("无法获取摄像头画面")
break
# 转换为 RGB 并处理(MediaPipe 要求 RGB 输入)
image = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
results = hands.process(image)
# 转换回 BGR 用于显示
image = cv2.cvtColor(image, cv2.COLOR_RGB2BGR)
# 检测到手部
if results.multi_hand_landmarks:
for hand_landmarks in results.multi_hand_landmarks:
# 绘制手部关键点与连线
mp_drawing.draw_landmarks(
image, hand_landmarks, mp_hands.HAND_CONNECTIONS)
# 提取 21 个关键点的三维坐标
landmarks = []
for lm in hand_landmarks.landmark:
landmarks.append([lm.x, lm.y, lm.z])
# 显示当前各类别样本数量
info_text = " | ".join(
[f"{cls}: {count}" for cls, count in counters.items()])
cv2.putText(image, info_text, (10, 30),
cv2.FONT_HERSHEY_SIMPLEX, 0.7, (0, 255, 0), 2)
# 显示画面
cv2.imshow('Gesture Collection (Press number key to save, q to exit)', image)
# 键盘事件处理
key = cv2.waitKey(5) & 0xFF
if key == ord('q'):
break
# 按数字键保存对应类别的数据(chr: 将整数转为对应字符)
elif chr(key) in [str(k) for k in GESTURE_CLASSES.keys()]:
cls_idx = int(chr(key))
cls_name = GESTURE_CLASSES[cls_idx]
if results.multi_hand_landmarks and len(results.multi_hand_landmarks) > 0:
# 保存关键点数据
counters[cls_name] += 1
data = {
"class": cls_name,
"class_index": cls_idx,
"landmarks": landmarks,
"timestamp": str(np.datetime64('now'))
}
# 保存为 JSON 文件
filename = f"{cls_name}_{counters[cls_name]}.json"
filepath = os.path.join(DATA_DIR, cls_name, filename)
with open(filepath, 'w') as f:
json.dump(data, f, indent=2)
print(f"已保存 {cls_name} 样本 #{counters[cls_name]}")
else:
print("未检测到手部,请将手放在摄像头前")
cap.release()
cv2.destroyAllWindows()
# 打印最终收集的样本数量
print("\\n数据收集完成!")
print("样本数量统计:")
for cls, count in counters.items():
print(f"{cls}: {count}个样本")
if __name__ == "__main__":
collect_gesture_data()
4.2 使用方法
每个 JSON 文件结构大致如下:
{
"class": "fist",
"class_index": 0,
"landmarks": [[0.51, 0.32, –0.01], …],
"timestamp": "2026-09-21T17:30:12.345678"
}
其中 landmarks 是一个长度为 21 的列表,每个元素是 [x, y, z]。
4.3 采集建议
数据质量直接决定模型上限,采集时建议:
- 每类至少50个样本,样本太少模型容易过拟合;
- 多角度、多距离、多光照下采集,不要只在一个姿势下拍;
- 手在画面中左、中、右、上、下不同位置都要有样本;
- 保持五类样本数量大致均衡,避免某类特别多导致模型偏向多数类;
- 采集过程中如果关键点连线飘了,不要按数字键,等稳定再按。
五、第二步:模型训练与评估
5.1 完整代码(2_gesture_recognizer.py)
import os
import json
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import joblib
import seaborn as sns
# 数据目录和手势类别(需与采集程序一致)
DATA_DIR = "gesture_data"
GESTURE_CLASSES = {
0: "fist",
1: "open_hand",
2: "point",
3: "peace",
4: "ok"
}
def load_gesture_data():
"""加载手势数据并转换为特征向量"""
X = [] # 特征向量
y = [] # 标签
# 遍历每个手势类别目录
for cls_idx, cls_name in GESTURE_CLASSES.items():
cls_dir = os.path.join(DATA_DIR, cls_name)
if not os.path.exists(cls_dir):
print(f"警告: 类别 {cls_name} 的数据目录不存在")
continue
# 加载该类别的所有样本
for filename in os.listdir(cls_dir):
if filename.endswith(".json"):
filepath = os.path.join(cls_dir, filename)
with open(filepath, 'r') as f:
data = json.load(f)
# 将 21 个关键点的 3D 坐标展平为一维向量 (21*3=63 维)
landmarks = data["landmarks"]
feature_vector = []
for lm in landmarks:
feature_vector.extend(lm) # 添加 x, y, z 坐标
X.append(feature_vector)
y.append(cls_idx)
print(f"加载完成! 共 {len(X)} 个样本,每个样本 {len(X[0]) if X else 0} 维特征")
return np.array(X), np.array(y)
def train_and_evaluate_models():
"""训练多种传统机器学习模型并评估性能"""
# 加载数据
X, y = load_gesture_data()
if len(X) == 0:
print("没有数据可用于训练,请先采集数据")
return
# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y)
# 特征标准化
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
# 保存标准化器
joblib.dump(scaler, "scaler.pkl")
# 定义要训练的模型
models = {
"K近邻分类器": KNeighborsClassifier(n_neighbors=5),
"支持向量机": SVC(kernel='rbf', gamma='scale'),
"决策树": DecisionTreeClassifier(max_depth=10),
"随机森林": RandomForestClassifier(n_estimators=100)
}
# 训练并评估每个模型
best_accuracy = 0
best_model = None
best_model_name = ""
print("\\n模型训练和评估结果:")
for name, model in models.items():
# 训练模型
model.fit(X_train_scaled, y_train)
# 预测
y_pred = model.predict(X_test_scaled)
# 评估
accuracy = accuracy_score(y_test, y_pred)
print(f"\\n{name} 准确率: {accuracy:.4f}")
print("分类报告:")
print(classification_report(
y_test, y_pred,
target_names=GESTURE_CLASSES.values()
))
# 保存表现最好的模型
if accuracy > best_accuracy:
best_accuracy = accuracy
best_model = model
best_model_name = name
# 保存最佳模型
joblib.dump(best_model, "best_gesture_model.pkl")
print(f"\\n最佳模型是: {best_model_name},准确率: {best_accuracy:.4f}")
print("最佳模型已保存为 best_gesture_model.pkl")
print("特征标准化器已保存为 scaler.pkl")
# 绘制最佳模型的混淆矩阵
y_pred_best = best_model.predict(X_test_scaled)
cm = confusion_matrix(y_test, y_pred_best)
plt.figure(figsize=(10, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
xticklabels=GESTURE_CLASSES.values(),
yticklabels=GESTURE_CLASSES.values())
plt.xlabel('预测标签')
plt.ylabel('真实标签')
plt.title(f'{best_model_name} 混淆矩阵 (准确率: {best_accuracy:.4f})')
plt.savefig('confusion_matrix.png')
print("混淆矩阵已保存为 confusion_matrix.png")
plt.close()
def real_time_recognition():
"""实时手势识别"""
import cv2
import mediapipe as mp
# 加载模型和标准化器
try:
model = joblib.load("best_gesture_model.pkl")
scaler = joblib.load("scaler.pkl")
except FileNotFoundError:
print("未找到模型文件,请先训练模型")
return
# 初始化 MediaPipe 手部检测
mp_hands = mp.solutions.hands
mp_drawing = mp.solutions.drawing_utils
cap = cv2.VideoCapture(0)
with mp_hands.Hands(
static_image_mode=False,
max_num_hands=1,
min_detection_confidence=0.7,
min_tracking_confidence=0.7) as hands:
print("实时手势识别开始,按 q 退出")
while cap.isOpened():
ret, frame = cap.read()
if not ret:
print("无法获取摄像头画面")
break
# 转换为 RGB 并处理
image = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
results = hands.process(image)
# 转换回 BGR 用于显示
image = cv2.cvtColor(image, cv2.COLOR_RGB2BGR)
# 检测到手部
if results.multi_hand_landmarks:
for hand_landmarks in results.multi_hand_landmarks:
# 绘制手部关键点
mp_drawing.draw_landmarks(
image, hand_landmarks, mp_hands.HAND_CONNECTIONS)
# 提取 21 个关键点的三维坐标并转换为特征向量
landmarks = []
for lm in hand_landmarks.landmark:
landmarks.extend([lm.x, lm.y, lm.z])
# 标准化特征(必须使用训练时保存的 scaler)
landmarks_scaled = scaler.transform([landmarks])
# 预测手势
prediction = model.predict(landmarks_scaled)
predicted_class = GESTURE_CLASSES[prediction[0]]
# 获取预测概率
if hasattr(model, 'predict_proba'):
probabilities = model.predict_proba(landmarks_scaled)[0]
max_prob = max(probabilities) * 100
display_text = f"{predicted_class} ({max_prob:.1f}%)"
else:
display_text = predicted_class
# 在画面上显示结果
cv2.putText(image, display_text, (10, 30),
cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 255, 0), 2)
# 显示画面
cv2.imshow('Real-time Gesture Recognition (q to exit)', image)
if cv2.waitKey(5) & 0xFF == ord('q'):
break
cap.release()
cv2.destroyAllWindows()
print("实时识别结束")
if __name__ == "__main__":
import argparse
parser = argparse.ArgumentParser(description='手势识别程序')
parser.add_argument('–train', action='store_true', help='训练模型')
parser.add_argument('–recognize', action='store_true', help='实时识别')
args = parser.parse_args()
if args.train:
train_and_evaluate_models()
elif args.recognize:
real_time_recognition()
else:
print("请指定操作: –train 训练模型 或 –recognize 实时识别")
5.2 特征构造:63 维向量
每个样本的 landmarks 是 21 个 [x, y, z],按顺序拼接:
[x1, y1, z1, x2, y2, z2, …, x21, y21, z21]
一共 21 × 3 = 63 维。这就是模型看到的"一张图片"。
5.3 训练集/测试集划分
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y)
- test_size=0.2:20% 作为测试集,80% 用于训练;
- random_state=42:固定随机种子,保证每次划分结果一致,便于复现;
- stratify=y:分层抽样,保证训练集和测试集中每类的比例与原始数据一致,这在多分类、样本不均衡时非常重要。
5.4 StandardScaler 标准化
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
StandardScaler 会把每一维特征转换为均值 0、方差 1:
x
′
=
x
−
μ
σ
x' = \\frac{x – \\mu}{\\sigma}
x′=σx−μ
其中
μ
\\mu
μ、
σ
\\sigma
σ 都是在训练集上计算的。测试集和实时识别时只能 transform,不能重新 fit,否则就泄漏了测试集信息、分布也对不上。
为什么要标准化?
- KNN 用欧氏距离衡量相似度,如果某一维数值范围特别大,会主导距离计算;
- SVM(RBF 核) 对特征尺度同样敏感;
- 决策树、随机森林理论上对单调缩放不敏感,但统一做标准化也不会有副作用,且能保证所有模型输入一致。
5.5 四个传统机器学习模型对比
| KNN(K 近邻) | n_neighbors=5 | 最简单,靠最近的 5 个邻居投票;对尺度敏感,预测时计算量大 |
| SVM(支持向量机) | kernel='rbf', gamma='scale' | 在小样本高维数据上表现通常较好,能找最大间隔超平面 |
| 决策树 | max_depth=10 | 可解释性强,但单棵树容易过拟合 |
| 随机森林 | n_estimators=100 | 100 棵决策树投票,抗过拟合,通常是四者中最稳的 |
代码会依次训练这四个模型,用测试集准确率比较,自动把准确率最高的那个保存为 best_gesture_model.pkl。
5.6 模型评估指标
- accuracy_score:整体准确率;
- classification_report:输出每一类的精确率(precision)、召回率(recall)、F1 分数;
- confusion_matrix + seaborn.heatmap:绘制混淆矩阵热力图,保存为 confusion_matrix.png。混淆矩阵的行是真实标签、列是预测标签,对角线上数值越大越好;非对角线上的数值能直观看到"哪两个手势容易被搞混"。
六、第三步:实时手势识别
6.1 运行方式
6.2 实时识别流程
实时识别部分与采集部分几乎对称:
关键点在于:实时推理时的预处理必须与训练时完全一致——同样的 21 个点、同样的顺序、同样的标准化器。
七、总结
| 数据采集 | 1_hand_gesture_collector.py | MediaPipe Hands 21 关键点、JSON 存储 |
| 模型训练 | 2_gesture_recognizer.py –train | 63 维特征、StandardScaler、KNN/SVM/决策树/随机森林、混淆矩阵 |
| 实时识别 | 2_gesture_recognizer.py –recognize | 加载 pkl 模型、摄像头实时推理、置信度显示 |