温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
以下是一份关于《Hadoop+Spark+Hive视频推荐系统》的开题报告框架及内容示例,结合大数据处理技术与推荐系统设计展开:
开题报告
题目:基于Hadoop+Spark+Hive的视频推荐系统设计与实现
一、研究背景与意义
- 数据爆炸与信息过载:视频平台(如YouTube、抖音)用户规模与内容量激增,用户需花费大量时间筛选感兴趣的视频。
- 推荐系统重要性:个性化推荐可提升用户留存率(如Netflix 75%观看量来自推荐)、增加平台广告收入。
- 大数据技术支撑:Hadoop提供分布式存储与计算框架,Spark实现实时推荐引擎,Hive支持结构化数据查询与分析,三者协同可处理海量异构数据。
- 学术价值:探索大数据生态在推荐系统中的工程化实践,验证混合推荐算法(协同过滤+内容分析)的准确性。
- 实践价值:为视频平台提供低成本、高可扩展的推荐解决方案,降低传统推荐系统的硬件与开发成本。
- 技术价值:构建基于Hadoop的离线数据仓库与Spark的实时推荐流水线,支持批处理与流式计算双模式。
二、国内外研究现状
- 协同过滤(CF):基于用户-物品评分矩阵(如UserCF、ItemCF),但存在冷启动与数据稀疏性问题。
- 内容推荐:提取视频标题、标签、描述等文本特征(如TF-IDF、Word2Vec),匹配用户兴趣标签。
- 混合模型:结合协同过滤与内容特征(如加权融合、矩阵分解),提升推荐多样性(如YouTube早期推荐系统)。
- Hadoop生态:
- HDFS存储海量用户行为日志(如点击、观看时长、收藏)。
- Hive构建数据仓库,支持SQL查询用户画像与视频特征。
- Spark技术栈:
- Spark MLlib实现ALS矩阵分解、FP-Growth关联规则挖掘等算法。
- Spark Streaming处理实时用户行为(如实时更新推荐列表)。
- 工业级实践:
- Netflix:基于Spark的实时推荐系统,处理每秒百万级请求。
- 阿里巴巴:通过MaxCompute(Hadoop兼容)与PAI平台实现商品推荐。
- 数据孤岛:用户行为数据、视频元数据、社交关系数据分散在不同系统中,未有效整合。
- 实时性不足:传统Hadoop MapReduce延迟高,难以支持实时推荐场景。
- 冷启动问题:新用户/视频缺乏历史数据,导致推荐质量下降。
三、研究目标与内容
- 构建基于Hadoop+Spark+Hive的视频数据仓库,整合用户行为、视频元数据与外部知识图谱。
- 设计混合推荐算法,结合协同过滤与内容特征,解决冷启动与数据稀疏性问题。
- 开发实时推荐系统,支持离线批处理(每日更新模型)与在线流式计算(秒级响应请求)。
- 数据采集与存储:
- 数据源:用户行为日志(点击、播放、点赞)、视频元数据(标题、标签、分类)、知识图谱(演员、导演、类型关联)。
- 存储方案:
- HDFS存储原始日志文件(如Parquet格式)。
- Hive表设计:
- user_profile(用户ID、年龄、性别、兴趣标签)。
- video_meta(视频ID、标题、分类、时长)。
- user_behavior(用户ID、视频ID、行为类型、时间戳)。
- 推荐算法设计:
- 离线模型:
- 基于Spark MLlib实现ItemCF协同过滤,计算视频相似度矩阵。
- 结合视频内容特征(如BERT提取标题语义向量),通过加权融合优化推荐列表。
- 实时模型:
- 使用Spark Streaming处理实时用户行为,动态调整推荐权重(如用户新点击视频后立即更新候选集)。
- 引入Flink或Kafka实现毫秒级事件处理(可选扩展)。
- 离线模型:
- 系统架构实现:
- 离线层:
- Hadoop YARN调度Spark作业,每日定时训练推荐模型。
- Hive查询生成用户-视频评分矩阵,供Spark处理。
- 实时层:
- Spark Streaming监听Kafka中的用户行为事件,触发增量模型更新。
- Redis缓存热门视频与实时推荐结果,降低数据库压力。
- 服务层:
- 提供RESTful API供前端调用,返回Top-N推荐视频列表。
- 离线层:
四、技术路线与创新点
- 数据处理流程:
1原始日志 → HDFS存储 → Hive清洗 → Spark特征工程 → 模型训练 → 推荐结果 → Redis缓存
2 - 系统架构图:
1[数据源] → [Hadoop集群] → [Spark计算] → [Hive/Redis存储] → [Web服务] → [用户终端]
2 - 关键工具链:
- Hadoop 3.x(HDFS+YARN)、Spark 3.x(MLlib+Streaming)、Hive 3.x、Kafka 2.x、Redis 6.x。
- 混合推荐优化:提出基于内容相似度的动态权重调整机制,缓解冷启动问题(如新视频通过内容匹配推荐给相似兴趣用户)。
- 实时增量学习:设计Spark Streaming与Hive的增量更新管道,避免每日全量模型重训。
- 多维度特征融合:整合用户行为、视频内容与知识图谱(如“用户喜欢导演A→推荐导演A的新作”),提升推荐多样性。
五、预期成果
六、进度安排
| 文献调研 | 第1-2月 | 研究Hadoop/Spark在推荐系统的应用案例与混合推荐算法 |
| 数据准备 | 第3月 | 搭建Hadoop集群,采集并清洗视频数据与用户行为日志 |
| 算法开发 | 第4-5月 | 实现离线协同过滤模型,设计内容特征融合与实时更新模块 |
| 系统实现 | 第6-7月 | 开发Spark Streaming实时处理管道与Web服务接口 |
| 测试优化 | 第8月 | 通过A/B测试对比推荐效果,优化系统吞吐量与响应速度 |
| 论文撰写 | 第9月 | 总结成果并撰写论文 |
七、参考文献
备注:
- 实际开题报告需补充具体数据集来源(如公开数据集MovieLens、Kaggle视频数据)、集群配置参数(如节点数量、内存分配)及实验设计(如A/B测试分组策略)。
- 可结合隐私计算技术(如差分隐私)说明用户数据保护方案,满足GDPR等法规要求。
希望这份框架能为您提供清晰的研究方向!如需进一步调整或补充细节,请随时告知。
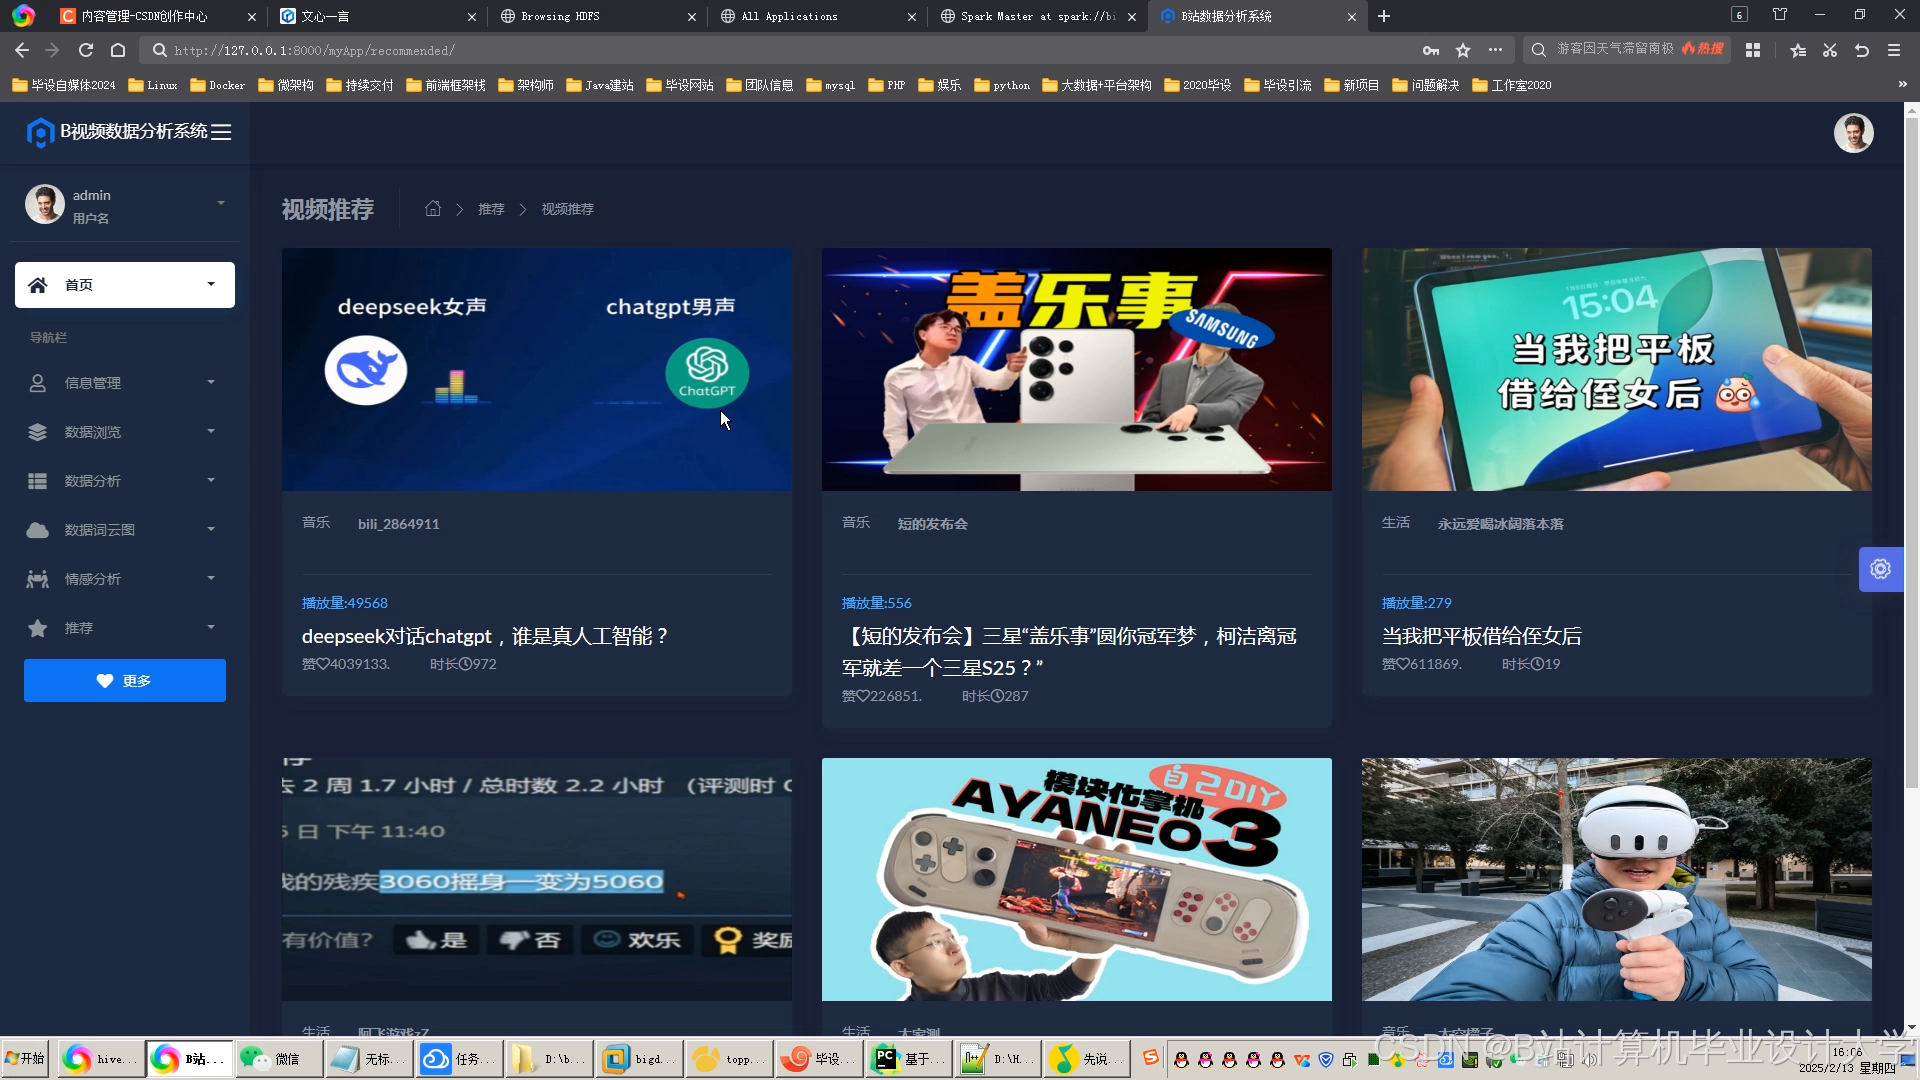
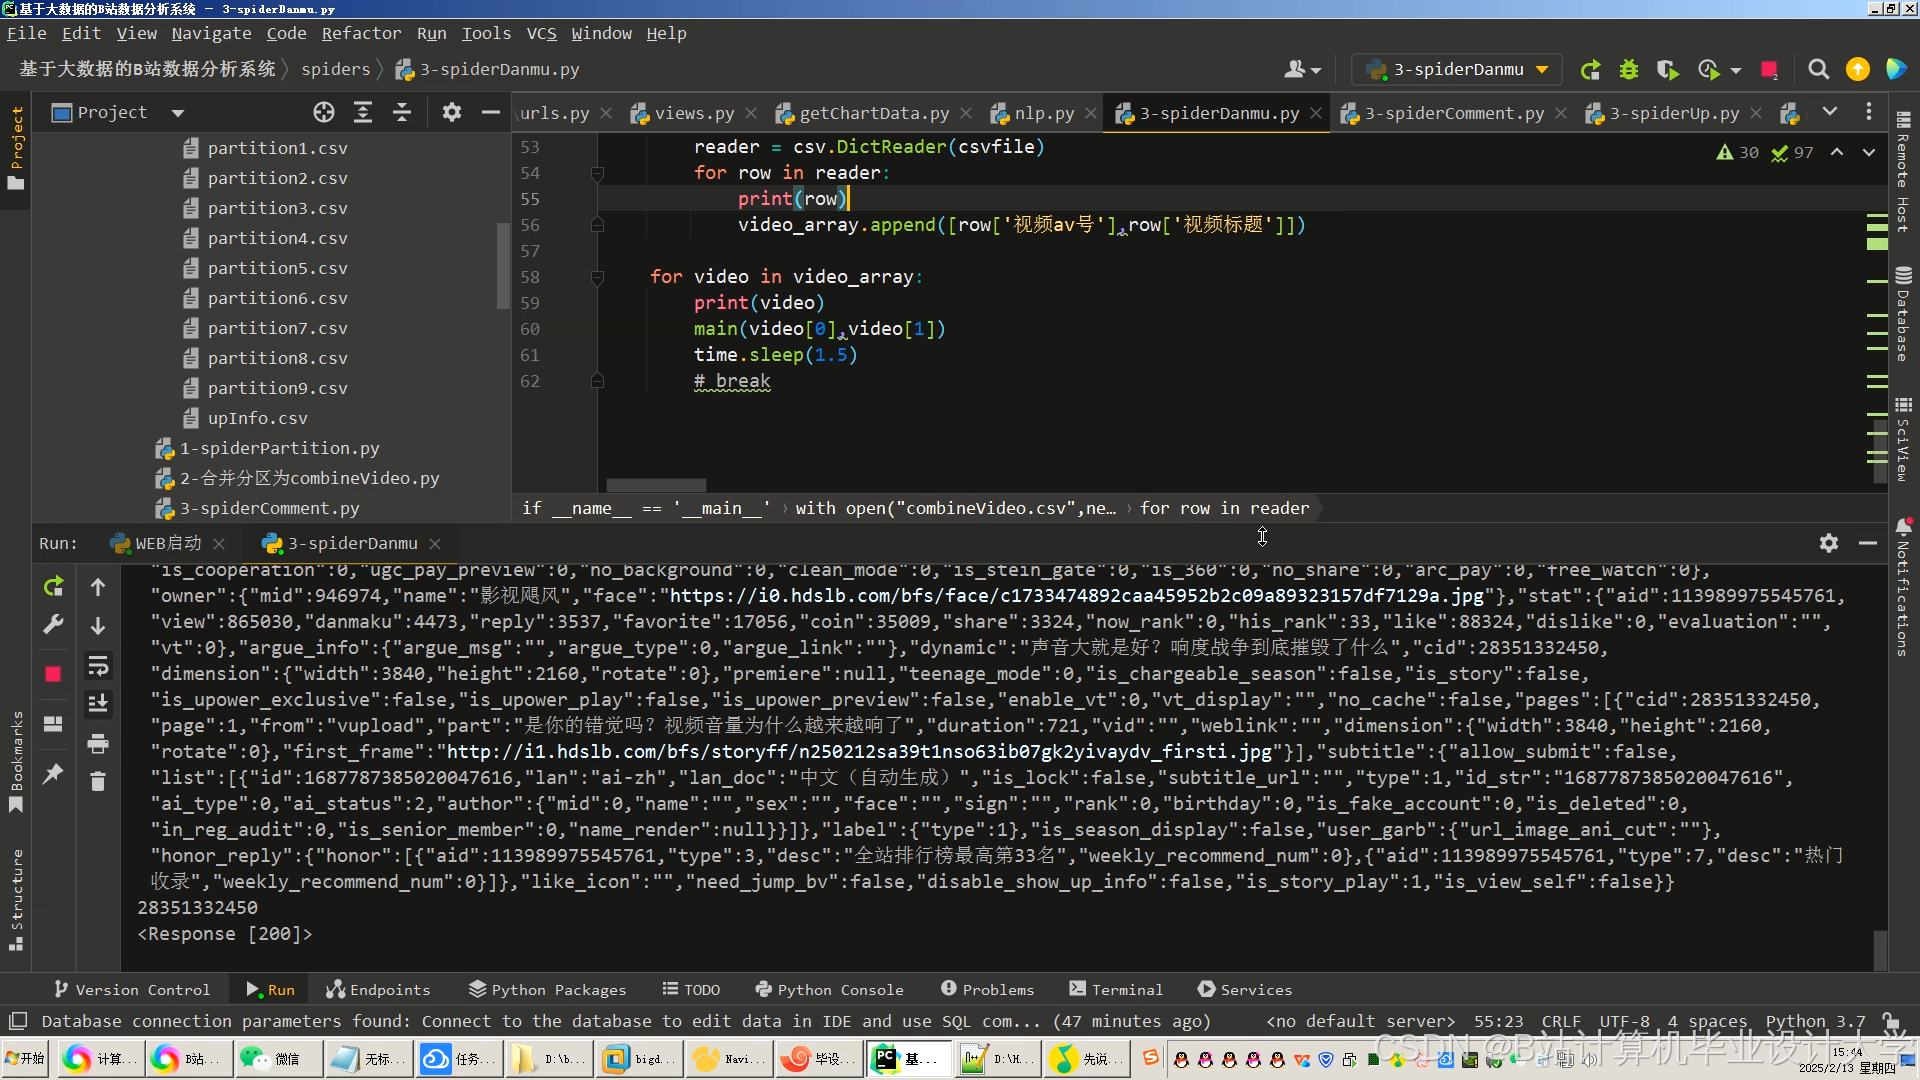
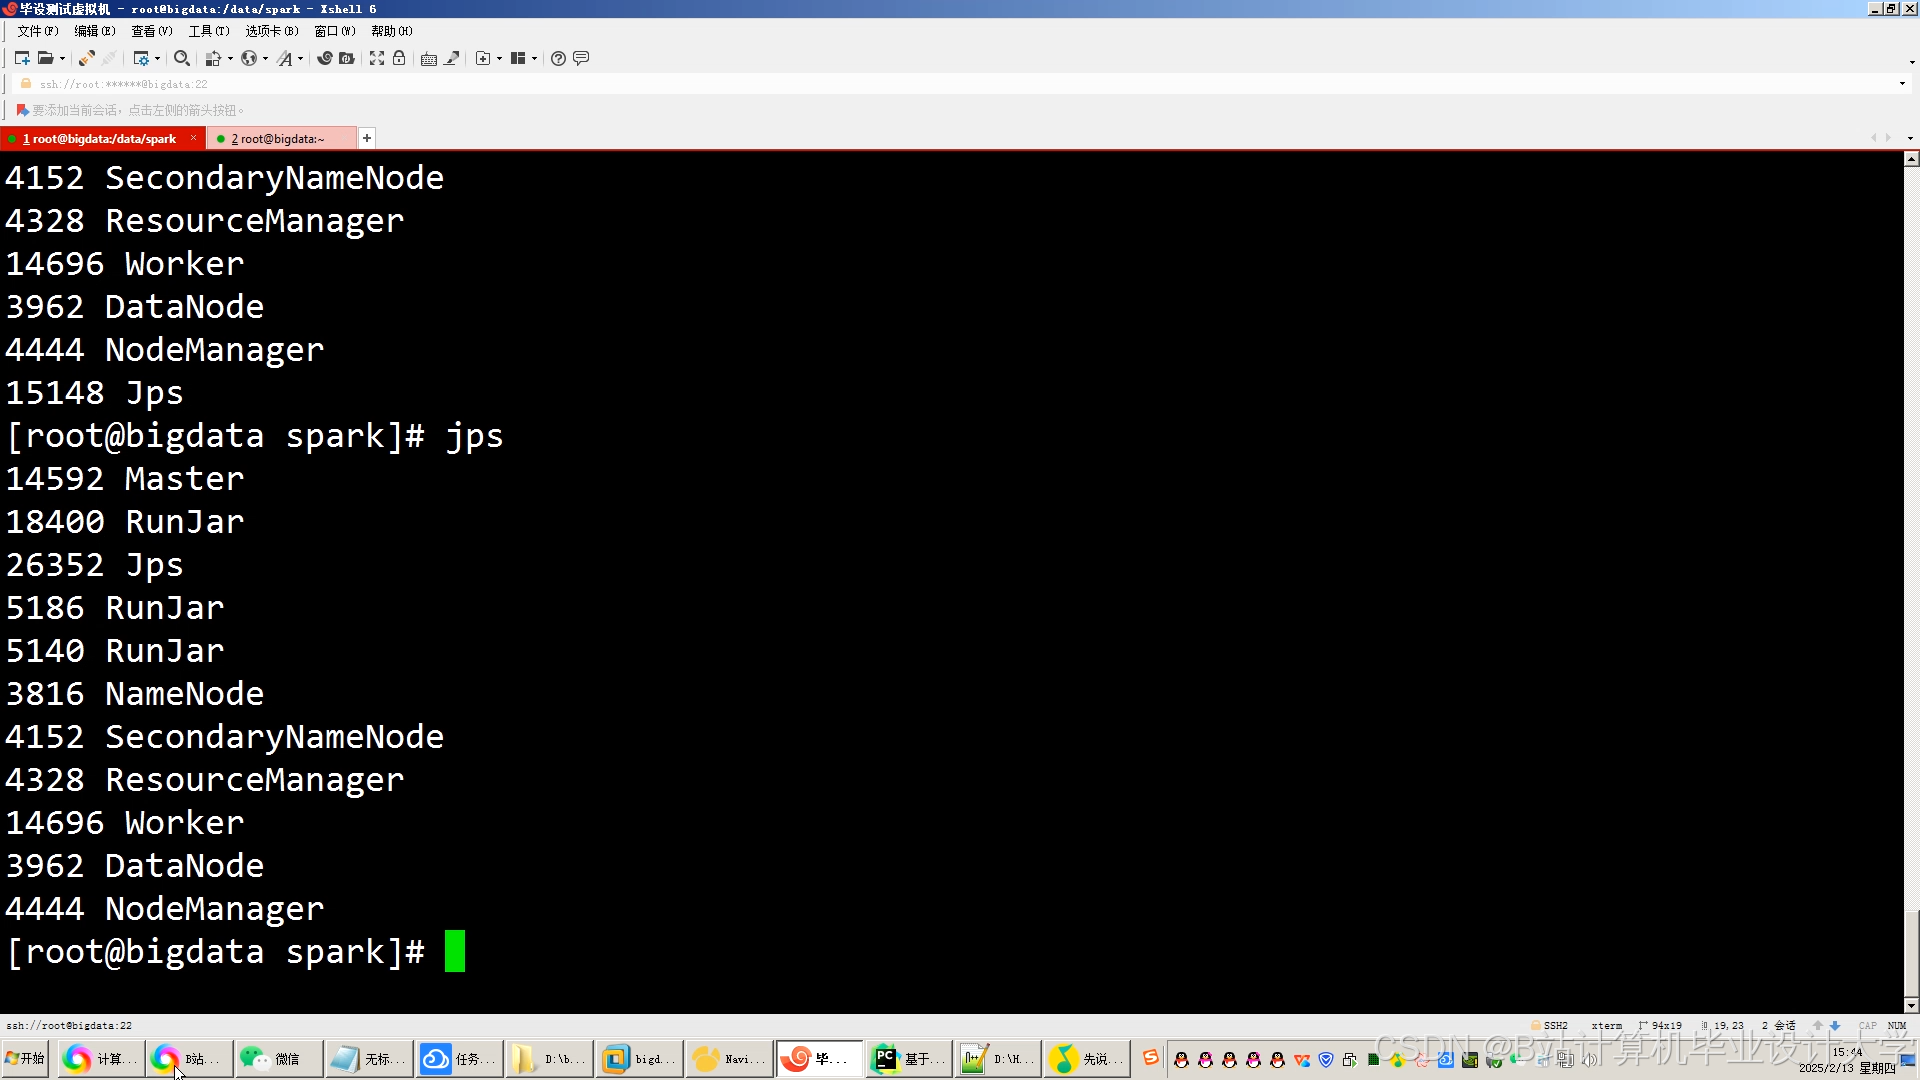
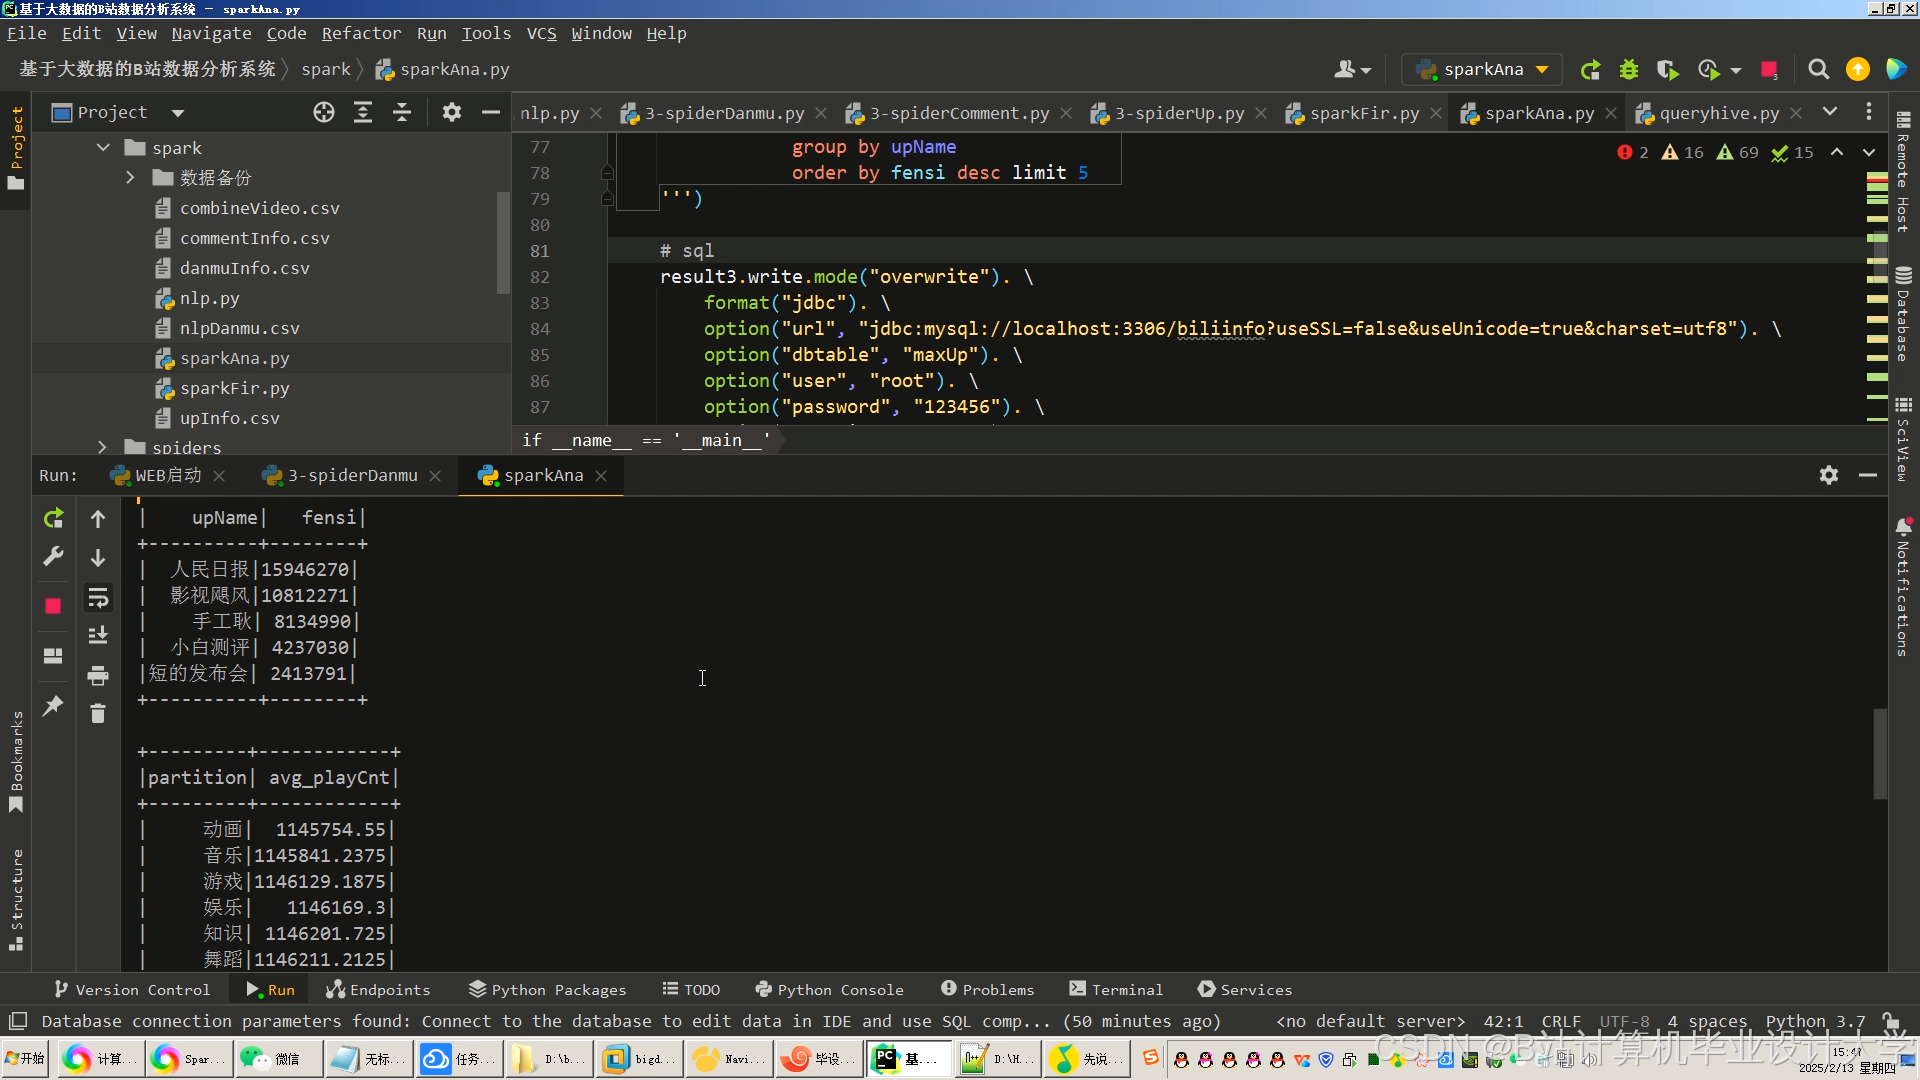
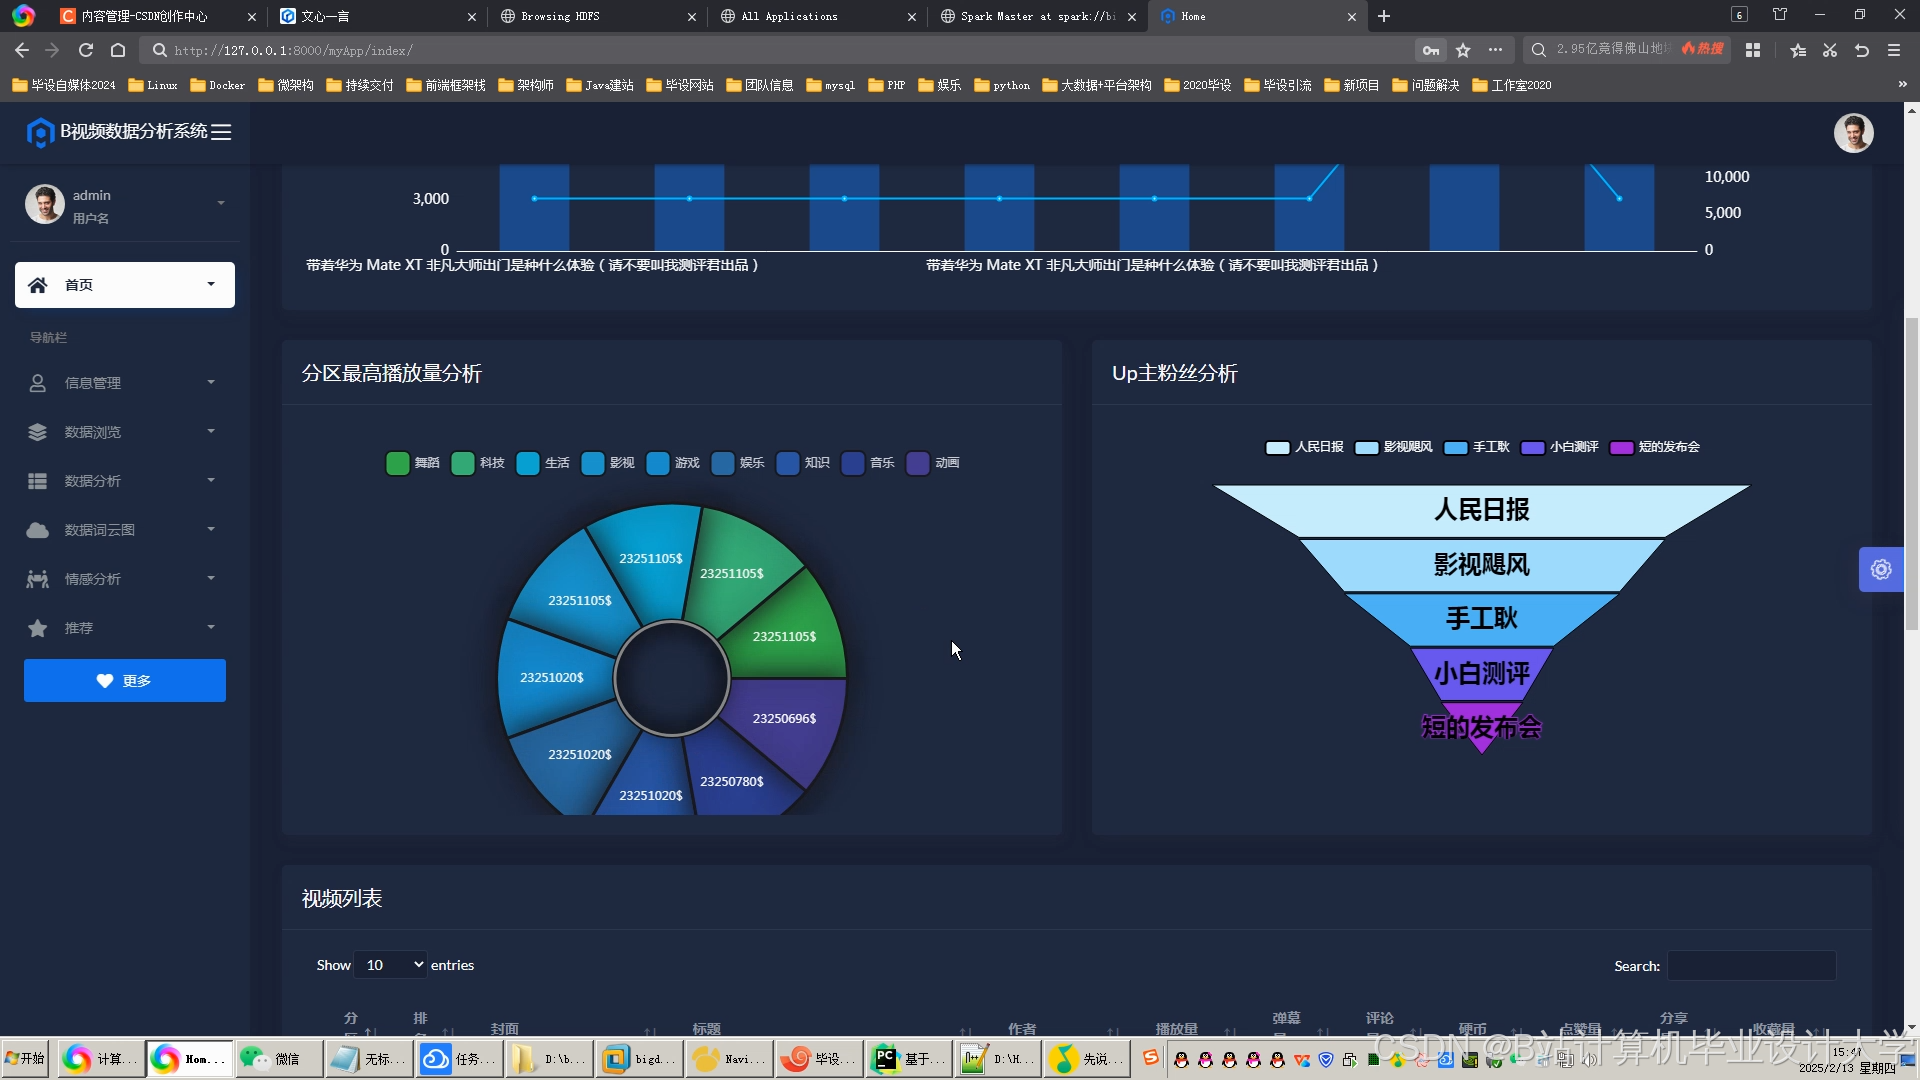
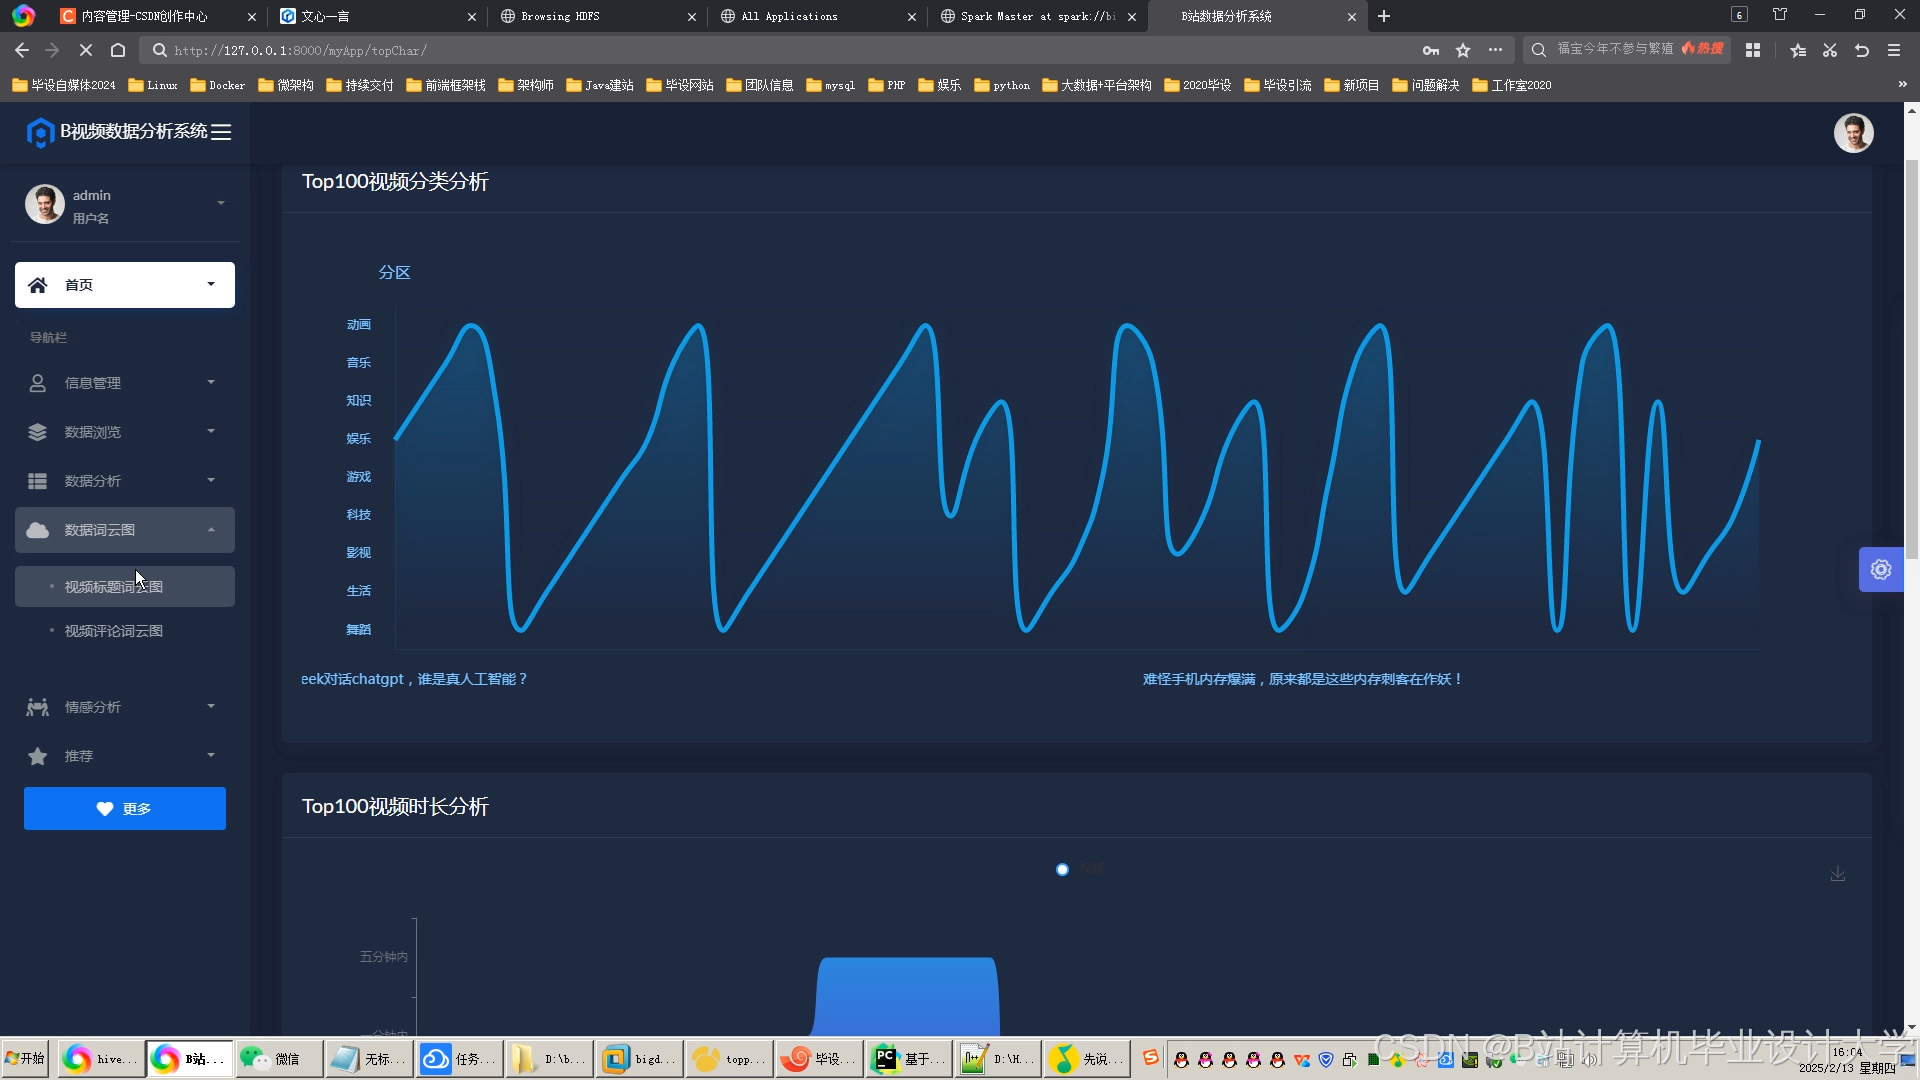
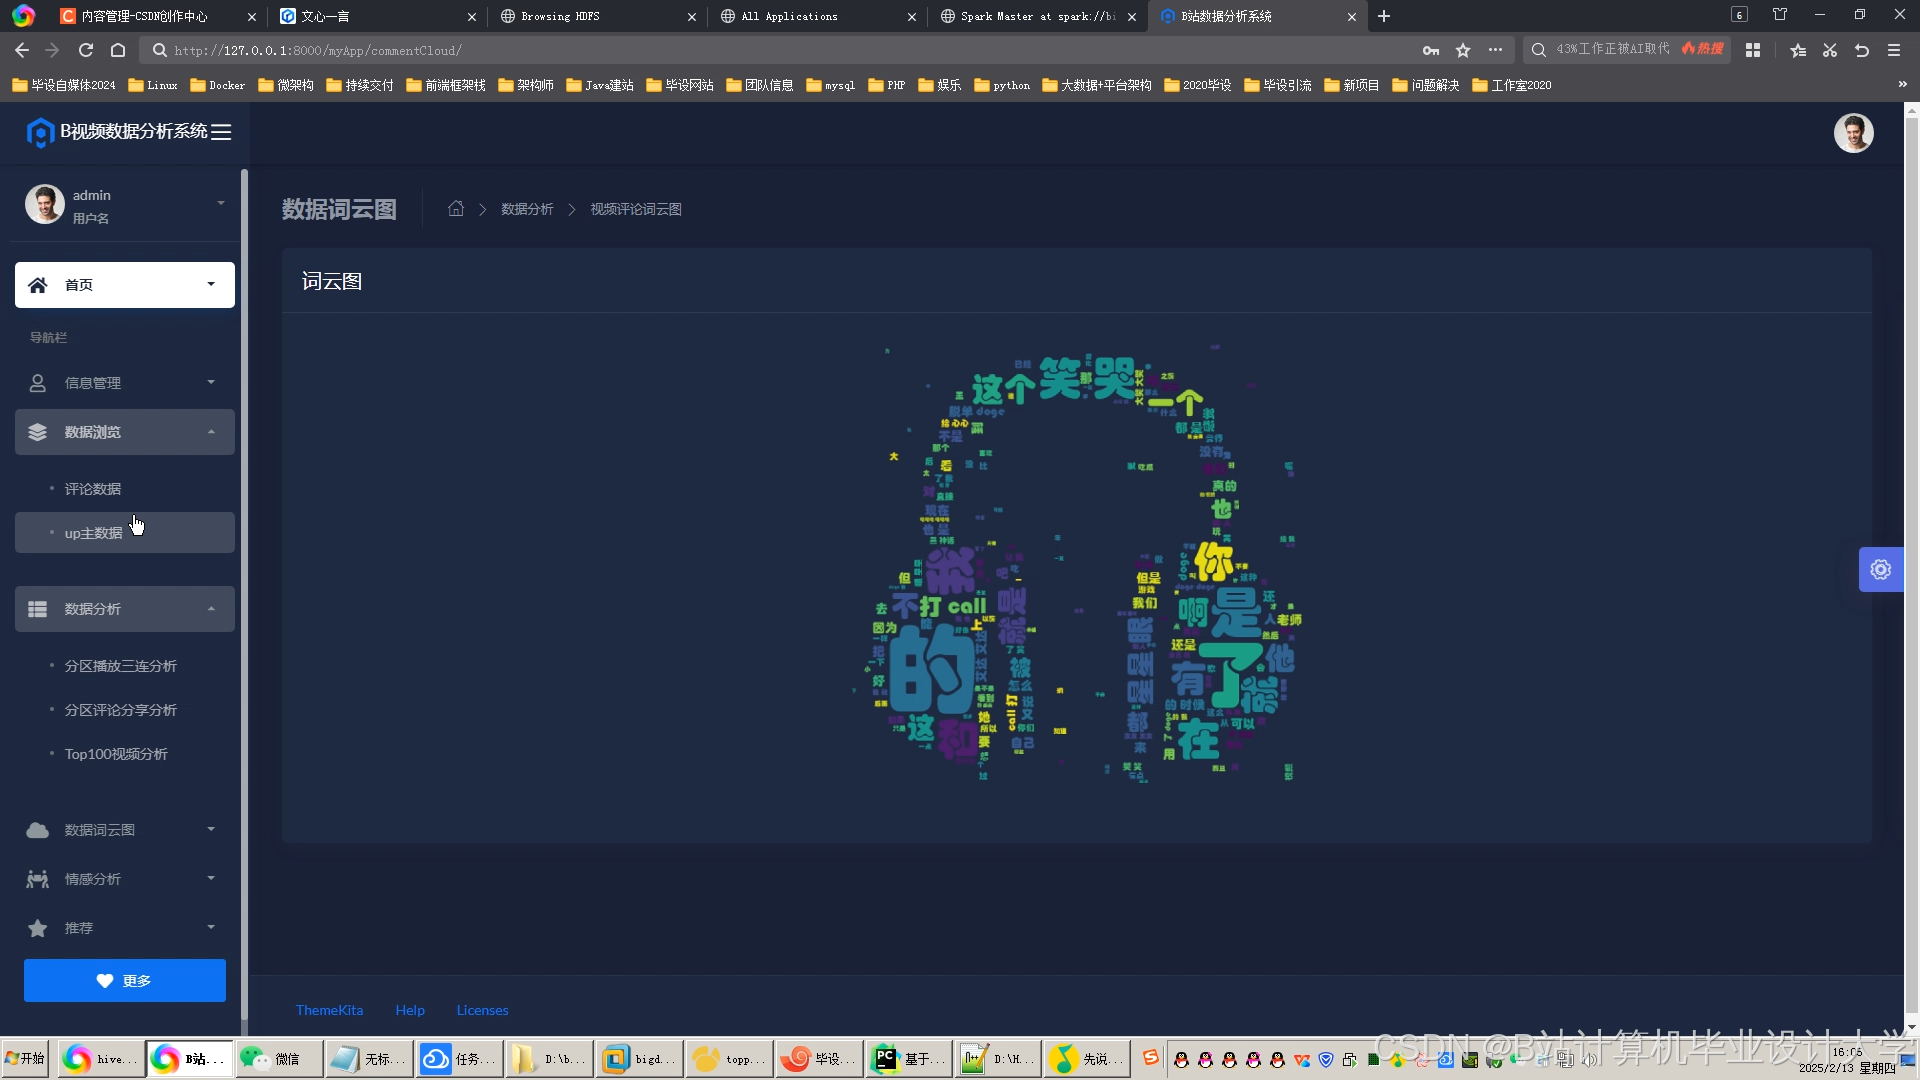
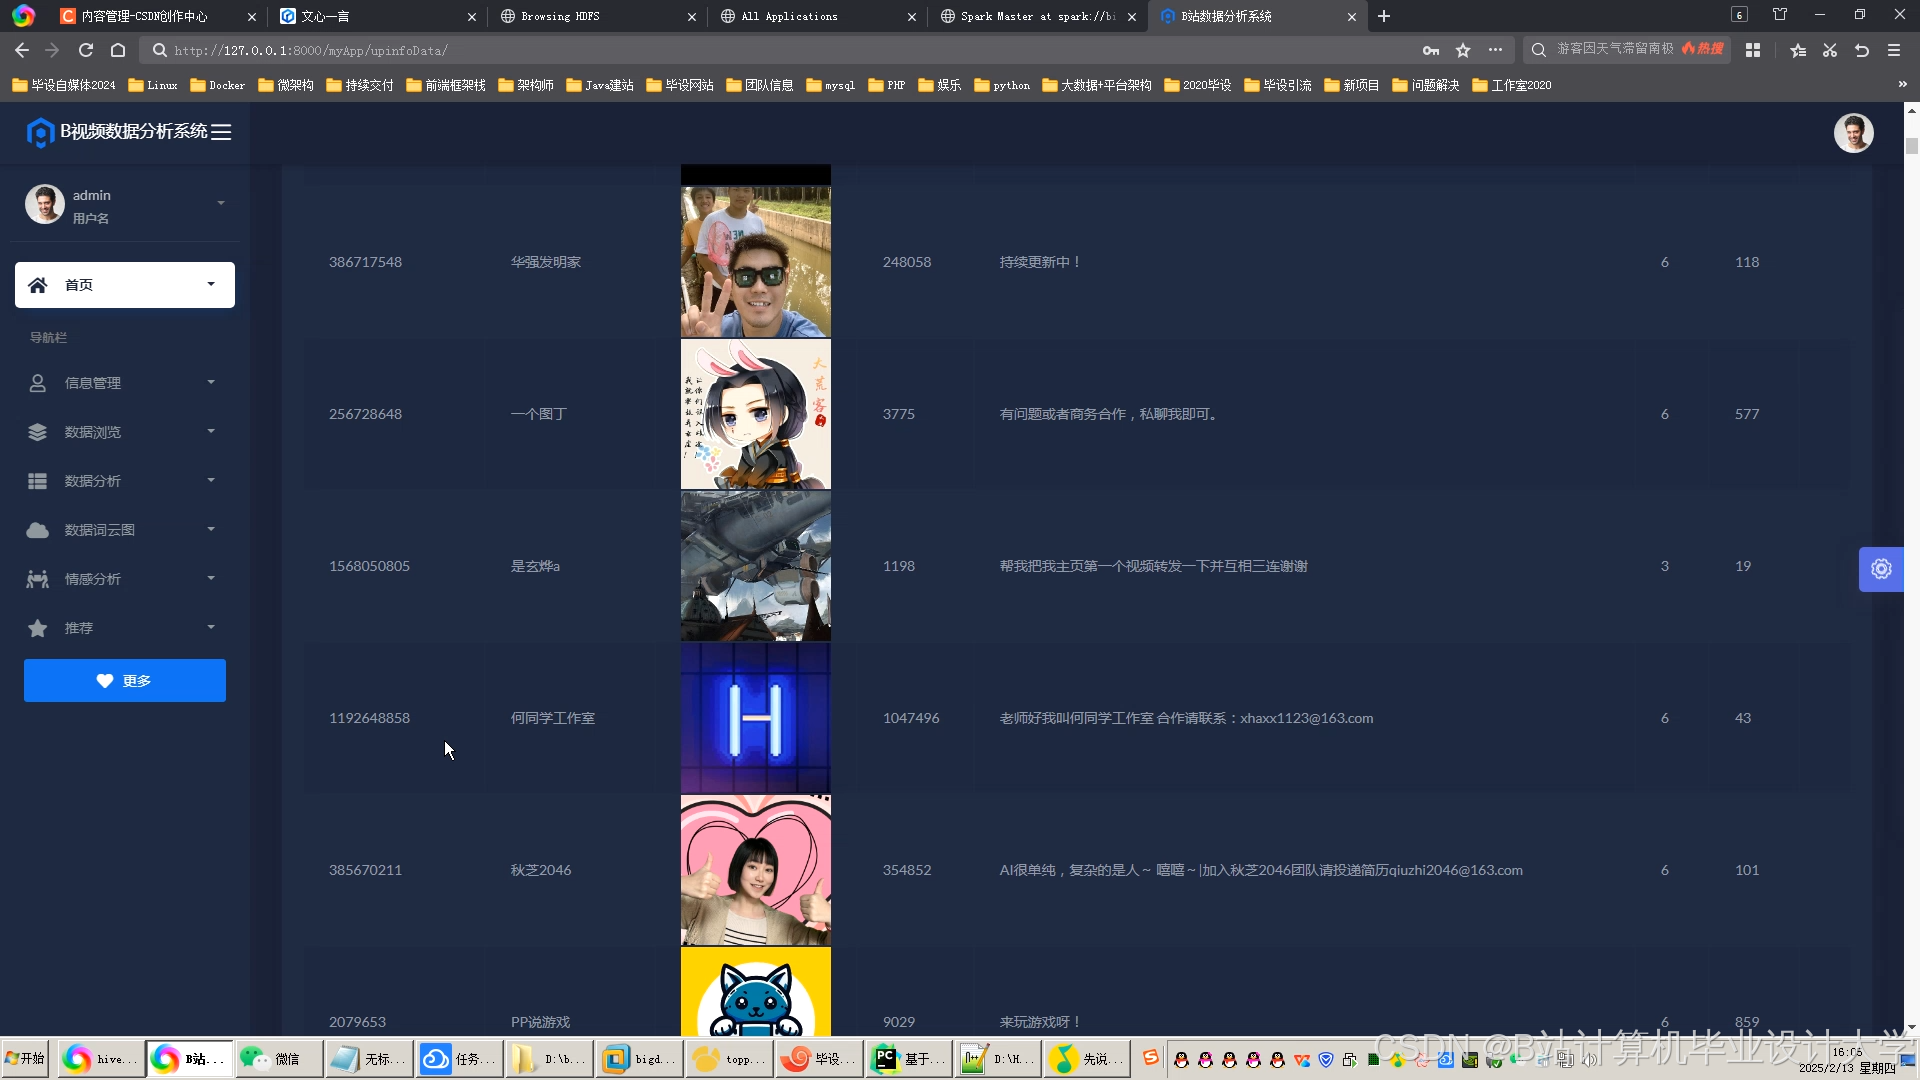
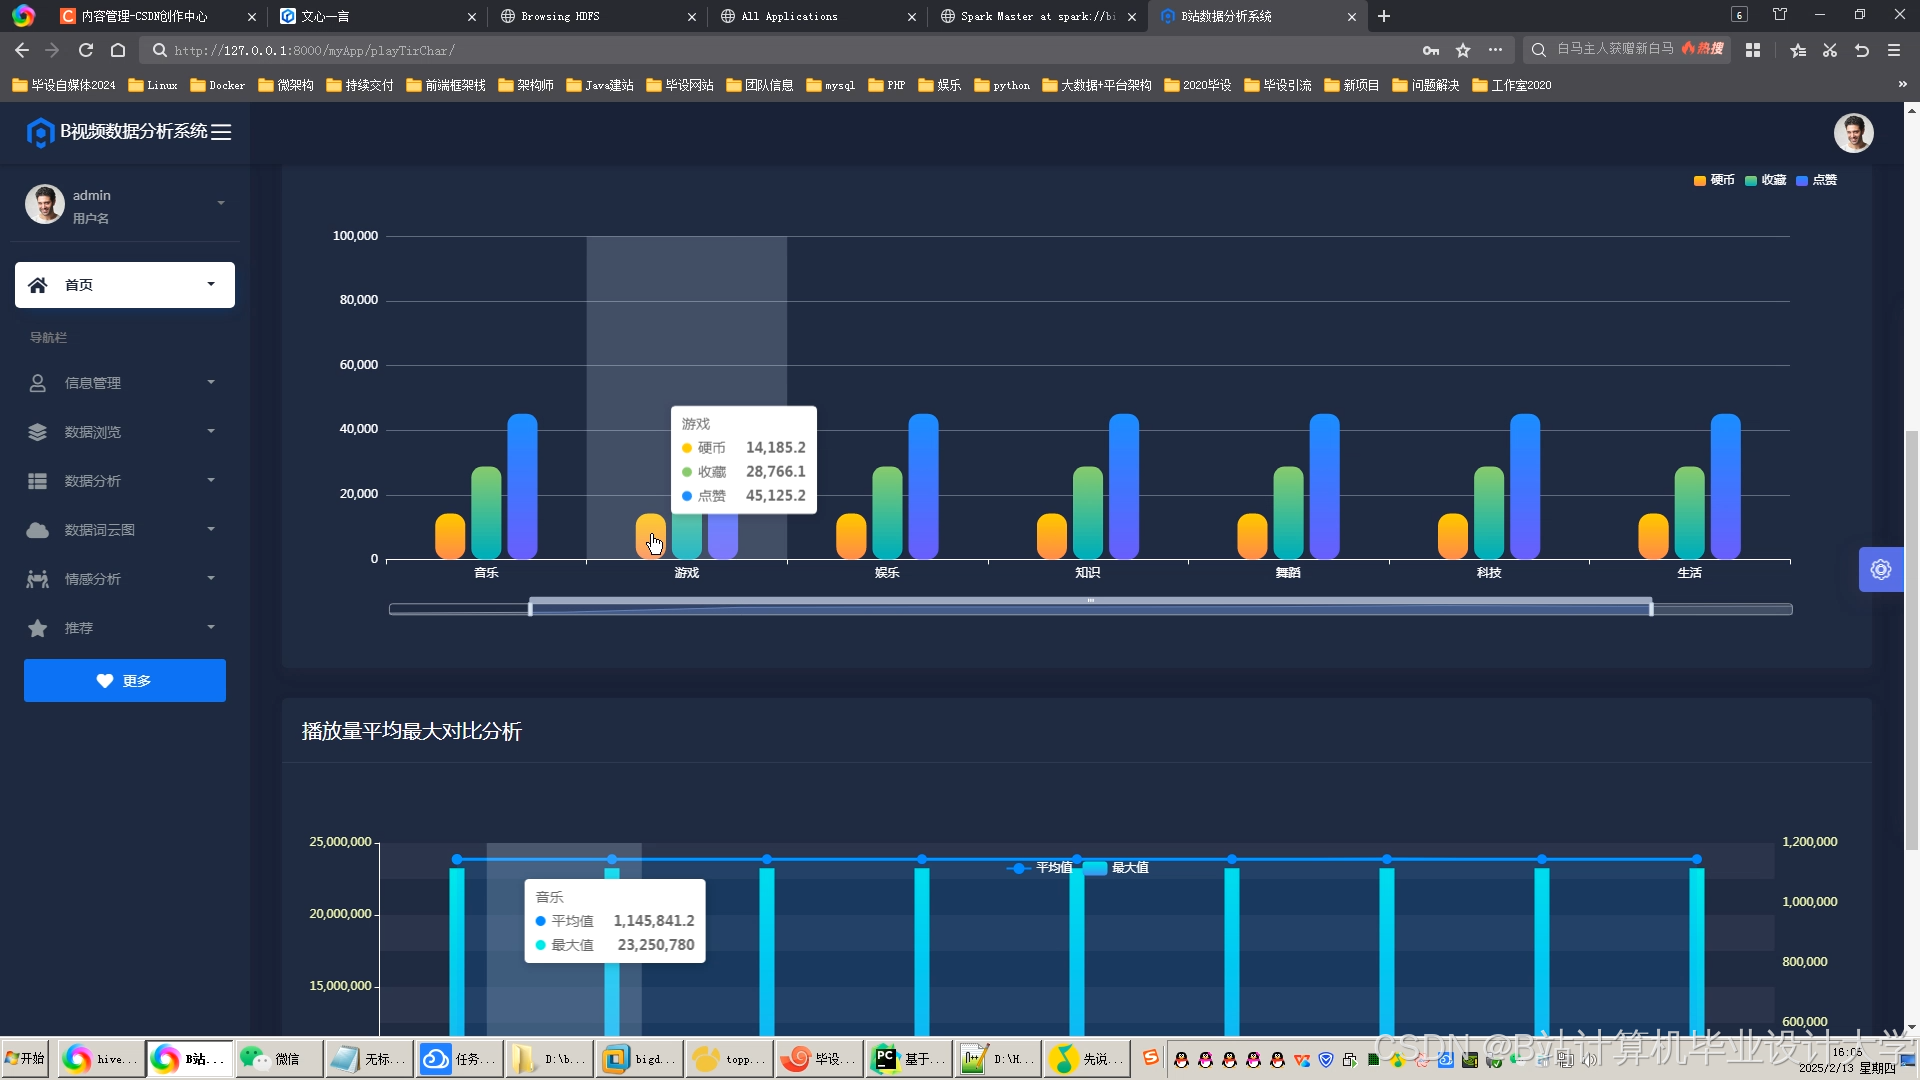
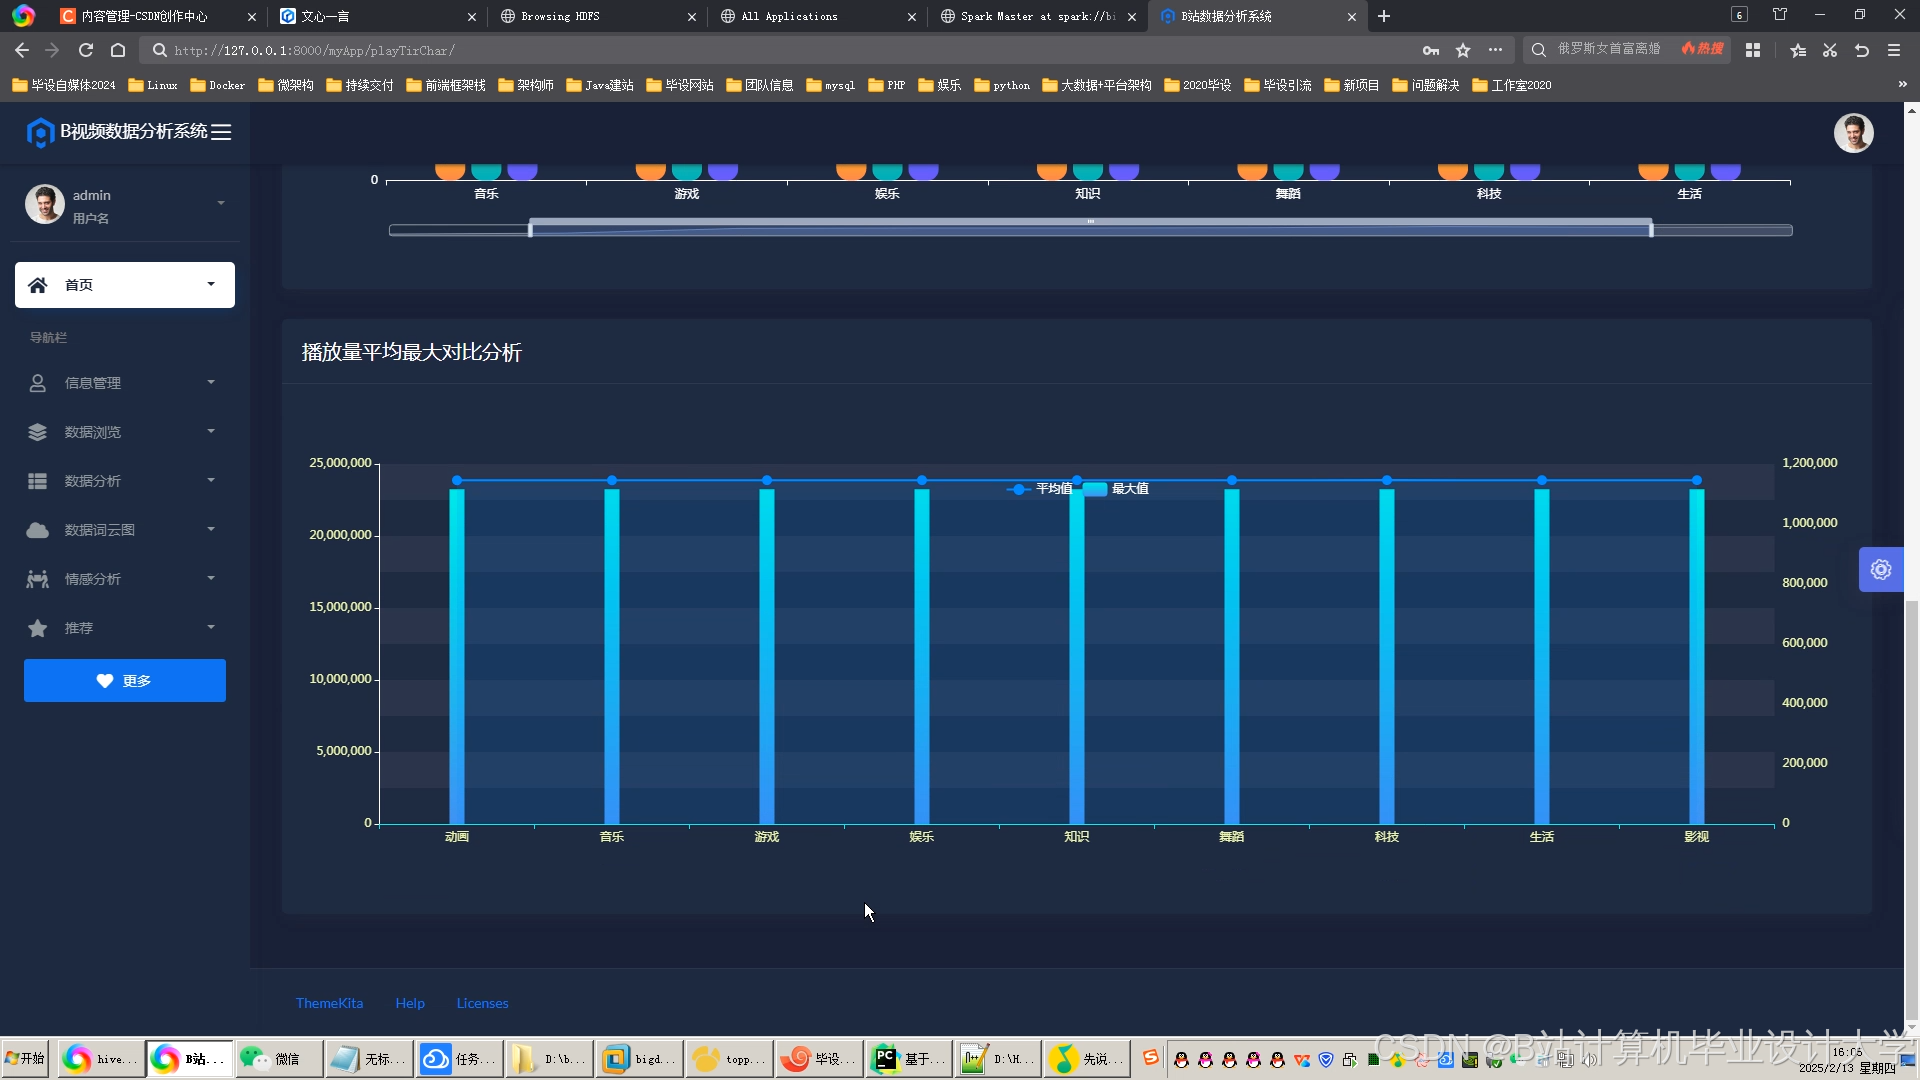
运行截图
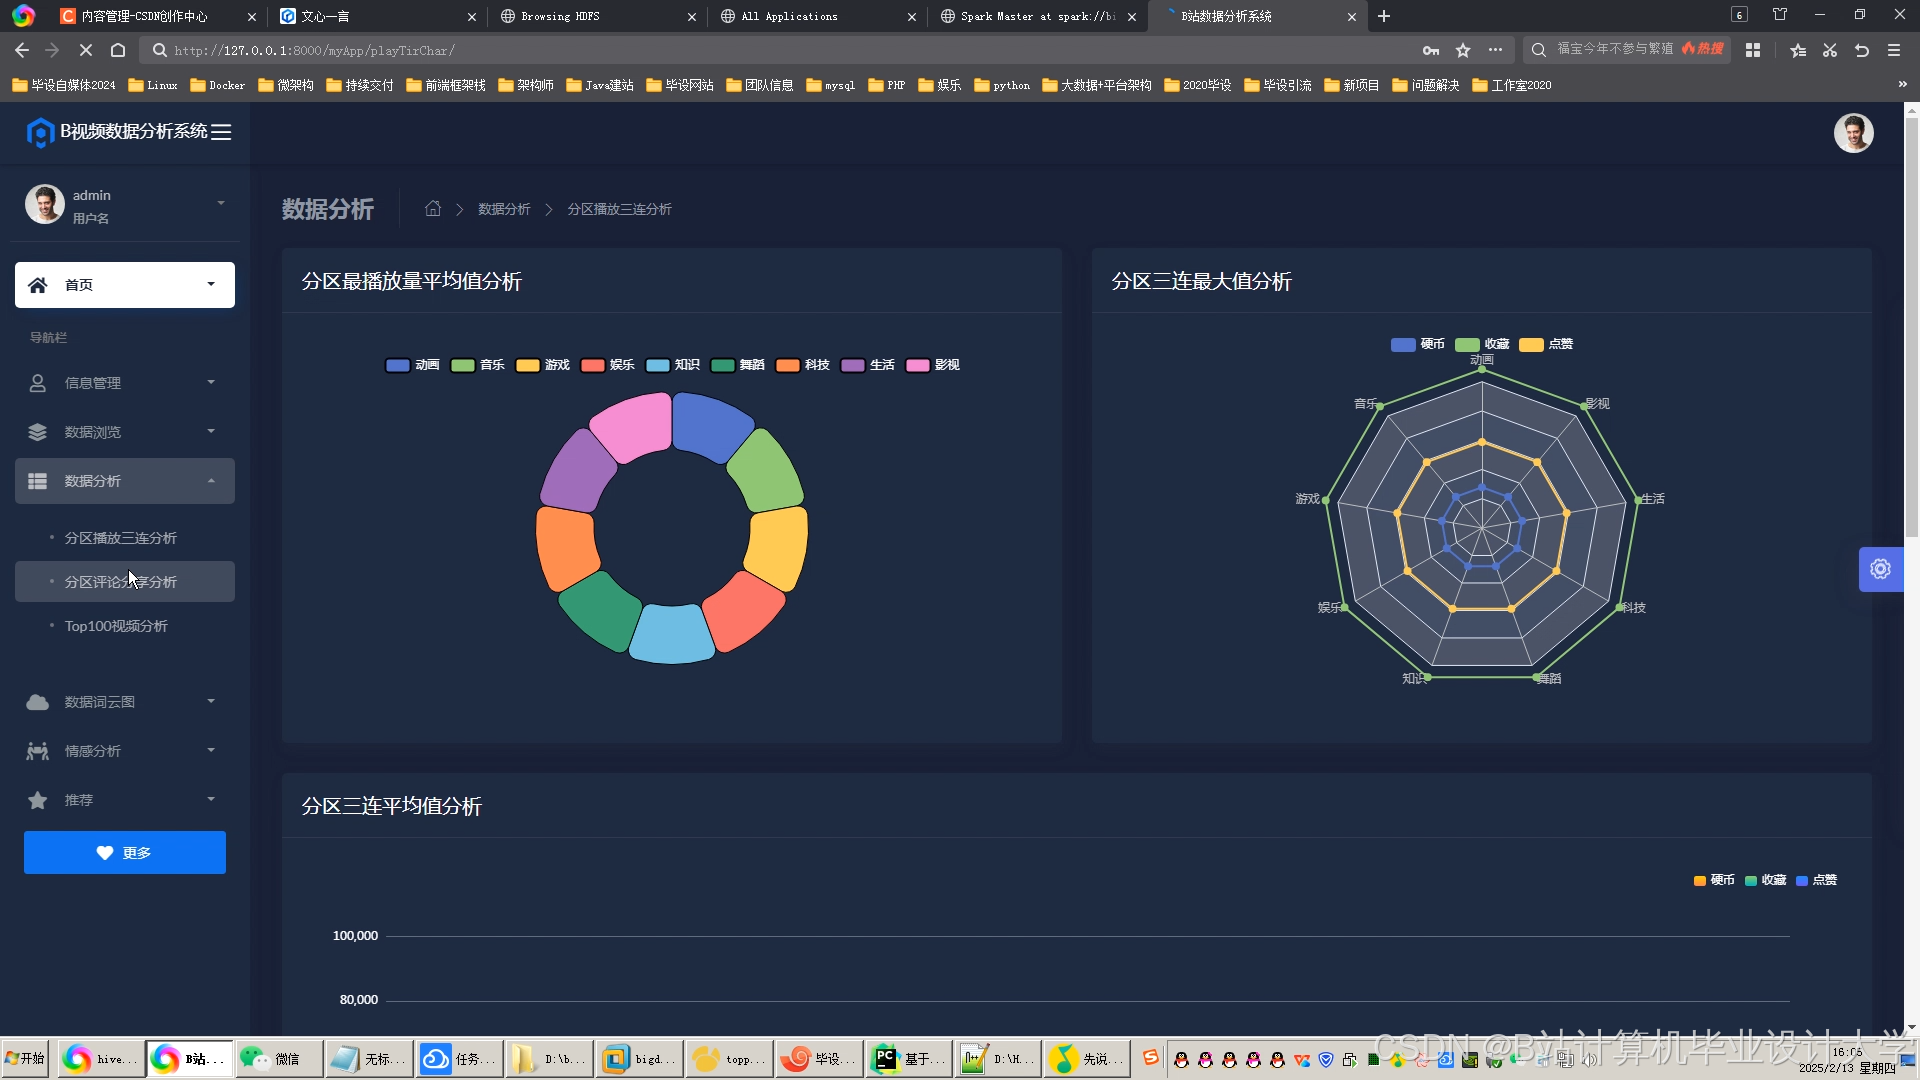
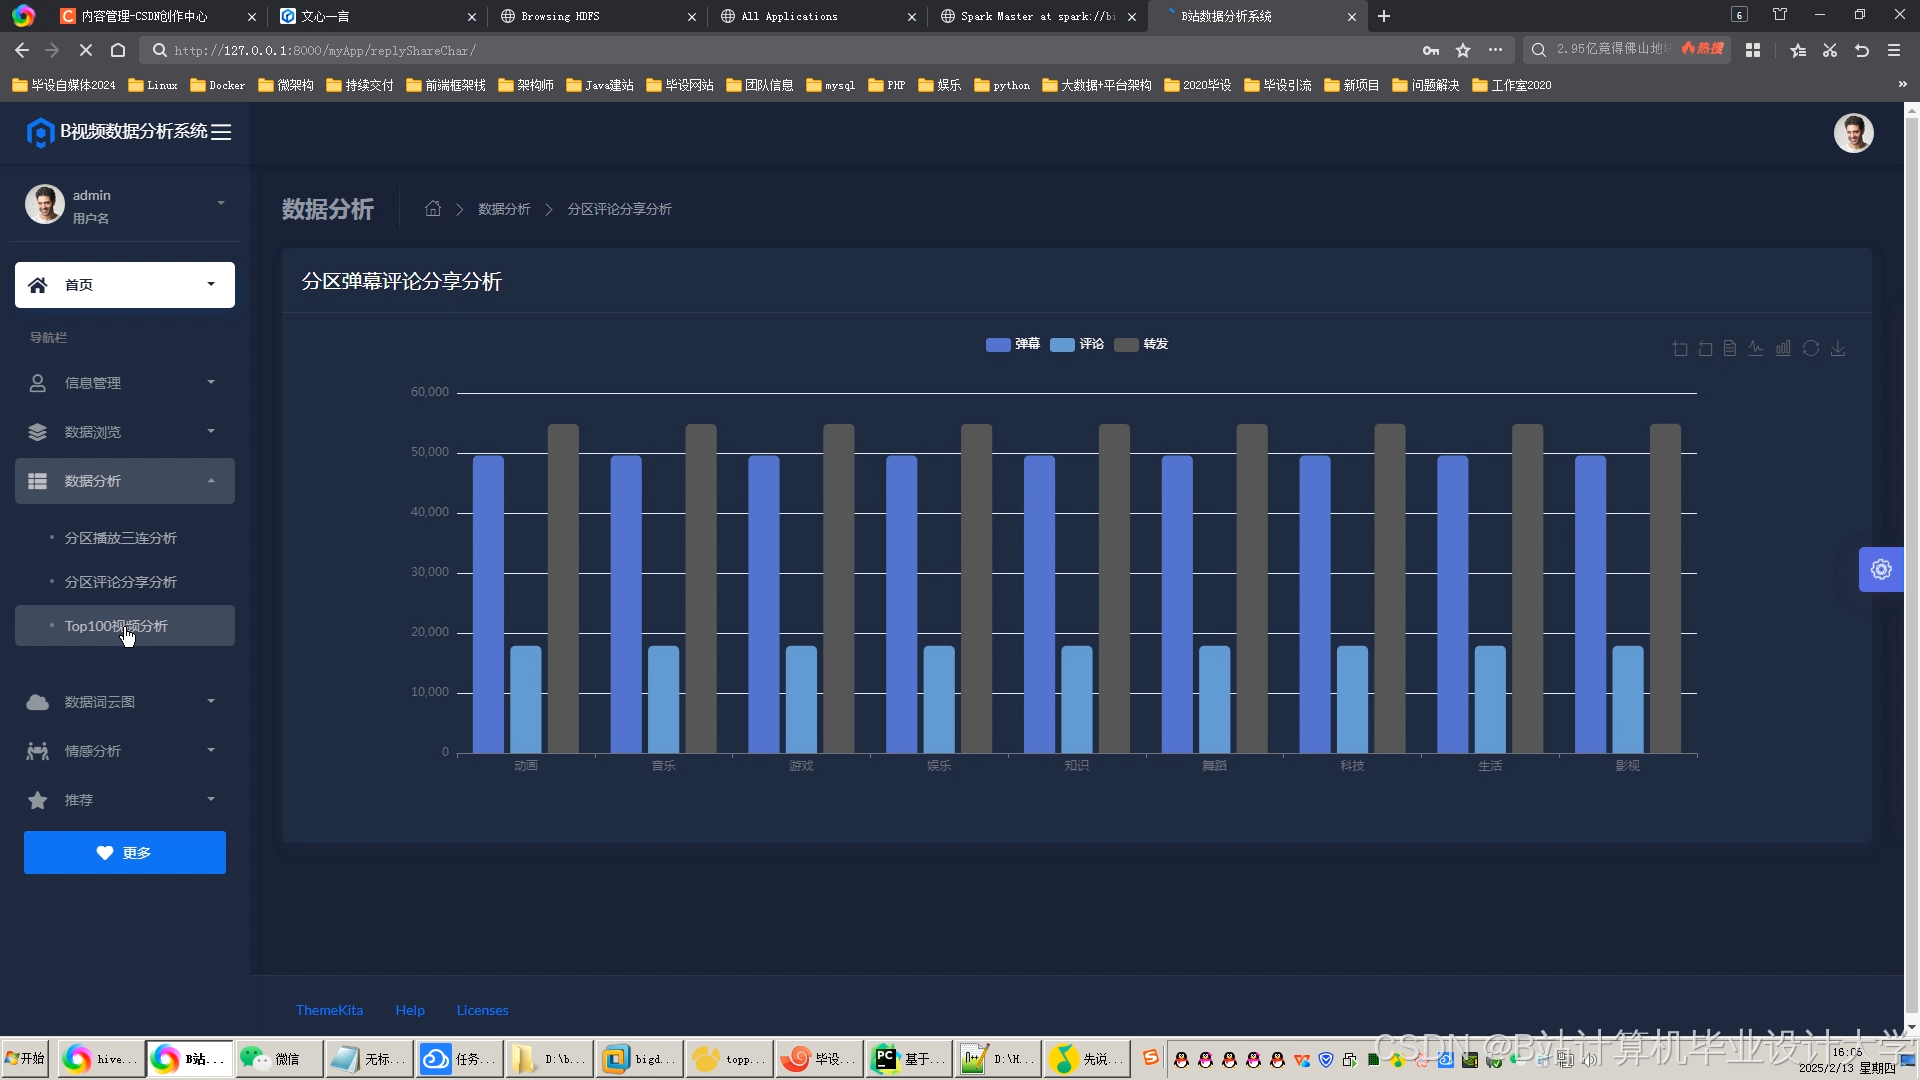
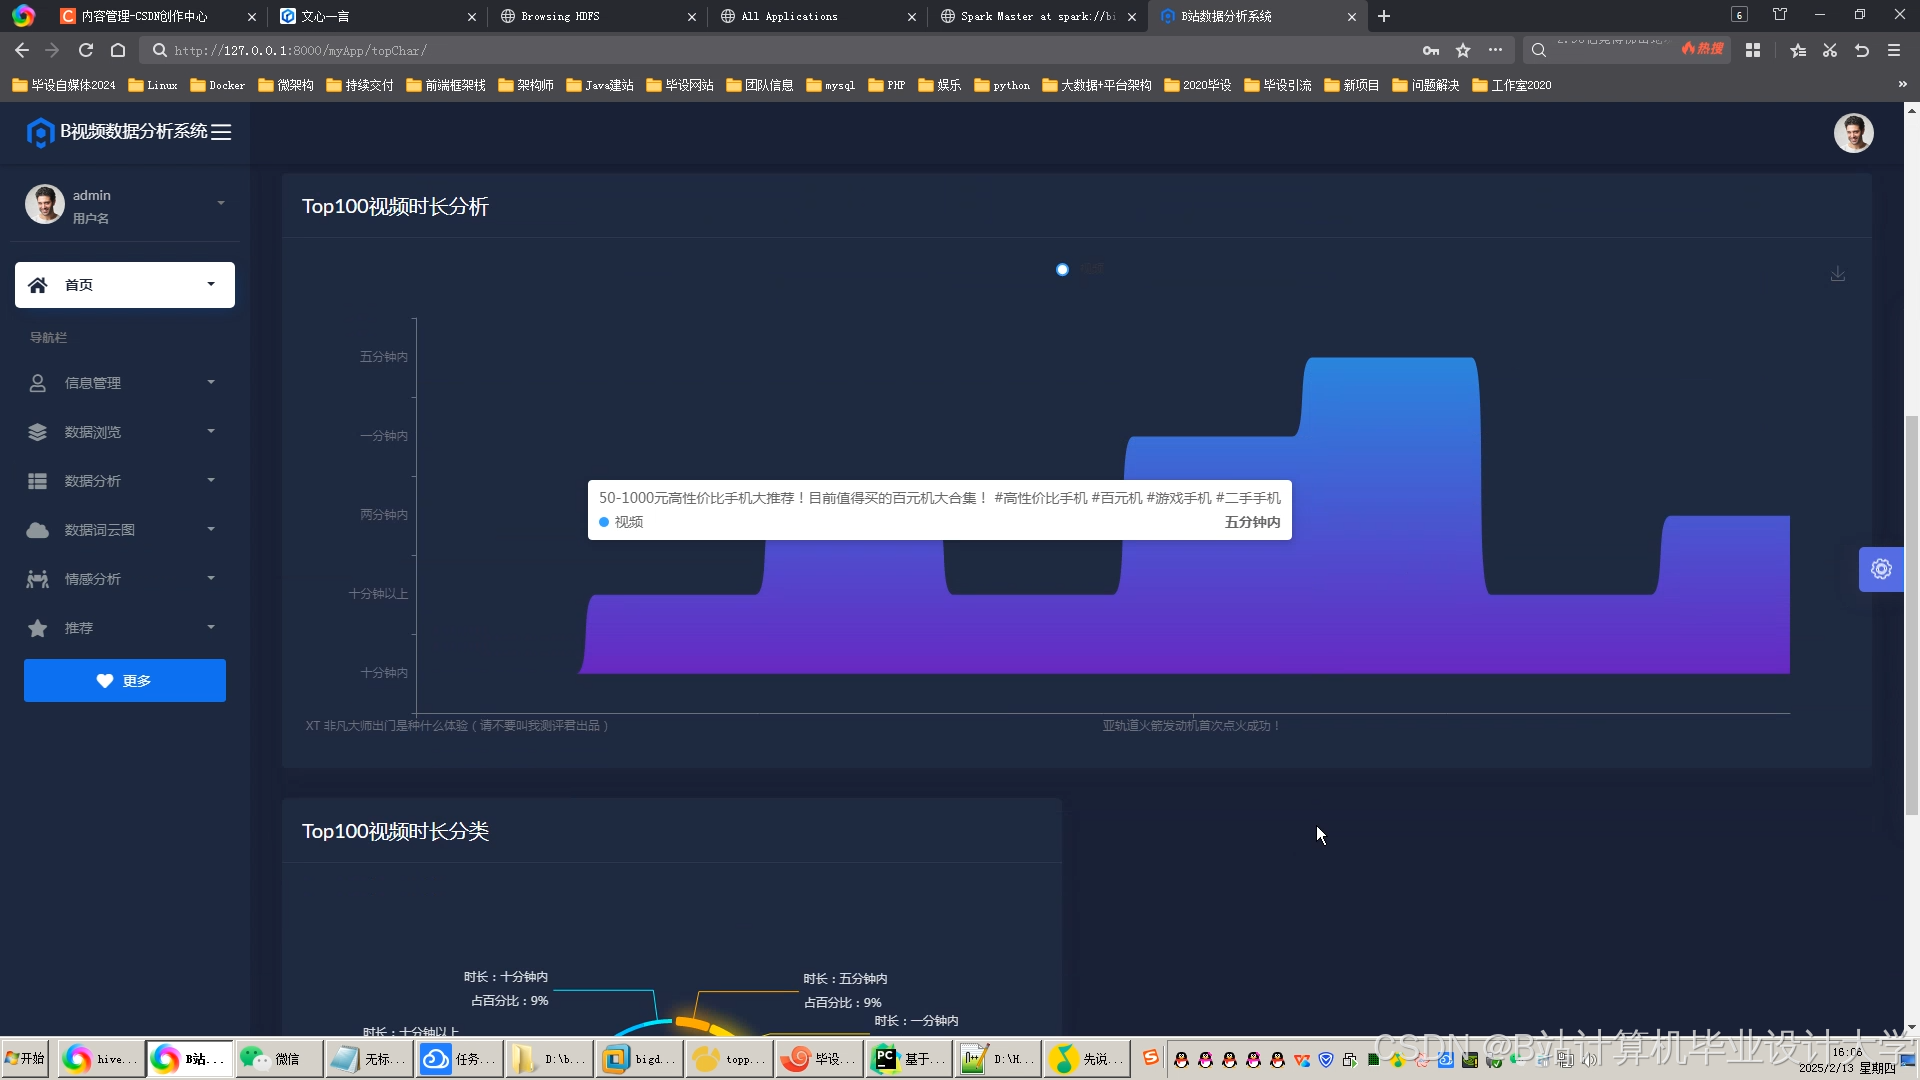
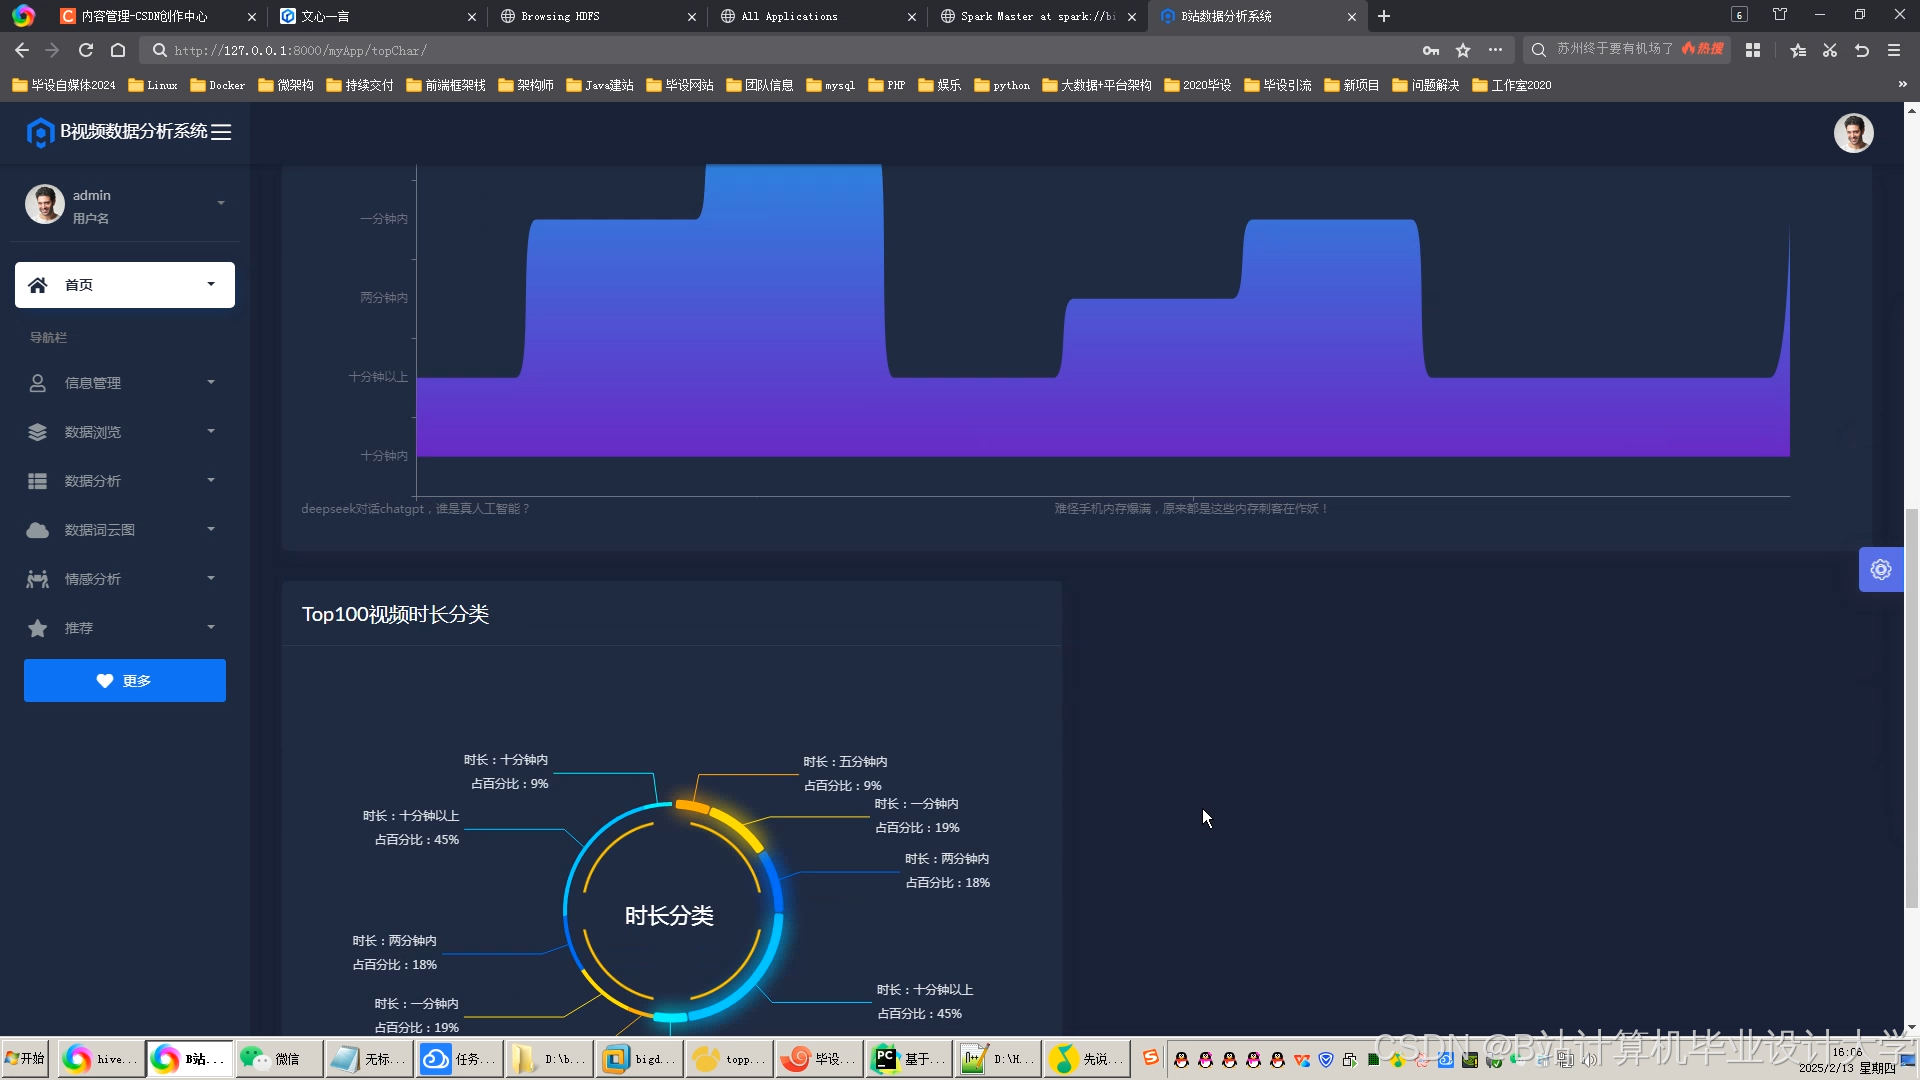
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例
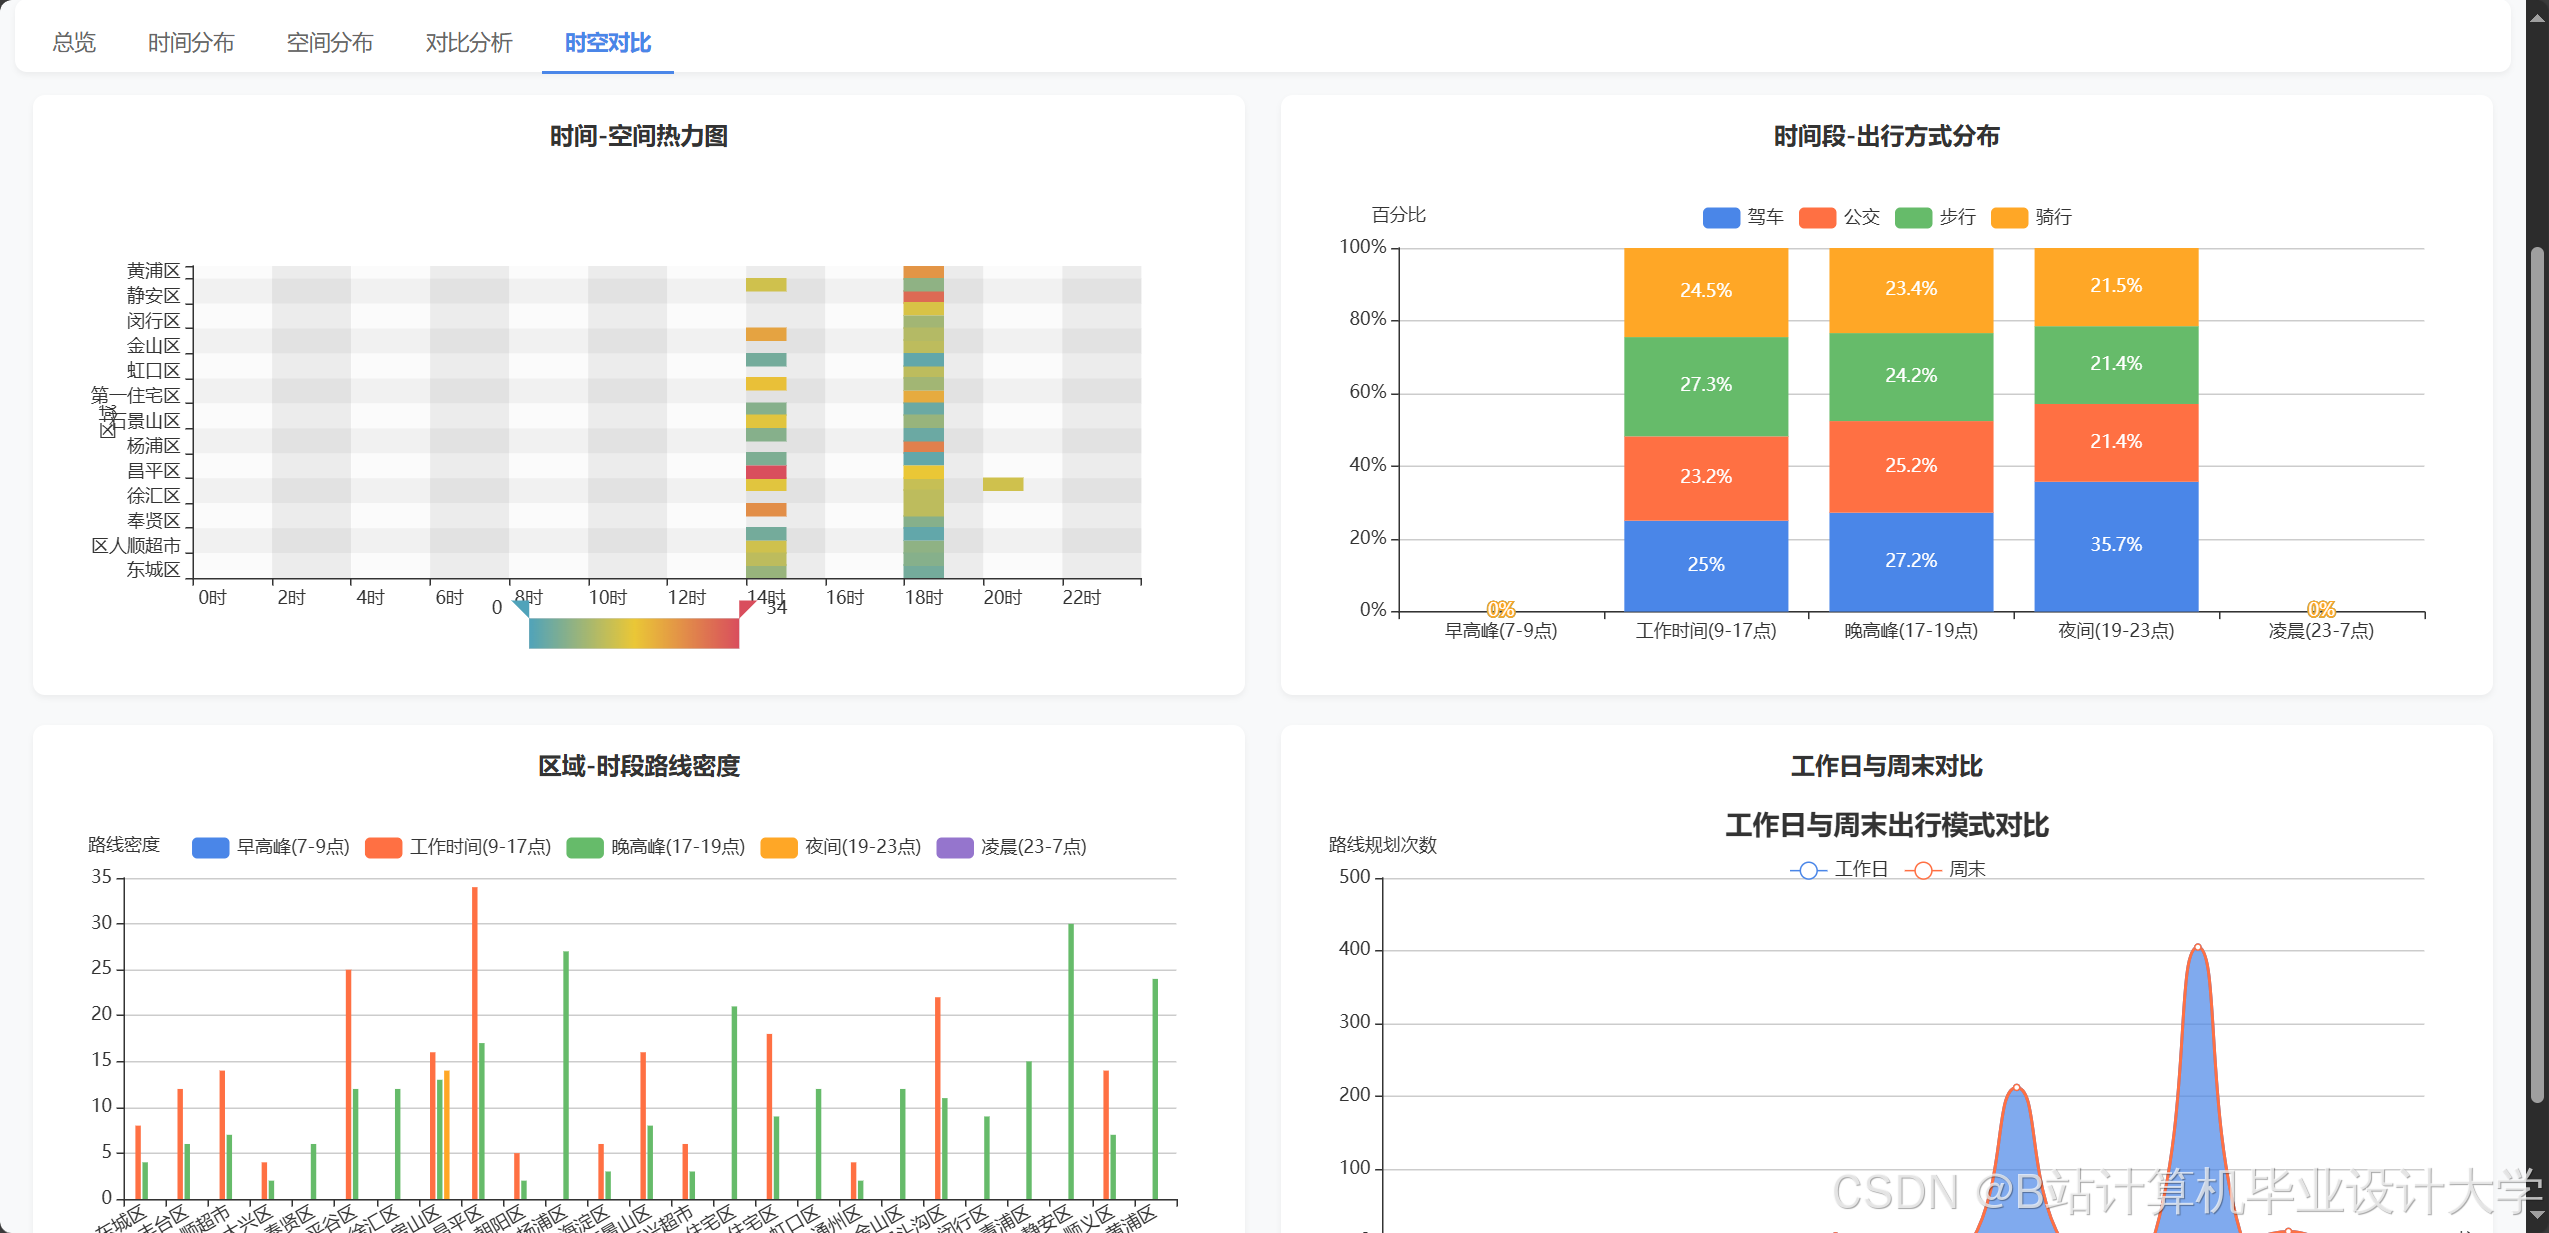
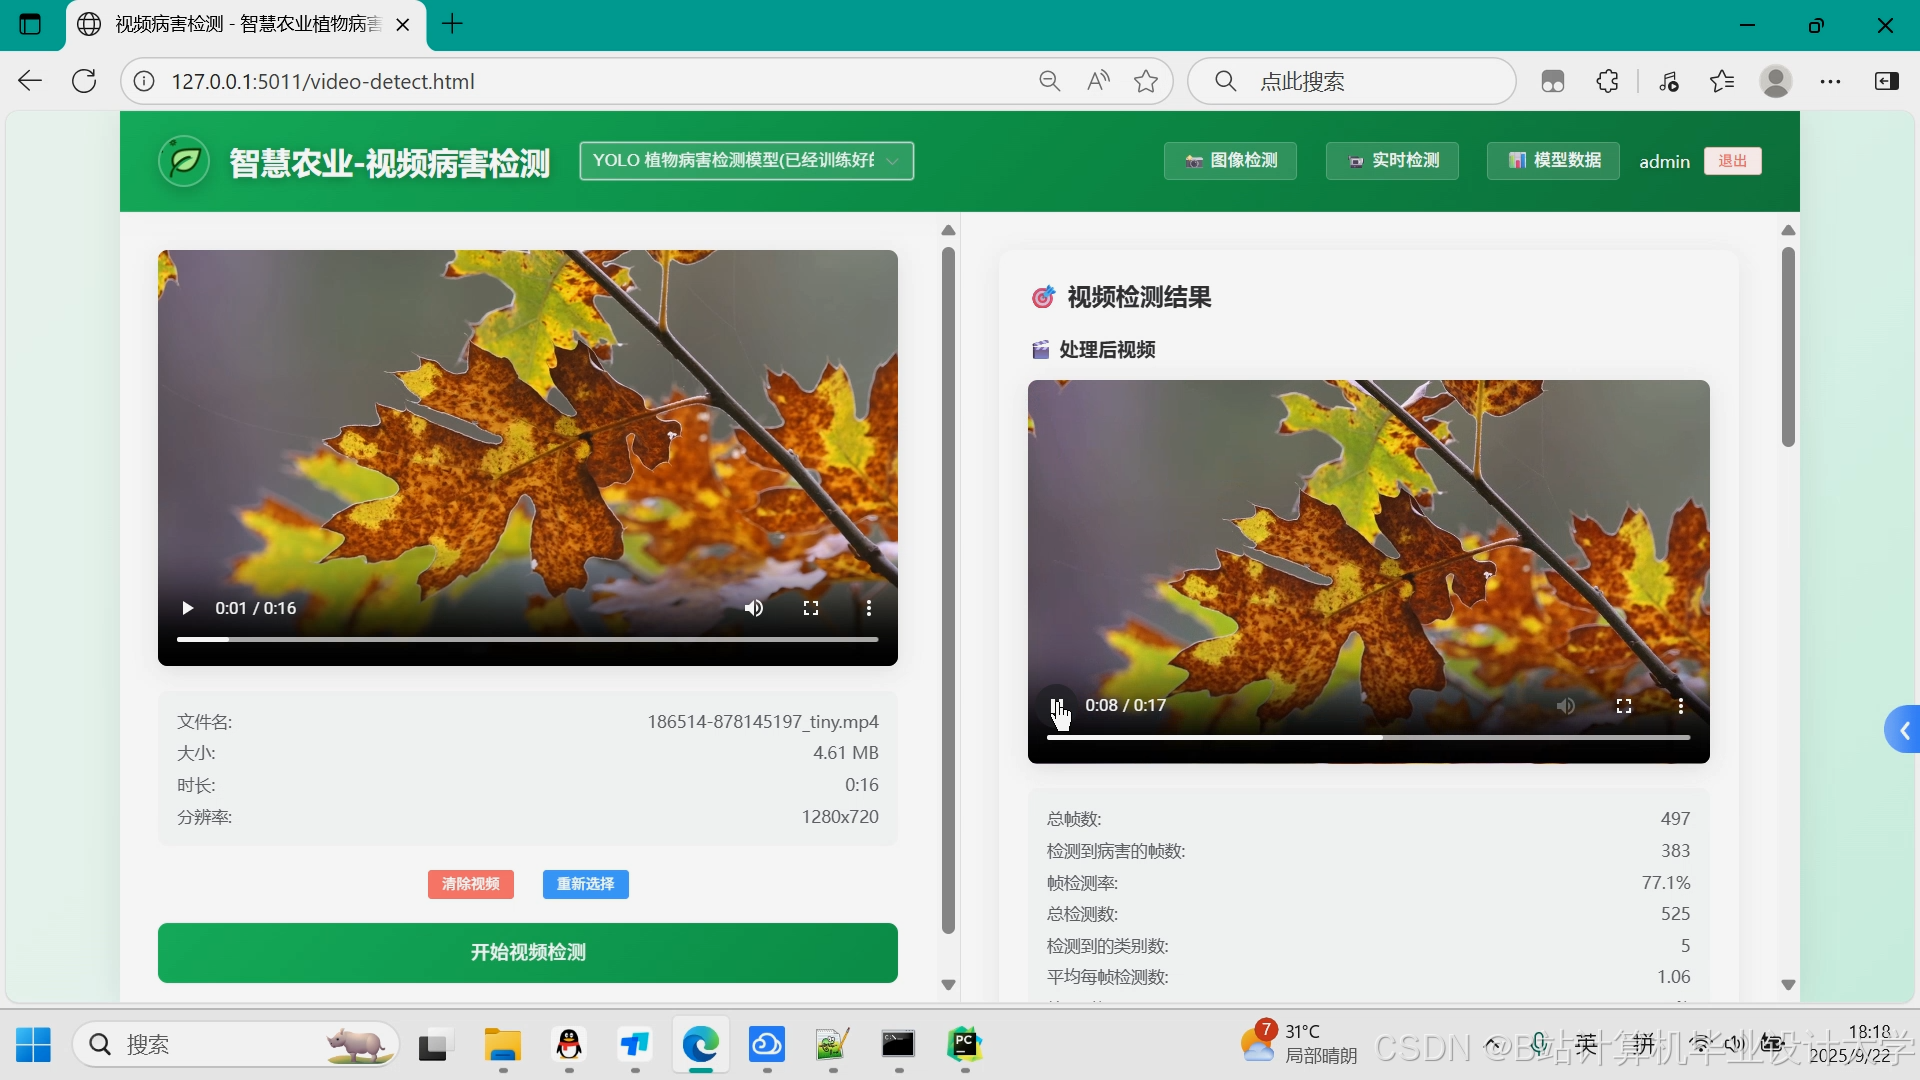
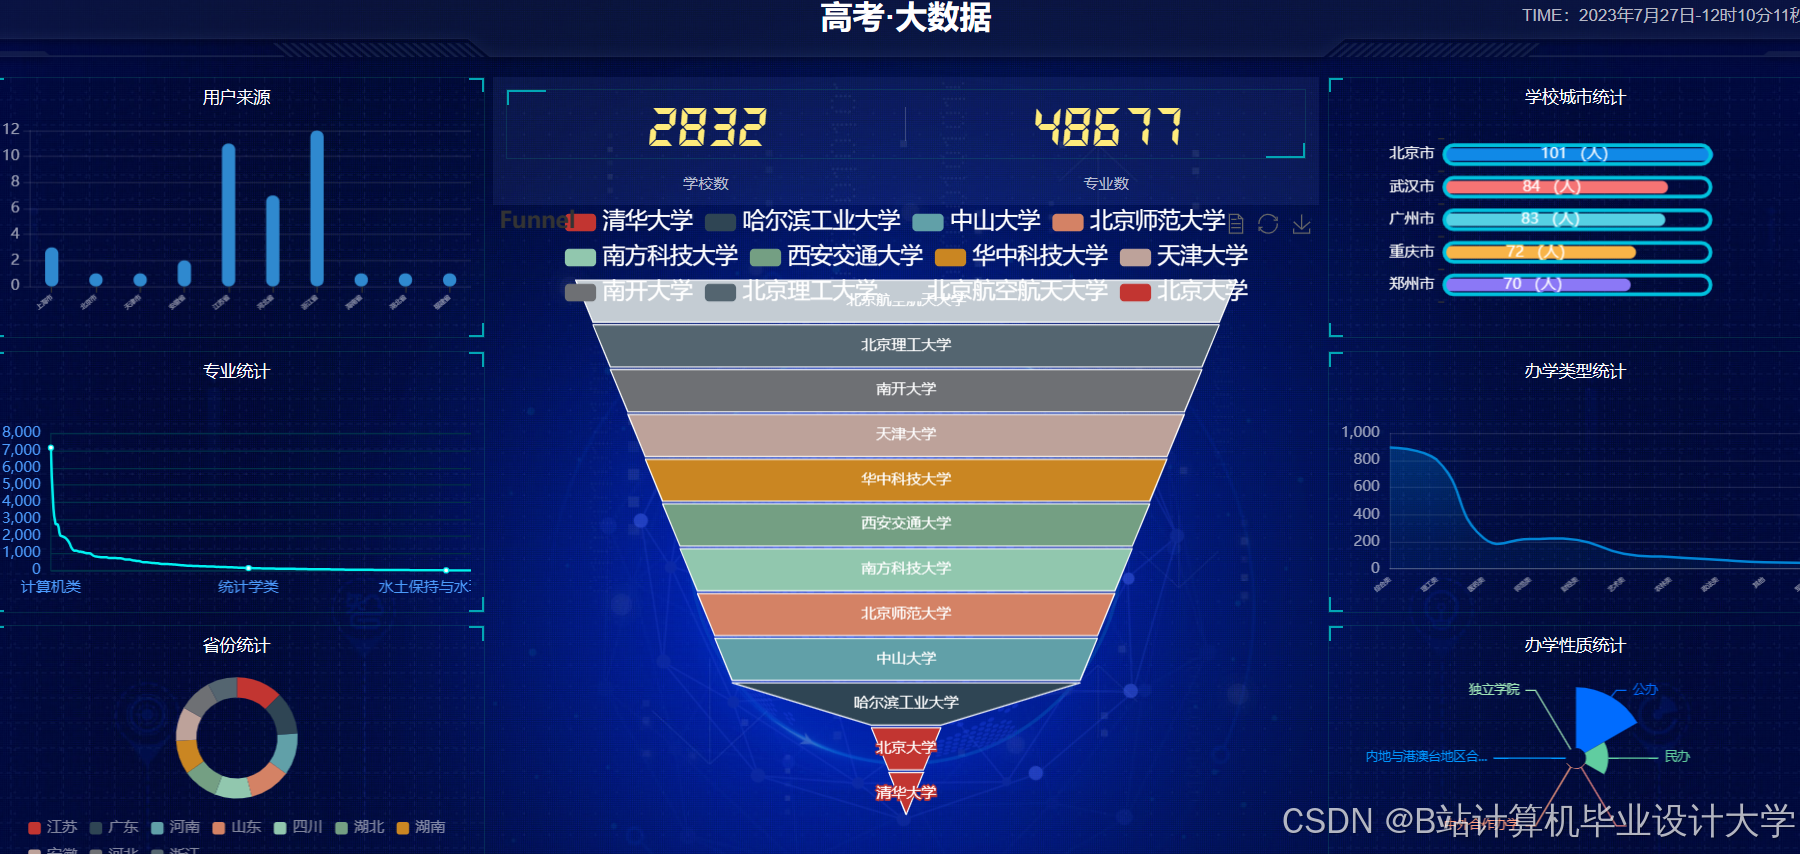
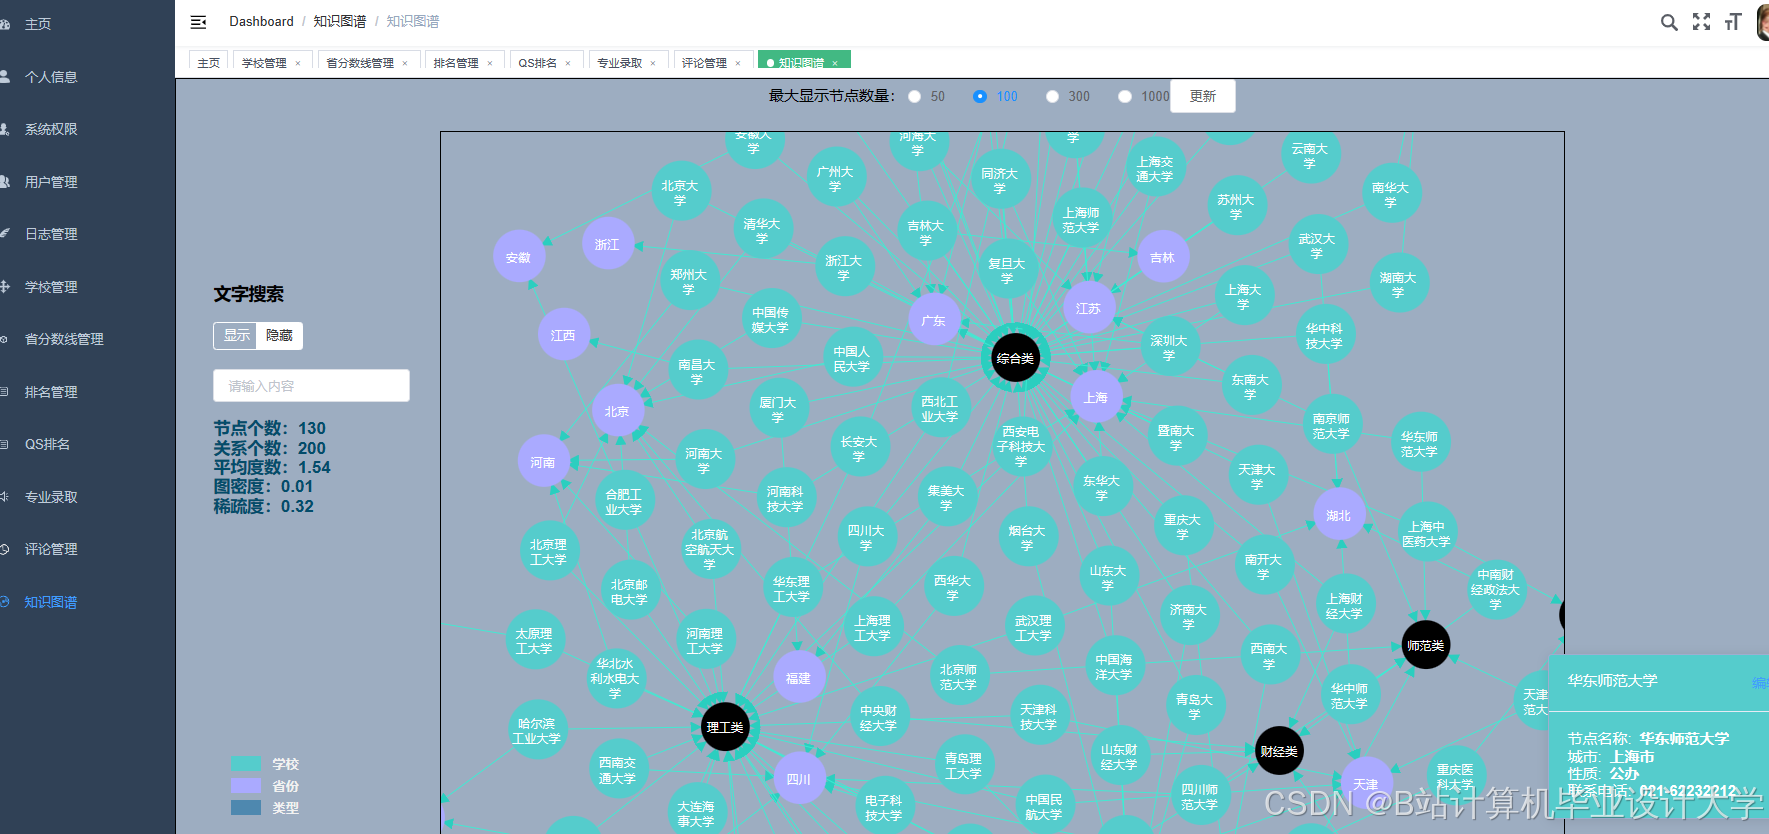


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!

为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓