Python 接口自动化测试框架搭建:告别一堆 if,用工厂模式做到"填 Excel 就能跑
一套基于 pytest 的 Python 接口自动化测试框架,让测试同学只填表格、不写代码就能跑,先带你看清它的整体设计,实现细节后续专题细讲。
前言
做接口测试,最开始大家都是一条一条写 requests.post(…),接口一多就成了"面条代码":改一个域名要动几十个文件,加一条用例要复制粘贴一大段,新来的同事看半天不敢动。
你有没有过这些崩溃瞬间?
- 接口一多,脚本堆成山,改一处牵一身;
- 用例逻辑里塞满 if type == "xxx",越写越长、越改越怕;
- 想让不写代码的同事也能加用例,根本无从下手。
后来我基于 Python + pytest + requests + Allure 折腾了一个框架,已经在项目里实际使用。核心思路就一句话:让写用例的人只填 Excel,不写代码。测试同学在表格里配好"请求什么、断言什么、存什么变量",框架自动跑完、出报告;想加一种新用例类型,只加代码不改老逻辑。
这篇文章就带你认识我搭的这套 Python 接口自动化测试框架:不堆代码,先讲清楚它整体怎么分层、几个核心机制分别解决了什么痛点、大概怎么跑起来。看完你会对"一个 Python 接口自动化测试框架该长什么样"有个清晰的整体印象;至于每个机制具体怎么落地,我会在后面的专题里一篇篇拆开细讲。代码功底一般,欢迎大佬指点。
一、技术选型:为什么是这几样
| pytest | 测试执行引擎 | 用例发现、参数化、钩子函数都很成熟,插件生态强 |
| requests | 发 HTTP 请求 | API 简洁,二次封装方便 |
| openpyxl | 读 Excel 用例 | 让非技术同学也能用表格维护用例 |
| Allure | 生成测试报告 | 报告好看、有步骤、有附件,领导爱看 |
| loguru | 日志 | 一行 from loguru import logger 就能用,配置简单 |
| jsonpath | 断言取值 | 从复杂 JSON 响应里精准取字段 |
| PyMySQL / psycopg2 | 数据库断言 | 支持"调完接口,去数据库查一下真的写进去没" |
一句话概括:pytest 负责跑,Excel 负责存用例,requests 负责发请求,Allure 负责出报告。
二、目录结构:先看清楚各司其职
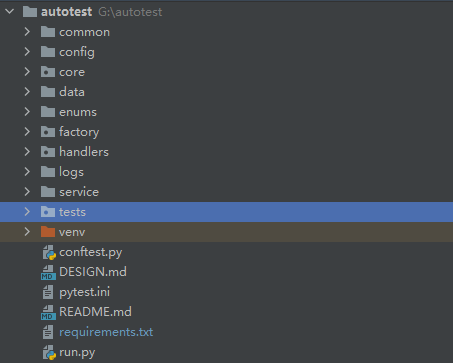
autotest/
├── common/ # 通用工具:HTTP客户端、Excel读取、断言、配置、数据处理
├── config/ # 配置文件:区分 test / prod 等环境
├── core/ # 核心组件:初始化、日志、执行观察、步骤记录
├── data/ # 测试数据:test_cases.xlsx(用例就写在这里)
├── enums/ # 枚举:用例类型、数据源类型等
├── factory/ # 工厂类:根据用例类型创建对应处理器
├── handlers/ # 处理器:每种用例类型一个处理器(核心扩展点)
├── service/ # 服务层:串起"读用例→分发→执行"的主流程
├── tests/ # 测试用例入口:pytest 从这里发现用例
├── logs/ # 日志输出目录
├── conftest.py # pytest 钩子:初始化环境、注入 http_client
├── pytest.ini # pytest 配置:命名规则、运行参数
├── requirements.txt # 依赖清单
└── run.py # 一键运行入口
和很多网上的框架不同,这个框架多了 factory/ 和 handlers/ 两层,正是它"好扩展"的关键,下面重点讲。
三、整体架构:分层设计
框架从上到下分成 5 层,数据一层层往下传:
┌─────────────────────────────────────────────┐
│ 测试执行引擎 pytest + conftest.py │ ← 发现用例、注入依赖、跑钩子
├─────────────────────────────────────────────┤
│ 核心组件层 RunnerHelper / RunObserver │ ← 初始化环境、记录执行过程
│ StepLogger / InitializeManager │
├─────────────────────────────────────────────┤
│ 服务层 BaseService │ ← 读用例、过滤、分发
├─────────────────────────────────────────────┤
│ 处理器层 HandlerFactory + 各 Handler │ ← 每种用例类型各干各的活
├─────────────────────────────────────────────┤
│ 工具层 HttpClient / ExcelReader … │ ← 发请求、读表格、连数据库
└─────────────────────────────────────────────┘
它遵循两个最重要的设计原则:
- 单一职责:读 Excel 的只管读,发请求的只管发,断言的只管断言。
- 开闭原则:想加一种新用例类型(比如"发消息"),只要新写一个 Handler、在工厂里登记一下,完全不用改老代码。
四、核心机制一:数据驱动,用例写在 Excel 里
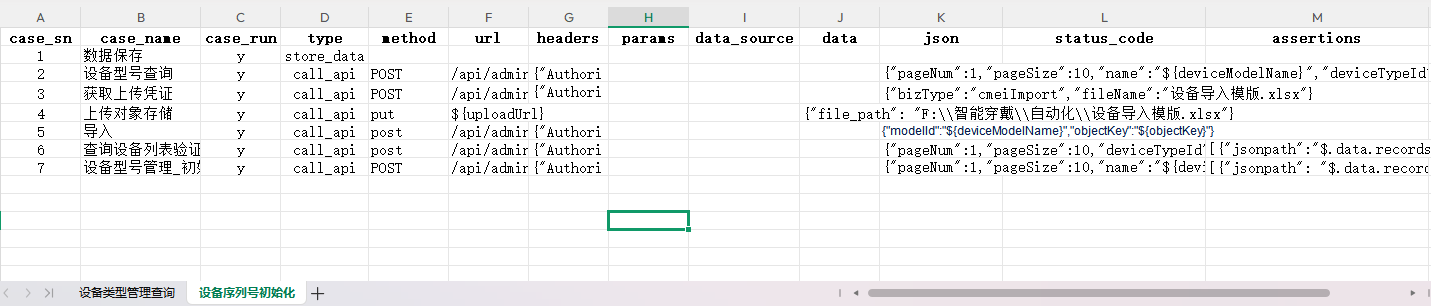
测试用例统一放在 data/test_cases.xlsx,一行就是一条用例。常用列如下:
| case_sn | 用例编号 | TC001 |
| case_name | 用例名称 | 登录测试 |
| case_run | 是否执行(Y/N) | Y |
| type | 用例类型 | call_api / assertion |
| method | 请求方法 | GET / POST |
| url | 请求路径 | /api/login |
| params / json / headers | 请求参数、请求体、请求头 | {"username":"admin"} |
| status_code | 期望状态码 | 200 |
| assertions | 断言规则(JSON) | [{"jsonpath":"$.code","expected":"0","type":"equal"}] |
框架读表时做了两件关键的事:一是自动过滤 case_run != Y 的行,只跑你勾选的用例;二是把每一行"喂"给 pytest 参数化,Excel 里有几行有效用例,就自动跑几条。
对写用例的人来说,加一条用例 = 往表格里加一行,不碰任何代码。测试同学、甚至产品都能维护用例。
看下真实效果——用例长这样,一行一条,填好就能跑
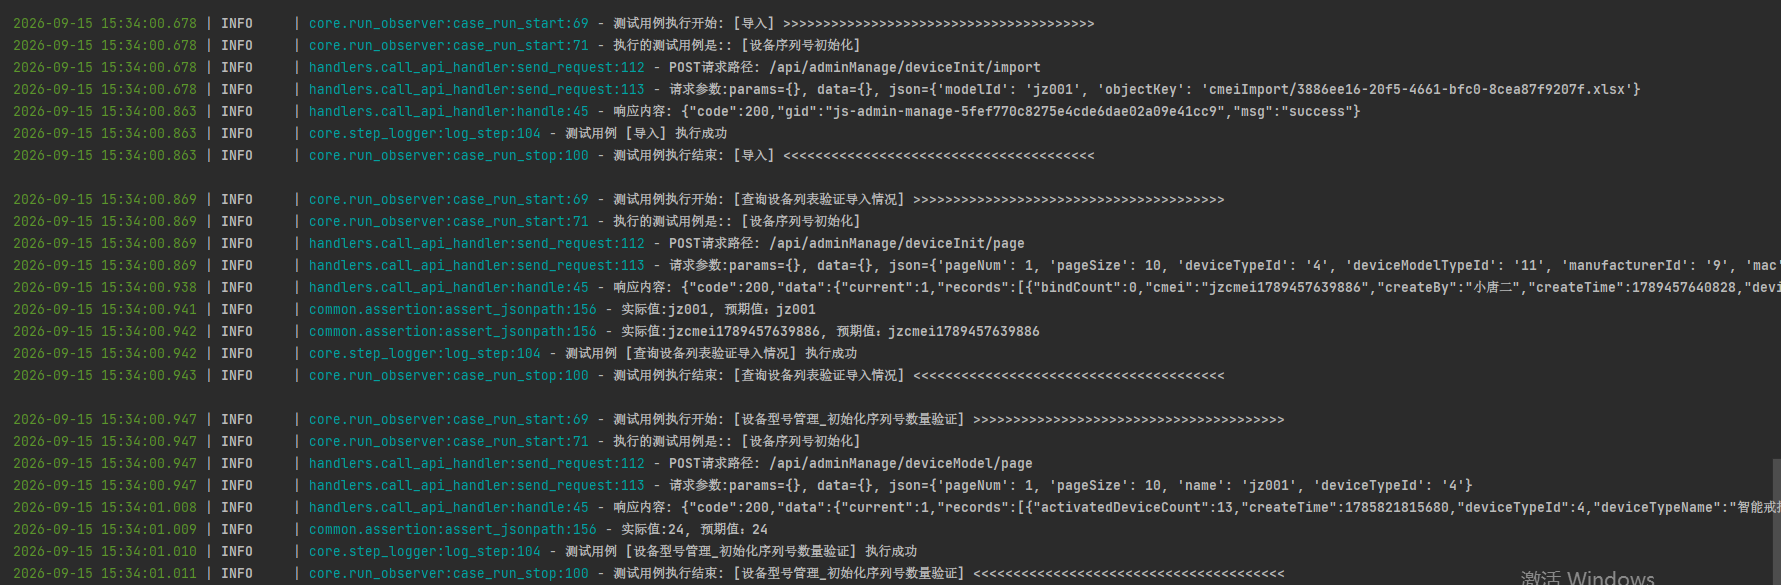
用例本地执行日志:每一条用例的执行时间、请求路径、请求参数、响应数据、断言都清楚记录
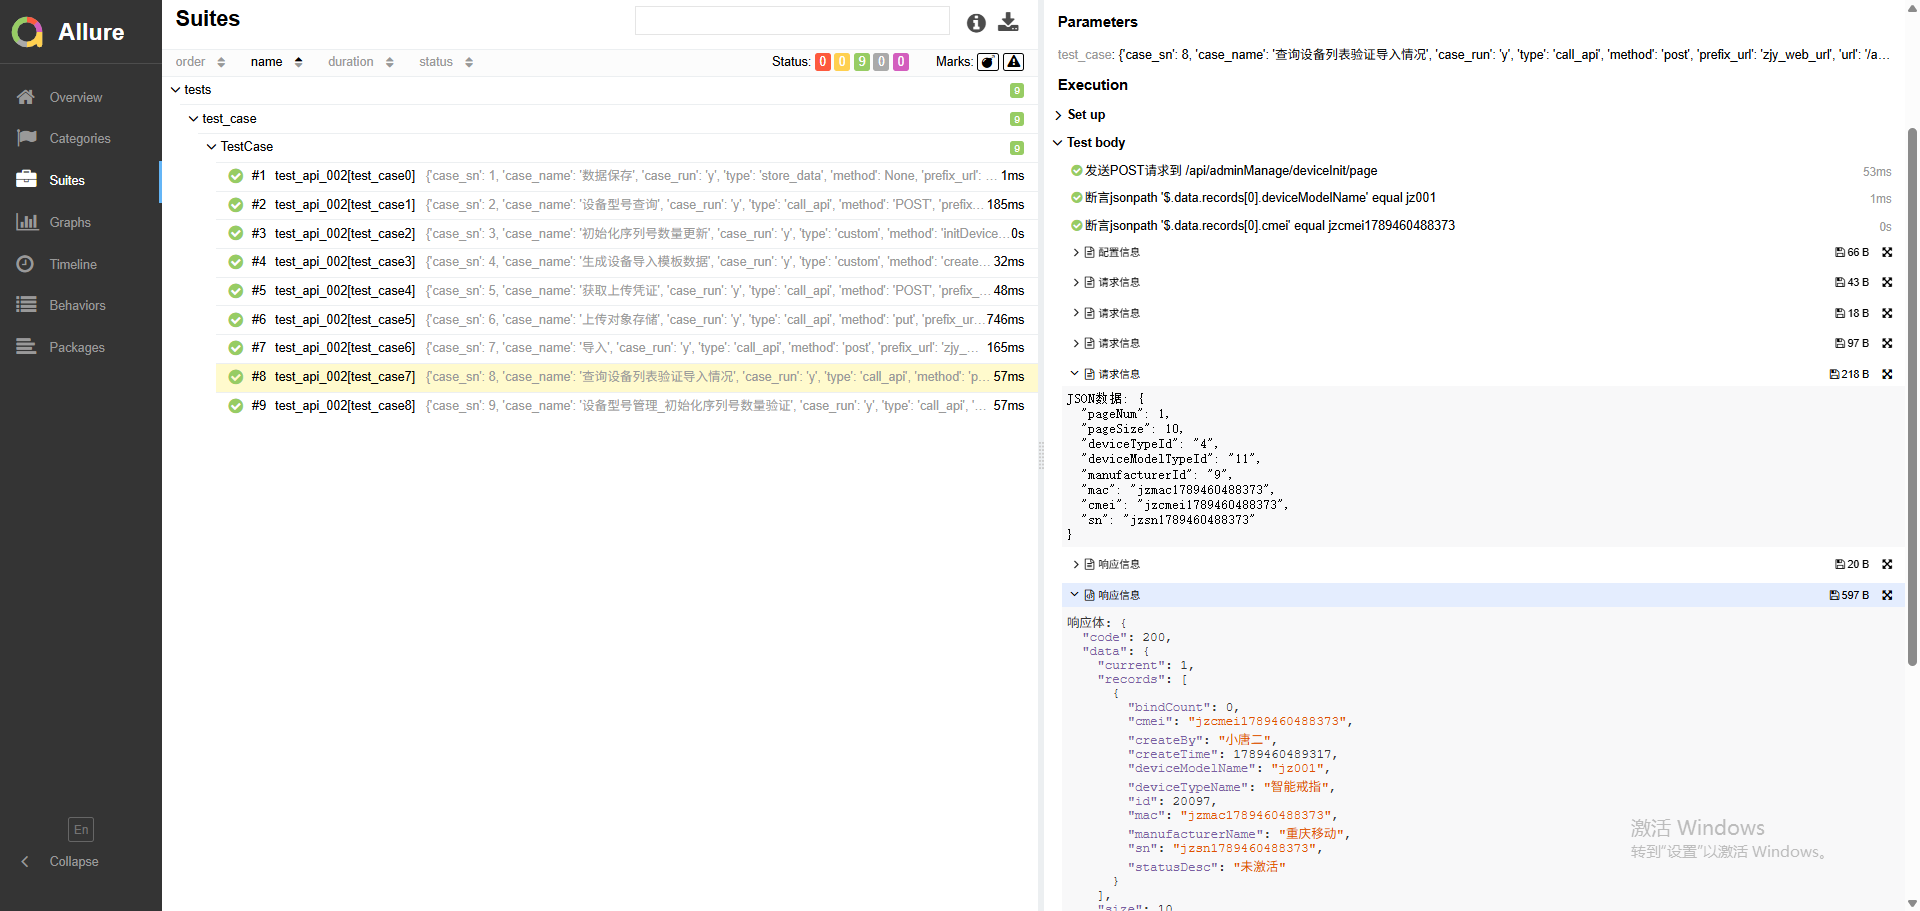
跑完自动生成 Allure 报告
"读表 → 过滤 → 参数化"这套数据驱动的具体实现,我会在后面的《数据驱动专题》里单独拆开讲,这里先感受它的效果就好。
五、核心机制二:工厂模式 + 处理器,扩展不改老代码
不同类型的用例干的事完全不一样:call_api 发请求、assertion 连库查、delayed 等待……传统写法就是一大坨 if type == "xxx",越堆越长,改一处怕碰坏另一处。
这个框架的做法是每种用例类型配一个"处理器",由工厂按用例的 type 自动派对应处理器去干活。加新类型时,只写一个新处理器、登记一下就行,老代码一个字不动——这就是"对扩展开放、对修改关闭"。用例类型越多,这套结构越省心。
工厂怎么实现、处理器怎么写,我会在后面的《工厂模式专题》里带完整代码拆开讲。这里先记住它解决的痛点:加类型不改老代码。
六、核心机制三:接口关联(场景测试)
真实业务很少是单个接口,更多是"先登录拿 token,再拿 token 去查数据、改数据"。这种接口依赖处理不好,用例之间就会互相耦合、没法复用。
这个框架的做法是:前一个接口把响应里的值(比如 token)存进一个全局变量仓库,后续用例用 ${token} 引用,框架发请求前自动替换成真实值。于是多条接口就串成一个完整业务场景,用例之间只靠变量名对接,谁也不用改谁。
变量怎么存取、跨用例怎么共享,我会在《场景测试专题》里带完整实现细讲。这里先记住它解决的痛点:多接口依赖,不用手动传参。
七、工具层几个封装亮点
1)HttpClient——连接复用 + 环境自适应
底层按线程复用 requests.Session(连接池,减少握手开销),并从环境配置里读 base_url、timeout、默认 headers。好处是用例里只写相对路径(/api/login),完整 URL 由客户端自动拼,换环境不用改用例。
2)AssertionHandler——不止断响应,还能断数据库
这是它和很多开源框架拉开差距的地方:断言不只看接口返回,还能直连数据库执行 SQL 去查,再和期望值逐条比对(支持 equal / not_equal / greater / less / contains 等操作符)。它解决的是一个很实际的问题——“接口返回成功,但数据到底写没写进库?” 这一点我会在《数据库断言专题》里专门展开。
3)多环境切换
config/ 下放了 test.properties、prod.properties,一个配置项一键切换,也支持命令行覆盖,避免把测试地址、数据库连接写死在代码里。
八、从零把它跑起来
1)准备环境(Python 3.9+)
cd autotest
python -m venv venv
venv\\Scripts\\activate # Windows
# source venv/bin/activate # Linux / macOS
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
2)配好环境和用例
- 在 config/test.properties 里填好 base_url、超时、(可选)数据库连接;
- 打开 data/test_cases.xlsx,按列填好用例,把要跑的行 case_run 设为 Y。
3)运行
python run.py
# 或者只跑某个文件
pytest tests/test_case.py -v
4)出 Allure 报告(需先装 Allure 命令行工具)
allure generate report/allure-results -o report/allure-report –clean
allure open report/allure-report
九、执行流程串一遍
把上面的东西连起来,一次完整执行是这样的:
十、总结
这个框架的价值不在于代码多复杂,而在于三个设计:
- 数据驱动:用例进 Excel,写用例不用写代码,非技术同学也能维护;
- 工厂 + 处理器:加新用例类型只加不改,扩展性好;
- 分层解耦:读数据、发请求、断言、报告各管一段,哪块想换就换哪块。
如果你也在项目里被"面条式接口脚本"折磨,不妨照着这个思路搭一套。后续可以继续扩展 UI 测试、性能测试,或者接入 Jenkins / GitLab CI 做持续集成。
📦 完整源码 + 文档打包好了
文章里的代码都是节选,怕你照着搭踩坑,我把整套东西整理好了:
- ✅ 完整可运行框架源码(factory / handlers / core 全实现)
- ✅ Excel 用例模板(各类型填写示例,拿来就改)
- ✅ 环境搭建 + 踩坑清单(编码、Allure、数据库断言我踩过的坑)
两种方式,按需自取:
- 🆓 免费:Excel 用例模板 + 精简 demo —— 关注后私信回复「模板」直接拿
- 💎 完整版:可跑框架全源码 + 文档 + 踩坑清单 —— 私信回复「框架」看获取方式
有问题也欢迎评论区或私信交流,看到都会回。
代码水平有限,欢迎大佬指正。觉得有用的话,点赞 + 收藏 + 关注走一波,方便你之后回来翻,也是对我持续更新最大的支持~