Spark 任务调优手记:从 Stage 倾斜到 AQE 自适应执行深度排障
在千万级乃至数十亿级海量数据离线数仓 ETL 批处理中,Apache Spark 依然是不可撼动的主力计算引擎。
然而,几乎每个负责夜间数仓调度的工程师都经历过这样的绝望时刻:
- 整个 Spark 任务包含 50 个 Task,前 49 个 Task 在 1 分钟内全部光速跑完(进度条显示 99%);
- 唯独最后一个 Task(Task 49)卡在 ShuffleMapStage 苦苦挣扎了 2 个小时,最终抛出经典的 FetchFailedException: Connection reset by peer 或 java.lang.OutOfMemoryError: Java heap space 导致全盘任务失败;
- 第二天早晨 8 点,管理层所有核心大屏因为底层数仓任务阻塞全部延期产出。
这就是典型的大数据“头号公敌”——数据倾斜(Data Skew)。
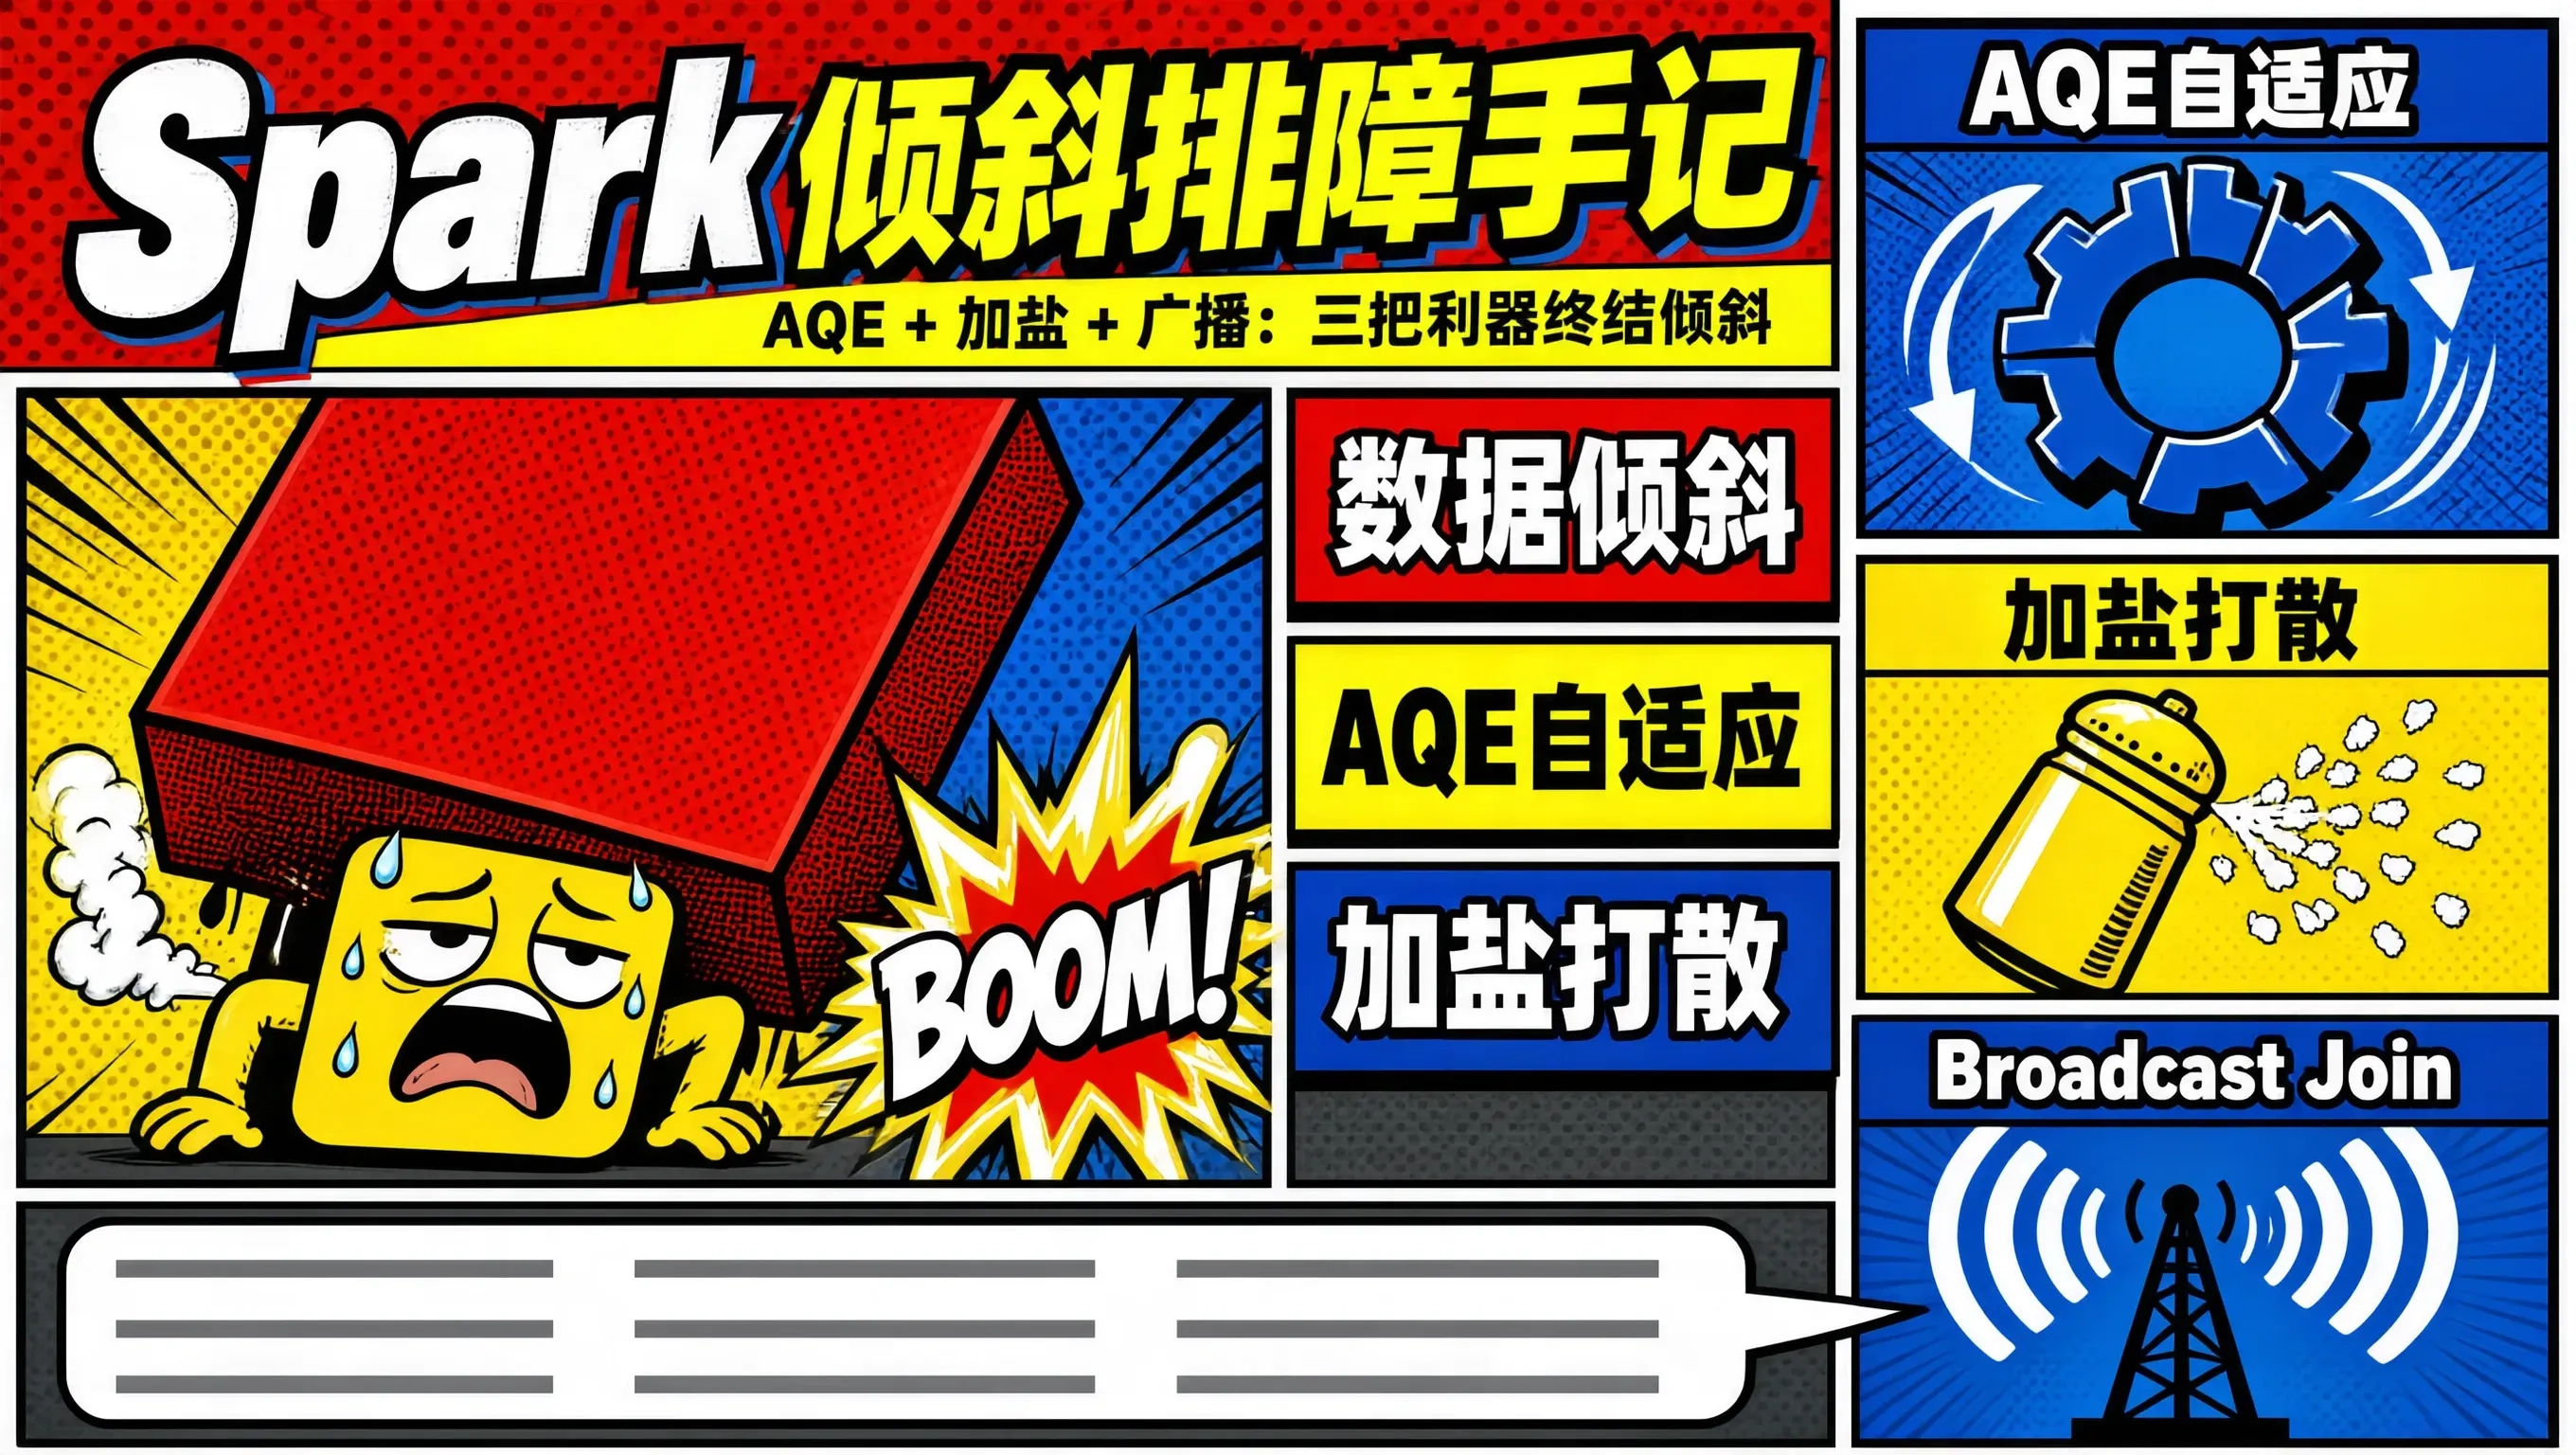
今天我们系统拆解 Spark 在发生数据倾斜时的底层物理根因,并奉上从 AQE(自适应查询执行) 到 加盐打散(Salting) 与 Broadcast Join 的完整调优实战手记。
数据倾斜的物理本质:Hash 分区的单点过载
理解数据倾斜的关键,是认清 Spark 在 Shuffle 阶段的重分区机制:
[ 上游 4 个分区数据 (包含 1000 万行记录) ]
│
▼ (执行 JOIN 或 GROUP BY key,Spark 按 Hash(key) % numPartitions 路由)
┌─────────────────────────────────────────────────────────────┐
│ 正常 Key (均匀分布) ────────► 分流到 Task 0, Task 1, Task 2 │ (每个 Task 处理 10 万行,耗时 5 秒)
│ 倾斜 Key (如空值 NULL/冷门大类) ──► 全量涌入 Task 3 ! │ (单 Task 被迫承载 970 万行!内存爆满!)
└─────────────────────────────────────────────────────────────┘
单点 Task 处理的数据量比其他 Task 多数百倍,计算节点 CPU 和内存被单点打满,引发严重的 GC 停顿(GC Pause)和磁盘溢出(Spill to Disk)。
调优利器一:开启 Spark 3.x AQE(自适应查询执行)
在 Spark 3.0+ 中,最强大、最应该默认开启的黑科技是 AQE(Adaptive Query Execution)。它允许 Spark 在运行期间根据刚刚结束的 Shuffle Stage 实际统计元数据,动态重写后续的物理执行计划:
— 生产级 Spark 3.x AQE 核心防倾斜配置
SET spark.sql.adaptive.enabled = true; — 开启自适应查询执行
SET spark.sql.adaptive.skewJoin.enabled = true; — 开启自适应倾斜 Join 优化!
SET spark.sql.adaptive.skewJoin.skewedPartitionFactor = 5; — 当某分区大小超过中位数 5 倍时判定为倾斜
SET spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes = 268435456; — 且分区大于 256MB 时触发自动切分
SET spark.sql.adaptive.coalescePartitions.enabled = true; — 自动合并过小 Shuffle 分区
AQE 倾斜 Join 的底层动作:
当 AQE 检测到某个 Task 分区过大时,它会自动将该倾斜的大分区在运行时动态切分成 5 个微型子分区,并将被 Join 的小表对应数据广播复制 5 份,由 5 个 Task 并行计算,无需人工修改一行 SQL 代码!
调优利器二:业务层加盐打散两阶段聚合(Salting)
如果使用的是 Spark 2.x 或者倾斜发生在 GROUP BY 聚合阶段(AQE 仅针对 Join 倾斜),必须使用经典的**“加盐(Salt)打散”两阶段聚合**:
— 场景:某热门商家 merchant_id = 8848 拥有数千万流水,直接 GROUP BY 发生严重倾斜
— 步骤一:第一阶段局部加盐聚合 (在 Key 后面随机拼接 0~9 的数字,把单点打散为 10 个独立节点)
WITH salted_step1 AS (
SELECT
merchant_id,
CONCAT(merchant_id, '_', CAST(FLOOR(RAND() * 10) AS STRING)) AS salted_key,
pay_amount
FROM dwd_orders
),
local_agg AS (
SELECT
salted_key,
merchant_id,
SUM(pay_amount) AS partial_amount,
COUNT(*) AS partial_count
FROM salted_step1
GROUP BY salted_key, merchant_id — 此时 10 个 Task 并行处理,完全无倾斜!
)
— 步骤二:第二阶段全局去盐汇总 (此时数据量已被压缩了 99%,再次聚合毫无压力)
SELECT
merchant_id,
SUM(partial_amount) AS total_amount,
SUM(partial_count) AS total_count
FROM local_agg
GROUP BY merchant_id;
调优利器三:大表 Join 小表强制改走 Broadcast Join
如果参与 Join 的两张表中,有一张维表体积较小(< 100 MB):
— 强制使用 Broadcast Hash Join,彻底绕过 Shuffle 阶段!
SELECT /*+ BROADCAST(dim_store) */
o.order_id,
o.pay_amount,
s.store_name,
s.city_name
FROM dwd_orders_large o
LEFT JOIN dim_store_small s ON o.store_id = s.store_id;
由于维表被完整广播到了每个 Executor 的内存中,大表数据无需在网络间进行任何昂贵的 Shuffle 重分区,零数据倾斜风险,查询耗时直接从 10 分钟压缩至 30 秒!