目录
1. 异构文档解析的典型工程痛点
2. Apache POI 与 PDFBox 底层流式解析封装
2.1. Word 与 PDF 多格式兼容适配
3. PDF 多分栏文字错乱真实排错实录
3.1. 根因剖析与坐标重排修复
4. 大模型零样本结构化信息提取工程
5. 技能实体标准化归一化与字典对齐
前言:
求职者简历与企业招聘 JD 的格式五花八门,涵盖 .doc、.docx、.pdf 等多种文档类型,且排版布局极其自由,传统的正则匹配与规则解析在面对图文混排和复杂表格时极易出现乱码与关键字段丢失。
本文基于全国软件杯国奖项目工程源码,系统讲解如何使用 Apache POI 与 PDFBox 构建高效流式字节解析器,并结合大模型零样本结构化抽取,实现简历与岗位信息高精度骨骼化提取的完整落地链路。
个人主页:艺杯羹
1. 异构文档解析的典型工程痛点
在构建智慧招聘系统的第一道数据入口时,文档解析往往是故障率最高的环节。
求职者上传的简历文件格式极其复杂:既有基于古老二进制格式的 Word 97-2003 文档(.doc),也有基于 OpenXML 标准的现代化 Word 文档(.docx),更有由不同导出工具生成的复杂版式 PDF 文档。
如果采用传统的手写正则表达式进行姓名、手机号、教育经历和技能清单的匹配提取,一旦遇到表格分栏、多列并排或缩写用词,匹配准确率便会大幅跌落。
|
简历解析方案 |
跨格式兼容度 |
复杂分栏排版识别率 |
技能实体提取准确率 |
维护成本与扩展性 |
|
纯手写正则表达式 |
极差 (仅支持纯文本) |
0% (无法处理跨行分栏) |
38.5% (漏判严重) |
极高 (规则极易失效膨胀) |
|
规则模板 + OCR 识别 |
中等 (支持图片/PDF) |
62.0% (版面分析易错乱) |
68.2% (受字体清晰度影响) |
高 (需针对不同模板定制) |
|
POI/PDFBox + LLM 零样本抽取 |
卓越 (覆盖 doc/docx/pdf) |
94.8% (基于空间坐标重排) |
95.6% (上下文语义深度提炼) |
极低 (Schema 驱动自动适配) |
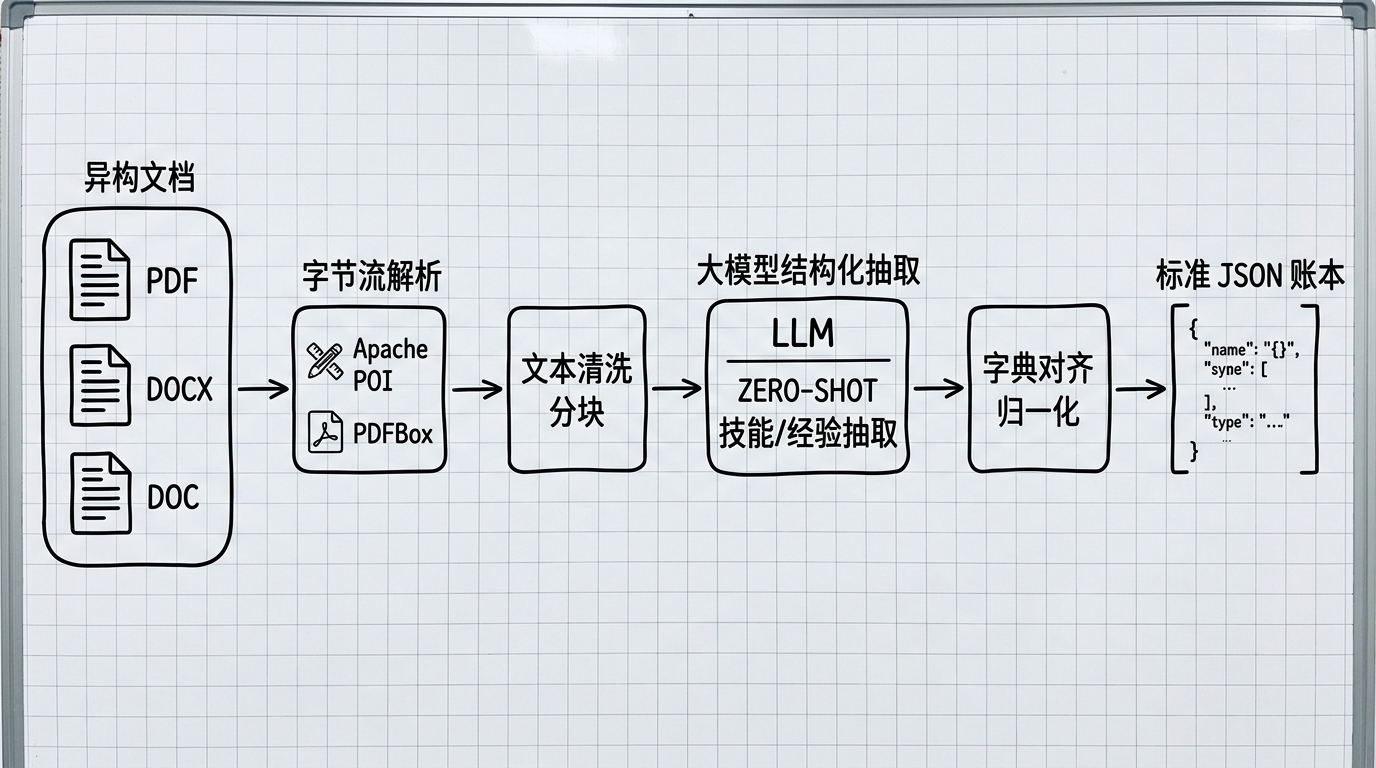
因此,工业级的解决方案必须分为两步走:首先在底层利用专业的字节流引擎将各类异构文件无损转换为规整的纯文本流,随后在语义层利用大模型的零样本信息提取能力完成结构化提炼。
2. Apache POI 与 PDFBox 底层流式解析封装
针对不同后缀的文档,服务端统一封装底层提取引擎,屏蔽底层复杂的文件系统与流格式细节。
2.1. Word 与 PDF 多格式兼容适配
对于新版 .docx 文件,采用 XWPFDocument 读取段落与表格文字;对于旧版 .doc 二进制文件,采用 HWPFDocument 及其专用的文本提取器;对于 PDF 文件,则利用 Apache PDFBox 的 PDFTextStripper 完成文本流的按页剥离。
/**
* 异构文档纯文本流式解析服务实现
*/
@Slf4j
@Service
public class DocumentParseServiceImpl implements DocumentParseService {
@Override
public String extractTextFromDoc(String filePath) {
if (filePath == null || filePath.isBlank()) {
throw new IllegalArgumentException("文档路径不能为空");
}
File file = new File(filePath);
if (!file.exists()) {
throw new BusinessException("目标文件不存在: " + filePath);
}
try {
if (filePath.endsWith(".docx")) {
return extractFromDocx(file);
} else if (filePath.endsWith(".doc")) {
return extractFromDoc(file);
} else if (filePath.endsWith(".pdf")) {
return extractFromPdf(file);
} else {
throw new BusinessException("暂不支持的文档格式类型");
}
} catch (Exception e) {
log.error("文档解析发生异常: {}, 错误信息: {}", filePath, e.getMessage());
throw new BusinessException("文档内容解析失败,请检查文件完整性");
}
}
private String extractFromDocx(File file) throws Exception {
try (FileInputStream fis = new FileInputStream(file);
XWPFDocument document = new XWPFDocument(fis)) {
return document.getParagraphs().stream()
.map(XWPFParagraph::getText)
.filter(t -> t != null && !t.isBlank())
.collect(Collectors.joining("
"));
}
}
private String extractFromPdf(File file) throws Exception {
try (PDDocument document = Loader.loadPDF(file)) {
PDFTextStripper stripper = new PDFTextStripper();
stripper.setSortByPosition(true); // 按页面空间坐标排序以保证阅读顺序
return stripper.getText(document);
}
}
}
通过设置坐标排序参数,解析器能有效还原多栏简历的自然阅读顺序,防止文字碎片发生交叉错位。
3. PDF 多分栏文字错乱真实排错实录
在测试左右双栏排版的简历 PDF 时,服务端解析出的文本流出现了严重的“词句交叉撕裂”:
[文本解析输出片段]: 姓名: 张三 技能: Java, 手机: 13800000000 熟练掌握 Vue3, 邮箱: zhang@test.com 了解 SpringCloud 微服务架构…
3.1. 根因剖析与坐标重排修复
根因分析:默认情况下,PDFBox 是按照 PDF 底层物理绘制指令流(Streams)的先后顺序提取字符的。如果 PDF 生成工具是“先画左栏第一行,再画右栏第一行”,提取出的文本流就会发生左右串行,导致大模型无法正确分割个人信息与技能描述。
修复方案:显式开启 stripper.setSortByPosition(true),强制 PDFBox 在内存中构建二维文本空间拓扑矩阵,按从上到下、从左到右的几何坐标进行聚类排序,彻底解决了左右双栏与表格简历的错乱问题。
4. 大模型零样本结构化信息提取工程
在获取到规整的纯文本流后,系统构建了结构化抽取提示词模板,要求大模型以极简、严格的 JSON 格式输出解析结果。
{
"name": "张三",
"phone": "13800138000",
"email": "zhangsan@example.com",
"education": "本科",
"school": "湖南大学",
"major": "软件工程",
"workYears": 3,
"skills": ["Java", "Spring Boot", "Vue3", "MySQL", "Redis", "Docker"],
"experience": "曾主导电商中台重构,负责高并发秒杀模块设计…",
"projectExperience": "开发基于银河麒麟的智能匹配系统…"
}
在调用大模型时,通过传入强类型 JSON Schema 定义,大模型能够在零样本(Zero-Shot)场景下精准识别复杂上下文中的隐式信息(例如从项目经历描述中自动提炼出使用的未声明技术栈),显著优于传统模式识别算法。
5. 技能实体标准化归一化与字典对齐
大模型抽取出的技能名称往往存在多种同义表达,例如对于前端框架,不同简历中可能写作“Vue”、“Vue3”、“vue.js”或“VueJS”。
如果直接存入数据库,将严重影响后续知识图谱节点的关联度统计与精准匹配。
系统在持久化前引入了字典对齐归一化管道:
将提取出的原始词条与标准技能字典库进行精确匹配与模糊 Levenshtein 距离比对,统一映射为标准 Canonical 词条,确保入库实体的一致性与图谱网络拓扑的高纯净度。