阿里 open-code-review (AI代码审查工具)实战:安装、四层规则链、自定义规则格式与实测避坑
结论先放这儿,方便你判断要不要往下看:
阿里把内部用了两年的 AI 代码审查助手开源了,命令行叫 ocr,npm install 两个包、12 秒装完。它跟"把 diff 丢给大模型"最大的区别是——选文件、分组、匹配规则、控 Token、定位行号全是确定性代码,模型只负责读代码和判断问题。
这篇是完整的落地记录:怎么装、怎么配、四层规则链怎么验证、自定义规则文件的确切格式(官方文档没写,我试出来的)、以及我踩的两个坑。所有命令和输出都是本机真实跑出来的。
环境:Windows / Node v22.22.2 / Git 2.55.0(它要求 Git >= 2.41)/ open-code-review v1.12.9
一、安装与验证
npm install -g @alibaba-group/open-code-review
装完的反馈:
added 2 packages in 12s
只有两个包:主包 + 平台二进制包(Windows 是 ocr-win32-x64)。它把 Go 编译好的二进制直接打进 npm 包,就是为了绕开"装完再下 GitHub Release"那一步——官方提交记录里明说国内网络下那步极慢。
验证:
$ ocr version
open-code-review v1.12.9 (bccbc15f) windows/amd64
built at: 2026-09-22T11:06:41Z
二、核心命令速查
| ocr review | 审查工作区改动(暂存 + 未暂存 + 未跟踪) |
| ocr review –from main –to feature | 审查分支区间(按 merge-base 计算) |
| ocr review –commit abc123 | 审查单个提交 |
| ocr review –preview | 只走筛选、不调模型,不需要 Key |
| ocr scan | 全文件扫描,不需要 diff |
| ocr scan –path src/ | 扫描指定目录 |
| ocr rules check <文件> | 查看某文件命中的规则及其来源 |
| ocr config provider / ocr config model | 交互式配置模型 |
| ocr llm providers | 列出内置 Provider |
| ocr llm test | 测试端点连通性 |
| ocr session list | 列出历史审查会话 |
| ocr session export -o x.html | 导出为单文件 HTML 报告 |
| ocr viewer | 启动本地 Web UI(默认 5483 端口) |
–preview 这个参数建议先记住:不配模型也能跑,用来确认"它到底会审哪些文件"。
三、实测:文件筛选怎么工作
我造了一个仓库,6 个文件改动,其中 2 个真该审、4 个是噪音:
$ ocr review –preview
Preview: 6 file(s) changed | +31 -2
Will review (2):
[M] src/main/java/com/example/demo/UserService.java +12 -0
[M] web/render.js +6 -1
Excluded from review (4):
[M] README.md (unsupported_ext)
[B] assets/logo.png (binary)
[M] generated/Api.pb.go (default_path)
[M] package-lock.json (default_path)
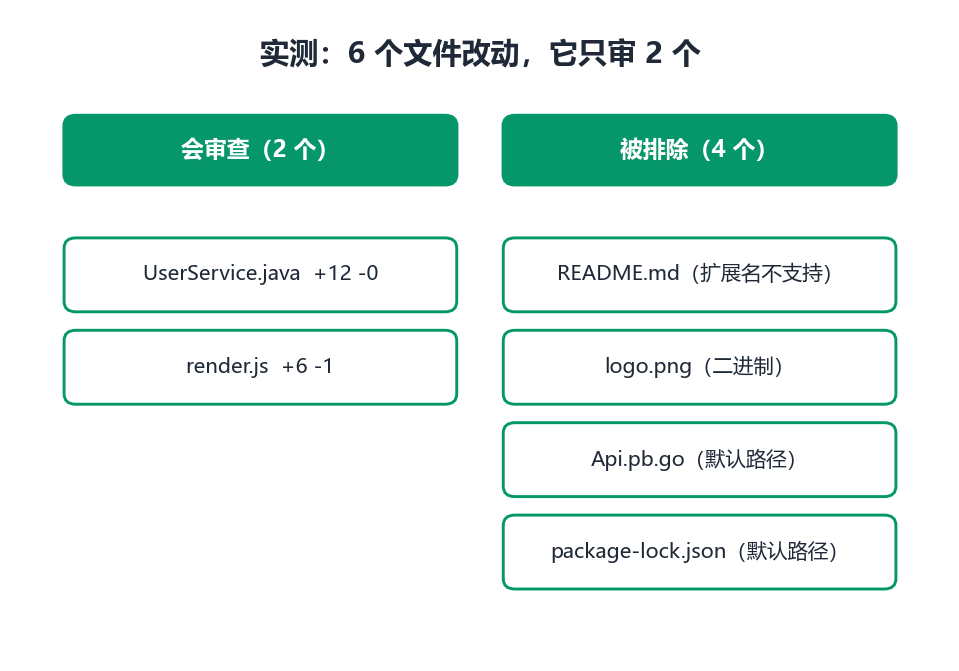
关键是括号里那四类原因:扩展名不支持、二进制、命中默认排除路径、用户自定义排除(user_exclude)。它不笼统说"跳过",而是给出理由——这是确定性筛选和模型拍脑袋的分界线。
全仓扫描是同一套逻辑:
$ ocr scan –preview
Preview: 8 file(s) changed | +107 -0
Will review (4):
[S] src/main/java/com/example/demo/Counter.java +18 -0
[S] src/main/java/com/example/demo/StringUtils.java +24 -0
[S] src/main/java/com/example/demo/UserService.java +49 -0
[S] web/render.js +16 -0
接 CI 用结构化输出:
ocr review –format json –audience agent –output result.json
{
"path": "README.md",
"status": "modified",
"insertions": 4,
"deletions": 0,
"will_review": false,
"exclude_reason": "unsupported_ext"
}
四、四层规则链怎么验证
规则不是写死在提示词里,是一条四层链,命中即停:
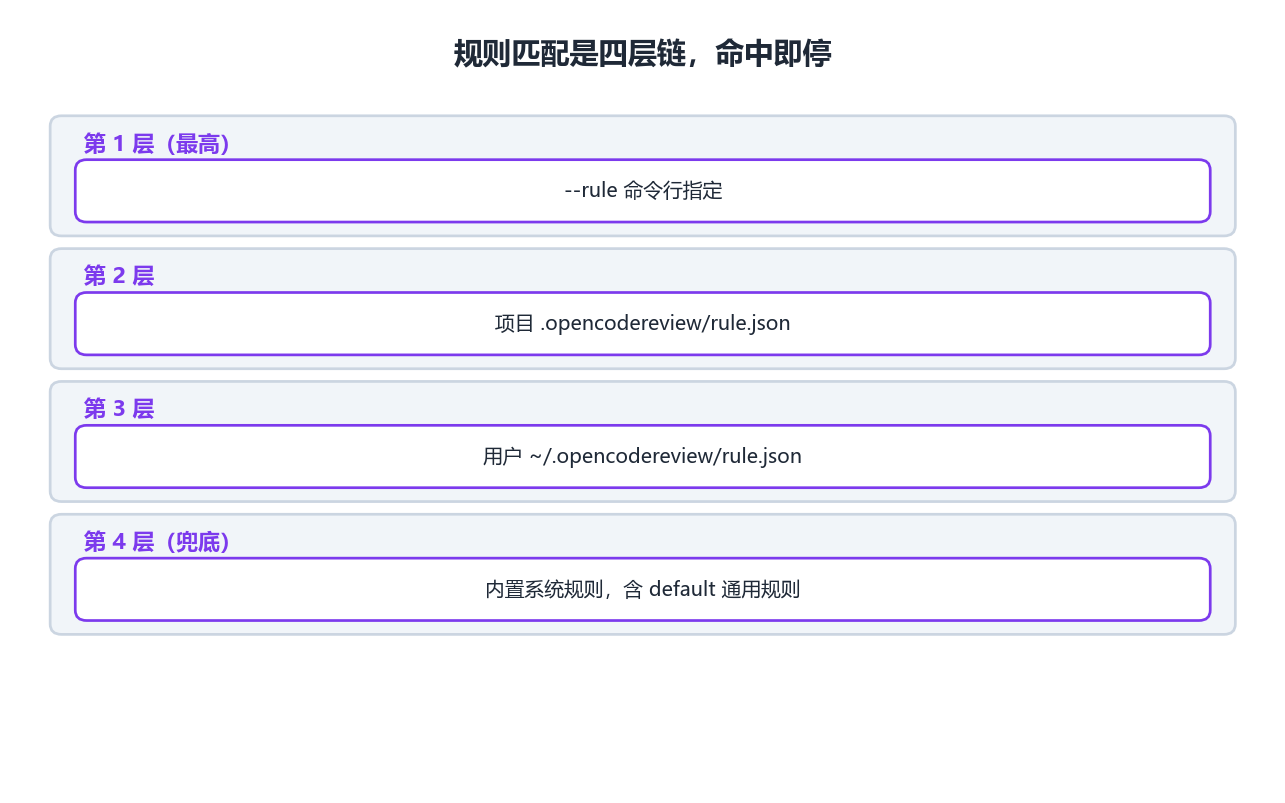
用 ocr rules check 逐层验证。
第 4 层,内置系统规则:
$ ocr rules check src/main/java/com/example/demo/UserService.java
File: src/main/java/com/example/demo/UserService.java
Source: System built-in
Pattern: **/*.java
内置的 Java 规则覆盖这几类:拼写错误、死代码、逻辑错误(含 NPE)、严重性能问题(循环内查库、N+1)、线程安全(竞态、非原子复合操作、不安全懒加载、并发写非线程安全集合)。
换成 JS 文件,模式变成 **/*.{ts,js,tsx,jsx,mjs,cjs}。换成它不认识的扩展名,落到 default 规则——只剩通用几条:逻辑正确性、边界条件、异常处理、并发安全、SQL 注入、XSS。不认识的文件不是不管,是用更保守的通用标准管。
第 2 层,项目级规则。这是第一个坑,见下节。
第 1 层,命令行指定:
$ ocr rules check –rule ./custom-rule.json src/main/java/com/example/demo/UserService.java
Source: Custom (–rule)
Pattern: **/*.java
五、避坑一:项目规则文件的确切格式
按最自然的写法建 .opencodereview/rule.json:
{
"rules": {
"**/*.java": "#### 团队规则\\n- 所有 SQL 必须使用 PreparedStatement"
}
}
报错:
Error: load rules: unmarshal project rule: json: cannot unmarshal object
into Go struct field ProjectRule.rules of type []rules.ProjectRuleEntry
rules 得是数组。但官方文档站只讲了 config.json(模型、Provider、超时),项目规则文件的结构一个字段都没提。
我用穷举试出了字段名:
for gk in pattern glob path match file files; do
for rk in rule content body text description prompt; do
printf '{"rules":[{"%s":"**/*.java","%s":"MARKER_XYZ"}]}' "$gk" "$rk" \\
> .opencodereview/rule.json
ocr rules check src/main/java/.../UserService.java | grep -q MARKER_XYZ \\
&& echo "HIT => $gk / $rk"
done
done
结果:HIT => path / rule。
正确格式:
{
"rules": [
{
"path": "**/*.java",
"rule": "#### 团队 Java 规则\\n- 禁止使用 String.format 处理用户输入\\n- 所有 SQL 必须使用 PreparedStatement"
}
],
"exclude": ["web/*"]
}
验证生效:
$ ocr rules check src/main/java/com/example/demo/UserService.java
Source: Project (.opencodereview/rule.json)
Pattern: **/*.java
exclude 吃 gitignore 风格模式。加了 web/* 之后,render.js 的排除原因变成 user_exclude——自定义排除是独立一类,跟内置规则不混。
六、避坑二:本地端点 URL 不要带 /v1
不配模型时的报错把配置途径列得很全:
Error: resolve LLM endpoint: no valid LLM endpoint configured; one of
OCR_LLM_URL/OCR_LLM_TOKEN/OCR_LLM_MODEL, ~/.opencodereview/config.json,
or ANTHROPIC_BASE_URL/ANTHROPIC_AUTH_TOKEN/ANTHROPIC_MODEL must be set
注意最后三个 ANTHROPIC_*——环境变量模式默认走 Anthropic 协议,请求打到 /v1/messages。
我一开始把 URL 写成 http://127.0.0.1:8899/v1,结果实际路径变成 /v1/v1/messages,多一层。端点 404,它拿不到工具调用就一轮轮重试,白跑 101 轮、烧掉 13 万 Token。
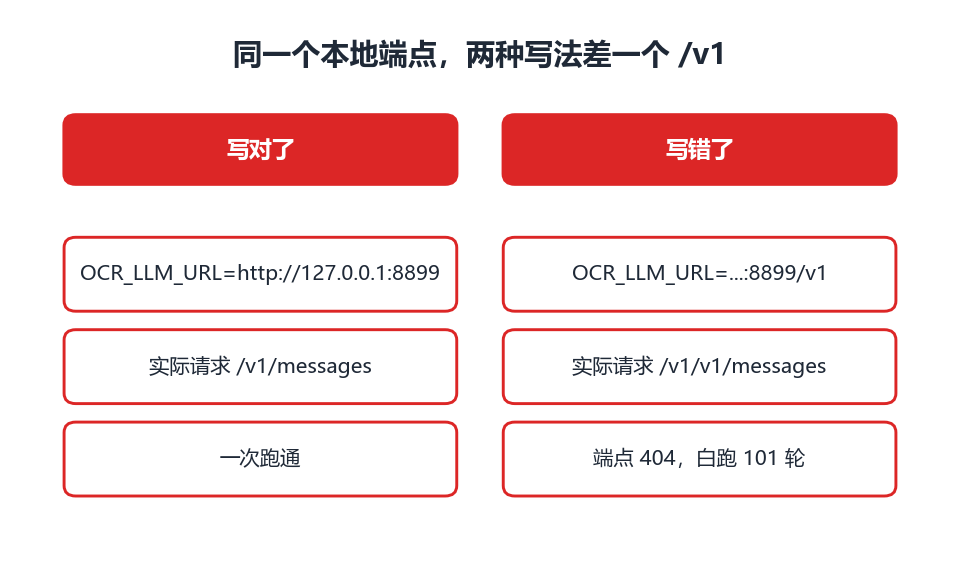
去掉 /v1 后正常,Token 从 13 万降到 1.1 万。
用环境变量配本地模型:
export OCR_LLM_URL=http://127.0.0.1:8899 # 注意:不带 /v1
export OCR_LLM_TOKEN=your-key
export OCR_LLM_MODEL=your-model
ocr llm test
用配置文件配(推荐,可持久化):
ocr config set provider ollama
ocr config set custom_providers.ollama.url http://127.0.0.1:11434/v1
ocr config set custom_providers.ollama.protocol openai
ocr config set custom_providers.ollama.model qwen3:32b
ocr config set custom_providers.ollama.api_key ollama
注意 custom_providers 这条路要显式指定 protocol,并且 URL 带 /v1——跟环境变量那条路的规则不一样,这点容易搞混。
内置 Provider 实测有 28 个:
$ ocr llm providers
NAME PROTOCOL BASE URL
anthropic anthropic https://api.anthropic.com
dashscope openai https://dashscope.aliyuncs.com/compatible-mode/v1
deepseek openai https://api.deepseek.com
kimi openai https://api.moonshot.cn/v1
z-ai openai https://open.bigmodel.cn/api/paas/v4
volcengine openai https://ark.cn-beijing.volces.com/api/v3
...
七、它到底给模型发了什么
用一个本地假端点(记录请求 + 返回合规响应)把原始请求截了下来。
工具只有 6 件:
tools: ['task_done', 'code_comment', 'code_search',
'file_read', 'file_read_diff', 'file_find']
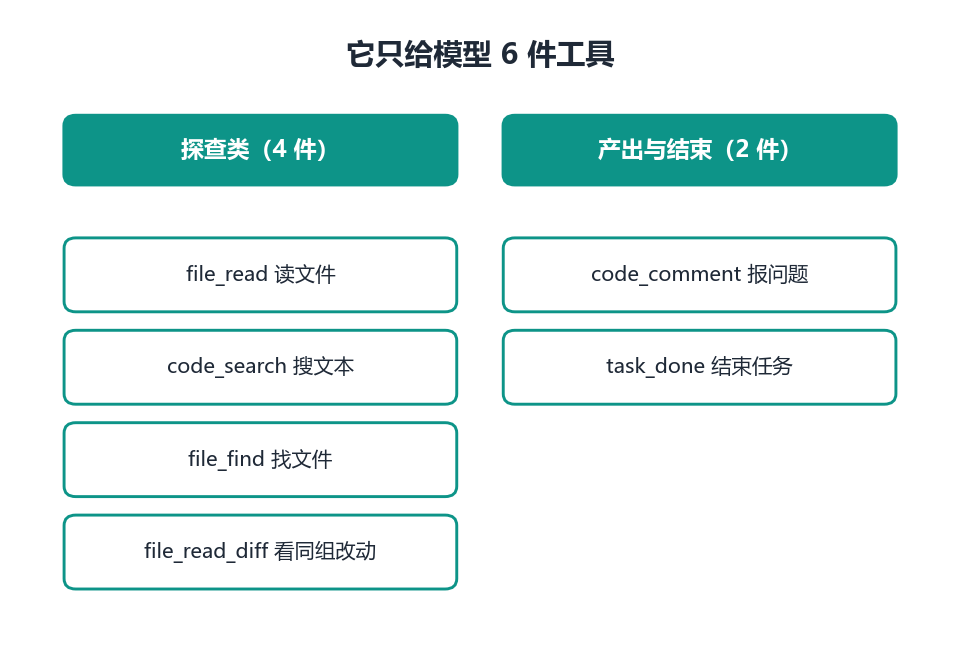
| file_read | 读文件,可指定起止行 | file_path(必填)、start_line、end_line |
| code_search | 搜文本/正则 | search_text(必填)、file_patterns、case_sensitive、use_perl_regexp |
| file_find | 按文件名找文件 | query_name(必填)、case_sensitive |
| file_read_diff | 看同组其他文件的 diff | path_array(必填) |
| code_comment | 报问题,自动定位行 | comments(必填) |
| task_done | 结束任务 | state(必填) |
全是只读加评论——没有 shell、没有写文件、没有联网。code_comment 是唯一产出内容的出口,位置由工具负责,不由模型自己写行号。
规则按路径挂载,这是首条用户消息里的原文:
<user_task>
### Review Checklist
<rules for=".opencodereview/rule.json">
Check JSON files for spelling errors in json-keys; ignore the content of json-values.
</rules>
<rules for="src/main/java/com/example/demo/UserService.java">
#### 团队 Java 规则
– 禁止使用 String.format 处理用户输入
– 所有 SQL 必须使用 PreparedStatement
</rules>
</user_task>
同一个请求里,不同文件挂不同规则——这就是四层链的落点。
八、跑完怎么查
$ ocr session list
SESSION ID MODE FILES COMMENTS STATUS
eb8ded5d-e82a-48e5-8c33-30bf7e1a2e81 workspace 2 (failed 2) 0 failed
$ ocr session export -o review.html
[ocr] Results written to review.html
导出的 HTML 157KB,样式脚本全内联,双击能开:
会话清单里还记了可复现性凭证:
"resolved_base": "4f27709ef55b31713e7368088bbaf410d532ecd7",
"source_artifact_sha256": "cda79ce7…",
"rule_config_sha256": "91d01a7b…",
"runtime_config_sha256": "efcdeebe…",
"ocr_version": "v1.12.9"
"同样输入为什么这次报了那次没报"是可查的,接 CI 时这点很值钱。
九、性能参考:同模型换跑法的差距
官方基准 AACR-Bench:50 个开源仓库、200 个真实 PR、10 种语言、1505 条人工标注问题。
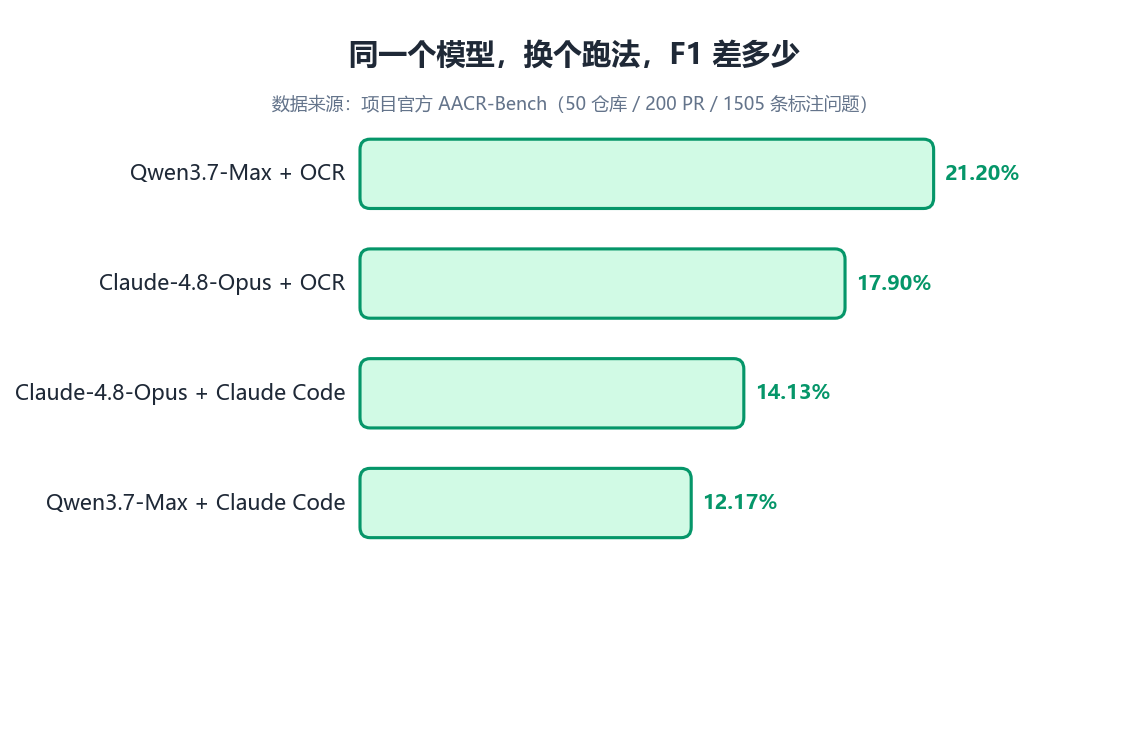
| Qwen3.7-Max | OCR | 21.20% | 25.20% | 18.30% | 625K |
| Claude-4.8-Opus | OCR | 17.90% | 37.80% | 11.70% | 352K |
| Claude-4.8-Opus | 通用 Agent | 14.13% | 15.93% | 12.70% | 2062K |
| Qwen3.7-Max | 通用 Agent | 12.17% | 8.23% | 23.37% | 5153K |
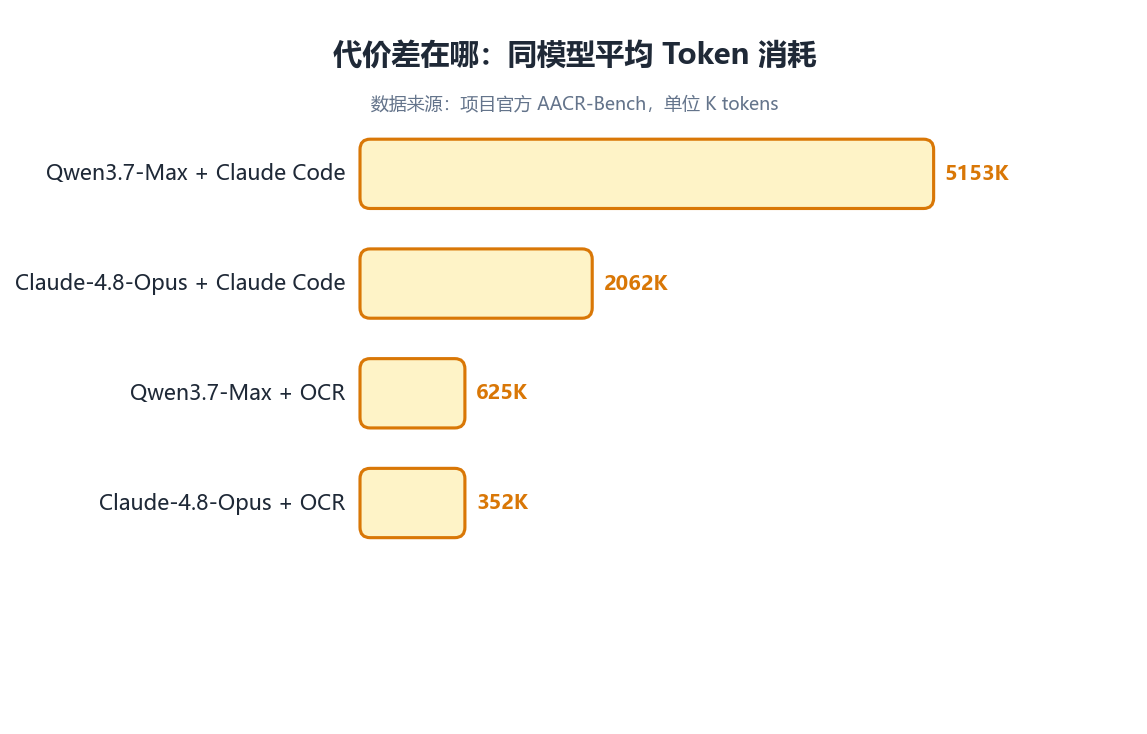
- Token 差 6 到 8 倍,耗时差 5 到 9 倍;
- 精确率翻倍(15.93% → 37.80%);
- 召回率确实更低,官方自己写明是刻意取舍——通用 Agent 靠广撒网多捞回一些,代价是精确率掉到 8.23%。
十、参数速查表
| 只看会审哪些文件 | ocr review –preview |
| 审查太浅,想加轮次 | –effort high(默认 medium,2 轮) |
| 接 CI,只要结构化结果 | –format json –audience agent |
| 排除某些路径 | –exclude '**/generated/*,*.pb.go' |
| 注入业务背景 | –background "本次改动是修订单金额计算" |
| 控制成本 | –max-tokens-budget 500000 |
| 输出 SARIF 给 GitHub Code Scanning | –format sarif |
| 评论说中文 | 配置项 language |
| 断点续跑 | –resume <session-id> |
十一、和商业方案的取舍
第三方横评把四款商业工具挂在同一个 50 万行 TypeScript 仓库跑了两周、40 个 PR(人工标 30 个真实问题):
| CodeRabbit | 15-25 条 | 63% | $24/人/月 |
| Ellipsis | 3-5 条 | 83% | $20/人/月 |
| Qodo | 8-12 条 | 57% | $19/人/月 |
| Greptile | 6-10 条 | 70% | $50/人/月 |
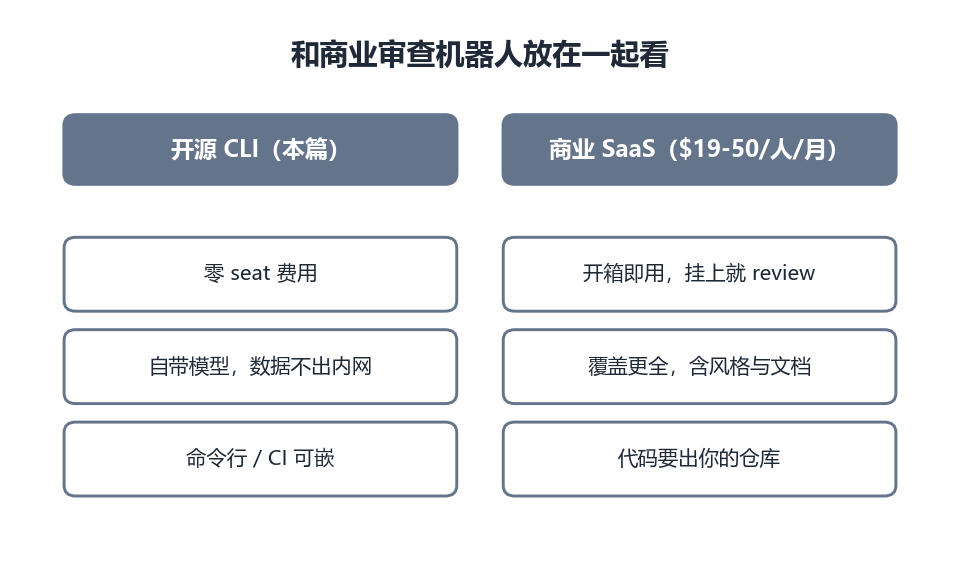
- 要开箱即用、覆盖全:商业 SaaS,代价是代码出仓库、按人头付费;
- 代码不能出内网、要嵌 CI、有团队规则要落地:ocr 更合适,代价是接入自己动手,且它不做风格类评论。
十二、一句话总结
这套设计里最值得学的,不是它用了哪个模型,而是它把哪些事从模型手里拿走了:选文件、控 Token、匹配规则、定位行号、失败降级,全是确定性代码。
如果这篇帮你省了踩坑时间,点个赞 + 收藏——那份项目规则文件的格式和 URL 的坑,都是我试错试出来的。