目录
-
- 一、先说结论
- 二、显存对照表
- 三、配置步骤
- 四、四类任务的实测细节
- 五、混合策略
- 六、几个坑
- 七、什么情况下不值得折腾
- 小结
关于本地大模型做编程助手,网上的教程基本停在「装好了、配好了、能出字了」。
但真正该回答的问题是下一个:配好之后到底能不能干活?
我在自己的项目上断断续续用了一段时间本地模型,这篇把结论写清楚——哪几类任务本地小模型完全够用,哪几类明显不行,以及不同显存能跑什么。省得你花一晚上配完才发现不是想要的东西。
一、先说结论
| 行内补全 | 完全够用 | 这类任务本来就不需要很强的推理 |
| 写单元测试 | 基本够用 | 模式化程度高,稍加约束就行 |
| 解释一段代码 | 够用 | 单文件范围内表现稳定 |
| 生成样板代码 | 够用 | CRUD、DTO 转换这类重复劳动 |
| 跨文件重构 | 明显不行 | 上下文一长就开始丢信息 |
| 复杂 bug 分析 | 明显不行 | 多步推理是小模型的短板 |
| 架构方案讨论 | 不行 | 给出的东西比较空泛 |
一句话概括:重复性、模式化、单文件范围内的活,本地模型够用;需要跨文件推理和多步思考的活,差距还很明显。
所以我现在是混着用:补全和样板代码走本地,重构和排查走云端模型。
二、显存对照表
这块是最容易踩坑的地方。模型参数量和实际显存占用不是一回事,还要看量化精度和上下文长度。
下面这张是按日常编程场景(上下文 8K 到 16K)整理的对照,供选型时估个量级。具体到你的机器还会受量化方式和同时开着什么程序影响,不必当成精确值:
| 8 GB | 1.5B 补全模型 | 只做行内补全,够用 |
| 16 GB | 7B 量化版 | 补全 + 简单问答,日常可用 |
| 24 GB | 7B 完整 / 14B 量化 | 大部分单文件任务可用 |
| 32 GB 以上 | 14B 以上 | 开始接近可用于小范围重构 |
几个实际经验:
Mac 的统一内存要打折算。 M 系列芯片是内存共享的,标称 16GB 不等于有 16GB 给模型用,系统和其他应用要占掉一部分。16GB 的机器跑 7B 量化模型可以,但同时开着 IDE、浏览器和 Docker 的话会开始吃力。
上下文长度是隐藏的内存杀手。 同一个模型,上下文从 4K 开到 32K,显存占用能翻倍。编程场景我一般开到 8K 到 16K,够用且稳定。
补全和对话对模型的要求不一样。 补全要的是快,对话要的是准。用同一个大模型扛这两件事,每次按键都要等一两秒,体验很差。
不同工具处理这件事的方式不同:有的允许你显式配两个模型(一个 1.5B 跑补全、一个 7B 以上跑对话),有的是内部就用轻量模型做行内补全、对话走你选的模型。配之前先确认你手上的工具是哪一种,否则容易出现「挂了个 7B 上去,结果打字卡顿」的情况。
三、配置步骤
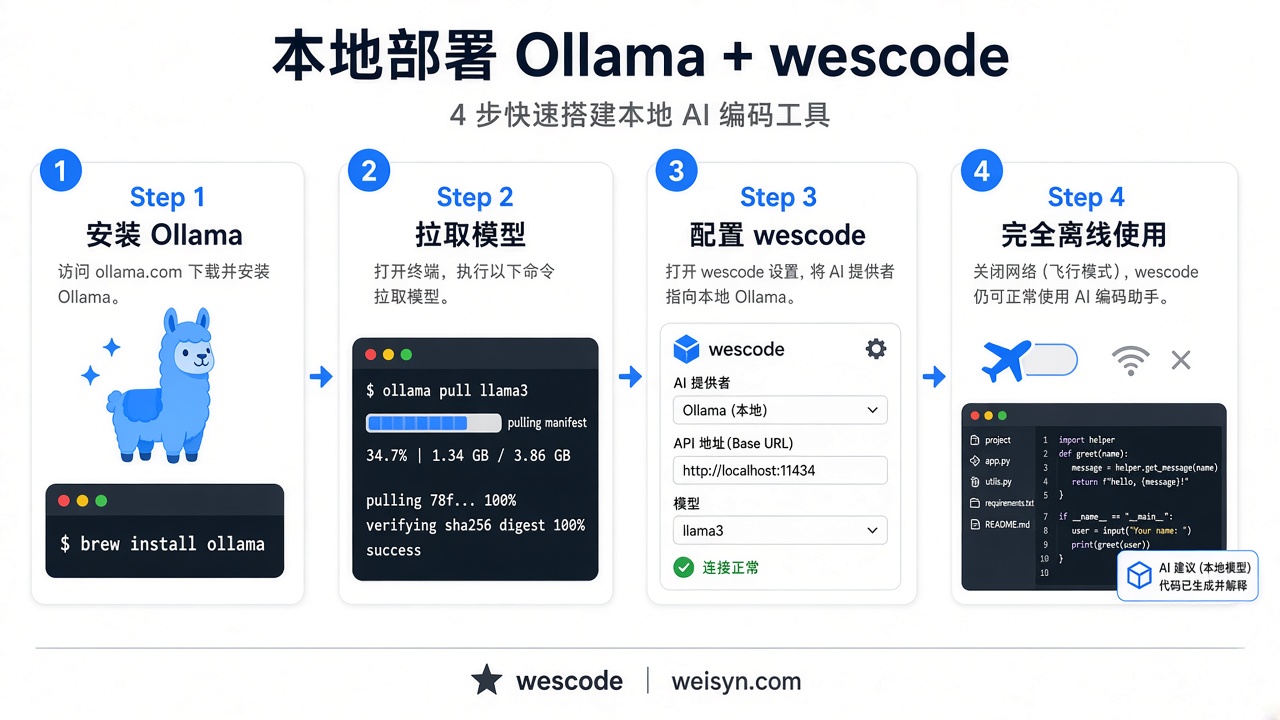
装 Ollama 并拉模型
# 拉一个补全用的小模型
ollama pull qwen2.5-coder:1.5b
# 拉一个对话用的大一点的
ollama pull qwen2.5-coder:7b
# 确认服务起来了
curl http://localhost:11434
# 返回 Ollama is running 就正常
接进编辑器
Ollama 默认暴露的是 OpenAI 兼容接口,所以任何支持自定义 Provider 的编辑器都能接。
我用的是 wescode,在设置里加一个 Provider,填三个字段:
Base URL: http://localhost:11434/v1
API Key: 留空
Models: qwen2.5-coder:7b
注意 Base URL 末尾的 /v1 不能少——Ollama 的原生接口在 11434 根路径,OpenAI 兼容接口才在 /v1 下。少写这一截会连不上,报错信息还往往看不出是这个原因。
填完点测试连接,通了就能用。因为走的是标准接口,配置方式和接云端模型没区别,只是地址指向本机。
这里顺带说一个我比较在意的点:wescode 的代码解析和索引本来就在本地跑,模型再指向本地 Ollama 的话,整条链路都不出这台机器——代码不经过任何外部服务。做内部项目或者有合规要求的时候,这个组合比较省心。
远程 GPU 机器的情况
如果模型跑在另一台机器上(比如家里的台式机或者公司的 GPU 服务器),把地址换成那台机器的 IP 就行:
Base URL: http://192.168.1.x:11434/v1
服务端需要让 Ollama 监听所有网卡,默认它只绑 localhost:
OLLAMA_HOST=0.0.0.0 ollama serve
注意这样等于把模型服务暴露在局域网里,公网环境别这么干。
用 Modelfile 定制一个编程专用模型
这一步可选,但效果比调 prompt 明显。默认模型的参数是通用场景的,编程需要低随机性和大上下文窗口。新建一个 Modelfile:
FROM qwen2.5-coder:7b
# 代码场景要稳定,温度压低。默认 0.8 会让它自由发挥
PARAMETER temperature 0.2
# 上下文给足,不然多文件对话很快就截断
PARAMETER num_ctx 16384
SYSTEM """
你是编程助手,遵守以下规则:
1. 给完整可运行的代码,不给片段
2. 不确定的 API 直接说不确定,不要臆造
3. 遵循代码中已有的命名和错误处理风格
4. 先给结论,再给代码,最后说注意事项
"""
构建并使用:
ollama create coder -f Modelfile
之后在编辑器的 Models 字段里填 coder 就行。temperature 0.2 这一条改善最明显——默认值下同一个问题问两次可能给出不同结构的代码,调低之后稳定很多。
四、四类任务的实测细节
补全:体验接近云端
这是本地模型表现最好的场景。1.5B 的模型在我的机器上响应通常在几百毫秒内,日常写代码基本感觉不到延迟。
补全这件事本来就不需要多强的推理能力——它需要的是接住当前的代码模式然后续写,小模型完全能胜任。
写测试:够用,但要给更多约束
本地模型写测试的质量,比云端模型明显更依赖 prompt 的约束程度。
同样一句「给这个函数写测试」,云端模型还能给出个像样的骨架,本地小模型出来的东西基本要重写。但如果把要求写细——只覆盖边界、用表驱动、断言具体到值——本地模型的输出就能用了。
结论是:本地模型对模糊指令的容错低,但对清晰指令的执行没问题。
所以挂本地模型的时候,我在 wescode 里会把要求写得比平时细一些,边界、断言、组织形式都点明。多打两行字,省掉一轮返工。
解释代码:单文件内够用
「这个函数在干什么」这类问题,本地模型答得不错。
但如果问题涉及跨文件,比如「这个接口有哪些实现,分别在什么场景下用」,本地模型就开始编了——它会给出一个听起来合理但实际不存在的答案。
这里有个组合用法值得一提:结构信息由工具提供,语言组织交给模型。wescode 的调用关系是索引阶段解析出来的,不是靠模型推理的,所以即使挂着本地小模型,「谁调用了这个函数」这类问题依然准确。模型只负责把这些结构信息组织成人话。
这个分工下,本地模型的短板(跨文件推理)被绕开了一部分。
跨文件重构:不建议
我试过几次,结论比较一致:本地 7B 级模型做跨文件重构,改着改着就开始丢东西。典型表现是改了三个文件之后,忘了第一个文件里的改动,最后出来的东西前后不一致。
这类任务我现在直接切云端模型。
五、混合策略
综合下来我的分配是这样:
| 行内补全 | 本地 1.5B |
| 日常问答、解释代码 | 本地 7B |
| 写测试、生成样板代码 | 本地 7B,prompt 写细 |
| 跨文件重构 | 云端模型 |
| 复杂 bug 排查 | 云端模型 |
| 敏感代码的任何操作 | 本地,不上云 |
在 wescode 里切换 Provider 是在设置里改,所以我一般是按项目定:内部项目默认挂本地,开源项目或者没什么敏感度的挂云端。
最后一行值得单独说。有些代码是不能往外发的——客户的、涉及内部算法的、合规要求明确的。这种情况下,本地模型能力弱一些也得用,因为替代方案不是「用云端模型」,而是「什么都不用」。能用上七成能力,比完全靠手写强。
六、几个坑
别指望它有云端模型的水平
7B 和几千亿参数的模型,差距是客观的。看到有文章说本地模型「完全可以替代」,那多半没在真实项目里用过。它是能干活,但干的是特定类型的活。
第一次加载有冷启动
模型第一次调用要加载进显存,可能要等十几秒。之后会常驻一段时间,闲置久了又会被换出。偶尔遇到一次响应特别慢,多半是这个原因,不是配置有问题——我一开始以为是 wescode 那边连接超时,查了半天才发现是 Ollama 在重新加载模型。
笔记本注意发热和续航
持续跑模型时风扇会一直转,电池掉得也快。我在外面用笔记本的时候一般切回云端模型,插电的时候才挂本地。
模型更新要手动
ollama pull 拉下来的模型不会自动更新,新版本出来得自己重新拉。我大概一两个月看一次有没有更新,编程类小模型这一年迭代还挺快的。
七、什么情况下不值得折腾
机器配置不够的时候。 8GB 以下的显存或内存,勉强跑起来体验也很差,不如直接用云端。
只是偶尔用一下的时候。 一个月写几次代码,云端 API 那点调用费比折腾本地环境的时间成本低得多。
你的活主要是复杂重构的时候。 本地模型在这块确实不行,配了也是白配。
真正值得配的情况其实很明确:代码不能外传,或者高频使用补全这类简单任务。 前者是硬需求,后者是本地模型的强项区间。
小结
本地模型能不能做编程助手,答案是「能,但要分清楚场景」。
补全、样板代码、单文件范围的问答,本地 7B 级模型已经够用,而且响应快、不用联网。跨文件推理和复杂分析,和云端模型的差距还是实打实的,短期内不太可能追平。
比较务实的用法是混着来:简单高频的走本地,复杂低频的走云端,敏感代码无条件走本地。反正现在大部分工具都支持自定义 Provider,切换成本很低。
如果你的诉求是代码不出本机,那还要多看一层:除了模型跑在哪,代码解析和索引是不是也在本地。有些工具模型可以挂本地,但索引过程还是要把代码传到服务端,那样等于白搭。
文中的 Provider 配置和本地索引是在 wescode 里做的,官网是 weisyn.com。你们用本地模型跑编程助手,实际体验如何,欢迎评论区交流。