现在做自动驾驶、机器人、无人机、目标检测,经常会看到一个词:多模态融合(Multimodal Fusion)。
RGB、LiDAR、Depth、Point Cloud、Thermal Infrared……看起来都是“看环境”,为什么还要放在一起?
核心原因其实很简单:
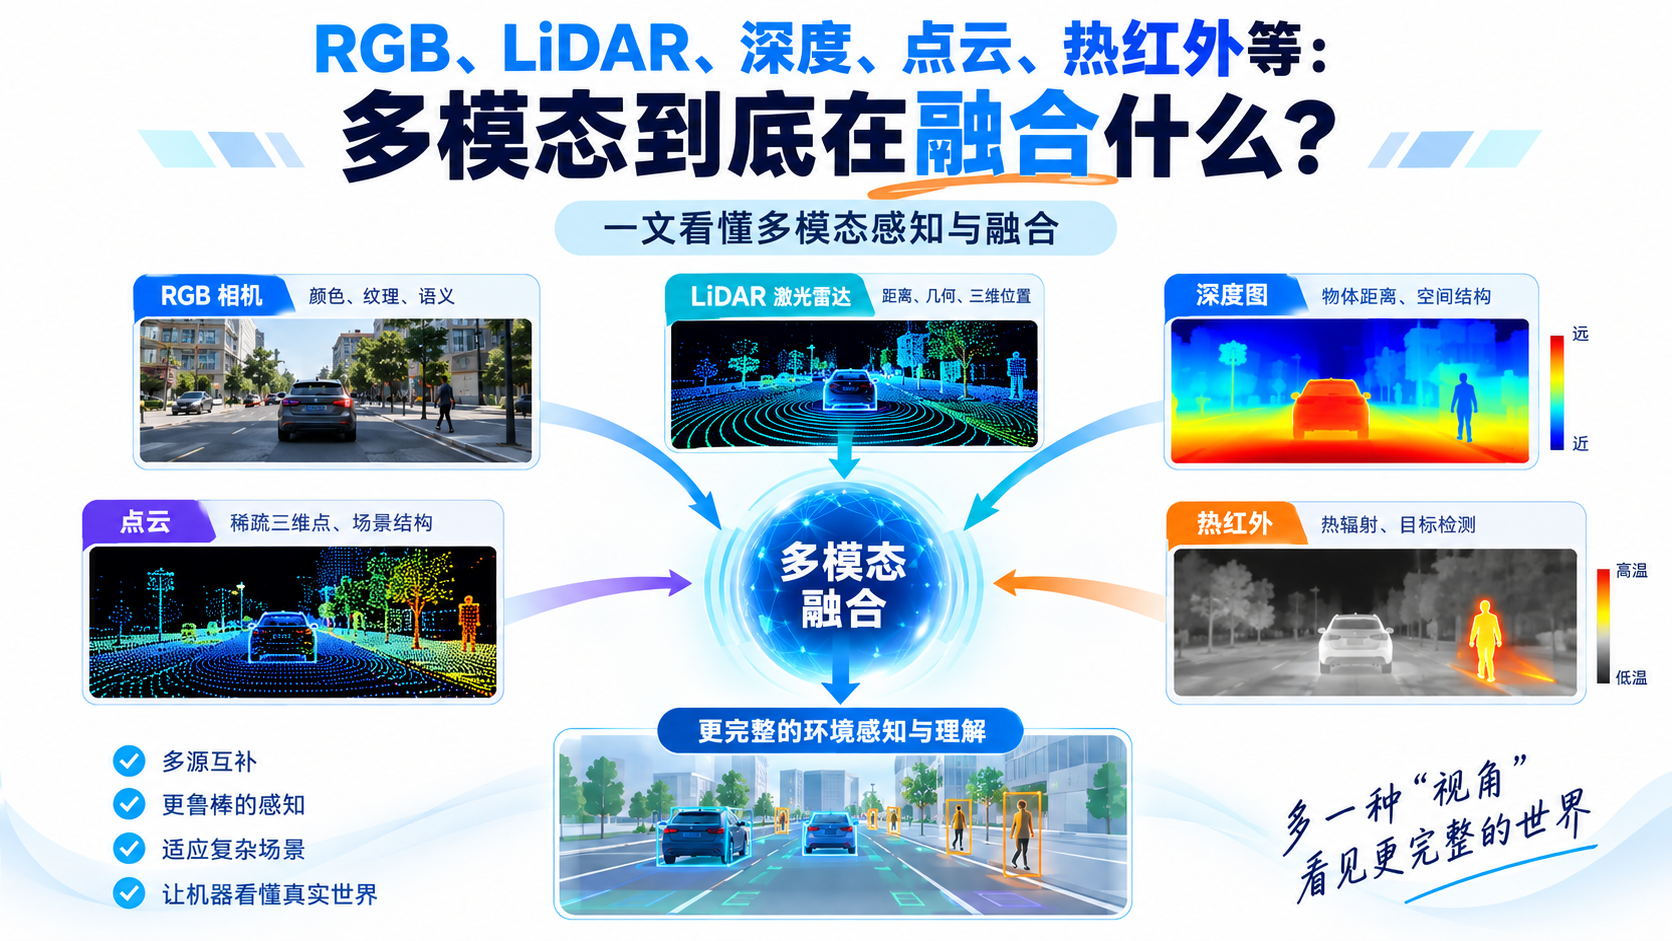
不同模态看到的是同一个世界的不同信息。多模态融合,就是把这些互补信息组合起来,让模型看得更完整。
1. 先搞清楚:这些数据到底有什么区别?
| RGB | 颜色、纹理、外观、语义 | 信息丰富、分辨率高 | 怕黑暗、强光 |
| Depth | 每个位置距离相机多远 | 直接提供空间距离 | 有效距离和精度受传感方式影响 |
| LiDAR | 激光测距得到的三维距离信息 | 3D 几何精度高 | 点较稀疏、成本较高 |
| Point Cloud | 一组三维空间点 (x,y,z) | 描述物体三维结构 | 缺少丰富纹理和颜色 |
| Thermal | 物体热辐射信息 | 夜间、弱光下仍可工作 | 纹理和颜色信息少 |
RGB 擅长回答:
“这是什么?”
而 LiDAR、Depth、Point Cloud 更擅长回答:
“它在哪里?离我多远?形状怎么样?”
热红外则可以补充:
“哪里存在明显的热目标?”
这就是不同模态之间的互补性。摄像头能够提供丰富的颜色和纹理语义,而 LiDAR 更擅长提供三维几何和距离信息,因此 Camera + LiDAR 已成为三维感知中典型的多模态组合。
2. LiDAR、Depth 和点云,其实不是一回事
这里最容易混淆。
LiDAR 是一种传感器
LiDAR,即 Light Detection and Ranging,通过发射激光并测量返回信息得到距离。
它通常可以生成:
LiDAR → 距离测量 → 3D 点云
Depth 是“深度信息”
例如:
RGB图像
每个像素:R G B
Depth图像
每个像素:距离值
Depth 可以来自很多方式,例如:
-
双目视觉
-
ToF
-
结构光
-
LiDAR
因此:
Depth 不等于 LiDAR。LiDAR 只是获取深度/距离信息的一种方式。
Point Cloud 是数据表示
点云本质上是一堆三维坐标:
(x1, y1, z1)
(x2, y2, z2)
(x3, y3, z3)
…
它既可以来自 LiDAR,也可以由 RGB-D 相机、双目视觉或三维重建得到。
所以更准确地说:
LiDAR:传感器
Depth:距离/深度信息
Point Cloud:3D数据表示
3. 多模态到底在“融合”什么?
不是简单把两张图片拼在一起。
真正融合的是不同传感器对同一场景的不同描述。
例如识别一个夜间行人:
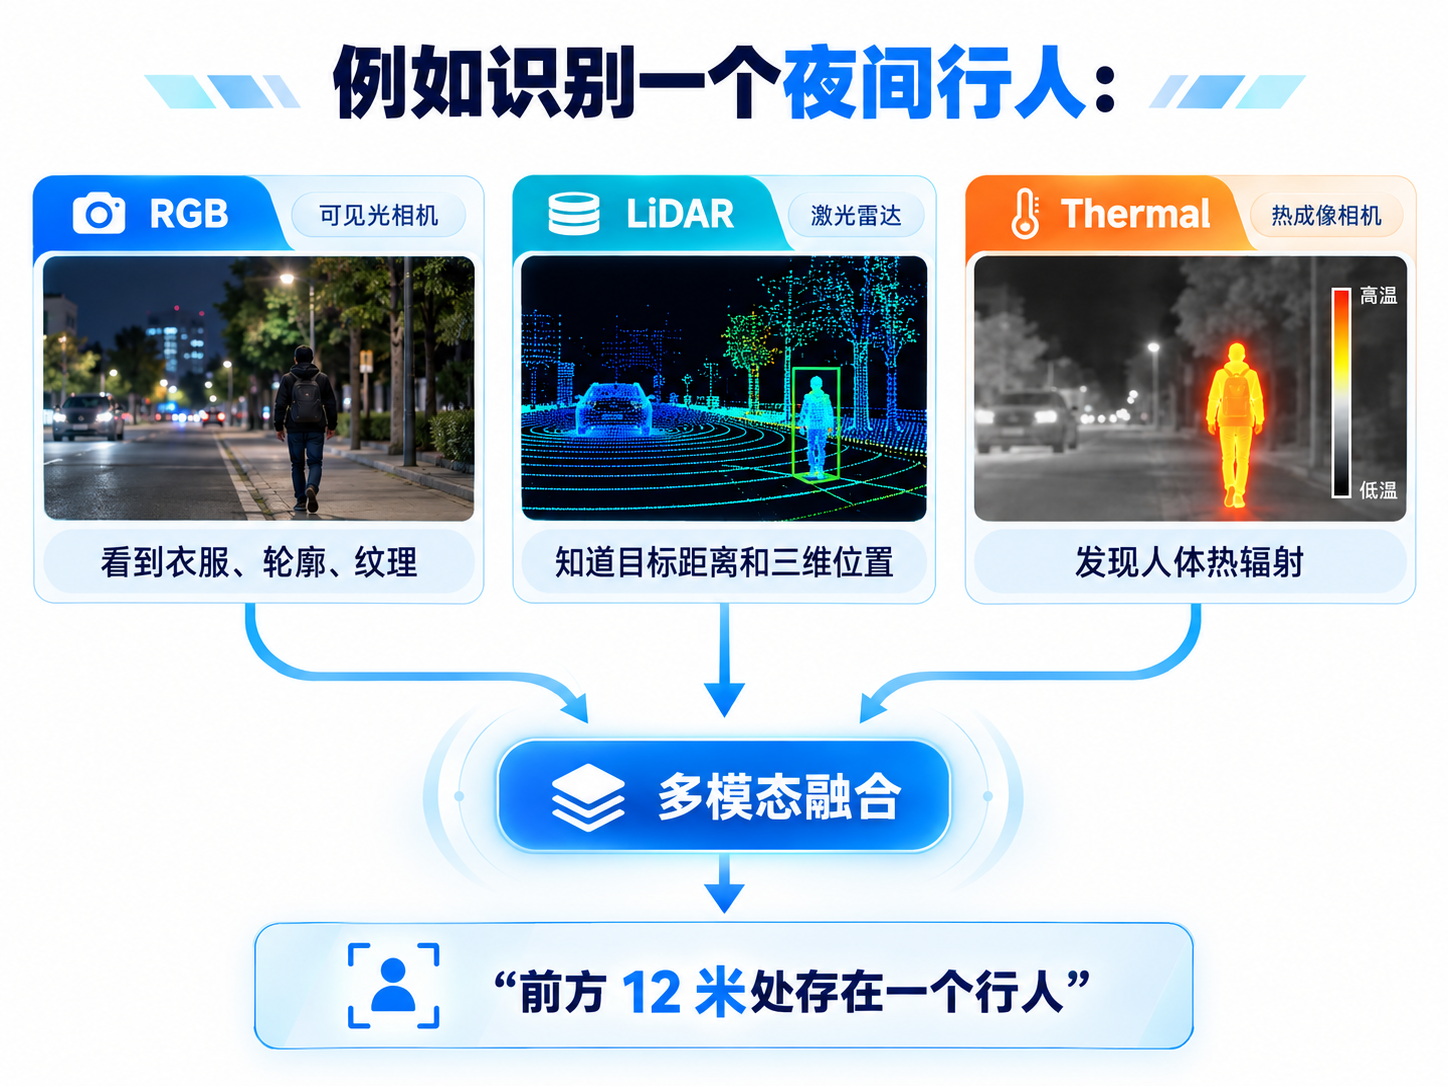
单独使用某一种传感器,都可能存在盲区。
RGB 光线不好时容易失效;点云虽然有很好的空间结构,却缺少丰富的颜色和纹理;热红外能够在弱光环境补充信息,但通常无法提供 RGB 那么丰富的视觉细节。RGB-D 与 Thermal 的融合因此被用于检测、跟踪、三维重建等任务。
4. 那模型怎么把它们融合起来?
常见方法可以简单分成三类。
① 数据级融合
直接在输入附近组合数据。
RGB + Depth
↓
RGB-D
↓
模型
优点是信息保留充分,但不同传感器必须做好空间对齐。
② 特征级融合
这是深度学习中非常常见的方法。
RGB → CNN/Transformer → RGB Feature
↘
Fusion → Detection
↗
LiDAR → Encoder → 3D Feature
模型先分别提取特征,再通过拼接、注意力机制或 Transformer 等方法融合。
③ 决策级融合
不同模态先独立预测,再把结果组合。
RGB → 检测结果 ─┐
├→ 最终结果
LiDAR → 检测结果 ┘
这类方法结构比较清晰,但前期丢掉的一些细粒度信息很难再恢复。
现代多传感器研究还大量使用 BEV(Bird's-Eye View,鸟瞰图),先把 Camera、LiDAR 等信息转换到统一空间,再进行融合。
5. 多模态真正困难的,其实不是“多”
真正困难的是:
怎么让不同模态准确对应起来。
比如 RGB 看到一个人:
像素位置:(540, 320)
LiDAR 中同一个人可能对应:
空间坐标:(8.2m, 1.4m, 0.9m)
模型必须知道:
这两个数据描述的是同一个目标。
因此多模态系统往往需要解决:
空间标定 + 时间同步 + 坐标转换 + 特征对齐 + 信息融合。
如果相机和 LiDAR 没有对齐,再强的网络也可能把“人的图像”和“旁边汽车的点云”错误地融合到一起。跨模态数据的空间错位、时间不同步以及不同传感器的数据分布差异,也是多传感器融合研究中的核心问题。
6. 一张图理解多模态
所以,多模态并不是简单地:
“传感器越多越好。”
而是:
让不同模态各自提供自己最擅长的信息,再把这些信息正确地对齐和融合。
RGB 告诉模型**“它看起来是什么”**;
Depth / LiDAR / Point Cloud 告诉模型**“它在哪里、空间结构是什么”**;
Thermal 告诉模型**“它的热辐射特征是什么”**。

最终,多模态融合做的事情就是:
把颜色、纹理、语义、距离、三维结构、热信息等不同维度的观察,组合成对真实世界更完整的理解。