Minimax Music开源,配套神器T8已开源,继AI视频自由后,AI音乐也自由了!新版comfyui整合包V18更新,写一个教程
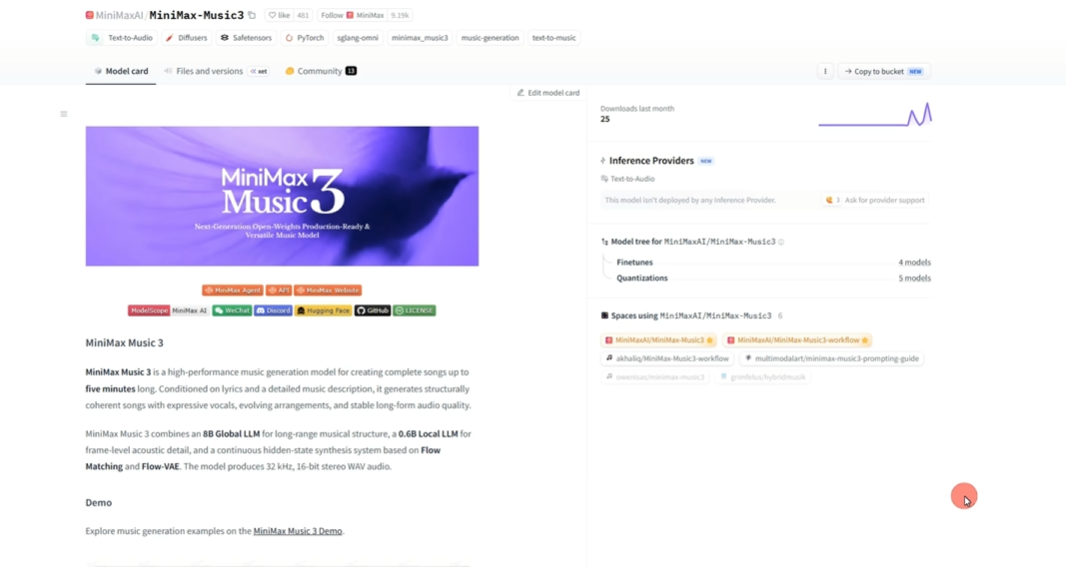
MiniMax Music 3 开源 + ComfyUI V18 整合包教程
就在昨天,继开源视频模型 H3 之后,MiniMax 又把音乐模型 MiniMax-Music3 给开源了。配合 T8 大佬刚更新的 ComfyUI V18 整合包,AI 音乐本地自由,现在真的实现了。
一、MiniMax-Music3 是什么?
一句话:一个能在你本地电脑上生成最长5分钟完整歌曲的AI模型,带人声,还支持中文/日文等多种语言。
它和 Suno、Udio 这类在线工具最大的不同是——模型权重完全免费开放,你可以下载到本地,没有任何次数限制,想生成多少首就生成多少首。
效果到底怎么样?
目前开源TTS/SVS领域,MiniMax-Music3 绝对是顶级的(SOTA级别)。虽然和顶级的闭源商业产品(比如 Suno)比还有一点差距,但在开源模型里,它已经是天花板了。
硬件门槛:官方推荐 24GB显存(如RTX 4090),实测生成3分钟歌曲约需219秒。整合包也支持通过配置在更低显存下运行。
二、下载与安装(V18整合包)
T8 大佬已经把所有依赖和环境都打包好了,不需要自己配 Python 环境。
MiniMax Music 3 模型 夸克网盘分享
T8 CF 整合包 V18 夸克网盘分享
T8 配套节点仓库https://github.com/T8mars/comfyui-minimax-h3-prompt-enhancer-T8
官方模型 Hugging Facehttps://huggingface.co/MiniMaxAI/MiniMax-Music3
官方提示词技能 (Skills) https://github.com/MiniMax-AI/MiniMax-Music3/tree/main/skills
安装步骤
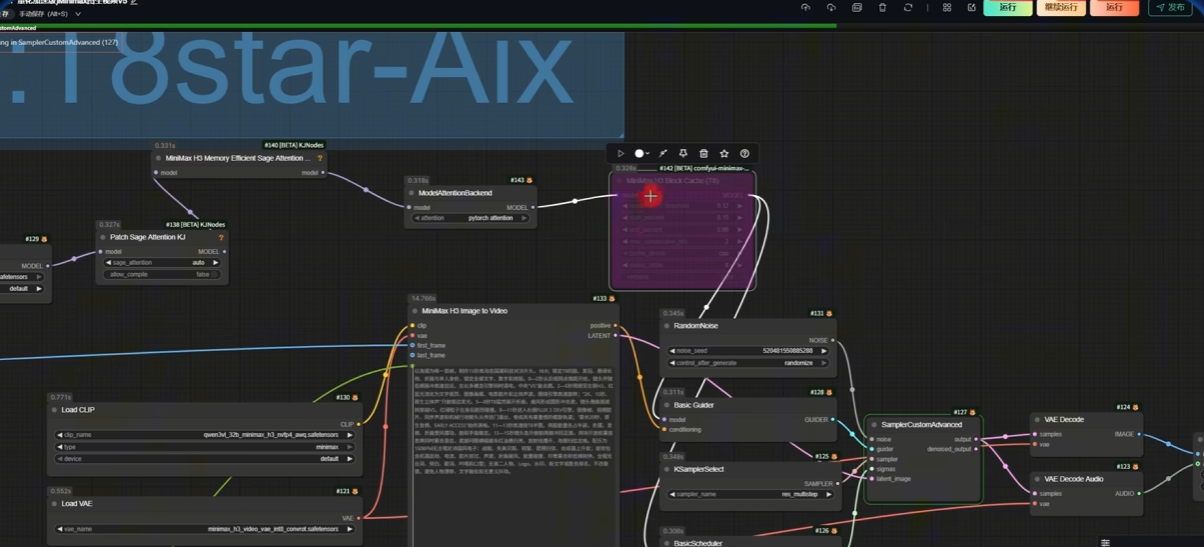
三、核心玩法:如何写提示词
MiniMax-Music3 不是随便写一句“来首悲伤的歌”就能出好效果的。它需要结构化的描述,就像给音乐人写一份制作需求单。
官方推荐的三段式结构:
1. 全局信息
- 流派/子流派、BPM(速度)、调性
- 情绪走向(从哪到哪)
- 收听场景、制作风格
2. 人声细节
- 性别、音色特质、演唱风格
- 和声、背景人声、效果
3. 编曲与段落
- 主奏/辅奏乐器
- 每个段落(主歌、副歌、桥段)的乐器变化
- 律动、低音、打击乐、空间感
示例(直接可复制修改):
Warm Mandarin pop / traditional Chinese ballad, 74 BPM, A-flat major.
Tender nostalgia opens into a celebratory chorus, with a mature male baritone-tenor, delicate guzheng, soft strings, gentle acoustic textures, expressive vibrato, and a natural live-room sound.
歌词格式
歌词需要用段落标签来标记结构,这样模型才知道哪里是主歌、哪里是副歌:
[Verse 1]
歌词第一段内容…
[Pre-Chorus]
过渡段内容…
[Chorus]
副歌内容…
[Bridge]
桥段内容…
[Outro]
尾奏内容…
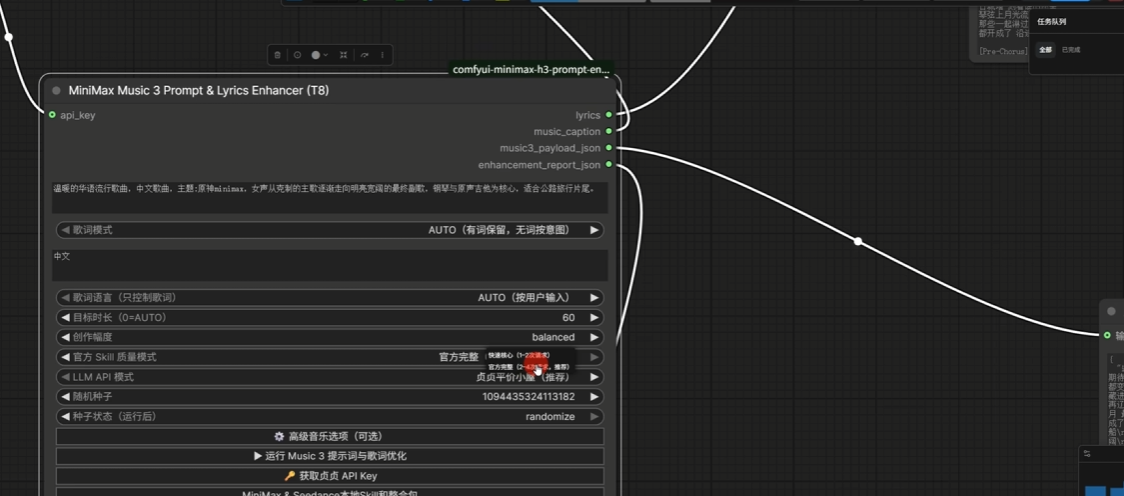
如果不想自己写,可以用 MiniMax 官方提供的 Skill(提示词生成器),输入主题就能自动生成结构化的描述和歌词。Skill 在官方 GitHub 的 skills 目录下。
四、ComfyUI 工作流使用
工作流节点说明
V18 整合包中,核心节点是 MiniMax Music 3 Generator:
|
输入 |
说明 |
|
Caption |
上面的三段式结构化描述 |
|
Lyrics |
带段落标签的歌词 |
|
Duration |
生成时长(最长300秒) |
模型选择
- minimax_music3_dit_fp16.safetensors:推荐,显存够用就选这个
- minimax_music3_dit_int8_convrot.safetensors:显存较低时使用
生成后通过 SaveAudioAdvanced 节点导出 WAV 文件。
常用参数建议
- 采样步数:官方建议 2-4 步即可,因为是 Flow Matching 架构
- 目标时长:建议从 60 秒开始测试,确认效果后再拉长
五、常见问题
Q1:报错 "block cache" 相关?
T8 的整合包已经修复了这个问题,更新到 V18 即可。如果自己装的节点,更新 ComfyUI-MiniMax-H3-BlockCache-T8 到最新。
Q2:生成的歌声音不稳定/走调?
检查提示词是否写了足够的结构信息。只写一句话的描述效果通常不好,尽量按三段式把 BPM、调性、乐器、段落变化都写清楚。
Q3:为什么只有 32kHz?
目前开源版本输出是 32kHz 16-bit 立体声 WAV,比 CD 音质(44.1kHz)稍低,但做 Demo、视频 BGM、播客配乐完全够用。
Q4:能生成纯音乐吗?
可以。歌词留空,或者把 is_instrumental 设为 true,就会生成无人声的纯音乐版本。
六、相关资源汇总
|
资源 |
链接 |
|
官方 GitHub |
GitHub – MiniMax-AI/MiniMax-Music3 · GitHub |
|
Hugging Face 模型页 |
https://huggingface.co/MiniMaxAI/MiniMax-Music3 |
|
官方 Demo(在线试听) |
MiniMax Music 3 |
|
官方 Skill(提示词生成) |
MiniMax-Music3/skills at main · MiniMax-AI/MiniMax-Music3 · GitHub |
|
ComfyUI 官方工作流 |
MiniMax Music 3:テキストから音楽 – ComfyUI Workflow |
祝玩得开心!记得给 大佬和官方点个 Star~ 🎵