摘要:2026 年 9 月 22 日凌晨,小米正式发布并开源 MiMo-V2.6 系列——1.02T 参数的旗舰推理模型 MiMo-V2.6-Pro、均衡型 MiMo-V2.6-Flash、以及最高 20 倍输出速度的 Pro-UltraSpeed 模式。MiMo-V2.6-Pro 在 Artificial Analysis 综合智能指数(v4.3)拿下 46.32 分,超越 Kimi K3、GLM-5.3、DeepSeek V4.1 全系,成为当前得分最高的开源模型。罗福莉更是直言:这项工作的研究创新与工程难度,「甚至超过她曾部分参与的 DeepSeek R1」。本文从产品矩阵、技术架构、规模化强化学习、榜单成绩、开源生态、定价策略、实战案例到上手使用,一文讲透。
标签:#MiMo-V2.6 #大模型 #开源 #强化学习 #小米
1. 开场:今天凌晨,小米放了个大招
9 月 22 日凌晨,小米没有开一场发布会,而是直接甩出了新一批模型:Xiaomi MiMo-V2.6 系列,同步开源权重。官方称这是其探索 RSI(Recursive Self-Improvement,递归自我改进) 路径的关键一步——以可验证的复杂任务为基础,规模化扩展强化学习(RL)算力,让模型在持续的探索与反馈中不断拓展智能边界。
这套打法最炸裂的地方在于:小米把一场持续近 6 天、合计花费约 347 万美元的强化学习训练,全程直播给了外界看。从训练进度、成本变化到任务通过率,外界可以近乎实时地围观两个模型如何在 30 个 RL step 中「变强」。这在开源模型史上是头一回。
配合新模型,小米还同步放出了 MiMo Desktop 桌面客户端正式版(Windows / Mac),以及 Pro 版本的 UltraSpeed 超高速模式——官方称在保持质量不变的前提下,输出速度最高可达普通 Pro 的 20 倍。
「超过 DeepSeek R1」怎么理解? 这是这两天社区讨论最热的一句话。准确拆解有三层:
2. 产品矩阵:四个版本,各司其职
MiMo-V2.6 系列一共四个成员,覆盖了从「极致性能」到「轻量研究」的完整光谱:
| MiMo-V2.6-Pro | 旗舰推理模型 | 总参数 1.02T / 激活 42B,1M 上下文 | 全模态、超高性能,面向复杂项目、长程任务、高价值工作、网络安全与科研 |
| MiMo-V2.6-Flash | 高效推理模型 | 总参数约 310B / 激活约 15B | 全模态、高智能、低成本,面向专业办公高频调用与规模化任务 |
| MiMo-V2.6-Pro-UltraSpeed | 超高速模式 | 同上(Pro 加速版) | 保持 Pro 质量,输出速度最高 20 倍,面向强实时交互场景 |
| MiMo-V2.6-Distill-Qwen-9B | 轻量研究版 | 9B(由 Qwen3.5-9B 蒸馏) | 给算力有限的开发者做 RL 研究与复现的起点 |
两个主力模型都是原生全模态:文本、图像、视频、音频在同一条网络里处理,而不是「文本模型 + 外挂视觉编码器」的缝合方案。这也是「全模态(Omnimodal)」与常见的「多模态(Multimodal)」在架构层面的本质区别。
3. 技术内核:1.02T 参数的「豪华」配置
先看一张我自己画的架构示意图,把整条链路串起来:
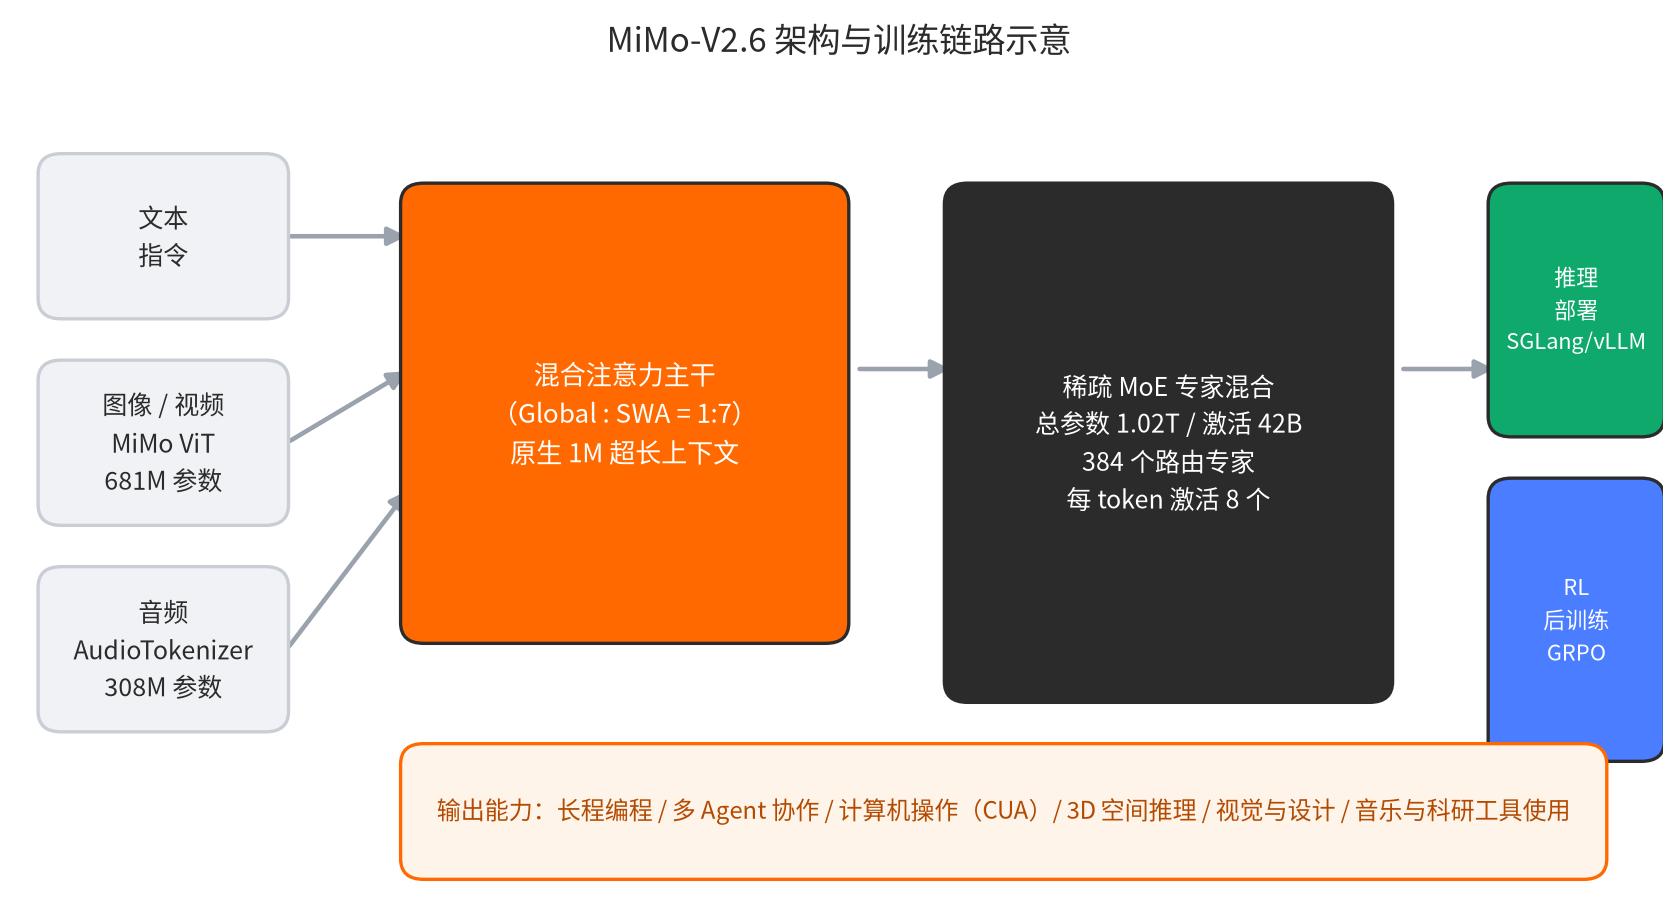
关键点拆开讲:
3.1 稀疏 MoE:1.02T 总参数,激活只有 42B
MiMo-V2.6-Pro 是稀疏专家混合(MoE)架构,总参数量 1.02 万亿,每次推理只激活 42B,内部配置 384 个路由专家、每个 token 激活其中 8 个。这个「总参数大、激活参数小」的设计,让模型在拥有巨型知识容量的同时,推理成本可控——这也是它能做到「1M 上下文 + 便宜价格」的底气。
3.2 混合注意力:1:7 的 Global 与 SWA 搭配
沿袭 MiMo-V2 系列的 Hybrid Attention 设计,Global Attention 与 Sliding Window Attention(滑动窗口注意力)按 1:7 的比例混合。全注意力层负责捕获全局依赖,滑动窗口层负责高效处理长序列,配合 原生 1M token 上下文窗口(最大输出 128K),意味着它可以一口气读完一个大型代码仓库、长工具调用轨迹,甚至是多会话的 Agent 运行记录。
3.3 全模态编码器:视觉音频双通道
模型包含两条输入编码通路:一个 681M 参数的 MiMo ViT 负责图像/视频理解,一个 308M 参数的 AudioTokenizer 负责音频处理,再接一个混合注意力主干,最后用推测解码(Speculative Decoding)头做加速。也就是说,从声音到画面,模型是「真的看见、真的听见」,而不是 OCR + 转写文本的降级处理。
3.4 精度与工程
训练采用 FP8(E4M3)混合精度(延续 V2.5 系列),1M 上下文长度训练,单步训练 token 达 3.5~3.7B。这套配置不是堆参数堆出来的「大而无当」,而是为长程 Agent 任务专门设计的。
4. 核心武器:六天烧掉 347 万美元的规模化 RL
如果说架构是 MiMo-V2.6 的「身体」,那规模化强化学习就是它的「大脑升级手术」。这一节是整个模型最值得聊的部分。
4.1 训练规模:史无前例的公开直播
按官方技术报告与媒体报道,MiMo-V2.6-Flash 与 Pro 各完成了 30 个 RL step,各自产生约 75 万条训练轨迹,耗时不到 6 天,成本分别约 85 万美元 和 262 万美元,合计 347 万美元。每个 step 使用 1568 个 prompt × 每条 16 个 rollout,一次处理约 2.5 万条长序列、27 亿~37 亿训练 token。
两个模型的平均任务通过率分别相对提升 25%(Flash) 与 12%(Pro);在样本外的长程软件工程基准 DeepSWE v1.1 上,Flash 从 48.8 分涨到 65.68 分(+17),Pro 从 58.4 分涨到 72.57 分(+14):
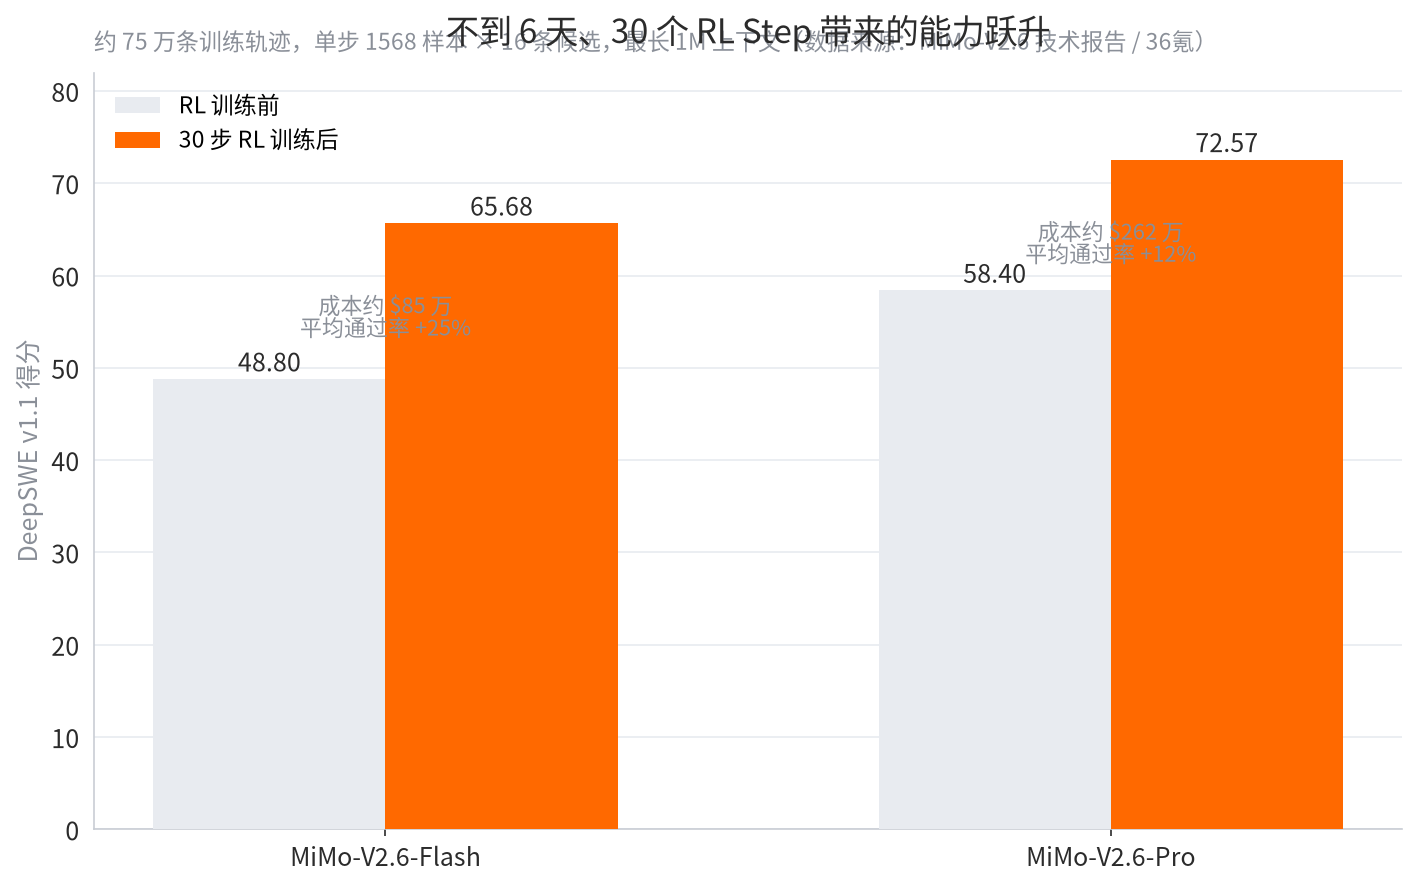
「样本外也能涨」这点非常关键——说明模型学到的不是刷题技巧,而是可迁移的通用长程执行能力。
4.2 三个维度的算力扩展
官方明确说了,这次 RL 是从三个维度同时放大:
4.3 防「奖励作弊」:大规模 RL 的隐形战场
大规模 RL 最容易翻车的就是奖励黑客(Reward Hacking)——模型钻评分规则的漏洞,表面拿高分、实际没干活。小米的处理是四件套:训练期间冻结 MoE 路由器抑制训练漂移;配合奖励设计、对抗评测、异常检测,以及多个验证器之间的交叉核验,把训练稳定性和奖励可靠性都拉上去。同时统一了不同 Agent 框架产生的轨迹格式,让异构任务能进入同一套训练系统。
4.4 MixRL + MOPD:罗福莉解释的分工
在 36 氪的采访里,罗福莉拆解了这套 RL 体系的分工:
- MixRL(混合强化学习):处理代码等难度适中、能够可靠验证的 Agent 任务,让模型获得可以跨任务迁移的通用能力;
- MOPD(多任务在线策略蒸馏):把游戏、3D、超长链路、评价标准偏主观的任务分开训练,再合并回主模型,避免拖慢 rollout 或造成数据过期。
她还提到,扁平的团队结构降低了 MixRL 的组织成本——几十人的团队长期围绕同一个目标,先通过中期训练积累模型潜力,再用大规模 RL 释放出来。按算力投入衡量,这很可能是开源模型团队迄今规模最大的单次强化学习训练之一。
5. 成绩单:开源模型的新标杆
5.1 AA 综合智能指数:46.32 分,开源第一
Artificial Analysis 综合智能指数(v4.3)整合了 10 项评估(AA-Briefcase、GDPval-AA v2、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity’s Last Exam、AA-Omniscience、AA-LCR v1.1 等)。MiMo-V2.6-Pro 拿下 46.32 分:
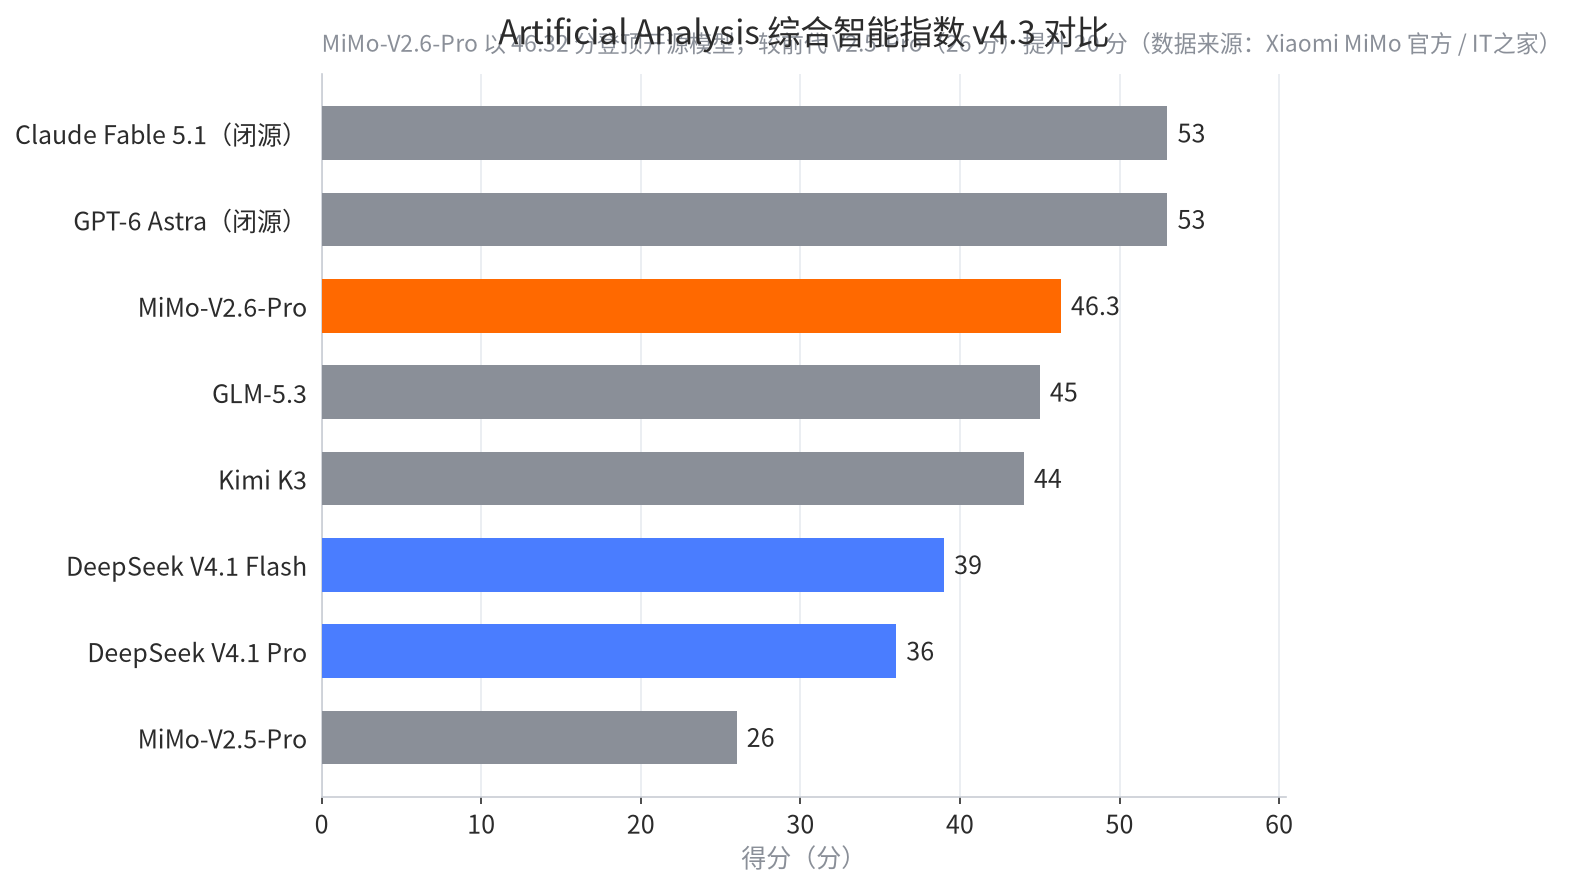
- 超过 GLM-5.3(45 分)、Kimi K3(44 分)、Qwen3.8 Max 等所有开源权重模型;
- 超过 DeepSeek 最新一代 V4.1 Flash(39 分) 与 V4.1 Pro(36 分);
- 相比前代 MiMo-V2.5-Pro 的 26 分,提升了整整 20 分;
- 但对比最强闭源模型 Claude Fable 5.1、GPT-6 Astra(均 53 分)仍有明显差距——这是官方自己承认的。
5.2 编程与 Agent 能力:逼近闭源旗舰
长程软件工程基准 DeepSWE v1.1 上,Pro 拿到 71.9 分,逼近 DeepSeek V4.1 Flash 的 74.2 和 Claude Opus 5 / GPT-6 Astra 的 74.0;对比 V2.5-Pro 的 19.0 分,代际跃升超过 50 分:

其他关键分项(Pro 版本,满分越高越好):
| Toolathlon-Verified | 76.9 | GPT-5.6 Sol 74.9 | Claude Fable 5 77.9 | 高于 GPT-5.6 Sol |
| Automation Bench v1.0.6 | 53.1 | DeepSeek V4.1 Flash 54.8 | GPT-6 Astra 52.0 | 略低于 V4.1 Flash,高于 GPT-6 Astra |
| JobBench(真实职业任务) | 62.0 | Claude Opus 5 65.7 | — | 仅次于 Opus 5 |
| MiMo Visual Coding(自研) | 72.3(Flash 71.5) | DeepSeek V4.1 Flash / Claude Opus 5 | GPT-6 Astra 82.2 | 高于前两者,低于 Astra |
注:MiMo Visual Coding 是小米自研的网页/可视化界面生成评测,口径与第三方基准不同,参考时注意甄别。
5.3 Agent 专项:部分基准反超闭源
在终端操作与网络安全两个 Agent 场景上,V2.6 的表现非常亮眼:
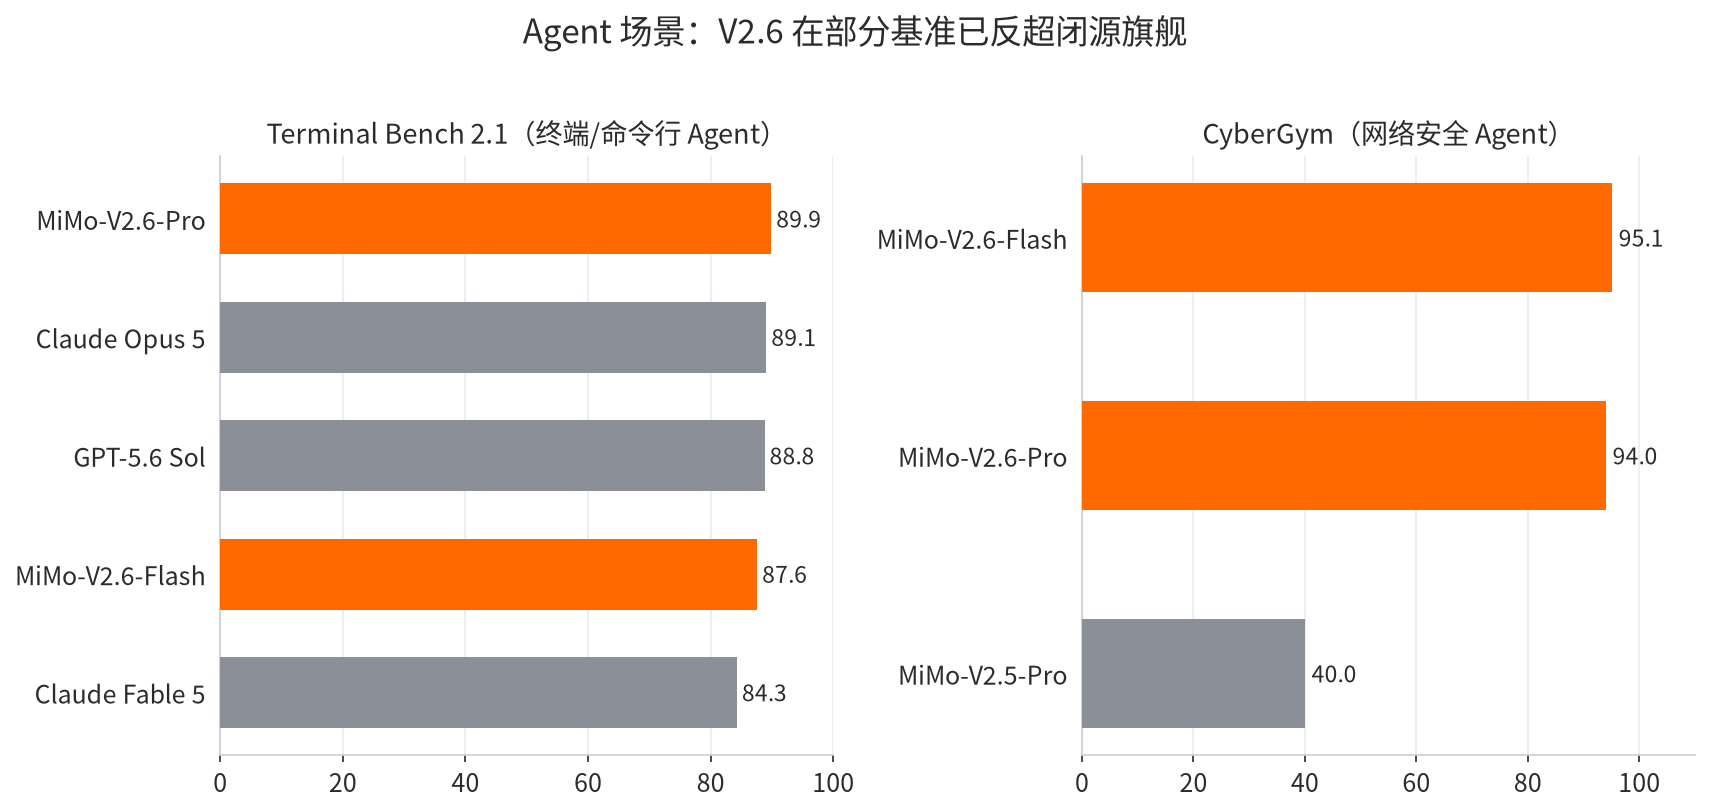
- Terminal Bench 2.1:Pro 89.9 分,反超 Claude Opus 5 的 89.1 分;
- CyberGym(网络安全 Agent):Pro 94.0、Flash 95.1,而 V2.5-Pro 只有 40.0——网络安全能力近乎翻倍。
5.4 短板也要说清楚
- Terminal Bench 4.0:Pro 只有 34.9 分,对比 GPT-6 Astra 的 59.6、Claude Fable 5.1 的 55.1,差距明显(注意 2.1 与 4.0 是不同版本,分数不可直接对比);
- 多项网络安全评测整体仍落后于头部闭源模型;
- 综合智能指数层面,与最强的闭源模型(53 分)还有约 7 分的距离。
一句话总结成绩单:开源阵营里没有对手,闭源阵营还在前方——但对开源模型而言,46.32 分的综合成绩配上便宜大碗的价格,可能比个别榜单名次更有现实意义。
6. 全面开源:不止权重,连训练过程都给了
这次开源力度,可能是小米在 AI 圈口碑最好的一次。MiMo-V2.6-Pro-RL、MiMo-V2.6-Flash-RL、MiMo-V2.6-Distill-Qwen-9B 权重全部挂在 Hugging Face(组织名 XiaomiMiMo),协议是 MIT——商用、自托管、微调、魔改,全部没有限制。一个 1.02T 参数的全模态模型用 MIT 开源,这本身就很不寻常。
更难得的是,小米同步开放了**「如何让模型变强」的整套工具链**:
- 完整技术报告:训练曲线、奖励机制、任务配比、关键参数、成本构成全部写进去,可审计、可复现;
- 7k+ 高质量 RL 任务环境:覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务;
- 端到端 RL 训练框架:基于 verl、uni-agent、mini-swe-agent,覆盖环境交互、轨迹采集、奖励评估、策略优化的完整流程;
- 轻量可组合的 Mini-Harnesses:把系统提示、工具与上下文管理解耦,支持「多 Harness 混合训练」,提升模型在不同框架(包括未见过的框架)上的泛化能力;
- 配套验证器与训练代码:研究者可以照着重跑这套大规模 Agentic RL。
6.1 蒸馏版 9B:给预算有限的研究者一条路
MiMo-V2.6-Distill-Qwen-9B 由 Qwen3.5-9B 蒸馏而来,以它为起点跑 RL,官方公布的成绩(相对 SFT 基线的提升):
| SWE-bench Verified | 61.1 | 66.2 | +5.1 |
| MiMo Cyber Bench | 31.3 | 47.0 | +15.7 |
| Terminal Bench 2.1 | 37.1 | 52.8 | +15.7 |
| MiMo Visual Coding | 64.0 | 72.4 | +8.4 |
9B 模型用同样的 RL 方法也能获得显著增益,说明这套训练方法有较强的规模迁移性——这对学术圈和小团队来说价值巨大。
7. 定价策略:加量不加价,价格屠夫再现
MiMo-V2.6 沿用了 V2.5 系列的 API 定价——更强的智能,一分钱不加。价格单位为「每百万 token」:
| MiMo-V2.6-Flash | ¥0.02($0.0028) | ¥1($0.14) | ¥2($0.28) |
| MiMo-V2.6-Pro | ¥0.025($0.0036) | ¥3($0.435) | ¥6($0.87) |
| MiMo-V2.6-Pro-UltraSpeed | ¥0.25($0.036) | ¥30($4.35) | ¥60($8.7) |
几个关键信息:
- 缓存命中 99% 折扣,且缓存写入限时免费;
- Pro-UltraSpeed 相当于用普通 Pro 10 倍的调用成本,换取最高 20 倍的输出速度——适合强实时场景;
- 官方口径:在同等智能水平下,MiMo-V2.6 系列价格仅为海外模型的 1/20 至 1/60。
这就是小米的策略:当开源模型追上前沿能力,又把价格压到同级海外模型的几十分之一,竞争压力就转移到了价格更高的一方——它们需要证明,多出来的溢价到底能换来什么。
8. 实战案例:从 Vibe Coding 到 Vibe World
小米把 MiMo-V2.6 的能力叙事从「写代码」扩展到了「构建可交互的数字世界」,称之为 Vibe World:给定一个目标、一套工具和时间,模型自己拆任务、调多 Agent 协作、构建、测试、交付。
8.1 游戏开发与 3D 建模
用户输入一张图、一段视频或一句文字,MiMo-V2.6 会把它拆解成多个任务,协调多个 Agent 搭建 3D 场景、编写交互逻辑、做视觉验证,然后根据渲染结果迭代修改,最终产出一个可运行的交互世界。在 3D 建模上,它能直接操作 Blender,根据文字描述或参考图生成可用于动画、3D 打印和游戏开发的资产。
8.2 具身智能仿真
在具身仿真环境中,MiMo-V2.6 直接以多视角相机画面为输入,通过视觉反馈闭环控制 Franka Panda 机械臂,完成物体抓取、颜色匹配和精确摆放——这是把「空间推理 + 多模态感知 + 决策」捏在一起的完整链路。
8.3 视觉与设计
一句话需求生成完整的前端界面或幻灯片,调用 Figma 与图像/视频生成工具补齐素材,还能保持排版、配色、图文排布的审美一致性。视频方面可以端到端完成镜头设计、动效编排、配乐与节奏对齐,并用 MiMo-V2.5-TTS 生成与画面精准对齐的旁白。
8.4 音乐创作
官方演示了两个案例:一个是让 Pro 为约十种乐器创作管弦乐,模型自己写出总谱并转成 MIDI(作品《Night Road》);另一个是两首 A 小调钢琴曲。官方定位是「作曲的第一次探索」,目前是 demo 级质量,更像个专业编曲助手。
8.5 科研:材料设计与定理形式化
这两个案例最能体现模型的「长程工具使用」能力,而且模型没有接受过任何科研专项 RL 训练:
- 材料设计:在小米材料专家的多轮引导下,MiMo-V2.6-Pro 完整走了一遍「联网检索 → 文献/专利调研 → 提出假设 → 新颖性评估 → 干实验(调用开源计算工具、搭建仿真环境、计算 MOF 材料与 PFAS 的结合能)→ 给出湿实验候选」的科研流程,为吸附 PFAS(全氟和多氟烷基物质,俗称「永久化学品」)设计出全新的金属有机框架(MOF)候选材料;
- 定理形式化:协助研究人员用 Lean 4 完成了经典论文《Period Three Implies Chaos(周期三蕴含混沌)》Li-Yorke 定理的完整形式化,项目超过 6000 行 Lean 源码,全部通过 Lean 内核验证,没有任何未完成的证明占位符。
9. 上手使用:API 与本地部署指南
9.1 云端:五个入口
MiMo-V2.6 已上线:小米 AI Studio、MiMo Code、MiMo Desktop(正式版)、MiMo API 开放平台、OpenRouter。MiMo Desktop 支持 Windows / Mac,订阅会员可直接使用 Pro + Flash,也可以配置自己的 API Key。
9.2 API 调用(OpenAI 兼容)
MiMo API 兼容 OpenAI Chat Completions 协议,基地址 https://api.xiaomimimo.com/v1,模型 ID 为 mimo-v2.6-pro / mimo-v2.6-flash,上下文 1M、最大输出 128K。curl 示例:
curl –location –request POST 'https://api.xiaomimimo.com/v1/chat/completions' \\
–header "api-key: $MIMO_API_KEY" \\
–header "Content-Type: application/json" \\
–data-raw '{
"model": "mimo-v2.6-pro",
"messages": [
{"role": "system", "content": "You are MiMo, an AI assistant developed by Xiaomi."},
{"role": "user", "content": "用三句话解释什么是递归自我改进(RSI)"}
],
"max_completion_tokens": 1024
}'
Python 方式(openai SDK):
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ.get("MIMO_API_KEY"),
base_url="https://api.xiaomimimo.com/v1"
)
completion = client.chat.completions.create(
model="mimo-v2.6-pro",
messages=[{"role": "user", "content": "写一个快排并解释复杂度"}],
max_completion_tokens=2048,
extra_body={"thinking": {"type": "enabled"}} # 开启深度思考
)
print(completion.model_dump_json())
深度思考模式的思考过程会通过 reasoning_content 字段返回,方便做思维链展示与分析。此外,MiMo 还提供 Anthropic Messages API 兼容端点(https://api.xiaomimimo.com/anthropic/v1/messages),可直接接入 Claude Code 等工具链。
注意:mimo-v2.5 与 mimo-v2.5-pro 将于 2026 年 10 月 21 日 10:00 正式下线,现有调用请尽快切换到 v2.6 模型 ID。
9.3 本地部署
- MiMo-V2.6-Pro-RL:1.02T 总参数 / 42B 激活,官方推荐用 SGLang 或 vLLM 部署,需要多卡节点(张量并行配置见 HF 模型卡),单卡跑不动;
- MiMo-V2.6-Flash-RL:约 310B 总参 / 15B 激活,部署门槛低一个量级;
- MiMo-V2.6-Distill-Qwen-9B:单卡可跑,适合做 RL 研究与轻量场景。
权重地址:Hugging Face 组织 XiaomiMiMo(MiMo-V2.6-Pro-RL / MiMo-V2.6-Flash-RL / MiMo-V2.6-Distill-Qwen-9B),同时上架 ModelScope。
10. 局限与冷静视角
聊完亮点,泼几盆冷水,这很重要:
11. 总结:开源模型的「斩杀线」效应
MiMo-V2.6 的意义,不在于某一个榜单的第一名,而在于它把「开源模型的能力上限」和「成本地板」同时往下/往上推了一大截:
- 能力上:AA 综合智能指数开源第一(46.32),多项 Agent 基准逼近甚至反超闭源旗舰;
- 成本上:同等智能水平下价格是海外模型的 1/20~1/60,加量不加价;
- 生态上:MIT 协议 + 全套 RL 工具链 + 训练过程公开,把「如何训练出强模型」这件事从黑盒变成了可复现的工程。
当一个开源模型既能在能力上斩杀大多数选手、又能在价格上碾压所有对手时,它就成了一条新的「斩杀线」:能力低于它的产品越来越难被选择,价格高于它的产品则需要给出更充分的理由。
下一轮竞争,压力已经给到了闭源阵营和 DeepSeek 团队。而这,正是开源社区最想看到的局面。
12. 参考资料
- 小米官方发布页(EN):https://mimo.xiaomi.com/mimo-v2-6
- 小米官方新闻(CN):https://mimo.mi.com/docs/zh-CN/news/latest/v2-6
- 小米官方模型发布记录:https://mimo.mi.com/docs/zh-CN/updates/model
- 小米官方模型列表与限流说明:https://mimo.mi.com/docs/zh-CN/quick-start/summary/model
- 小米官方 API 文档(OpenAI 兼容):https://mimo.mi.com/docs/zh-CN/api/chat/openai-api
- 罗福莉与 MiMo-V2.6 深度报道(36氪 / APPSO):https://36kr.com/p/3993989416188937
- 36氪快讯:https://36kr.com/newsflashes/3993832090139400
- IT之家报道:https://m.ithome.com/html/1005496.htm
- AI/TLDR 模型速览:https://ai-tldr.dev/releases/xiaomi-mimo-v2-6/
- OpenLM.ai 模型页:https://openlm.ai/mimo-v2.6/
- PyTorchKR 技术讨论(架构细节):https://discuss.pytorch.kr/t/xiaomi-rl-1-02t-mimo-v2-6-1/11981
- Hugging Face 权重(XiaomiMiMo):https://huggingface.co/XiaomiMiMo
- 太平洋科技报道:http://m.toutiao.com/group/7688182139620033064/
- 每日经济新闻报道:http://m.toutiao.com/group/7688160723205227044/
本文数据与事实均来自上述公开来源,检索整理于 2026 年 9 月 22 日;榜单口径以各发布机构为准。