AI换脸原理讲解
AI换脸视频的制作本质上是基于深度学习框架下的特征空间映射与图像合成问题,其数学基础可追溯至流形学习与生成对抗网络的理论体系。在数据预处理阶段,设输入视频帧序列为V={vt}t=1TV=\\{v_t\\}_{t=1}^TV={vt}t=1T,通过人脸检测器fdet:RH×W×3→R4f_{det}: \\mathbb{R}^{H×W×3} \\rightarrow \\mathbb{R}^{4}fdet:RH×W×3→R4获取边界框坐标(x,y,w,h)(x,y,w,h)(x,y,w,h),进而利用关键点检测模型gland:Rcrop→R68×2g_{land}: \\mathbb{R}^{crop} \\rightarrow \\mathbb{R}^{68×2}gland:Rcrop→R68×2定位面部特征点{pk}k=168\\{p_k\\}_{k=1}^{68}{pk}k=168。基于Procrustes分析进行刚性对齐,求解最优相似变换矩阵T∗=argminT∑k=168∣∣T(pksrc)−pkdst∣∣22T^* = \\arg\\min_T \\sum_{k=1}^{68}||T(p_k^{src}) – p_k^{dst}||_2^2T∗=argminT∑k=168∣∣T(pksrc)−pkdst∣∣22,将源人脸与目标人脸投影至统一姿态空间。
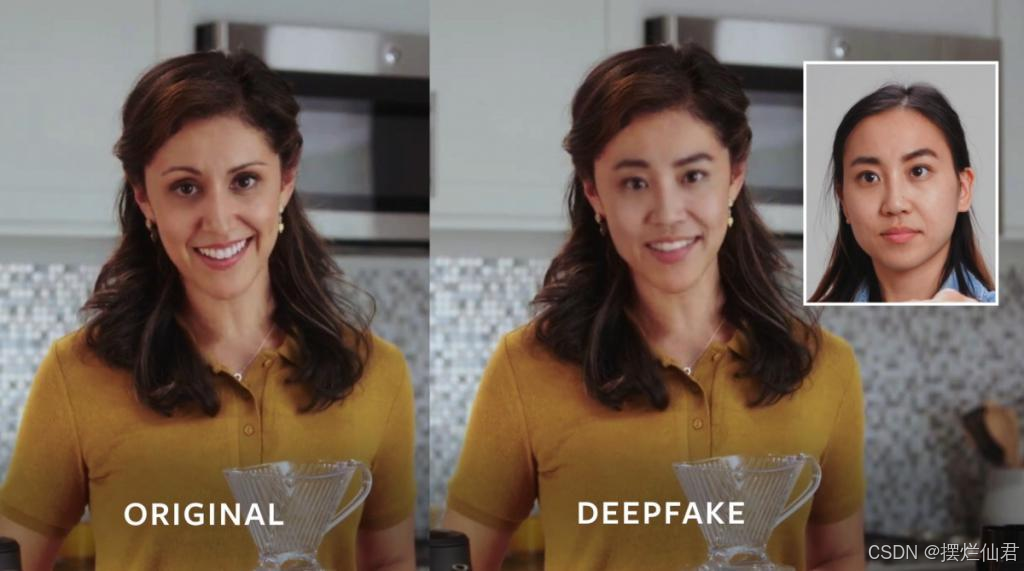
模型训练的核心在于构建双路编码器-解码器架构,其中编码器E:Rn×n×3→RdE: \\mathbb{R}^{n×n×3} \\rightarrow \\mathbb{R}^dE:Rn×n×3→Rd将输入图像映射到潜在空间z∈Rd\\mathbf{z} \\in \\mathbb{R}^dz∈Rd,解码器G:Rd→Rm×m×3G: \\mathbb{R}^d \\rightarrow \\mathbb{R}^{m×m×3}G:Rd→Rm×m×3通过反卷积操作重建人脸。对于源图像xsx_sxs与目标图像xtx_txt,其共享编码器需满足zs=E(xs)\\mathbf{z}_s = E(x_s)zs=E(xs)与zt=E(xt)\\mathbf{z}_t = E(x_t)zt=E(xt)的几何对齐约束。损失函数设计为多目标优化问题:
L=λrec∣∣G(E(x))−x∣∣1+λpercep∑l∣∣ϕl(G(E(x)))−ϕl(x)∣∣22+λadv[logD(x)+log(1−D(G(E(x))))]
\\mathcal{L} = \\lambda_{rec}||G(E(x)) – x||_1 + \\lambda_{percep} \\sum_{l} ||\\phi_l(G(E(x))) – \\phi_l(x)||_2^2 + \\lambda_{adv}[\\log D(x) + \\log(1 – D(G(E(x))))]
L=λrec∣∣G(E(x))−x∣∣1+λpercepl∑∣∣ϕl(G(E(x)))−ϕl(x)∣∣22+λadv[logD(x)+log(1−D(G(E(x))))]
其中ϕl\\phi_lϕl表示预训练VGG网络第lll层的特征响应,对抗损失项通过判别器DDD引导生成图像分布逼近真实数据分布。
当采用StyleGAN2的改进架构时,生成过程被建模为隐式神经表示G(w)=fθ(w)G(\\mathbf{w}) = f_\\theta(\\mathbf{w})G(w)=fθ(w), 其中潜在编码w∈W\\mathbf{w} \\in \\mathcal{W}w∈W空间通过映射网络M:Z→WM: \\mathcal{Z} \\rightarrow \\mathcal{W}M:Z→W学习解耦特征。风格迁移通过自适应实例归一化实现:
AdaIN(xi,w)=γwxi−μ(xi)σ(xi)+βw
\\text{AdaIN}(x_i, \\mathbf{w}) = \\gamma_\\mathbf{w} \\frac{x_i – \\mu(x_i)}{\\sigma(x_i)} + \\beta_\\mathbf{w}
AdaIN(xi,w)=γwσ(xi)xi−μ(xi)+βw
其中γw,βw\\gamma_\\mathbf{w}, \\beta_\\mathbf{w}γw,βw由w\\mathbf{w}w经全连接网络参数化,实现局部纹理的风格控制。
在图像融合阶段,设生成人脸区域为RgR_gRg,背景区域为RbR_bRb,泊松融合通过求解椭圆偏微分方程:
minf∬Ω∣∇f−∇g∣2dΩs.t.f∣∂Ω=b∣∂Ω
\\min_f \\iint_{\\Omega} |\\nabla f – \\nabla g|^2 d\\Omega \\quad \\text{s.t.} \\quad f|_{\\partial\\Omega} = b|_{\\partial\\Omega}
fmin∬Ω∣∇f−∇g∣2dΩs.t.f∣∂Ω=b∣∂Ω
其中ggg为生成区域的梯度场,bbb为背景图像。通过离散化得到线性系统Lf=vL\\mathbf{f} = \\mathbf{v}Lf=v(LLL为拉普拉斯矩阵),确保生成区域与背景的光照连续性。时序稳定性通过光流约束实现,设相邻帧光流场为Ft→t+1F_{t→t+1}Ft→t+1,则时序平滑损失为:
Ltemp=∑t=1T−1∣∣W(Ft→t+1,G(xt))−G(xt+1)∣∣1
\\mathcal{L}_{temp} = \\sum_{t=1}^{T-1} ||W(F_{t→t+1}, G(x_t)) – G(x_{t+1})||_1
Ltemp=t=1∑T−1∣∣W(Ft→t+1,G(xt))−G(xt+1)∣∣1
其中W(⋅)W(\\cdot)W(⋅)为双线性采样函数。最终通过超分辨率网络SSS实现从低分辨率生成结果y^L\\hat{y}_Ly^L到高分辨率输出y^H\\hat{y}_Hy^H的映射,其优化目标为:
minθEx,y[∥S(y^L)−yH∥1+λGANlog(1−DS(S(y^L)))]
\\min_\\theta \\mathbb{E}_{x,y}[\\|S(\\hat{y}_L) – y_H\\|_1 + \\lambda_{GAN}\\log(1 – D_S(S(\\hat{y}_L)))]
θminEx,y[∥S(y^L)−yH∥1+λGANlog(1−DS(S(y^L)))]
整个技术栈的数学完备性依赖于对微分流形、变分优化及概率生成模型的深度融合,其工程实现需要平衡数值稳定性与计算复杂度。值得注意的是,该领域的最新进展如扩散模型(Diffusion Models)已将生成过程重新参数化为随机微分方程:
dxt=f(xt,t)dt+g(t)dwt
d\\mathbf{x}_t = f(\\mathbf{x}_t,t)dt + g(t)d\\mathbf{w}_t
dxt=f(xt,t)dt+g(t)dwt
通过逆向过程逐步去噪实现更逼真的人脸合成,这为换脸技术提供了新的理论框架。
相关算法代码
以下将结合技术原理与关键代码段进行讲解(基于PyTorch框架的简化实现)。需注意完整实现涉及复杂工程细节,此处仅展示核心逻辑:
1. 数据预处理模块
import dlib
import cv2
import numpy as np
# 初始化dlib检测器
detector = dlib.get_frontal_face_detector()
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
def align_face(img):
# 人脸检测与关键点定位
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
rects = detector(gray, 1)
shape = predictor(gray, rects[0])
landmarks = np.array([[p.x, p.y] for p in shape.parts()])
# Procrustes对齐(核心数学运算)
src_points = landmarks[[36, 45, 33, 48, 54]] # 选取眼部、鼻尖、嘴角关键点
dst_points = predefined_standard_landmarks # 预定义的标准脸关键点
M, _ = cv2.estimateAffinePartial2D(src_points, dst_points)
aligned_face = cv2.warpAffine(img, M, (256, 256))
return aligned_face
2. 自编码器模型架构
import torch
import torch.nn as nn
from torchvision.models import vgg19
class FaceSwapAE(nn.Module):
def __init__(self):
super().__init__()
# 共享编码器
self.encoder = nn.Sequential(
nn.Conv2d(3, 64, 5, stride=2, padding=2),
nn.InstanceNorm2d(64),
nn.ReLU(),
# … 更多卷积层
)
# 目标解码器
self.decoder = nn.Sequential(
nn.ConvTranspose2d(512, 256, 4, stride=2, padding=1),
nn.InstanceNorm2d(256),
nn.ReLU(),
# … 更多反卷积层
)
# 感知损失网络(固定参数)
self.vgg = vgg19(pretrained=True).features[:16]
for param in self.vgg.parameters():
param.requires_grad = False
def forward(self, src_img, dst_img):
z_src = self.encoder(src_img)
z_dst = self.encoder(dst_img)
# 潜在空间插值
alpha = 0.7 # 融合系数
z_mix = alpha * z_dst + (1 – alpha) * z_src
# 生成换脸结果
gen_face = self.decoder(z_mix)
return gen_face
def perceptual_loss(self, gen, target):
# 计算VGG特征层差异
feat_gen = self.vgg(gen)
feat_real = self.vgg(target)
return nn.L1Loss()(feat_gen, feat_real)
3. 训练循环(关键损失计算)
model = FaceSwapAE()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)
gan_loss = nn.BCEWithLogitsLoss()
for epoch in range(100):
for src, dst in dataloader:
# 前向传播
gen = model(src, dst)
# 重建损失
l1_loss = nn.L1Loss()(gen, dst)
# 感知损失
percep_loss = model.perceptual_loss(gen, dst)
# 对抗损失(简化版判别器)
real_pred = torch.sigmoid(discriminator(dst)).mean()
fake_pred = torch.sigmoid(discriminator(gen.detach())).mean()
d_loss = gan_loss(real_pred, torch.ones_like(real_pred)) + \\
gan_loss(fake_pred, torch.zeros_like(fake_pred))
# 总损失
total_loss = 10*l1_loss + 0.1*percep_loss + 0.5*d_loss
# 反向传播
optimizer.zero_grad()
total_loss.backward()
optimizer.step()
4. 后处理融合(OpenCV实现)
def poisson_blending(foreground, background, mask):
# 计算混合梯度场
center = (background.shape[1]//2, background.shape[0]//2)
blended = cv2.seamlessClone(
foreground, background, mask, center,
cv2.MIXED_CLONE # 使用泊松方程求解
)
return blended
# 生成人脸掩模(UNet分割网络输出)
mask = model.segment(gen_face)
final_result = poisson_blending(gen_face, original_bg, mask)
免费开源网站
CSDN不允许当广告哎,自己上网搜吧(摊摊手~~)