(三):并发实战篇——错误处理与并发入门
前两篇我们打牢了地基,啃下了数据结构与接口。(前面两篇还没有学习的同学可以在我的专栏里先学习前两篇的内容) 现在,我们迎来了 Go 语言封神的两个核心:优雅的错误处理哲学,以及让无数大厂痴迷的并发编程(goroutine + channel)。收官之作,全是硬核干货!
十一、错误处理
Go 的错误处理跟别的语言完全不一样:没有 try-catch,错误是返回值。
result, err := doSomething()
if err != nil {
// 处理错误
return err
}
看着啰嗦?一开始我也觉得啰嗦,写多了才发现:这是 Go 的设计哲学——错误是值,不是异常。
为啥这么设计?因为 try-catch 会让错误处理代码和正常代码混在一起,控制流变得很难追踪。Go 的方式让你必须显式处理每一个错误,写出来的代码虽然啰嗦,但错误处理路径非常清晰。
error 接口
Go 标准库定义了一个 error 接口:
type error interface {
Error() string
}
就这么简单——只要你的类型实现了 Error() string 方法,它就是一个 error。Go 里几乎所有"错误"都是这个接口的实现。
创建错误
package main
import (
"errors"
"fmt"
)
func main() {
// 方式 1:errors.New(最简单的错误)
err1 := errors.New("出错了")
fmt.Println(err1) // 出错了
// 方式 2:fmt.Errorf(带格式化的错误,最常用)
name := "利威尔"
err2 := fmt.Errorf("用户 %s 不存在", name)
fmt.Println(err2) // 用户 利威尔 不存在
// 方式 3:自定义错误类型(可以携带更多信息)
type MyError struct {
Code int
Msg string
}
func (e *MyError) Error() string {
return fmt.Sprintf("错误码 %d: %s", e.Code, e.Msg)
}
err3 := &MyError{Code: 404, Msg: "页面没找到"}
fmt.Println(err3) // 错误码 404: 页面没找到
}
方式 3 的好处是自定义错误可以携带更多上下文信息(比如错误码、时间戳等),调用方可以根据这些信息做不同处理。
错误包装(Go 1.13+)
实际开发中,一个错误往往是从最底层一层层传上来的。传的时候,你想把底层错误"包"进新的错误里,方便追溯。Go 1.13 引入了错误包装:
package main
import (
"errors"
"fmt"
)
var ErrNotFound = errors.New("没找到")
func queryDB(name string) error {
// %w 是"包装",把底层错误塞进新错误里
return fmt.Errorf("数据库查询失败: %w", ErrNotFound)
}
func getUser(name string) error {
if err := queryDB(name); err != nil {
return fmt.Errorf("获取用户失败: %w", err)
}
return nil
}
func main() {
err := getUser("利威尔")
fmt.Println(err) // 获取用户失败: 数据库查询失败: 没找到
}
注意 %w 和 %v 的区别:
- %v:只把错误的字符串拼进去
- %w:把错误对象本身包进去,后面可以用 errors.Is/errors.As 拆开
错误判断:errors.Is 和 errors.As
拿到一个被包装过的错误,怎么判断它是不是某类错误?用 errors.Is:
package main
import (
"errors"
"fmt"
)
var ErrNotFound = errors.New("没找到")
func main() {
err := fmt.Errorf("查询失败: %w", ErrNotFound)
// 判断 err 链中是否有 ErrNotFound
if errors.Is(err, ErrNotFound) {
fmt.Println("是 NotFound 错误")
}
}
如果想提取错误链中某个具体类型,用 errors.As:
package main
import (
"errors"
"fmt"
)
type MyError struct {
Code int
Msg string
}
func (e *MyError) Error() string {
return fmt.Sprintf("错误码 %d: %s", e.Code, e.Msg)
}
func main() {
original := &MyError{Code: 404, Msg: "没找到"}
err := fmt.Errorf("包装: %w", original)
var target *MyError
if errors.As(err, &target) {
fmt.Println("错误码:", target.Code)
fmt.Println("消息:", target.Msg)
}
}
panic 和 recover:留给真正紧急的情况
Go 还有一套"恐慌 + 恢复"机制:panic 抛出严重错误,recover 接住。
package main
import "fmt"
func risky() {
defer func() {
if r := recover(); r != nil {
fmt.Println("救命:", r)
}
}()
panic("出大事了")
}
func main() {
risky()
fmt.Println("我没死")
}
但 Go 的哲学是:日常错误用 error,panic 只用于真正不可恢复的场景。
啥叫"真正不可恢复"?比如:
- 数组越界、空指针这类运行时错误
- 程序启动时发现关键配置缺失,没法继续跑
- 程序员写代码时留下 bug,触发不可能的状态
业务错误(用户不存在、参数非法、网络超时)不应该用 panic,应该用 error 返回。因为业务错误是预期的、可处理的;panic 是非预期的、不可挽回的。
panic 的传播路径:当前函数 → defer 函数 → 上层函数 → … → main → 程序崩溃。recover 必须在 defer 里调用,且只能在 panic 传播过程中生效。一旦 panic 完全传完,recover 就接不住了。
错误处理最佳实践
最后给你几条实战建议:
不要忽略错误:拿到 err 一定要处理,不能 _, _ := f() 这样丢。Go 编译器会提醒你没用 err,但有些场景(比如 _ = db.Ping())会绕过提醒,养成习惯。
错误往上抛:底层函数不用尝试"处理"所有错误,把错误包装后返回上层。错误处理的责任应该由最了解业务的地方承担。
main 里最后处理:把所有错误都往上抛,最后在 main 统一处理(打印日志、退出码等)。
错误信息要有上下文:错误信息应该告诉读者"在干啥的时候出错了",而不是只说"出错了"。比如 fmt.Errorf("查询用户 %s 失败: %w", name, err) 就比 errors.New("查询失败") 有用得多。
区分错误类型:用 errors.Is 判断错误类型做不同处理,用 errors.As 提取详细信息。避免简单的字符串匹配。
错误处理看着啰嗦,但它是 Go 工程化的基础。写 Go 代码,错误处理是基本功,别偷懒。
十二、并发入门 ★★★★ Go 的杀手锏
并发是 Go 的杀手锏,是它能火遍云原生时代的根本原因。
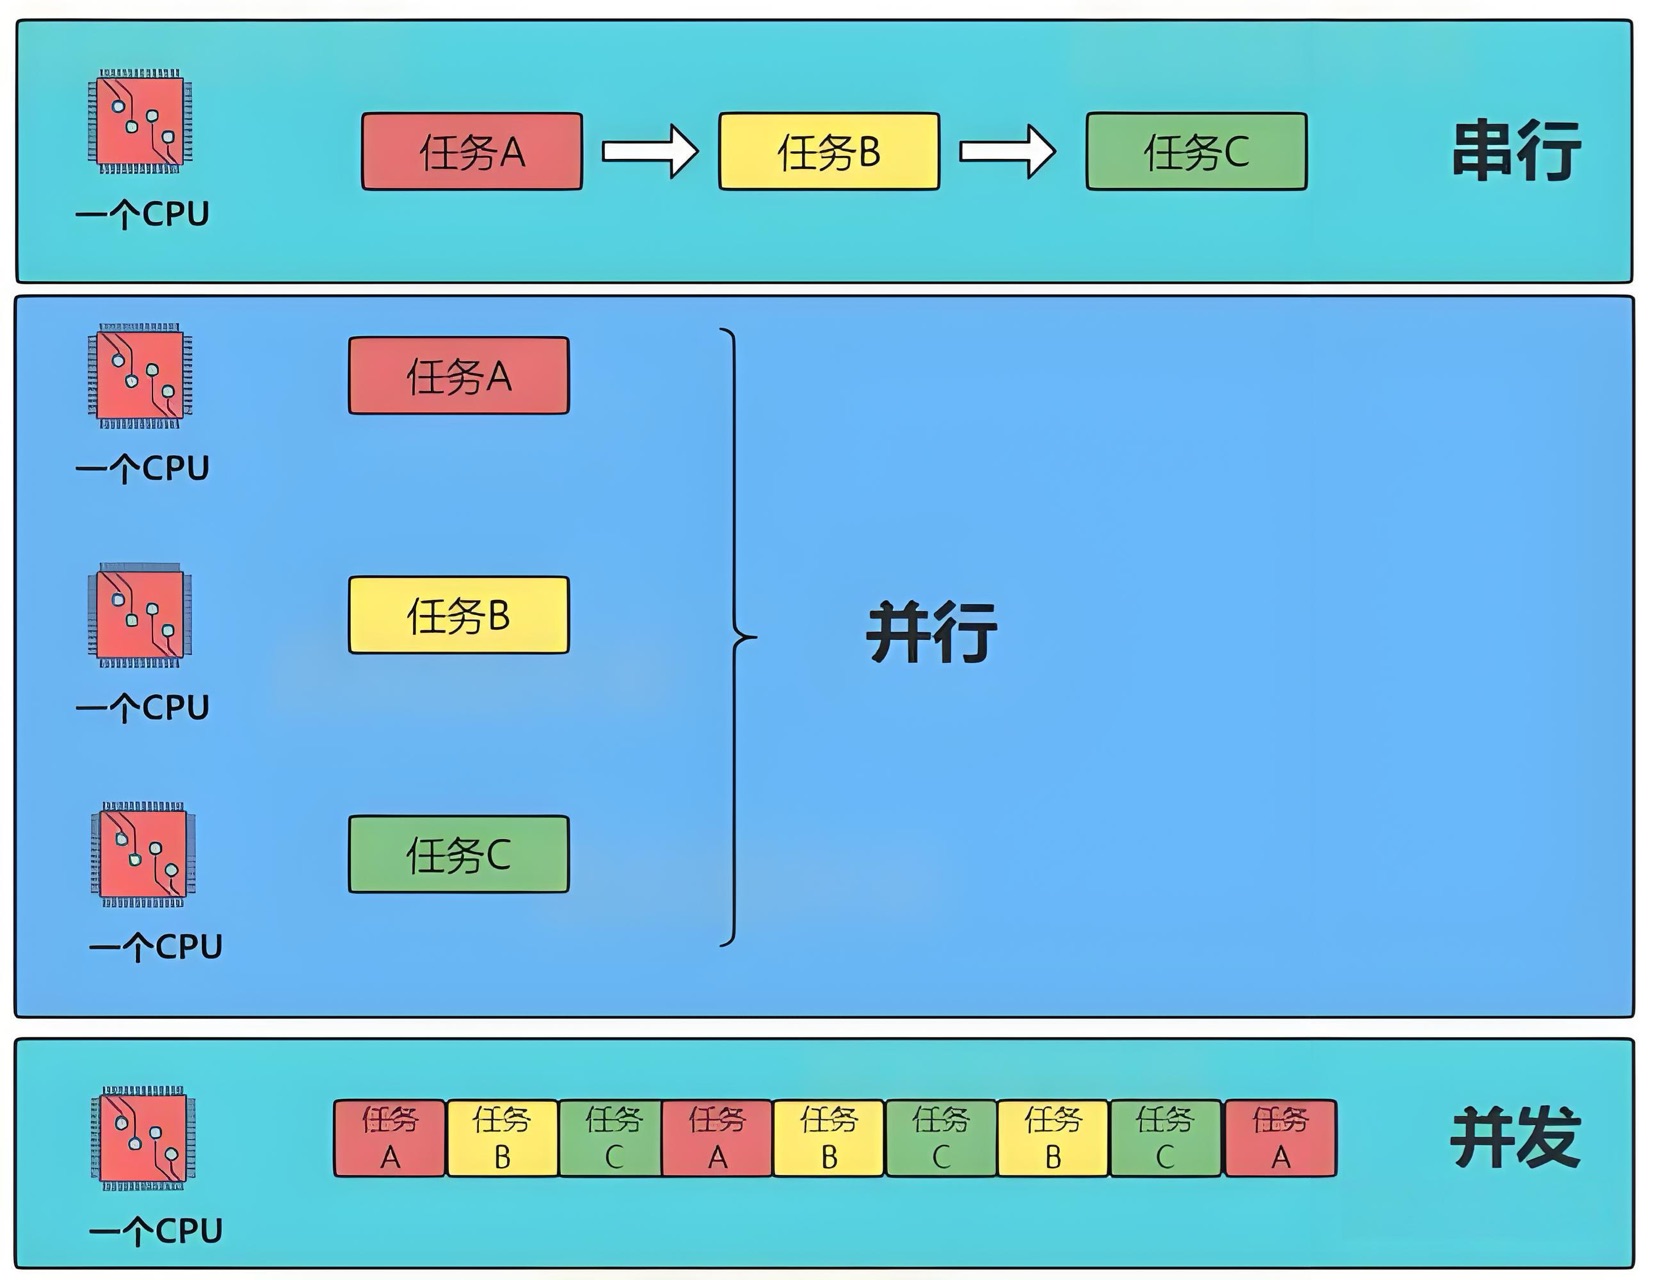
啥是并发?同时干多件事。比如你一边煮面,一边看手机——这就是并发(实际上是切换任务,但因为切换快,感觉是同时的)。在程序里,并发就是让多个任务"看起来同时"运行。
12.1 goroutine:轻量级并发
Go 里开启一个并发任务,一行代码搞定:
package main
import "fmt"
func say(s string) {
for i := 0; i < 3; i++ {
fmt.Println(s)
}
}
func main() {
go say("world") // 启动一个 goroutine
say("hello") // 主 goroutine 继续执行
}
加个 go 关键字,新任务就并发跑了。say("world") 在新 goroutine 里跑,say("hello") 在主 goroutine 里跑,两个任务并发执行。
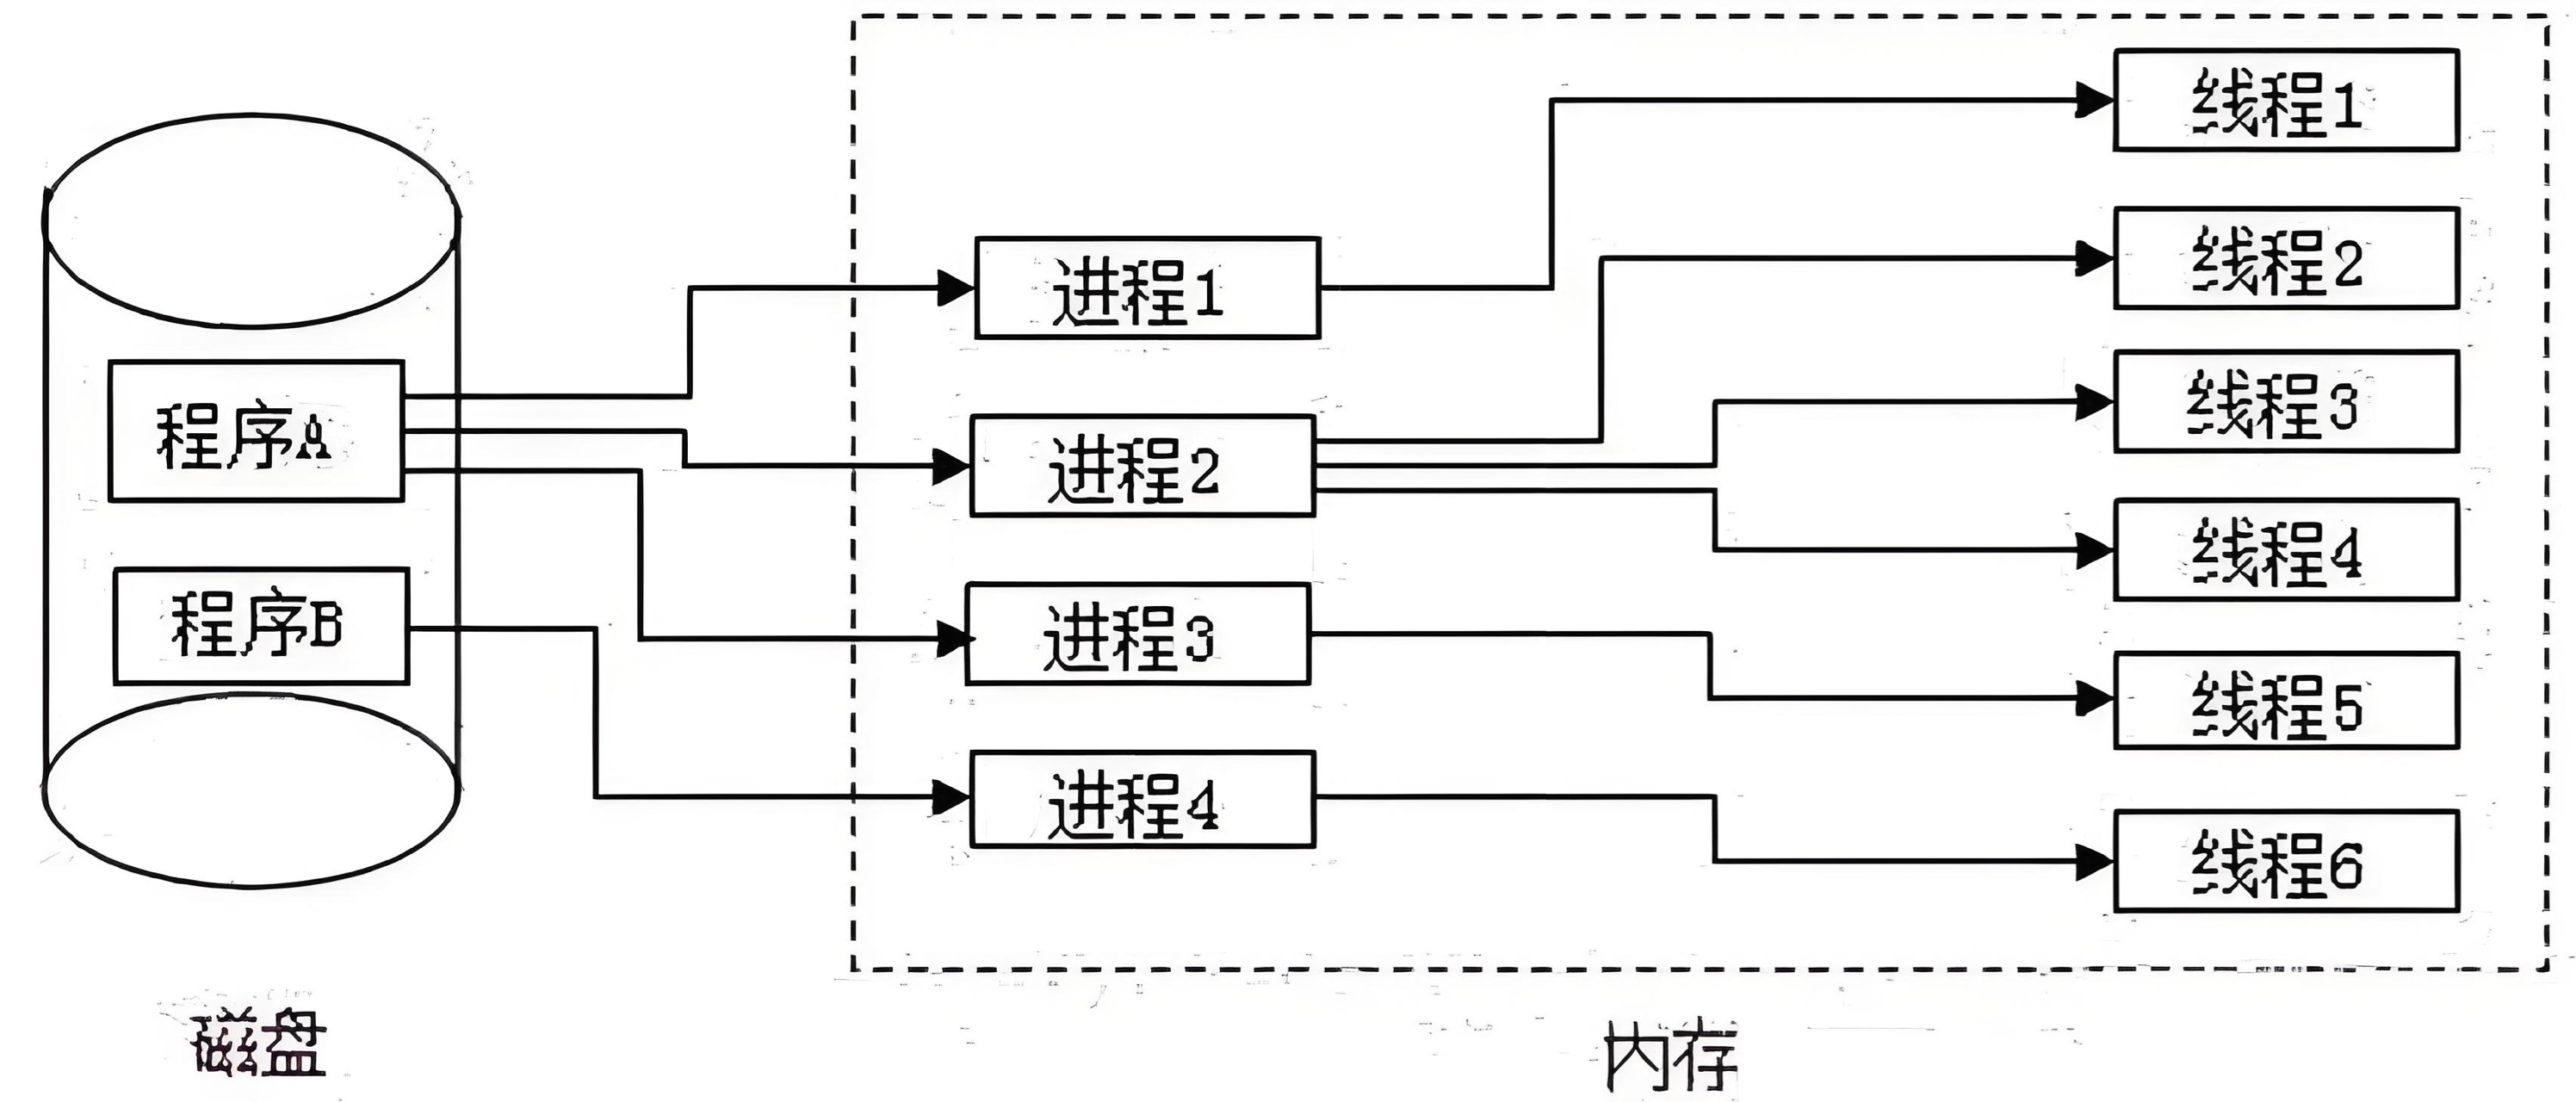
goroutine vs 线程:
| 调度方 | 操作系统 | Go 运行时 |
| 初始栈 | 1MB | 2KB |
| 切换开销 | 大(内核态) | 小(用户态) |
| 数量级 | 千级别 | 百万级别 |
为啥 goroutine 能这么轻?因为 Go 运行时在用户空间做了大量工作:动态栈增长(goroutine 栈不够时自动扩容)、工作偷取(空闲的处理器从别的处理器"偷"任务)、协作式调度(在函数调用时检查是否需要让出 CPU)。一个进程开几十万 goroutine 不是事儿,开几十万线程早就 OOM 了。
主 goroutine 退出 = 进程结束:
func main() {
go fmt.Println("我是子 goroutine")
// 主 goroutine 结束,子 goroutine 没机会执行
}
主 goroutine 一旦退出,整个进程就结束了,不管子 goroutine 跑没跑完。所以你得想办法等子 goroutine 跑完。最常见的办法是用 sync.WaitGroup:
package main
import (
"fmt"
"sync"
)
func worker(id int, wg *sync.WaitGroup) {
defer wg.Done() // 告诉 WaitGroup 这个任务完成了
fmt.Printf("worker %d done\\n", id)
}
func main() {
var wg sync.WaitGroup
for i := 0; i < 5; i++ {
wg.Add(1) // 告诉 WaitGroup 有一个新任务
go worker(i, &wg)
}
wg.Wait() // 等所有任务完成
fmt.Println("所有 worker 跑完了")
}
Add 加计数,Done 减计数,Wait 阻塞到计数为 0。这是 Go 并发的基本模式之一,记住它。
12.2 channel:goroutine 之间的通信管道
为啥需要 channel?因为 goroutine 之间要"说话"得有个介质——这就是 channel。你可以把它理解为"两个 goroutine 之间的一根水管"。一端灌水(发送),另一端出水(接收)。
package main
import "fmt"
func main() {
ch := make(chan int) // 创建一个 int 类型的 channel
go func() {
ch <- 42 // 发送数据
}()
result := <-ch // 接收数据
fmt.Println(result) // 42
}
没有 channel 的话,goroutine 之间没法通信——它们各自跑各自的,谁也不知道谁在干啥。有了 channel,它们就能协调工作了。
Go 的并发哲学:"不要通过共享内存来通信,而要通过通信来共享内存。"听着绕口对吧?翻译一下就是:
- 不要:多个 goroutine 都改同一个变量(用锁保证安全)
- 要:goroutine 之间通过 channel 传消息,避免直接共享数据

为啥?因为共享内存需要加锁,锁用错了就出 bug。channel 是无锁的,天然线程安全。
无缓冲 vs 有缓冲:
// 无缓冲 channel:发送和接收必须同时准备好(手对手交接)
ch1 := make(chan int)
// 有缓冲 channel:缓冲区满才阻塞(带仓库的水管)
ch2 := make(chan int, 3)
ch2 <- 1 // 不阻塞,缓冲区有空位
ch2 <- 2 // 不阻塞
ch2 <- 3 // 不阻塞
ch2 <- 4 // 阻塞!缓冲区满了
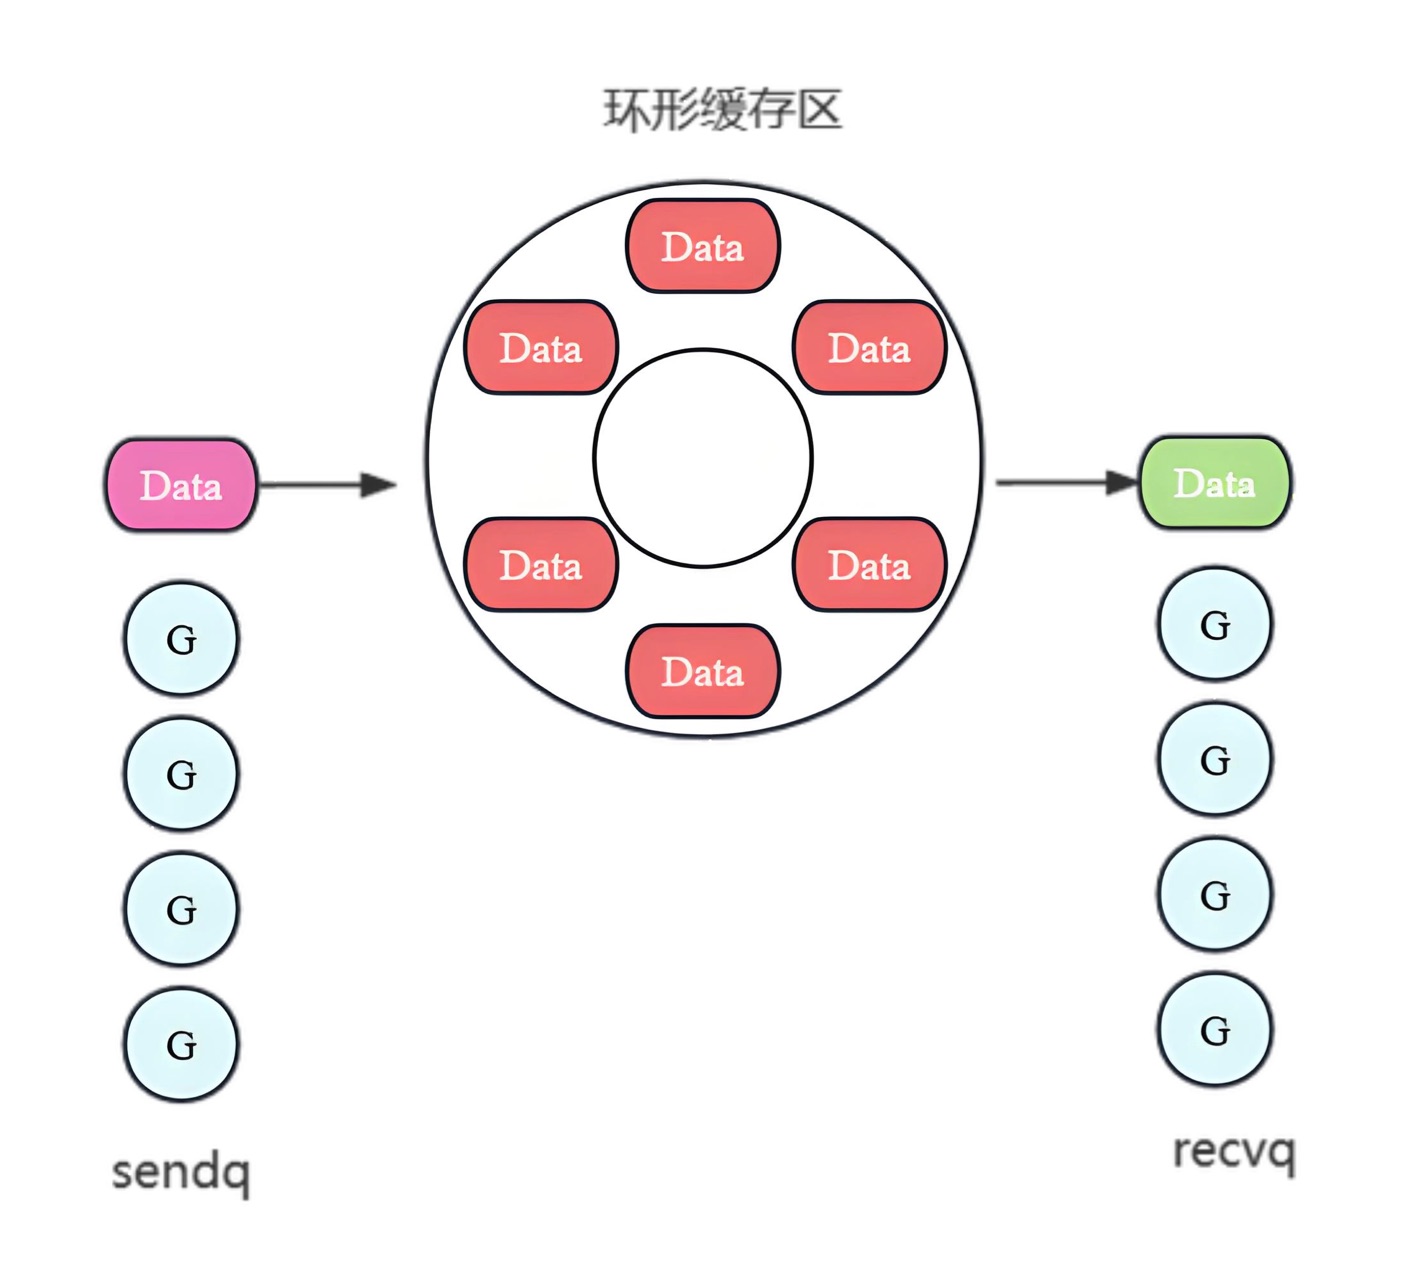
无缓冲 channel 是同步的——发送方发完得等接收方拿才能继续。像两个人面对面交接文件:你得把文件递到我手里,我拿了,你才能松手。如果你还没递呢我就伸手拿,就卡那了。
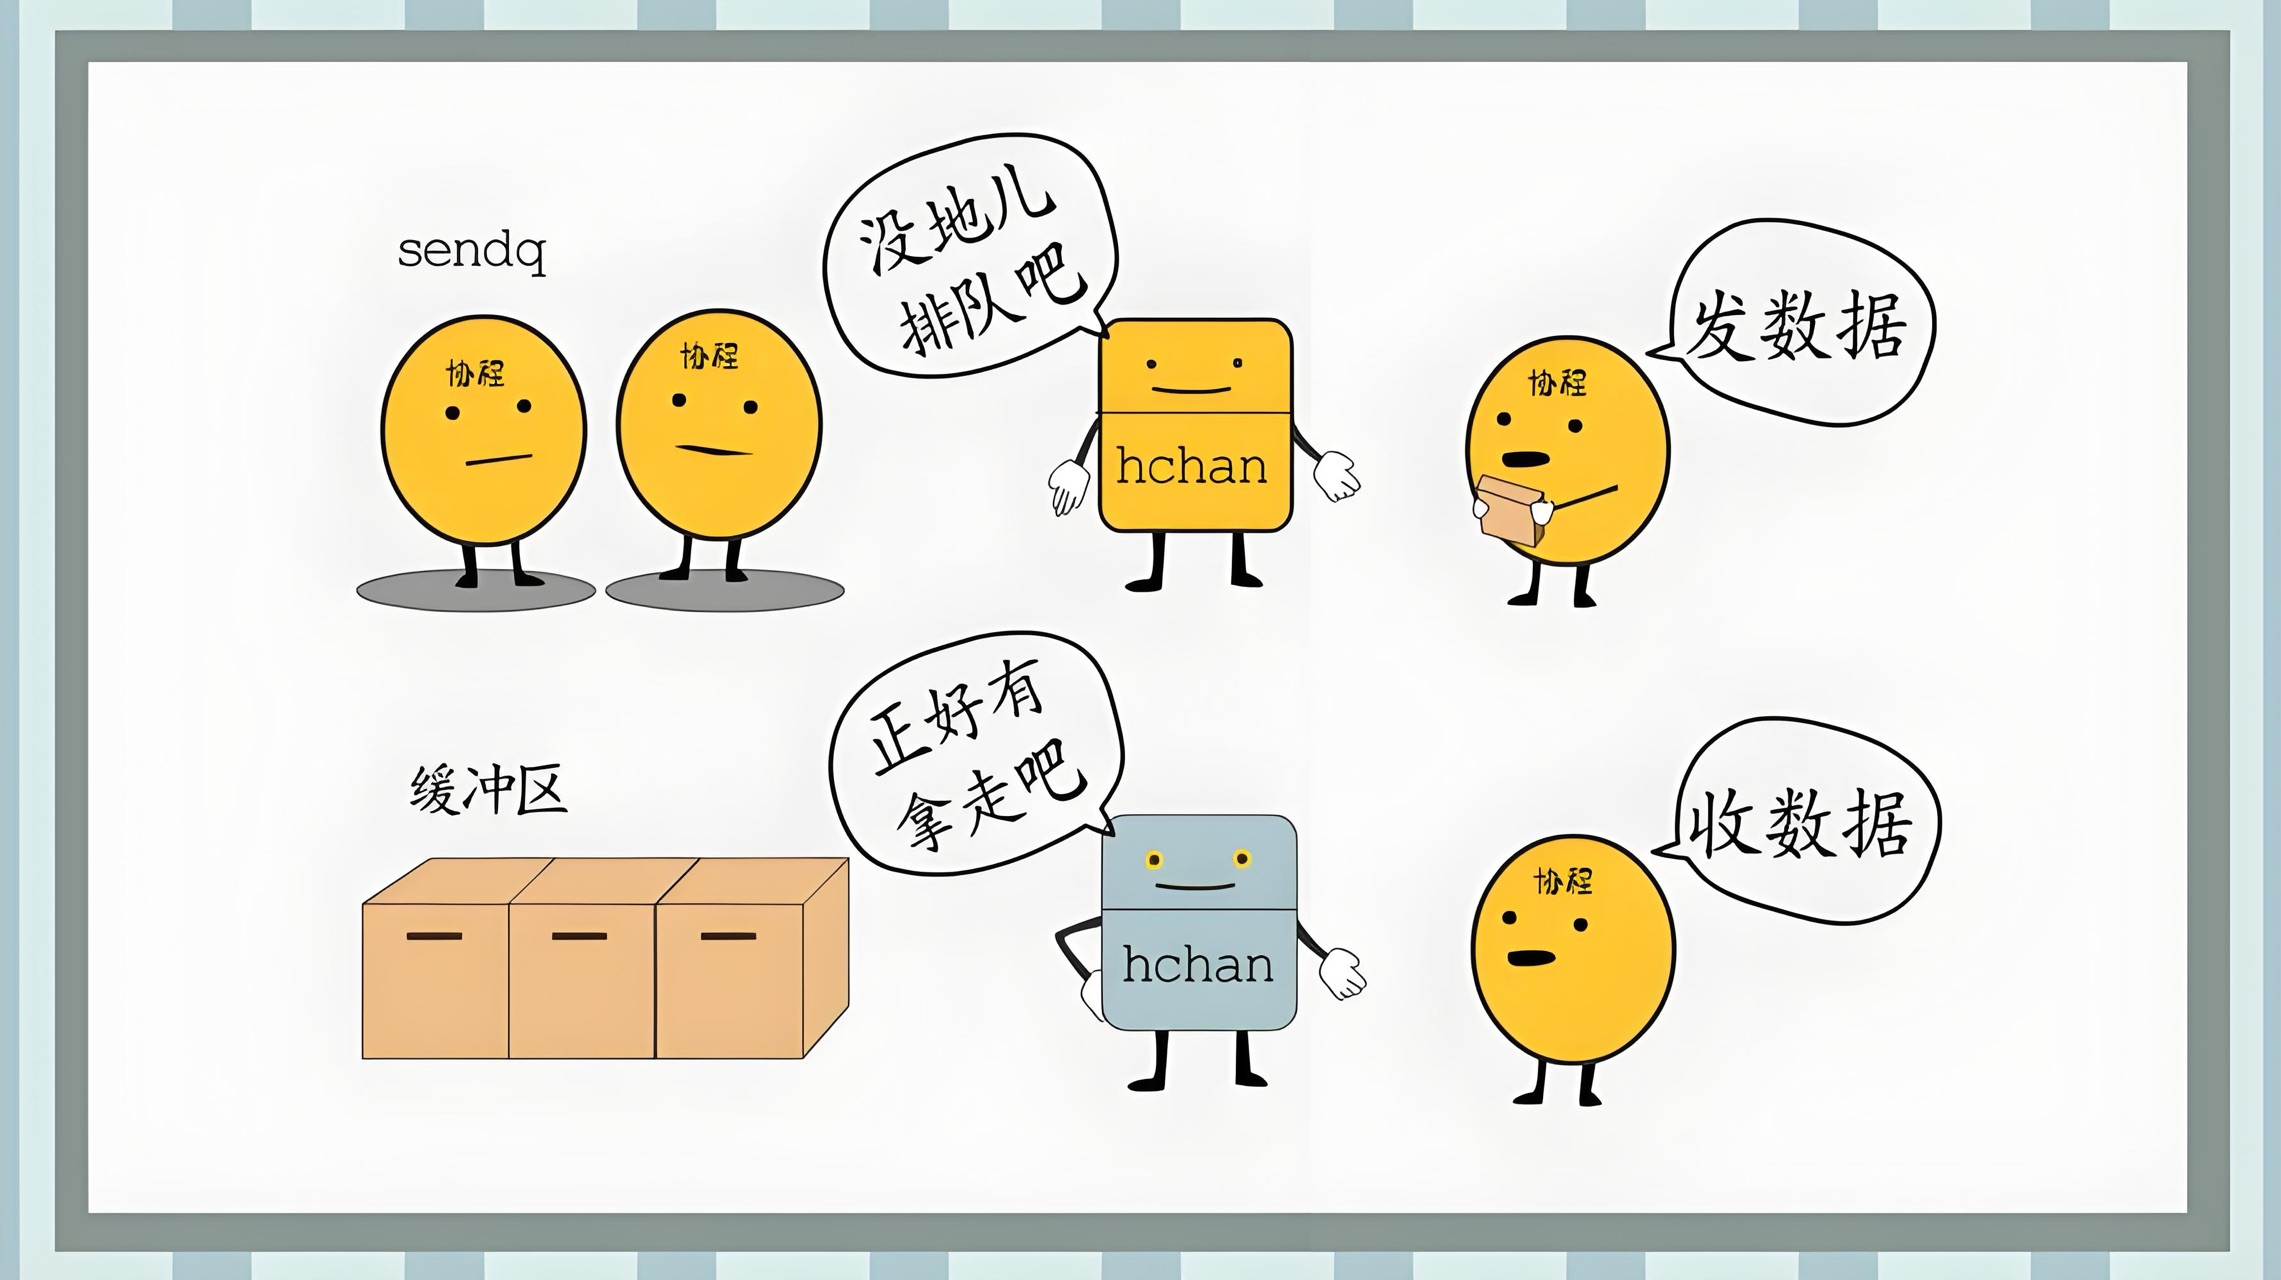
有缓冲 channel 是异步的——发完直接走,不管有没有人接。像往邮箱里塞信:你把信塞进邮箱就走了,邮箱空了也没事,下次有人来收。邮箱满了才塞不进去。
顺便一提,channel是这种环形缓存区:
关闭 channel:
发送方负责关闭 channel,接收方用 v, ok := <-ch 检测是否关闭:
package main
import "fmt"
func main() {
ch := make(chan int, 3)
ch <- 1
ch <- 2
close(ch) // 关闭 channel
// 用 range 遍历会自动检测关闭
for v := range ch {
fmt.Println(v) // 1 2
}
// 也可以单独判断
v, ok := <-ch
if !ok {
fmt.Println("channel 已关闭,没数据了")
} else {
fmt.Println("还收到:", v)
}
}
注意三条规则:
- 不要向已关闭的 channel 发送数据,会 panic
- 不要重复关闭 channel,也会 panic
- 关闭 channel 不是必须的,如果你能确定不会有 goroutine 还在等数据,关闭是好的实践
12.3 select:多路复用的抢答器
如果一个 goroutine 要同时等多个 channel,用 select。它像抢答器——多个 case 同时等着,哪个先好就执行哪个。
package main
import (
"fmt"
"time"
)
func main() {
ch1 := make(chan string)
ch2 := make(chan string)
go func() {
time.Sleep(1 * time.Second)
ch1 <- "来自 ch1"
}()
go func() {
time.Sleep(2 * time.Second)
ch2 <- "来自 ch2"
}()
select {
case msg := <-ch1:
fmt.Println(msg)
case msg := <-ch2:
fmt.Println(msg)
case <-time.After(3 * time.Second):
fmt.Println("超时了")
}
// 1 秒后 ch1 有数据,打印"来自 ch1"
}
time.After 返回一个 channel,一段时间后会发送一个值。这个用法在超时控制里特别常见。
select 还有个 default 分支,用于"非阻塞"操作:
select {
case msg := <-ch:
fmt.Println("收到:", msg)
default:
fmt.Println("channel 空着,没消息")
}
加了 default 之后,如果 channel 里没数据,select 不会阻塞,直接走 default 分支。
12.4 并发安全基础
并发最大的坑:竞态条件(race condition)。
package main
import (
"fmt"
"sync"
)
var count int
func main() {
var wg sync.WaitGroup
for i := 0; i < 1000; i++ {
wg.Add(1)
go func() {
defer wg.Done()
count++ // 看似一行,其实是"读-改-写"三步
}()
}
wg.Wait()
fmt.Println("count =", count) // 不是 1000!可能是 987、992 等等
}
count++ 看似一行,其实是三步:读 count、加 1、写回 count。两个 goroutine 同时执行这三步,就会出问题:两个都读到 100,都加 1,都写回 101,结果应该是 102 实际是 101——少加了一次。
解决方案 1:加互斥锁
package main
import (
"fmt"
"sync"
)
var (
mu sync.Mutex
count int
)
func increment() {
mu.Lock()
defer mu.Unlock()
count++
}
func main() {
var wg sync.WaitGroup
for i := 0; i < 1000; i++ {
wg.Add(1)
go func() {
defer wg.Done()
increment()
}()
}
wg.Wait()
fmt.Println("count =", count) // 一定是 1000
}
互斥锁的原理很简单:拿不到锁就等,拿到锁才能进,出来就释放锁。
解决方案 2:用 channel 串行化
package main
import (
"fmt"
"sync"
)
func main() {
ch := make(chan int, 1)
ch <- 0 // 初始化
var wg sync.WaitGroup
for i := 0; i < 1000; i++ {
wg.Add(1)
go func() {
defer wg.Done()
v := <-ch // 取出
v++
ch <- v // 放回
}()
}
wg.Wait()
fmt.Println("count =", <-ch) // 一定是 1000
}
这里 channel 充当了"互斥锁"的角色——同一时刻只有一个 goroutine 能拿到数据。这种模式叫串行化 goroutine。
实际开发中,加锁更常用。channel 适合"传递数据",锁适合"保护共享状态"。
12.5 检测竞态:go run -race
Go 自带竞态检测器,加 -race 参数就能开启:
go run -race main.go
开启后,程序会监控所有共享变量的读写,一旦发现竞态就打印警告。强烈建议:所有并发代码都用 -race 跑一遍测试。
go test -race ./...
go build -race -o myapp
生产环境也可以用 -race 编译的二进制,代价是性能会下降 2-20 倍,但能帮你抓到绝大多数竞态 bug。
12.6 并发小实战:并发爬虫
光说不练假把式,咱们写个简单的并发爬虫看看:
package main
import (
"fmt"
"sync"
"time"
)
// 模拟爬取一个 URL
func fetch(url string) string {
time.Sleep(100 * time.Millisecond) // 模拟网络请求
return fmt.Sprintf("内容 from %s", url)
}
func main() {
urls := []string{
"https://a.com",
"https://b.com",
"https://c.com",
"https://d.com",
"https://e.com",
}
// 串行爬取
start := time.Now()
for _, url := range urls {
result := fetch(url)
fmt.Println(result)
}
fmt.Printf("串行耗时: %v\\n", time.Since(start))
// 并发爬取
start = time.Now()
var wg sync.WaitGroup
for _, url := range urls {
wg.Add(1)
go func(u string) {
defer wg.Done()
result := fetch(u)
fmt.Println(result)
}(url)
}
wg.Wait()
fmt.Printf("并发耗时: %v\\n", time.Since(start))
}
5 个 URL,每个模拟 100ms 请求。串行需要约 500ms,并发只需要约 100ms。差距非常明显——这就是并发的威力。
12.7 并发总结口诀
最后送你这几条口诀,记住它们,并发基本不会翻车:
- goroutine 用 go 启动,轻量但别乱开(百万级也得考虑资源)
- channel 是 goroutine 之间的"水管"
- 无缓冲 = 同步(手对手交接),有缓冲 = 异步(带仓库)
- 关闭 channel 只能由发送方做
- select 多路复用,谁先好谁先动,加 default 不阻塞
- 共享变量必须加锁或用 channel 串行化
- 调试加 -race,并发必备
并发这块内容多,写起来也容易出 bug。建议你多写几个小程序练手:并发打印、并发计数器、并发下载器,把这些基础模式玩熟,后面学 GMP 调度、context 这些高级特性就轻松多了。
十三、总结
到这里,Go 的基础部分就讲完了。我们过了一遍:
- 变量:程序的地基砖块,三种声明方式,零值机制
- 流程控制:if、for、switch 三件套
- 函数:乐高积木,多返回值,可变参数,闭包,defer
- 切片:Go 的精髓,ptr+len+cap 三要素,append 扩容,共享底层数组的坑
- Map:键值对字典,哈希桶结构,并发不安全要加锁
- 结构体:字段集合,组合代替继承,Tag 配序列化
- 接口:Go 的灵魂,隐式实现,鸭子类型
- 错误处理:error 返回值,errors.Is/As,panic/recover 留给紧急情况
- 并发入门:goroutine 轻量并发,channel 通信,select 多路复用,竞态条件与锁
速记口诀:变量函数流程,切片 Map 结构,接口错误并发,九大模块全通。
学习建议:
- 不要背 API,多写代码。Go 的语法不算多,但细节多,光看记不住。
- 刷 LeetCode 简单题巩固语法。推荐用 Go 刷算法题,一举两得。
- 推荐书:《Go 语言圣经》(网络上有免费的中文版)、《Go 高级编程》。
- 练手项目:写一个并发爬虫、简易 HTTP 服务器、命令行小工具。这些小项目能把上面的知识点串起来。
Go 的基础看着简单,但细节多。这篇文章覆盖的内容足够你应付 80% 的日常开发了。后续想进阶的话,可以学:
- GMP 调度模型:深入理解 goroutine 的底层调度
- 内存管理:逃逸分析、GC 三色标记
- 接口底层:eface 和 iface 的内存结构
- Map 底层:负载因子、渐进式扩容、红黑树
如果有http后端开发基础的同学可以尝试用go语言实现一个简单的项目了,比如我在大一写的这款聊天室项目,可以直接在我的GitHub仓库里找到源代码:

到这里,《万字详解 | Go 基础从入门到入土》这个连载系列就全部完结了。从变量到并发,感谢你陪我走完这段旅程。
我是利威尔xu,CSDN 的新人博主。文章里要是有错误或者讲得不到位的地方,欢迎评论区拍砖。觉得有帮助的话,三连支持一下——点赞、收藏、关注。下一篇我会写 Go 进阶的内容,敬请期待。


