AI视频的多元化之言:
2026 年 7 月底,视频生成这条赛道突然裂了一道缝。
MiniMax 把 H3 的权重甩上了 HuggingFace——330 亿参数、2K / 15 秒、原生立体声、一次推理同时出画面和声音,而本地跑起来的门槛,是一张 12GB 显存的消费卡。
对面站着字节的 Seedance 2.0:闭源、API、4K 分镜稳、音画联合生成成熟,是过去一年里很多人眼里的“视频生成天花板”。
一边是把模型文件塞进自己机箱里随便改的开源新王,一边是只肯在云端递结果的闭源旗舰。
问题不再是“谁榜单分高”,而是——2026 年做 AI 视频的人,到底该把如何自如的、融合的、低成本化的应用在AI视频商业上?
1:MiniMax H3:开源登场
1.1 H3参数的核心解析:
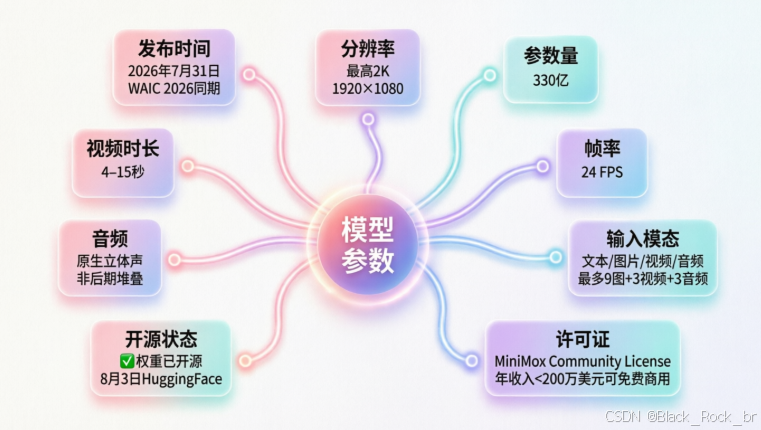
1.2H3 架构深潜:四个关键技术突破与工程实现
上下文全模态表示(Contextual Omni Representation)
H3 采用多模态压缩编码方案,将原始输入素材(图像、视频、音频,总量约 100K token)映射为约 4K token 的紧凑语言表征。
该表征作为跨模态对齐的桥梁,使模型能够解析并执行涉及多源素材的复合指令。例如,用户指令"采用参考视频1的运镜方式、图2的人物形象、音频3的声线特征"可被准确解构并执行,其底层依赖的是语言空间中对各模态语义关系的形式化描述。
H3-VAE:4× 序列压缩
基于重建优化的变分自编码器(VAE)Tokenizer,在保持重建质量的前提下实现 4 倍序列长度压缩。
收益:
-
有效上下文窗口扩展 4 倍
-
训练与推理的计算开销显著降低
-
为 2K 帧长视频生成提供序列长度基础
H3-Omni Transformer:解耦式架构设计
采用理解与生成计算分离的架构策略:
表格
| 序列长度方差容忍 | 提升 3× |
| 训练吞吐 | 提升 ~30% |
通过解耦两类计算的调度粒度,降低长序列场景下的资源争抢与显存波动。
In-Context Regeneration(ICR):迭代式细节重建
2K 长视频生成不依赖传统后处理超分模块,而采用上下文内的自回归精修机制:
初稿生成:输出低分辨率中间结果
上下文重建:模型在完整上下文中对初稿进行二次生成
细节保真:文字、标识、发丝等高保真要素通过迭代重建恢复,避免超分引入的伪影与语义漂移
根据 Artificial Analysis 独立评测榜单(2026 年 8 月 1 日更新),H3 在多个视频生成维度上的排名如下:
表格
| Video Editing(视频编辑) | 第 1 名 |
| Text-to-Video(文生视频) | 第 2 名 |
| Image-to-Video(图生视频) | 第 3 名 |
注: 该榜单将开源与闭源模型纳入同一评测体系。H3 作为开源方案,在上述维度中进入前三,表现值得关注。
2:Seedance 2.0 的闭源哲学与架构优势
2.1参数的维度解析:
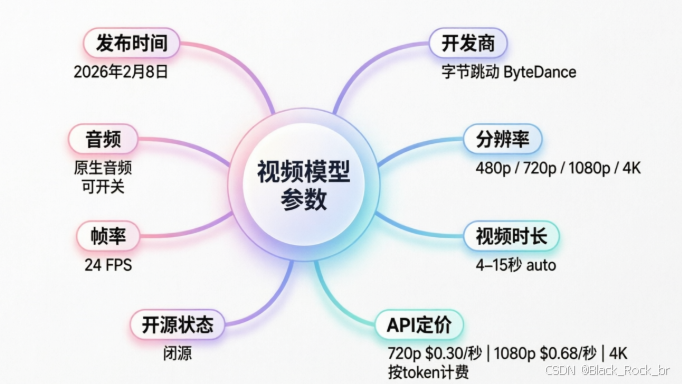
2.2拆解 Seedance 2.0 工业级视频生成优势
分辨率上限:交付规格的差异
MiniMax H3 的输出上限为 2K(2048×1080),而 Seedance 2.0 支持 4K(3840×2160) 原生渲染。在影视母版、线下大屏投放及电商高码率详情页场景中,4K 像素量是 2K 的 4 倍,属于硬性交付指标。这是目前闭源旗舰在输出端保持代差的核心优势。
多镜头叙事:时序控制的稳定性
Seedance 2.0 支持基于时间戳的分镜式 Prompt 注入。例如:
[0–3s] Aerial shot of neon cityscape → [3–6s] Crane down to street singer → [6–10s] Close-up, bokeh background。
其底层调度器能在单次推理中维持角色 ID 与场景光照的一致性。相比之下,H3 在跨分镜的长时序生成中,偶发出现角色特征漂移(Identity Drift)与光影跳变,需依赖后处理修复。
确定性生成:Seed Control
Seedance 2.0 暴露了 Random Seed 参数,支持通过固定随机种子实现像素级复现(Deterministic Generation)。这对工业化流水线至关重要:支持批量素材的 AB 测试、局部重绘(Inpainting)衔接以及故障回滚。H3 当前未开放该底层参数,生成结果具备不可复现性。
2.3 闭源路径的成本与约束
-
部署隔离:模型权重未开放,推理必须在字节云端完成,数据需经公网上传,无法满足本地私有化部署需求。
-
推理成本:按量计费模式下,1080p 视频生成成本为 $0.68/s。折算一条 15 秒成片,单条成本约为 $10.2(≈¥73),显著高于 H3 的本地推理边际成本(趋近电费)。
2026 AI 视频选型决策树:H3 还是 Seedance 2.0?
核心原则:不谈“谁更强”,只谈“谁更适合”。
1. 先看“交付规格”:4K 是分水岭
这是最硬的一刀,没有妥协空间。
-
必须 4K(影视母版 / 线下大屏 / 高端电商主图)
→ 选 Seedance 2.0。
H3 的物理上限是 2K,超分算法无法弥补原生像素的缺失。Seedance 2.0 是目前少数能稳定输出 4K 且保持多镜头一致性的闭源方案。
-
2K 或以下(短视频平台 / 信息流 / 预览稿 / 内部Demo)
→ 优先 MiniMax H3。
2K 是 H3 的甜点位,配合本地部署,成本几乎为零。
2. 再看“数据主权”:能不能上云
这是很多 B 端业务的红线。
-
数据敏感(私有化部署 / 内网隔离 / 合规要求)
→ 选 MiniMax H3。
Seedance 2.0 必须上传云端,数据路径不可控。H3 权重开源,可部署在完全离线的环境(如本地服务器、内网 GPU 集群)。
-
数据公开(营销素材 / 公开内容 / 非敏感素材)
→ 两者皆可,进入下一轮筛选。
此时重点考量成本与可控性。
3. 接着看“量产需求”:要不要复现
这是工业化流水线的核心痛点。
-
需要批量生产、AB 测试、局部重绘(Inpainting)
→ 选 Seedance 2.0。
只有 Seedance 2.0 开放了 Seed Control(随机种子),能保证同一组参数下的结果高度一致。这对于广告素材迭代、角色一致性维护至关重要。
-
单次生成、允许随机性(创意探索 / 概念验证)
→ 优先 MiniMax H3。
H3 目前无 Seed 参数,每次生成都是“开盲盒”,适合创意发散,不适合标准化量产。
4. 最后看“成本账”:边际成本 vs 固定成本
这是商业决策的最后一道门槛。
-
预算充足,追求极致画质与稳定
→ 选 Seedance 2.0。
按量计费($0.68/s),一条 15 秒视频约 $10。适合客单价高、对品质要求苛刻的项目(如汽车广告、大制作短剧)。
-
预算敏感,追求高频迭代
→ 选 MiniMax H3。
本地推理边际成本趋近于零(仅电费)。适合 MVP 验证、中小商家素材、教育内容、个人创作者。
5. 特殊场景:混合路由策略(进阶玩法)
对于复杂项目,不必二选一,可以组合使用:
创意探索期:用 MiniMax H3 在本地快速试错,低成本验证 Prompt、分镜逻辑和构图。
关键素材生产:确定方案后,将精选 Prompt 和参考帧提交给 Seedance 2.0,利用其 4K 能力和 Seed Control 进行最终成片渲染。
后期处理:利用 H3 的开源特性,微调模型以适应特定品牌风格(如 Logo 颜色、特定运镜),再用 Seedance 2.0 进行高分辨率输出。
决策速查表(Cheat Sheet)
|
影视广告 / 大屏展示 |
Seedance 2.0 |
唯一稳定支持 4K 的选项 |
|
电商详情页主图 |
Seedance 2.0 |
4K 画质 + 多镜头稳定性 |
|
短视频平台内容 |
MiniMax H3 |
2K 足够,本地跑成本极低 |
|
企业内网 / 私有化 |
MiniMax H3 |
数据不出域,权重可控 |
|
广告素材 AB 测试 |
Seedance 2.0 |
Seed Control 保证结果可复现 |
|
个人创作 / 学习 |
MiniMax H3 |
免费(除电费),无 API 焦虑 |
|
短剧批量生产 |
混合策略 |
H3 打样 + Seedance 2.0 定稿 |
3:ComfyUI + H3,让 12GB 显存部署实录
3.1ComfyUI?H3 本地部署的工具链解析
ComfyUI 是当前 AI 视频生成领域较为成熟的本地工作流前端之一。
核心特性:
-
节点式工作流:通过可视化拖拽搭建生成管线,降低使用门槛
-
动态显存管理:支持显存受限环境下运行较大规模模型
-
模型生态兼容:原生接入 MiniMax H3、Wan 2.2、LTX-Video、HunyuanVideo 等主流视频生成模型
-
社区资源丰富:工作流模板可复用,便于快速上手
3.2 硬件的匹配
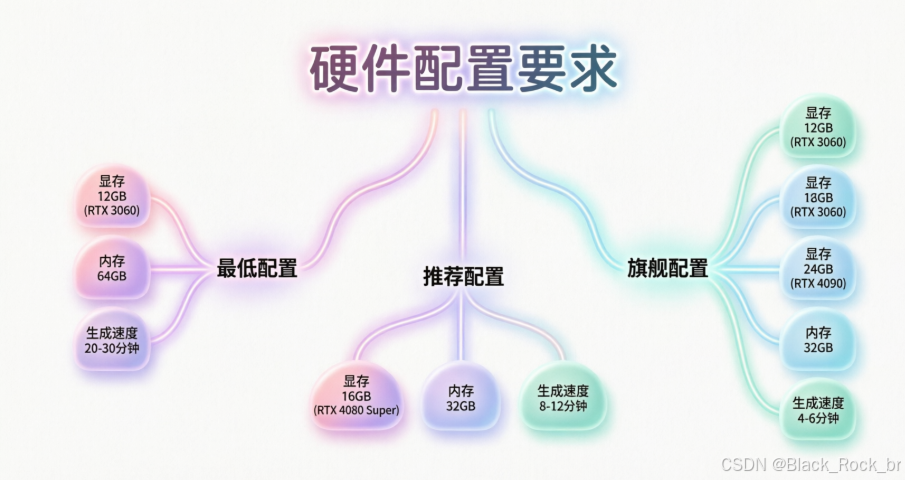
存储与内存优化明细
-
全精度占用:123.6 GB(需多卡集群或大内存服务器)。
-
Int8量化后:仅42.5 GB,压缩比达3:1,显存门槛直降三分之二。
-
分片策略:模型以4个分片形式分发,单分片约10.6 GB,便于并行加载与断点续传,总占用稳定在42.5 GB。
3.3 三步走通 ComfyUI + H3:从环境配置到首帧生成的实操路径
很多人卡在第一步,其实就三件事:
第一,版本要对。 别用老教程里的旧版 ComfyUI,H3 需要 0.30.0 以上的新前端支持。克隆主分支,装 requirements.txt,一步到位。
第二,模型要对。 别去 MiniMax 官方 HF 找原始权重,那是给 Transformers 用的。做视频要去 Comfy-Org/MiniMax-H3 下载 ComfyUI 专用封装版,扔进 models/diffusion_models 里。显存只有 12GB 的,别头铁下 FP16,直接拿 Q4_K_M.gguf,这是能跑起来的底线。
第三,工作流要对。 不用自己连节点,ComfyUI 已经内置了 video_minimax_h3_*.json 模板。拖进去,选对模型路径,改几个参数就能跑。如果卡住,先看显存占用,再看 VAE 是不是没开 Tiled。
3.4常见问题一览:
问题一:显存不足(CUDA out of memory)
现象: 运行时报显存溢出错误。
排查与解决:
-
启动参数添加 –lowvram 或 –novram
-
ComfyUI 会自动将部分计算负载卸载至系统内存,缓解显存压力
问题二:生成速度过慢
可能原因: 未启用模型量化。
排查与解决:
-
下载 FP8 / Int8 量化版本模型
-
启用后推理速度通常可提升 3–5 倍
问题三:输出视频无音频
可能原因: H3 支持原生音频生成,但工作流中未启用对应选项。
排查与解决:
-
检查相关节点参数,确认已勾选 "Generate Audio"
-
验证音频输出节点是否正确连接
问题四:2K 输出画质模糊
可能原因: 未正确触发 ICR(In-Context Regeneration)机制。
排查与解决:
-
H3 的 2K 为原生输出,非传统超分上采样
-
在 Prompt 中明确写入 "high resolution, 2K" 等质量描述词,引导模型进入高分辨率生成模式
最后–2026 AI 视频三大技术拐点
|
开源追平闭源 |
H3 进入 Arena 前三;社区微调兴起 |
私有化部署成本骤降;闭源 API 定价承压 |
2026 Q4 |
|
本地门槛下探 |
ComfyUI + INT8 + Block Swap |
12GB 显存跑 2K → 8GB 显存跑 2K |
2026 年中 |
|
音画原生同步 |
单流联合推理(非拼接) |
后期配音需求减少;短视频生产链路缩短 40% |
2026 全年 |