Kafka 幂等生产者与事务消息在大促交易防重中的性能损耗评估
在大促交易与资金结算链路中,“消息绝不能丢,但也绝不能重复消费”是一条不可动摇的资金安全红线。如果用户支付成功的一条 MQ 消息被重复消费了两次,导致用户钱包被双重扣款或商家被重复打款,会直接引发严重的资损和客诉。
Kafka 默认提供的传输语义是“至少一次(At-Least-Once)”——当生产端发送消息成功但由于网络抖动未收到 Broker 的 ACK 时,生产端会发起重试,从而在 Topic 中产生两条内容完全一致的重复消息;或者当消费端处理完毕但未能成功提交 Offset 时,Rebalance 后也会导致消息被再次投递。
为了实现精确一次(Exactly-Once Semantics, EOS),Kafka 官方推出了幂等生产者(Idempotent Producer)与事务消息(Transactional Messaging)。然而,天下没有免费的午餐。在大促数十万 TPS 极限压测下,开启这些特性究竟会带来多少性能损耗?架构师该如何进行技术选型与权衡?
幂等生产者(Idempotent Producer)的实现机理与损耗
从 Kafka 3.0 开始,生产者默认开启了幂等性(enable.idempotence=true)。
底层工作原理
[Producer] –(PID: 1001, Seq: 42, Data: OrderPaid)–> [Broker Partition-0]
|
检查内存窗口:
当前最大 Seq=41 -> 成功写入,更新 Seq=42
|
[Producer] –(重试发送: PID: 1001, Seq: 42)———> [Broker Partition-0]
|
检查内存窗口:
已存在 Seq=42 -> 丢弃 Payload,返回 SUCCESS ACK!
压测性能损耗评估
在 16 核 32G 机器、单实例并发发送 50,000 TPS 的基准压测下:
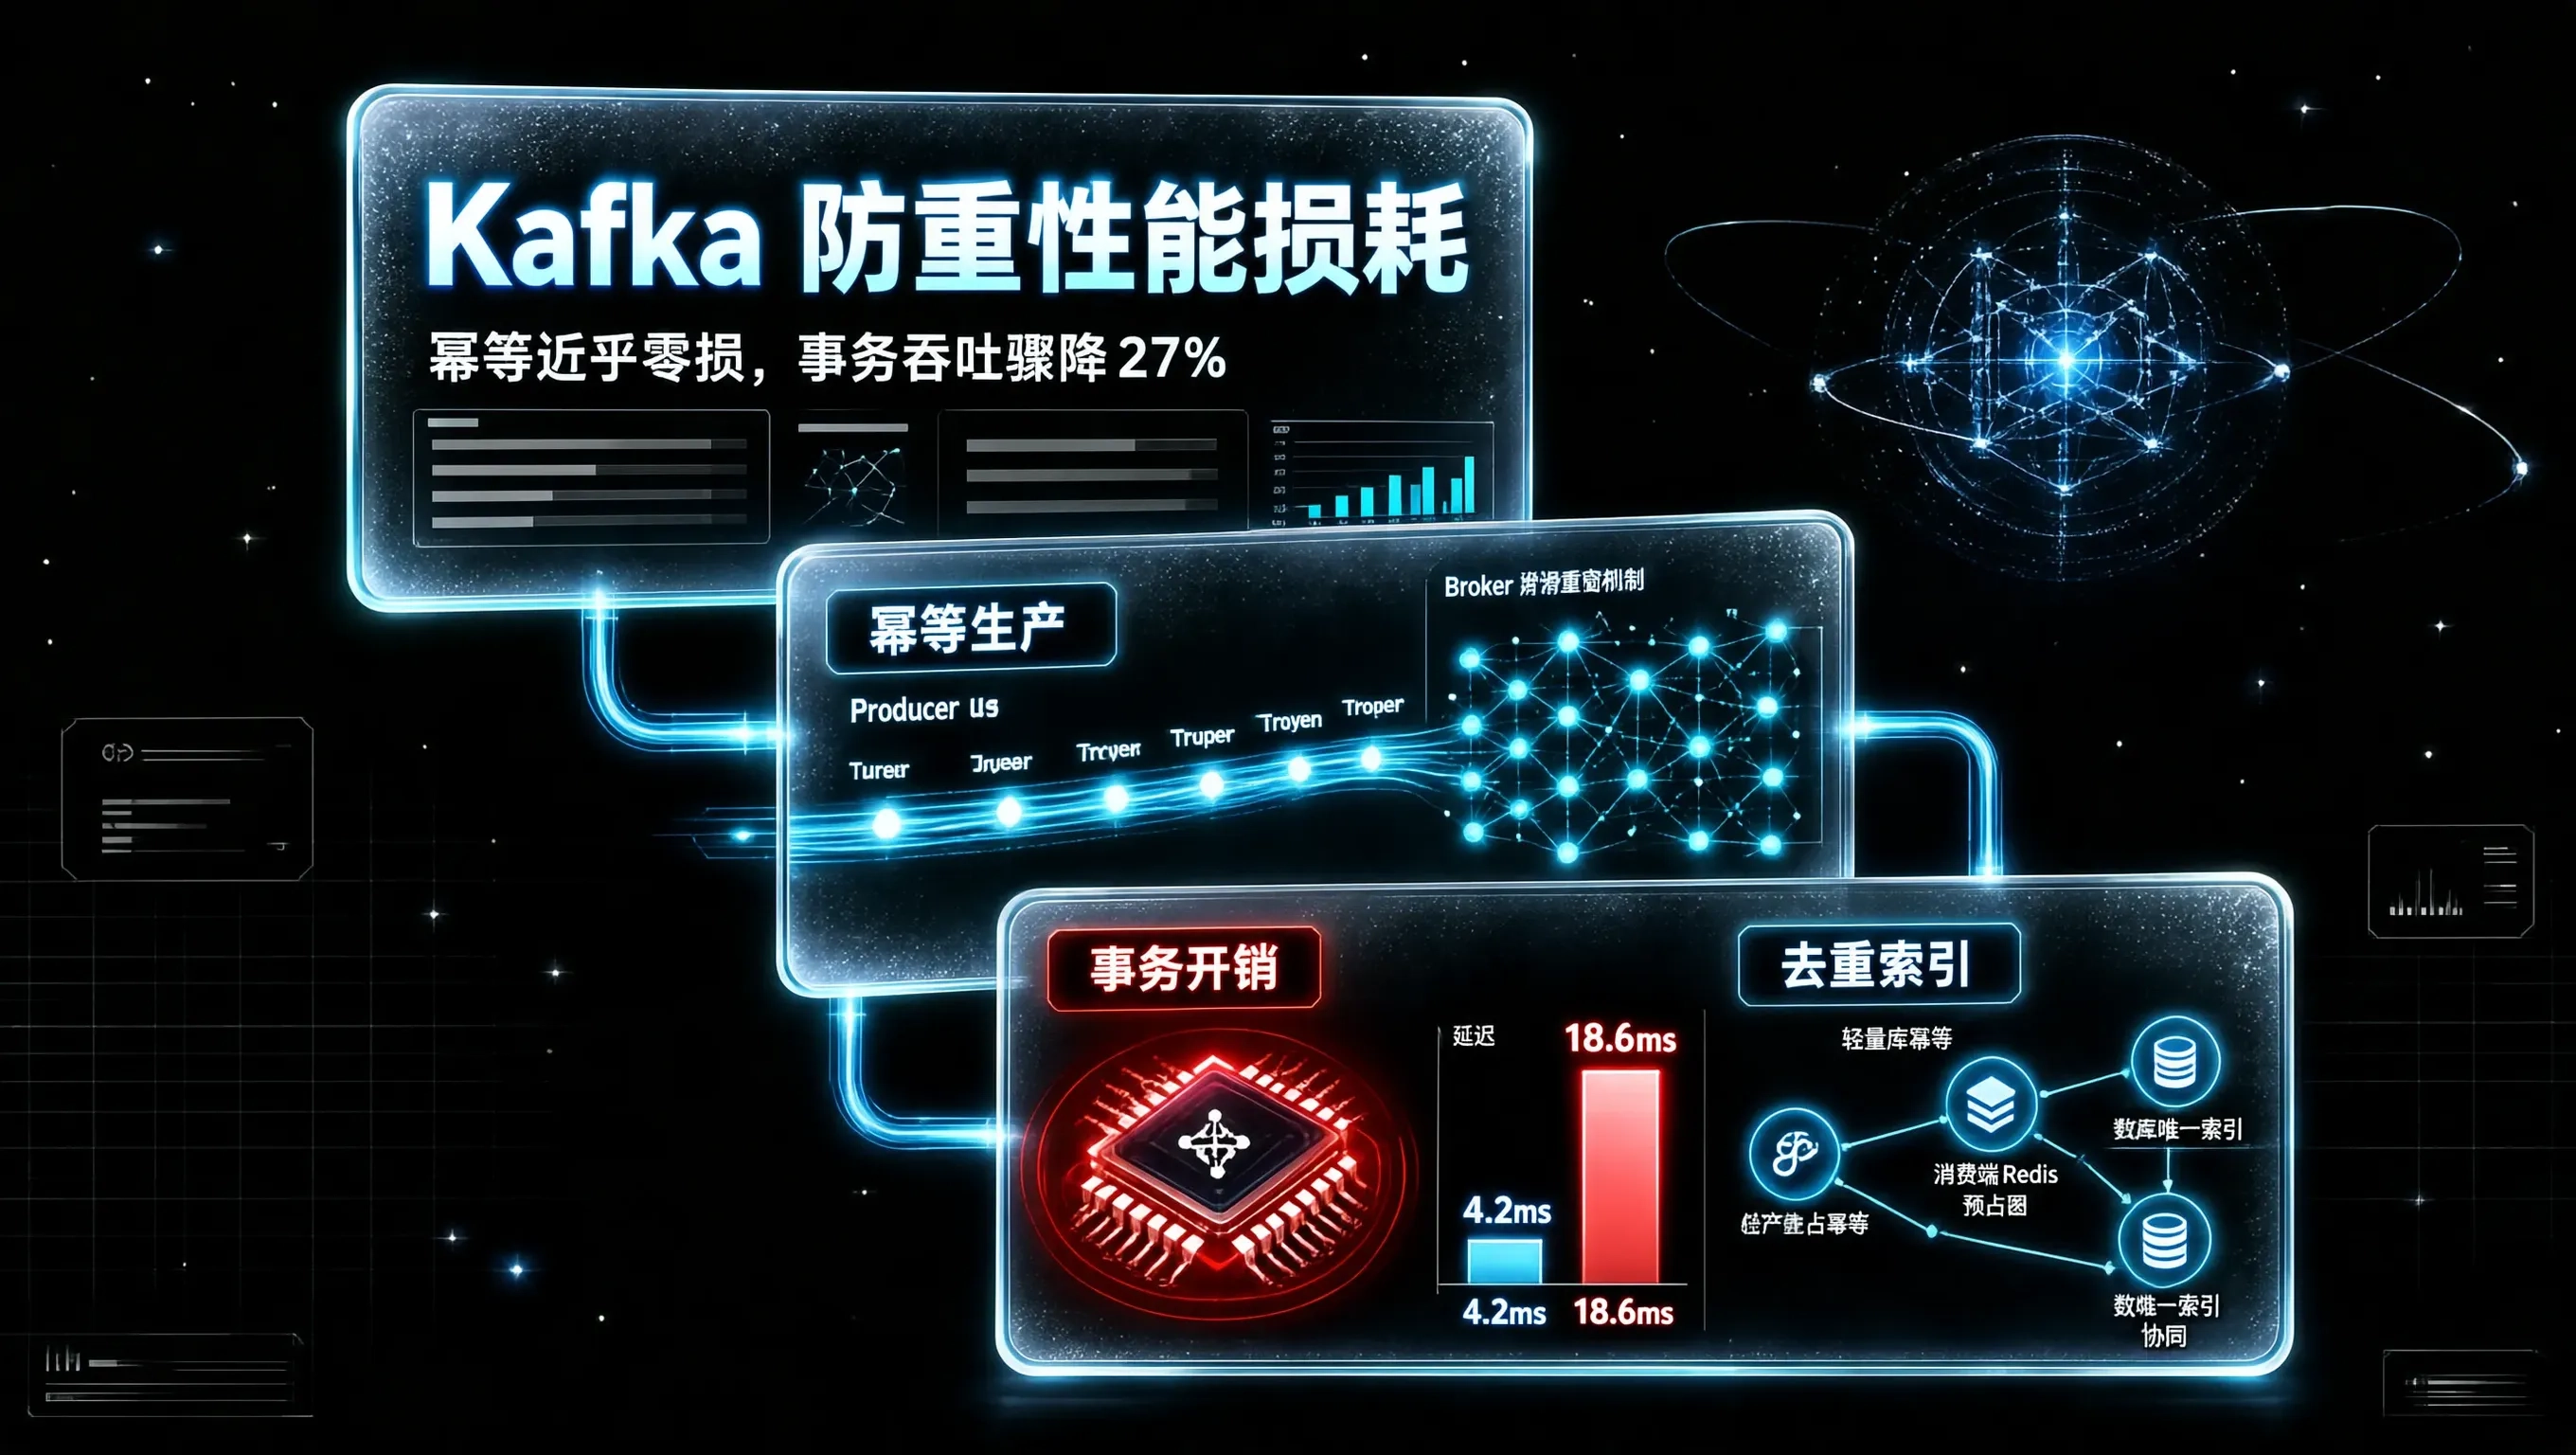
- 延迟(Latency):P99 延迟从 4.2ms 增加至 4.4ms,增幅仅为 +4.7%;
- 吞吐(Throughput):由于每条消息仅增加了 PID(8 字节)和 Sequence Number(4 字节)共 12 字节的微小开销,Broker 端仅需进行一次内存哈希比对,整体吞吐量下降小于 3%;
- 核心结论:幂等生产者的开销微乎其微,大促全链路所有核心与非核心 Topic 均建议强制开启!
Kafka 事务消息(Transactional API)的实现机理与代价
幂等生产者只能保证单个生产者在单个分区内部的防重,且无法保证“跨多个 Topic 生产与消费的原子性”。
在大促订单与库存协同场景下,通常需要满足原子操作:“消费订单创建消息 $\\rightarrow$ 本地数据库更新 $\\rightarrow$ 向库存扣减 Topic 发送新消息”,三者必须要么全部成功,要么全部回滚。为此,Kafka 引入了基于两阶段提交(2PC)的事务协调器(Transaction Coordinator)机制。
// 典型的 Kafka 事务生产者代码:支持跨分区原子写入
KafkaProducer<String, String> producer = new KafkaProducer<>(props);
producer.initTransactions(); // 向 Transaction Coordinator 注册全局 transactional.id
try {
producer.beginTransaction();
producer.send(new ProducerRecord<>("trade-order-topic", orderJson));
producer.send(new ProducerRecord<>("stock-deduct-topic", stockJson));
// 提交事务:协调器向事务日志写入 COMMIT 标记,并向各分区写入 Control Batch (Commit Marker)
producer.commitTransaction();
} catch (ProducerFencedException | OutOfOrderSequenceException e) {
producer.close();
} catch (KafkaException e) {
producer.abortTransaction(); // 异常回滚
}
事务消息的底层物理开销
压测性能损耗数据
在相同硬件规格与并发载荷下:
- 延迟(Latency):单次事务提交的 P99 延迟从 4.2ms 恶化至 18.6ms(膨胀了 4.4 倍);
- 吞吐(Throughput):单 Broker 最大并发写入 TPS 从 85,000 跌落至 62,000(吞吐骤降约 27%)。
大促最佳实践:业务去重表 + 轻量幂等生产的黄金组合
综合评估大促峰值的高吞吐诉求与资损防范,我们强烈推荐如下分层组合架构:
[生产端] -> 开启 Kafka 原生轻量幂等性 (enable.idempotence=true) -> 几乎零性能损耗
|
v (网络传输)
[消费端] -> 采用【本地 Redis 预占 + 数据库防重唯一索引表】实现业务级 Exactly-Once
- 消费端在写入数据库业务表的同时,将 message_id(全局唯一分布式雪花 ID)写入一张包含 UNIQUE KEY (msg_id) 的 trade_dedup_log 去重表;
- 利用 MySQL 本地事务的原子性,一旦发生重复消费,数据库底层唯一键冲突报错抛出 DuplicateKeyException,消费者直接安全 ACK,既保障了 100% 不重复,又榨干了 Kafka 的极致吞吐。