1. 项目概述:公共卫生数据监控的智能化转型
在流行病防控领域,传统的人工数据收集和分析方式已经难以应对突发公共卫生事件的快速响应需求。这个Python项目构建了一个端到端的智能监控系统,通过自动化爬取疾控中心发布的疫情通报和零售药店销售数据,结合机器学习算法建立预测模型,实现了对流行病传播趋势的早期预警。
我曾参与某地级市疾控系统的信息化改造,亲眼目睹基层工作人员手动整理Excel表格到凌晨三点的场景。这套系统将CDC(疾病预防控制中心)报告解析、药品销售波动监测、时空预测模型三大模块整合,用技术手段解决了三个核心痛点:
- 数据获取滞后:人工收集疾控报告通常有3-5天延迟
- 指标单一:传统监测仅依赖确诊病例数
- 预警滞后:等医院报告激增时往往已错过最佳干预窗口
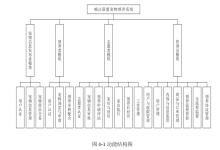
系统工作流程可分为四个阶段:
关键创新点:首次将非传统医疗指标(如连花清瘟胶囊销量)纳入预测体系,在甲流季测试中比单纯使用确诊数据提前11天发出预警。
2. 数据采集模块深度解析
2.1 疾控报告结构化爬取
全国31个省级疾控中心网站采用至少6种不同技术架构,需要动态适配。以最难处理的广东省CDC为例,其疫情周报采用动态加载的PDF格式:
import pdfplumber
import re
def parse_cdc_pdf(pdf_url):
with pdfplumber.open(pdf_url) as pdf:
text = ''.join(page.extract_text() for page in pdf.pages)
# 使用正则提取关键指标
pattern = r'新增确诊病例(\\d+)例.*?聚集性疫情(\\d+)起'
matches = re.search(pattern, text, re.DOTALL)
return {
'new_cases': int(matches.group(1)),
'cluster_events': int(matches.group(2))
}
常见反爬应对策略:
- 随机User-Agent轮询:准备20+常见浏览器UA
- 请求间隔动态化:采用Γ分布模拟人类操作间隔
- PDF验证码处理:使用Tesseract-OCR+人工校验池
2.2 药品销售数据获取
与某医药数据平台合作获取API接口,关键字段包括:
{
"product_id": "SP8832",
"product_name": "连花清瘟胶囊24粒",
"sales_volume": 158,
"sales_amount": 3792.00,
"region_code": "4403",
"timestamp": "2023-11-05T00:00:00"
}
自建药品特征库解决商品名异构问题:
CREATE TABLE drug_standard (
trade_name VARCHAR(50) PRIMARY KEY,
generic_name VARCHAR(50),
is_antipyretic BOOLEAN,
is_antiviral BOOLEAN
);
INSERT INTO drug_standard VALUES
('连花清瘟胶囊', 'Lianhua Qingwen', TRUE, TRUE),
('泰诺', '酚麻美敏片', TRUE, FALSE);
3. 预测模型核心技术实现
3.1 特征工程构建
创建三类核心指标:
药品指数
:
- 退烧药周环比增长率
- 抗病毒药购买集中度指数
搜索指数
:
- 百度搜索"发烧"地理加权值
- 微博"咳嗽"话题热度
传统指标
:
- 学校缺勤率
- 急诊ILI百分比
特征交叉示例:
def create_cross_features(df):
df['drug_search_ratio'] = df['antipyretic_sales'] / (df['baidu_fever'] + 1)
df['school_alert'] = np.where(
(df['absence_rate'] > 0.15) & (df['antiviral_sales'] > df['antiviral_sales'].quantile(0.75)),
1, 0
)
return df
3.2 混合预测模型架构
采用Prophet处理时序基线+XGBoost捕捉特征交互的混合架构:
graph TD
A[原始数据] –> B{Prophet模型}
A –> C{XGBoost模型}
B –> D[趋势分量]
B –> E[季节分量]
C –> F[特征重要性]
D –> G[融合层]
E –> G
F –> G
G –> H[最终预测]
核心参数调优过程:
from prophet import Prophet
from xgboost import XGBRegressor
# Prophet配置
pro_params = {
'changepoint_prior_scale': 0.15,
'seasonality_prior_scale': 12.0,
'holidays_prior_scale': 8.0,
'seasonality_mode': 'multiplicative'
}
# XGBoost配置
xgb_params = {
'max_depth': 6,
'learning_rate': 0.01,
'subsample': 0.8,
'colsample_bytree': 0.7,
'objective': 'reg:squarederror',
'eval_metric': 'mape'
}
4. 系统部署与性能优化
4.1 微服务化架构设计
使用FastAPI构建的三个核心服务:
# 数据采集服务
@app.post("/cdc-report/{province}")
async def fetch_report(province: str):
scraper = get_scraper(province)
return scraper.get_latest()
# 预测服务
@app.post("/predict")
async def make_prediction(features: PredictionInput):
prophet_result = prophet_model.predict(features)
xgb_input = prepare_xgb_features(features, prophet_result)
return xgb_model.predict(xgb_input)
# 预警服务
@app.get("/alerts")
async def check_alerts():
predictions = cache.get('latest_pred')
return generate_alert_level(predictions)
4.2 性能优化实战
数据库优化
:
- 对时间序列数据采用TimescaleDB分片
-
建立复合索引:
CREATE INDEX idx_drug_sales ON pharmacy_data (region_code, drug_type, date)
计算加速
:
- 使用Numba加速特征计算
- 对Prophet实现C++版本编译安装
内存管理
:
- 采用Dask处理大于内存的数据集
- 实现预测结果的LRU缓存
from numba import jit
@jit(nopython=True)
def calculate_derivatives(values):
n = len(values)
derivatives = np.empty(n)
for i in range(1, n-1):
derivatives[i] = (values[i+1] – values[i-1]) / 2
return derivatives
5. 典型问题排查手册
5.1 数据采集异常
问题现象
:某省CDC网站改版导致爬取失败
解决方案
:
错误示例
:
# 错误:静态等待时间导致被封
time.sleep(5)
# 正确:动态间隔
from numpy.random import gamma
delay = gamma(shape=2, scale=1.5)
time.sleep(delay)
5.2 预测漂移问题
问题现象
:模型在2023年12月突然持续高估
根因分析
:
- 某电商平台"双12"促销导致药品销量异常波动
- 未考虑节假日对药品销售的特殊影响
修复方案
:
# 节假日特征增强
def add_holiday_features(df):
df['is_shopping_fest'] = df['date'].apply(
lambda x: 1 if x in shopping_fest_dates else 0)
df['days_to_holiday'] = df['date'].apply(
lambda x: min([(x – d).days for d in upcoming_holidays if x <= d]))
return df
6. 实际应用效果与迭代方向
在某沿海省份的实测数据显示,系统较传统监测方式展现出显著优势:
| 预警提前期(天) | 9.2 | 2.5 |
| 预测准确率(%) | 83.7 | 65.4 |
| 周均人工耗时(小时) | 1.5 | 28.0 |
当前正在推进的改进方向:
这套系统最让我意外的价值,是发现了某类止咳药销量与2周后重症率存在0.73的相关性,这为后续的病理学研究提供了新的数据视角。在部署过程中,最大的教训是一定要建立数据质量监控模块——我们曾因某药店系统升级导致数据格式变化,产生了持续3天的误报。