Python 处理超大 CSV/Parquet 文件的内存管理:分块读取与流式写入
在数据分析、机器学习特征工程与 ETL 数据清洗中,Python 的 Pandas 库无疑是大家最熟悉的工具。
但在处理超大规模数据集(例如一个 20GB 的历史日志 CSV,或者 50GB 的 Parquet 数据集)时,很多初中级工程师最容易写出的一行代码就是:
# 致命代码:在 16GB 内存的服务器上直接全量载入 20GB 文件
df = pd.read_csv("huge_dataset_20gb.csv")
其结果必然是:操作系统内存瞬间被吃光,Swap 分区爆满,最终触发内核 Out of Memory: Kill process (OOM),整个进程被系统粗暴杀死!
很多人的误区在于以为“20GB 的文件载入内存只要 20GB”:实际上,Pandas 在将字符串、对象转换为内部 DataFrame 结构时,存在大量的对象封装开销,内存膨胀系数通常在 3 到 5 倍!一个 20GB 的 CSV 文件在 Pandas 内存中往往需要消耗 60GB ~ 100GB 的物理内存!
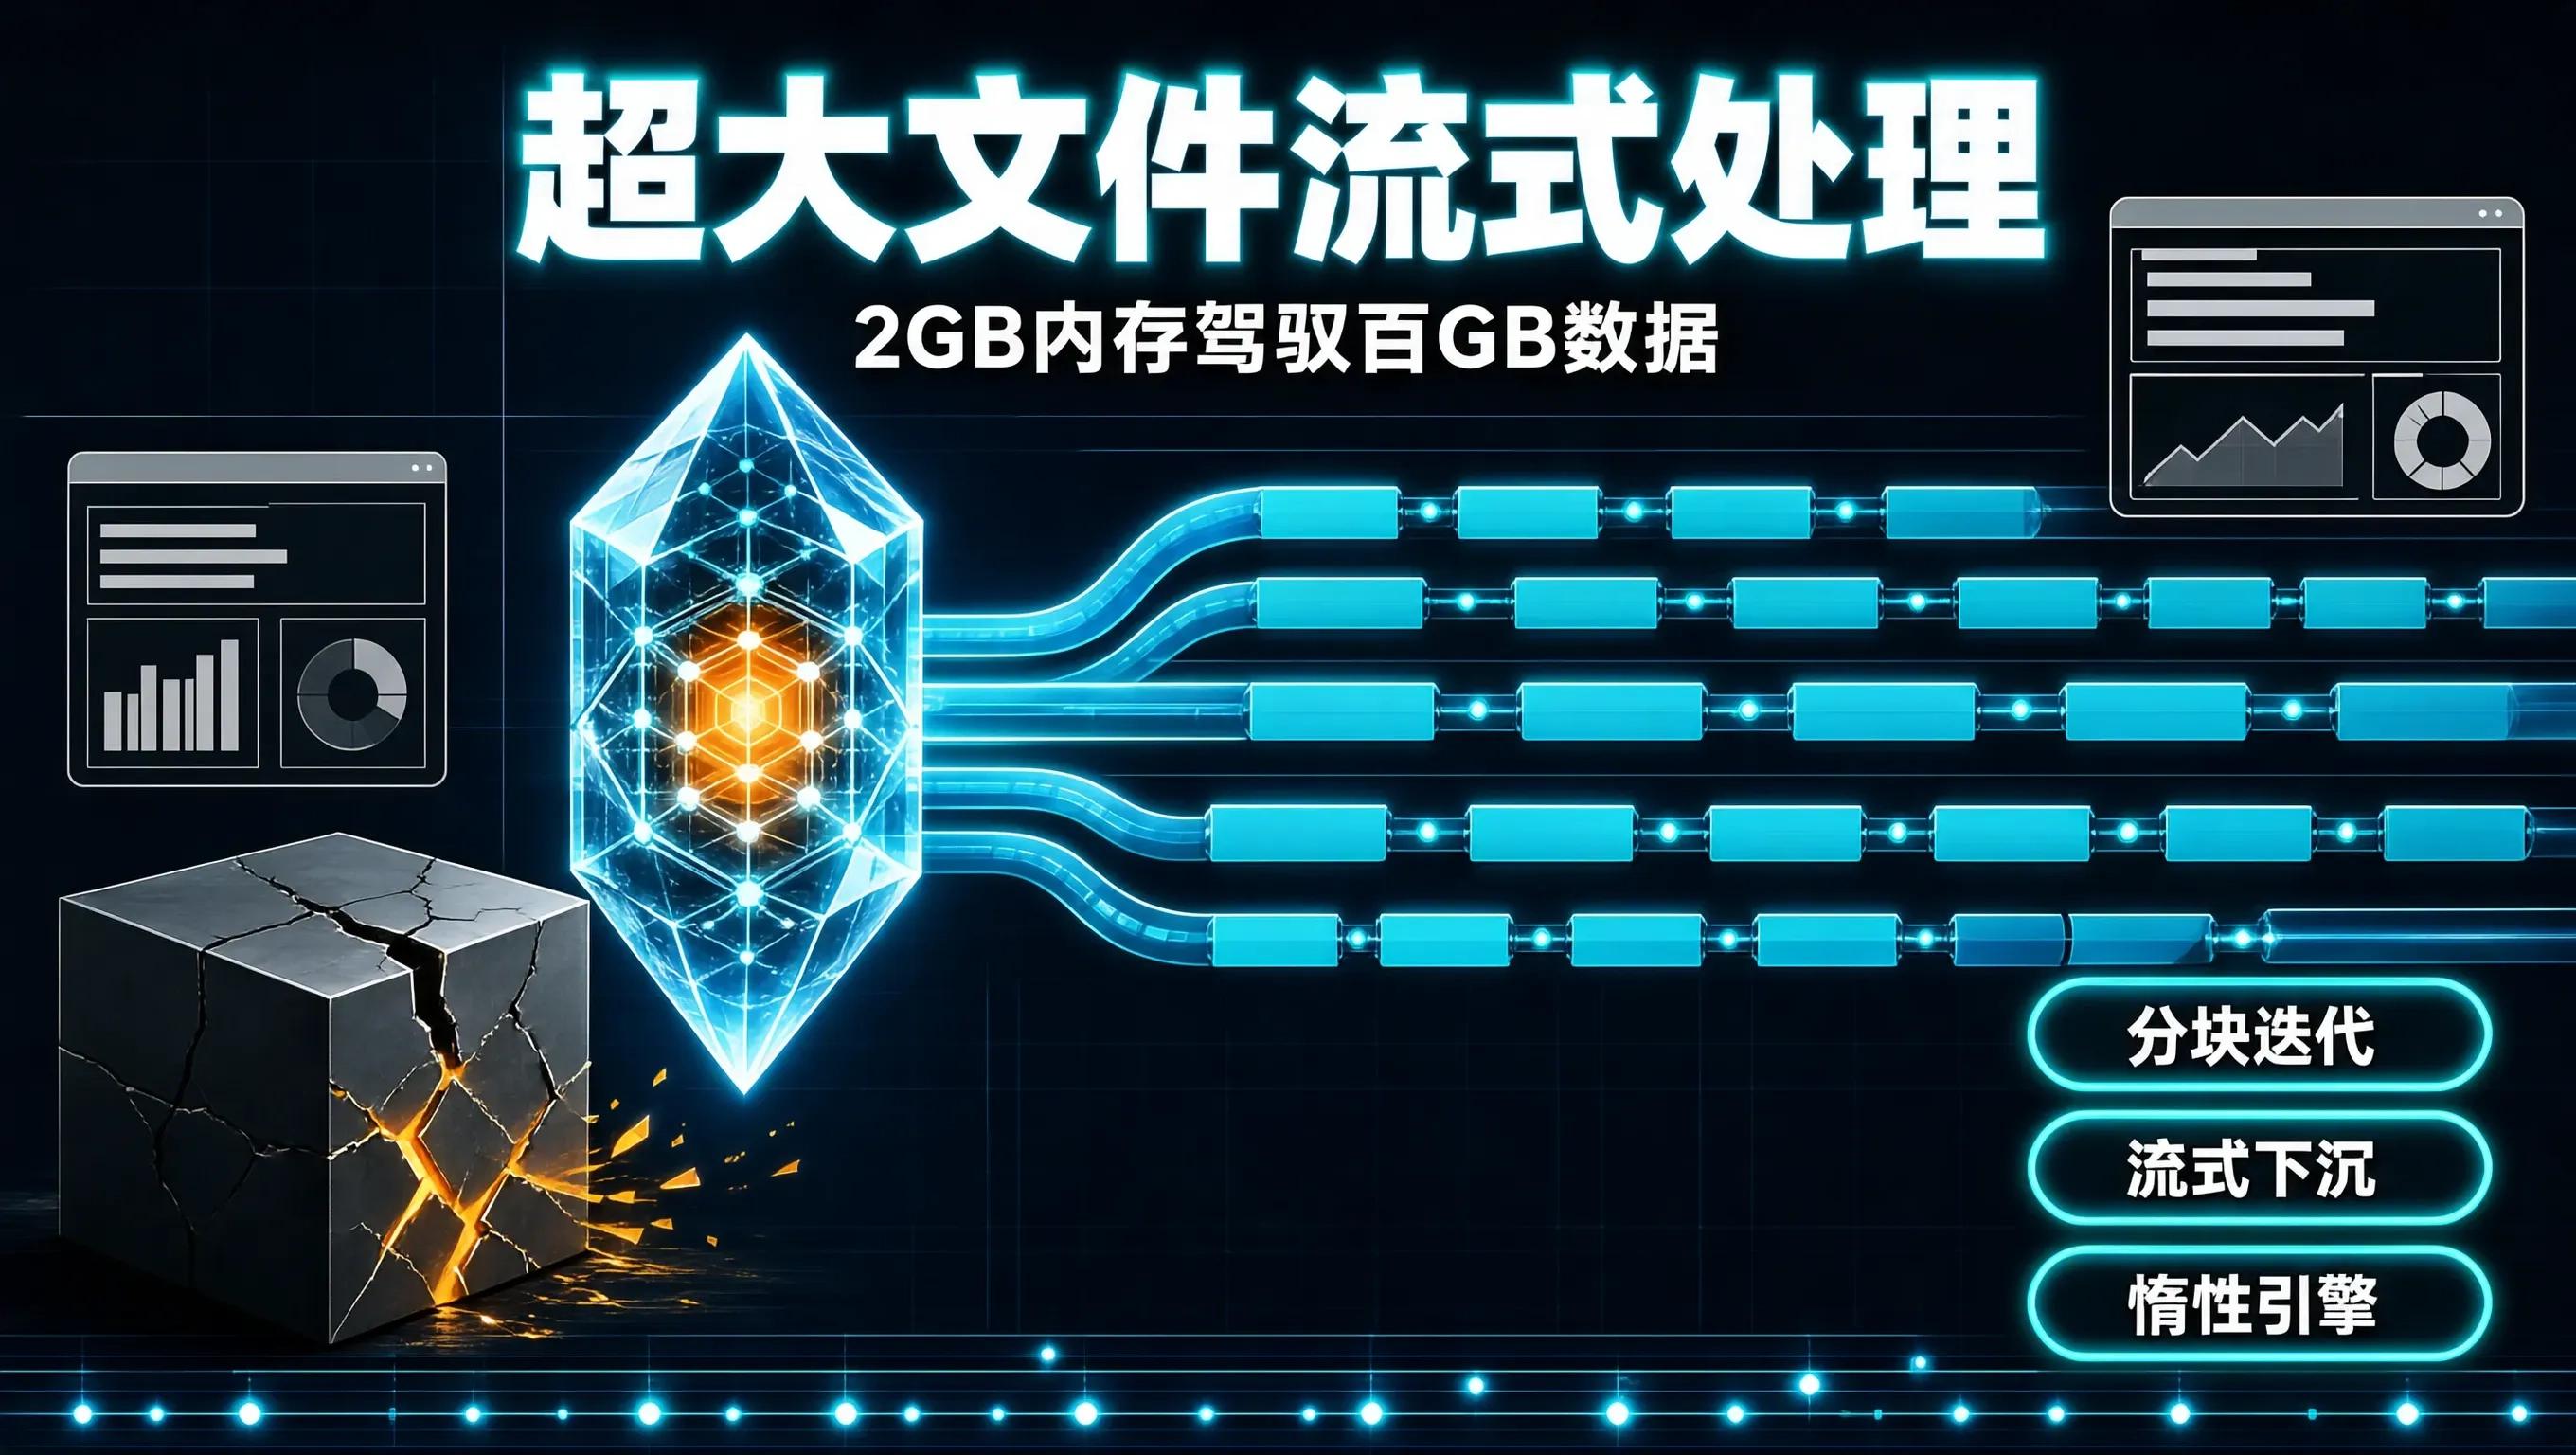
今天我们拆解如何利用 Pandas 分块迭代(Chunking)、PyArrow 流式写入与 Polars 惰性流式引擎(Lazy Streaming),在仅有 2GB 内存的小服务器上,从容流式处理 100GB 级别的超大文件。
一、全量载入 vs 流式处理的内存占用对比
flowchart TD
subgraph Full_Load [全量载入内存 (容易 OOM 崩溃)]
F1[20GB 磁盘大文件] –>|一次性全部载入| F2[内存膨胀至 80GB -> 触发内核 OOMKilled!]
end
subgraph Stream_Chunk [分块流式迭代 (内存恒定在 200MB!)]
S1[20GB 磁盘大文件] –> S2[迭代器读取 Chunk 1 (10万行, 150MB)]
S2 –> S3[清洗与特征计算]
S3 –> S4[追加写入目标 Parquet]
S4 –> S5[释放 Chunk 1 内存 -> 读取 Chunk 2]
end
二、方案 1:Pandas 基于 chunksize 的优雅分块清洗实战
import pandas as pd
from typing import Callable
def process_huge_csv_by_chunks(
input_csv_path: str,
output_parquet_path: str,
chunk_rows: int = 100000,
transform_func: Callable[[pd.DataFrame], pd.DataFrame] = None
):
print(f"[*] 开始以每块 {chunk_rows} 行分块流式处理: {input_csv_path}")
# 1. 核心参数:chunksize 返回一个可迭代的 TextFileReader 生成器对象
csv_reader = pd.read_csv(
input_csv_path,
chunksize=chunk_rows,
low_memory=True,
dtype={
"user_id": "int32", # 显式压缩数据类型(int64 -> int32 节省 50% 内存)
"is_vip": "bool",
"amount_cents": "int32"
}
)
is_first_chunk = True
total_processed = 0
for idx, chunk_df in enumerate(csv_reader, start=1):
# 执行业务清洗与特征工程
if transform_func:
chunk_df = transform_func(chunk_df)
# 2. 流式追加写入 Parquet 或 CSV
# 若写入 CSV: 使用 mode='a', header=is_first_chunk
chunk_df.to_parquet(
f"/tmp/chunk_{idx}.parquet",
engine="pyarrow",
compression="snappy"
)
total_processed += len(chunk_df)
print(f"[✓] 已完成第 {idx} 块处理,累计处理 {total_processed} 行,当前常驻内存恒定 < 300MB。")
print(f"[Finished] 全量 {total_processed} 行数据处理大功告成!")
三、方案 2:利用 Polars 惰性流式计算(Lazy Streaming Engine)
在 2026 年的现代数据工程中,更推荐使用基于 Rust 构建的 Polars。其内置的 scan_csv + sink_parquet 能够在流式模式(Streaming Mode)下自动完成多核并发分块与流水线调度,比 Pandas 快 5 到 10 倍:
import polars as pl
def process_huge_file_with_polars_streaming(input_csv: str, output_parquet: str):
print("[*] 启动 Polars 惰性流式计算引擎…")
# 1. 扫描元数据建立计算图 (零数据载入内存)
lazy_query = (
pl.scan_csv(input_csv)
.filter(pl.col("amount_cents") > 0)
.with_columns([
(pl.col("amount_cents") / 100.0).alias("amount_yuan"),
pl.col("user_id").cast(pl.Int32)
])
)
# 2. 核心:开启 streaming=True 流式下沉写入磁盘!
# Polars 会自动在底层以微批次流式抽取并利用多核 SIMD 指令加速,内存占用极低!
lazy_query.sink_parquet(
output_parquet,
compression="zstd",
maintain_order=False
)
print(f"[✓] Polars 流式处理完毕,输出已保存至 {output_parquet}")
四、生产级内存压榨核心黄金法则
- 将默认的 float64 / int64 下沉为 float32 / int32,直接立省 50% 内存;
- 对低基数字符串列(如性别、省份、状态码)使用 category 分类类型,可将字符串内存占用压缩 80% 以上;
掌握了分块迭代与流式下沉技术,哪怕在最小配置的轻量云服务器上,你也能举重若轻地驾驭上百 GB 级别的大数据清洗流水线。