系列:《高通 NPU 边缘 AI 实战:从芯片架构到开发板落地》 从零到一 · 高通 Dragonwing 边缘 AI 12 讲 数据口径:本讲数值凡标注 [官方](厂商公开规格)、[推算](基于架构的估算)、[实测](仅给测量方法、不替你出数字)。估算不冒充实测。 本讲定位:第 03–10 讲你已经能在犀牛派 A1(QCS6490)上从点亮板子、装工具链、转模型、量化、部署,一路做到实时视觉、连续媒体流,甚至封装成 ROS2 机器人节点。但"能在实验室跑通"和"能在工厂/现场 7×24 稳定运行并量产"之间,还隔着一道鸿沟。本讲就是填这道沟:性能调优(让推理更快更省)+ 生产化(让系统扛得住真实世界、并能量产)。
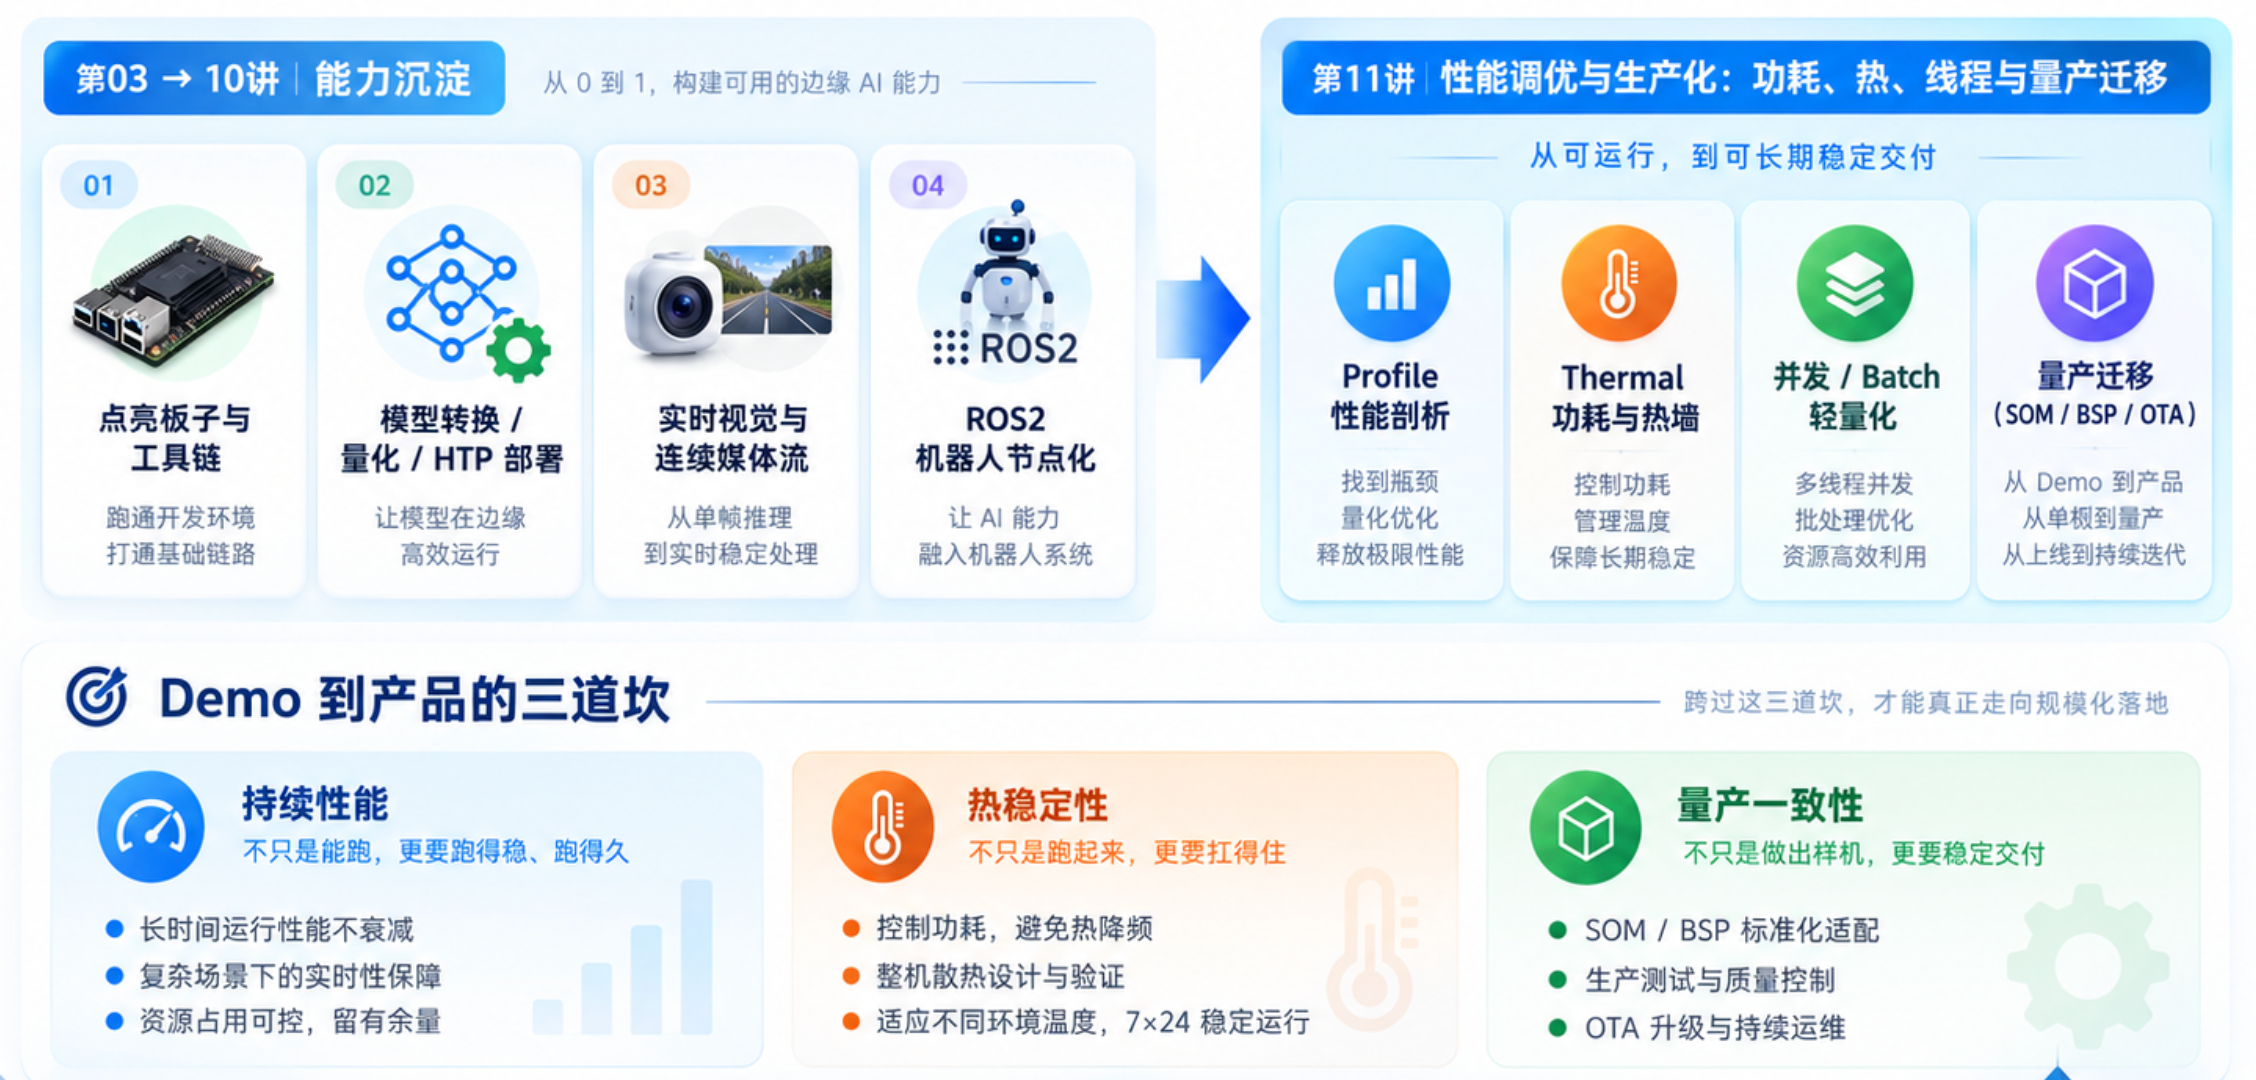
本讲目标
- 目标读者:已完成第 03–10 讲,功能已跑通,想把它变成"扛得住、能量产"产品的人。
- 本讲目标:
- 会用 qnn-profile 读逐层耗时,定位 NPU 推理热点。
- 理解功耗墙与热墙,尤其是 thermal 降频这一边缘部署最常见的"玄学报错"根源。
- 掌握多模型并发、多线程流水、batch 策略对吞吐与延迟的权衡。
- 知道模型轻量化(算子融合、剪枝、更小骨干)怎么落地。
- 搞清楚从"开发板"到"OEM 量产"的关键迁移(BSP 锁定、SOM 选型、OTA)。
- 你将带走:一份性能调优 checklist、一份量产迁移清单、thermal 降频对策表、功耗/算力权衡的估算方法。
一、环境调研:为什么"能跑"不等于"能交付"
1.1 demo 与产品的三道坎
实验室 demo 的标准是"我手上的板子能出正确结果";产品标准是"一千块板子在客户现场跑一年不出事"。中间隔三道坎:
| 性能 | 单次延迟够看就行 | 持续高负载下的稳定延迟 |
| 功耗/热 | 跑几分钟无所谓 | 7×24 不降频、不宕机 |
| 一致性 | 一块板调好即可 | 千块板 BSP/模型完全一致、可 OTA |
[推算] 一个边缘设备若设计余量不足,满载运行几小时后 thermal 降频,延迟可能从 30ms 飙到 80ms——功能"看起来对的"模型,在降频后会开始漏检、开始掉帧。这正是"demo 跑半天就变卡"的真实成因,也是本讲要根治的对象。
1.2 调优与生产化的全景
本讲把"从能跑到能交付"拆成四块:
这四块顺序有讲究:先剖析定位,再稳住热,再提速,最后才谈量产——和前面"先正确再优化"的方法论一脉相承。
1.3 本讲前提
- 已完成第 07 讲:在 HTP 上跑通量化模型,拿到编译好的 context binary。
- 已装好 qnn-profile、qnn-net-run 等工具(第 04 讲)。
- 设备为犀牛派 A1(QCS6490),或同类高通边缘开发板;具体 thermal 阈值、BSP 版本以阿加犀/高通官方资料为准。
二、性能剖析:用 qnn-profile 定位热点
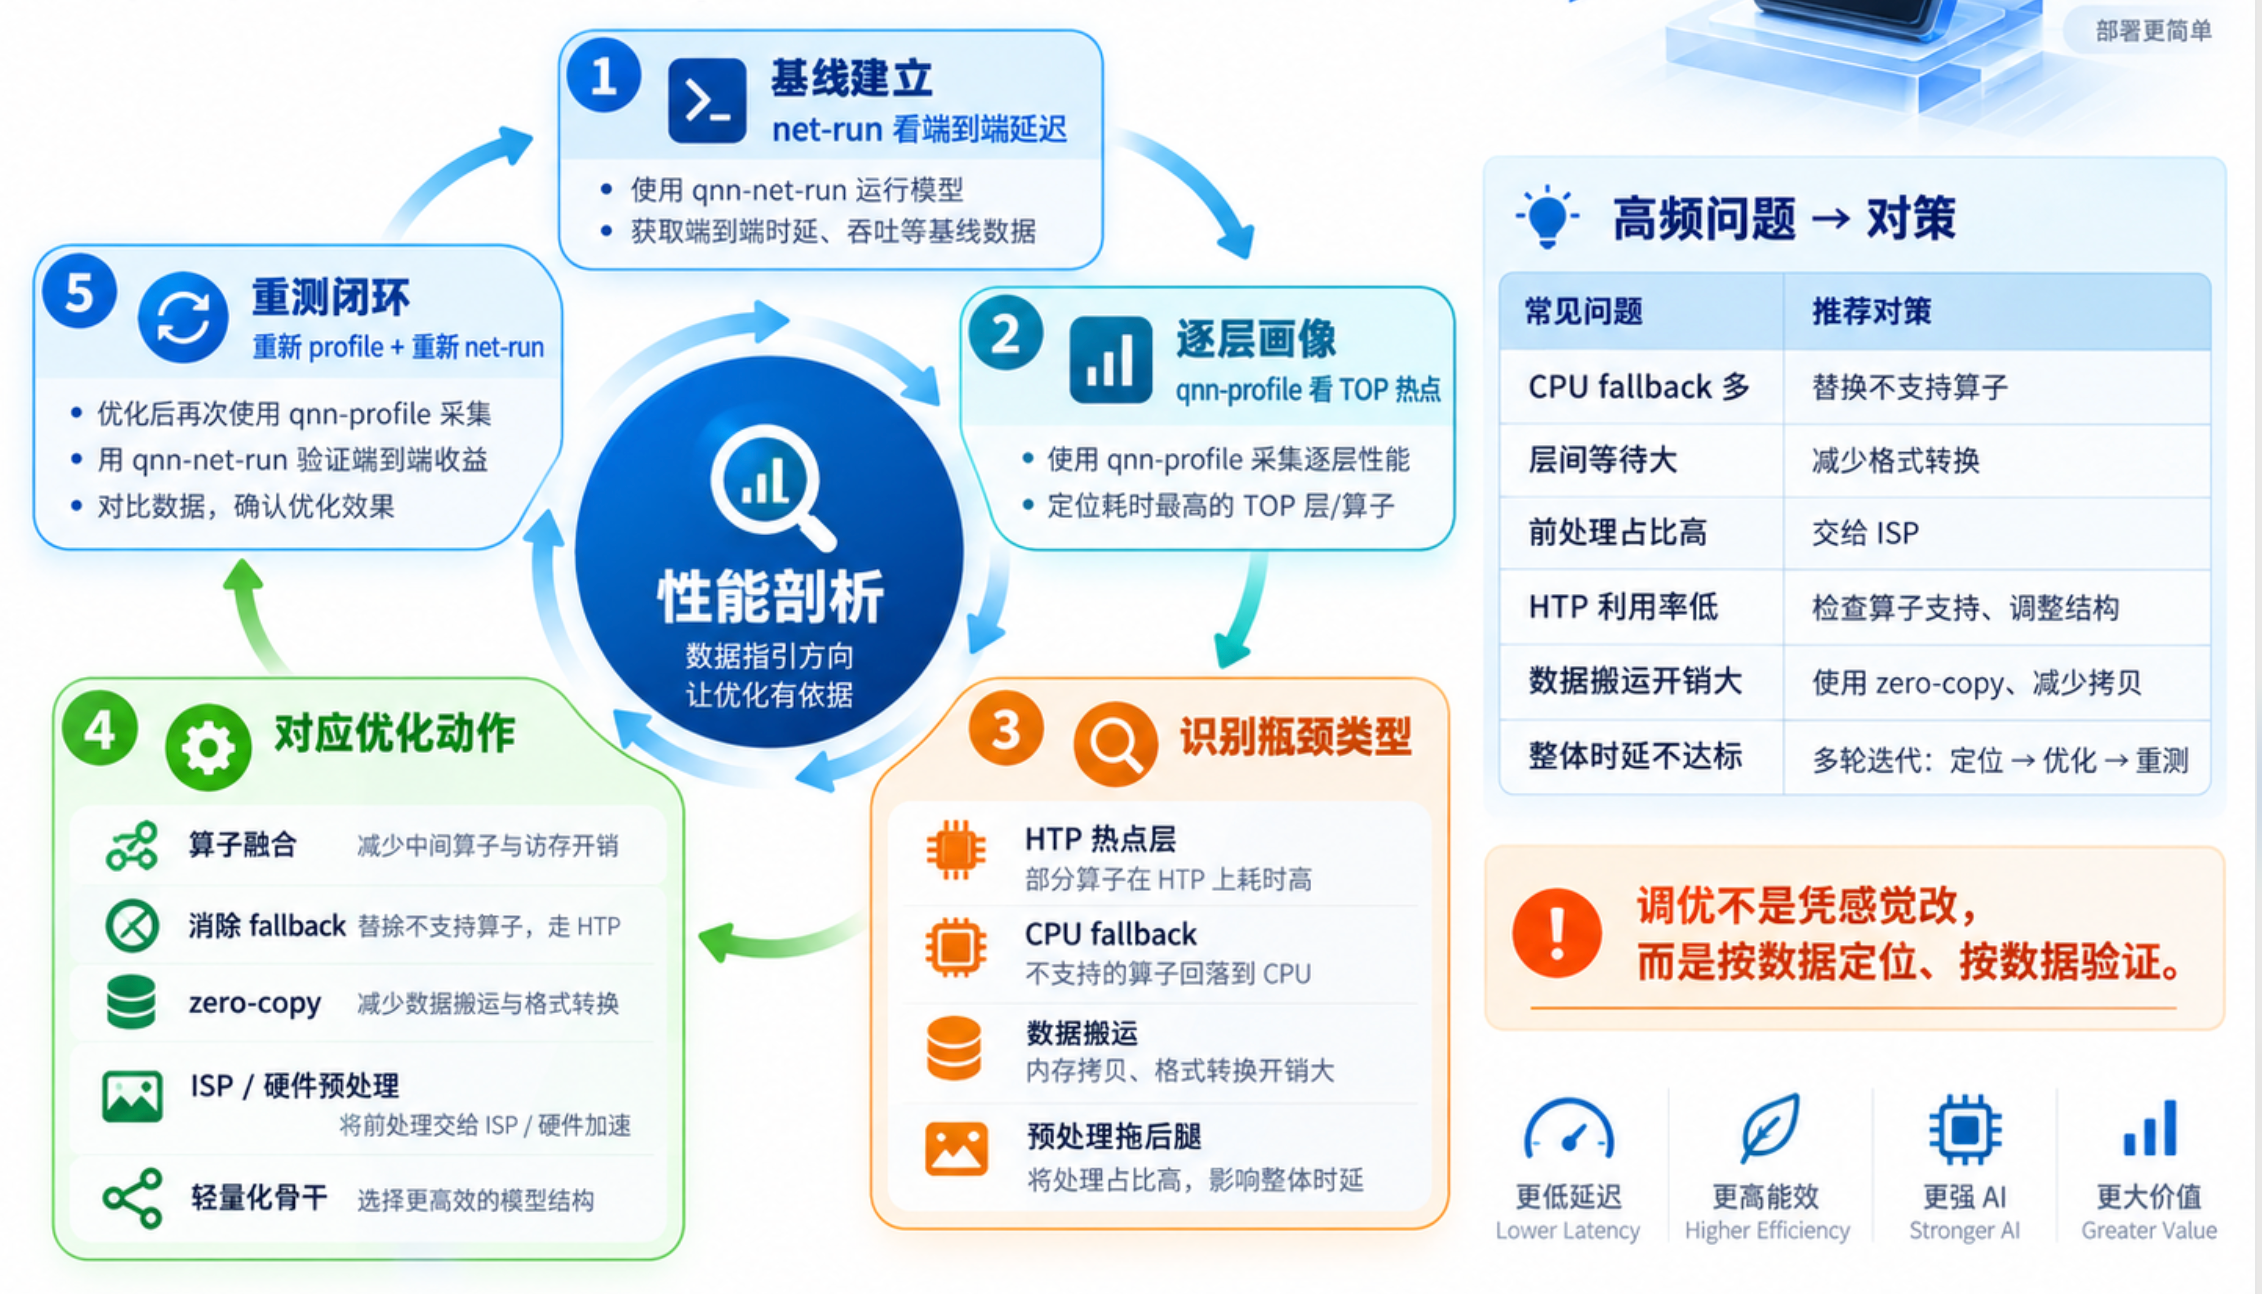
定位、优化示意图
2.1 profile 输出读什么
qnn-profile 会给出模型在目标 backend(HTP)上逐层(per-layer)的执行耗时与总耗时。你重点看三件事:
- 总耗时:端到端一帧多久,对照你的延迟预算。
- 热点层:耗时排名前几的层——它们决定了优化优先级。
- 非 HTP 层:有没有某些层被 fallback 到 CPU/GPU 执行(即第 05 讲讲的"NPU+CPU 混合执行")。fallback 层往往是大头,因为它们没吃到 HTP 的专用加速。
2.2 热点定位流程
#mermaid-svg-Dlep5c2cO6TDInm2{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-Dlep5c2cO6TDInm2 .error-icon{fill:#552222;}#mermaid-svg-Dlep5c2cO6TDInm2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-Dlep5c2cO6TDInm2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-Dlep5c2cO6TDInm2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-Dlep5c2cO6TDInm2 .marker.cross{stroke:#333333;}#mermaid-svg-Dlep5c2cO6TDInm2 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-Dlep5c2cO6TDInm2 p{margin:0;}#mermaid-svg-Dlep5c2cO6TDInm2 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster-label text{fill:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster-label span{color:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster-label span p{background-color:transparent;}#mermaid-svg-Dlep5c2cO6TDInm2 .label text,#mermaid-svg-Dlep5c2cO6TDInm2 span{fill:#333;color:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 .node rect,#mermaid-svg-Dlep5c2cO6TDInm2 .node circle,#mermaid-svg-Dlep5c2cO6TDInm2 .node ellipse,#mermaid-svg-Dlep5c2cO6TDInm2 .node polygon,#mermaid-svg-Dlep5c2cO6TDInm2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-Dlep5c2cO6TDInm2 .rough-node .label text,#mermaid-svg-Dlep5c2cO6TDInm2 .node .label text,#mermaid-svg-Dlep5c2cO6TDInm2 .image-shape .label,#mermaid-svg-Dlep5c2cO6TDInm2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-Dlep5c2cO6TDInm2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-Dlep5c2cO6TDInm2 .rough-node .label,#mermaid-svg-Dlep5c2cO6TDInm2 .node .label,#mermaid-svg-Dlep5c2cO6TDInm2 .image-shape .label,#mermaid-svg-Dlep5c2cO6TDInm2 .icon-shape .label{text-align:center;}#mermaid-svg-Dlep5c2cO6TDInm2 .node.clickable{cursor:pointer;}#mermaid-svg-Dlep5c2cO6TDInm2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-Dlep5c2cO6TDInm2 .arrowheadPath{fill:#333333;}#mermaid-svg-Dlep5c2cO6TDInm2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-Dlep5c2cO6TDInm2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-Dlep5c2cO6TDInm2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-Dlep5c2cO6TDInm2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-Dlep5c2cO6TDInm2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-Dlep5c2cO6TDInm2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster text{fill:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 .cluster span{color:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-Dlep5c2cO6TDInm2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-Dlep5c2cO6TDInm2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-Dlep5c2cO6TDInm2 .icon-shape,#mermaid-svg-Dlep5c2cO6TDInm2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-Dlep5c2cO6TDInm2 .icon-shape p,#mermaid-svg-Dlep5c2cO6TDInm2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-Dlep5c2cO6TDInm2 .icon-shape .label rect,#mermaid-svg-Dlep5c2cO6TDInm2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-Dlep5c2cO6TDInm2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-Dlep5c2cO6TDInm2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-Dlep5c2cO6TDInm2 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
HTP 内算子慢
fallback 到 CPU
运行 qnn-profile
读总耗时 对照预算
排热点层 TOP5
热点在 HTP 还是 fallback?
算子融合/换实现/轻量化
替换为 NPU 支持算子 / 自定义 op
重测
关键洞察:绝大多数"NPU 没想象中快"的案例,根因是大量层 fallback 到了 CPU,而非 HTP 本身慢。定位这一步,能帮你把力气用在刀刃上。
2.3 热点类型与对策
| 个别大算子慢 | 单层层耗时占比高 | 查是否有替代实现 / 自定义 op / 算子融合 |
| 大量 fallback 层 | CPU 层累计耗时高 | 替换不被支持的算子,尽量留在 HTP |
| 数据搬运慢 | 层间间隙大(非计算等待) | zero-copy、减少格式转换(呼应第 08/09 讲) |
| 预处理拖后腿 | 前处理占比高 | 用 ISP/硬件预处理(第 08 讲) |
2.4 解析 profile 输出的脚本示意
# [推算] 解析 qnn-profile 逐层耗时 CSV 的小工具(字段名以实际工具输出为准)
import csv
def top_hotspots(csv_path, k=5):
rows = list(csv.DictReader(open(csv_path)))
# 假设有 layer_name 与 time_ms 两列
rows.sort(key=lambda r: float(r['time_ms']), reverse=True)
total = sum(float(r['time_ms']) for r in rows)
print(f"总耗时 {total:.1f} ms, 层数 {len(rows)}")
for r in rows[:k]:
pct = float(r['time_ms']) / total * 100
print(f" {r['layer_name']:24} {float(r['time_ms']):.2f} ms ({pct:.1f}%)")
# 输出(推算):定位 TOP5 热点,优化它们通常能拿回 60%+ 的优化空间
[实测] 上面的字段名、单位、是否含 fallback 标记,以你本机 qnn-profile 的真实输出格式为准;脚本只是"怎么消费这些数据"的范例,具体要按真实表头调整。
2.5 一个 profile 实战读数示例(示意)
假设 qnn-profile 输出(字段名以实际工具为准)形如如下逐层耗时:
| Conv_1 | HTP | 1.2 |
| Conv_2 | HTP | 1.1 |
| NonMaxSuppression | CPU | 6.8 |
| Detect_head | HTP | 2.0 |
| … | … | … |
如果 TOP5 热点里 NonMaxSuppression 这种后处理层显示在 CPU 且耗时占比高,优化方向就不是动模型,而是把后处理搬到 GPU、或换 HTP 友好的 NMS 变体、或降低后处理频率。反之,若热点都在 HTP 的 Conv 层,才考虑轻量化骨干(第 5 节)。这一步判断,决定了后续 80% 的优化精力投在哪里——投错方向,做再多也是白费。
[实测] 上表为示意结构;真实字段、是否逐算子标注 backend、单位是否为 ms,一律以你本机工具输出为准。第 2.4 节的脚本只展示"如何消费这些数据",不是真实读数。
2.6 qnn-profile 与 qnn-net-run 的分工
qnn-net-run 帮你"跑通并得到端到端延迟",qnn-profile 帮你"看清时间花在哪"。两者的工程顺序是:先用 net-run 确认能跑、拿到基线延迟;再用 profile 定位热点、指导优化;优化完再用 net-run 验证端到端收益。它们必须配合,而不是只跑一个。
[实测] 不少人只跑 net-run 就以为"优化完了",结果优化了个寂寞——没定位热点,优化的方向就是猜的。本讲反复强调 profile 优先,正是要把"凭感觉调"变成"按数据调"。具体字段、单位、是否含 fallback 标记以你本机工具输出为准。
2.7 性能调优的三大误区
- 误区一:“NPU 利用率高 = 性能好”。错。利用率高可能意味着大量层 fallback 到 CPU 在忙等,或数据搬运占满总线。要看"端到端延迟"和"热点在哪",不是盯一个利用率数字(呼应 2.1)。
- 误区二:“一慢就换更大 SoC”。错。先用 profile 定位,多数情况是 fallback 层或带宽墙,换 SoC 治标不治本(见 5.6)。
- 误区三:“实测算一次就定稿”。错。边缘设备性能随温度、负载、并发波动,要在不同温度/负载下多测几次,尤其是 thermal 降频后的表现(见 3.5)。
[推算] 这三条误区,覆盖了本讲见过的大多数"调优失败"案例。记住一句话:调优是"按数据定位、按数据验证",不是"按感觉猜、按感觉改"——这条纪律,和全系列的数据口径([官方]/[推算]/[实测])是一体的。
三、功耗墙与热墙:thermal 降频
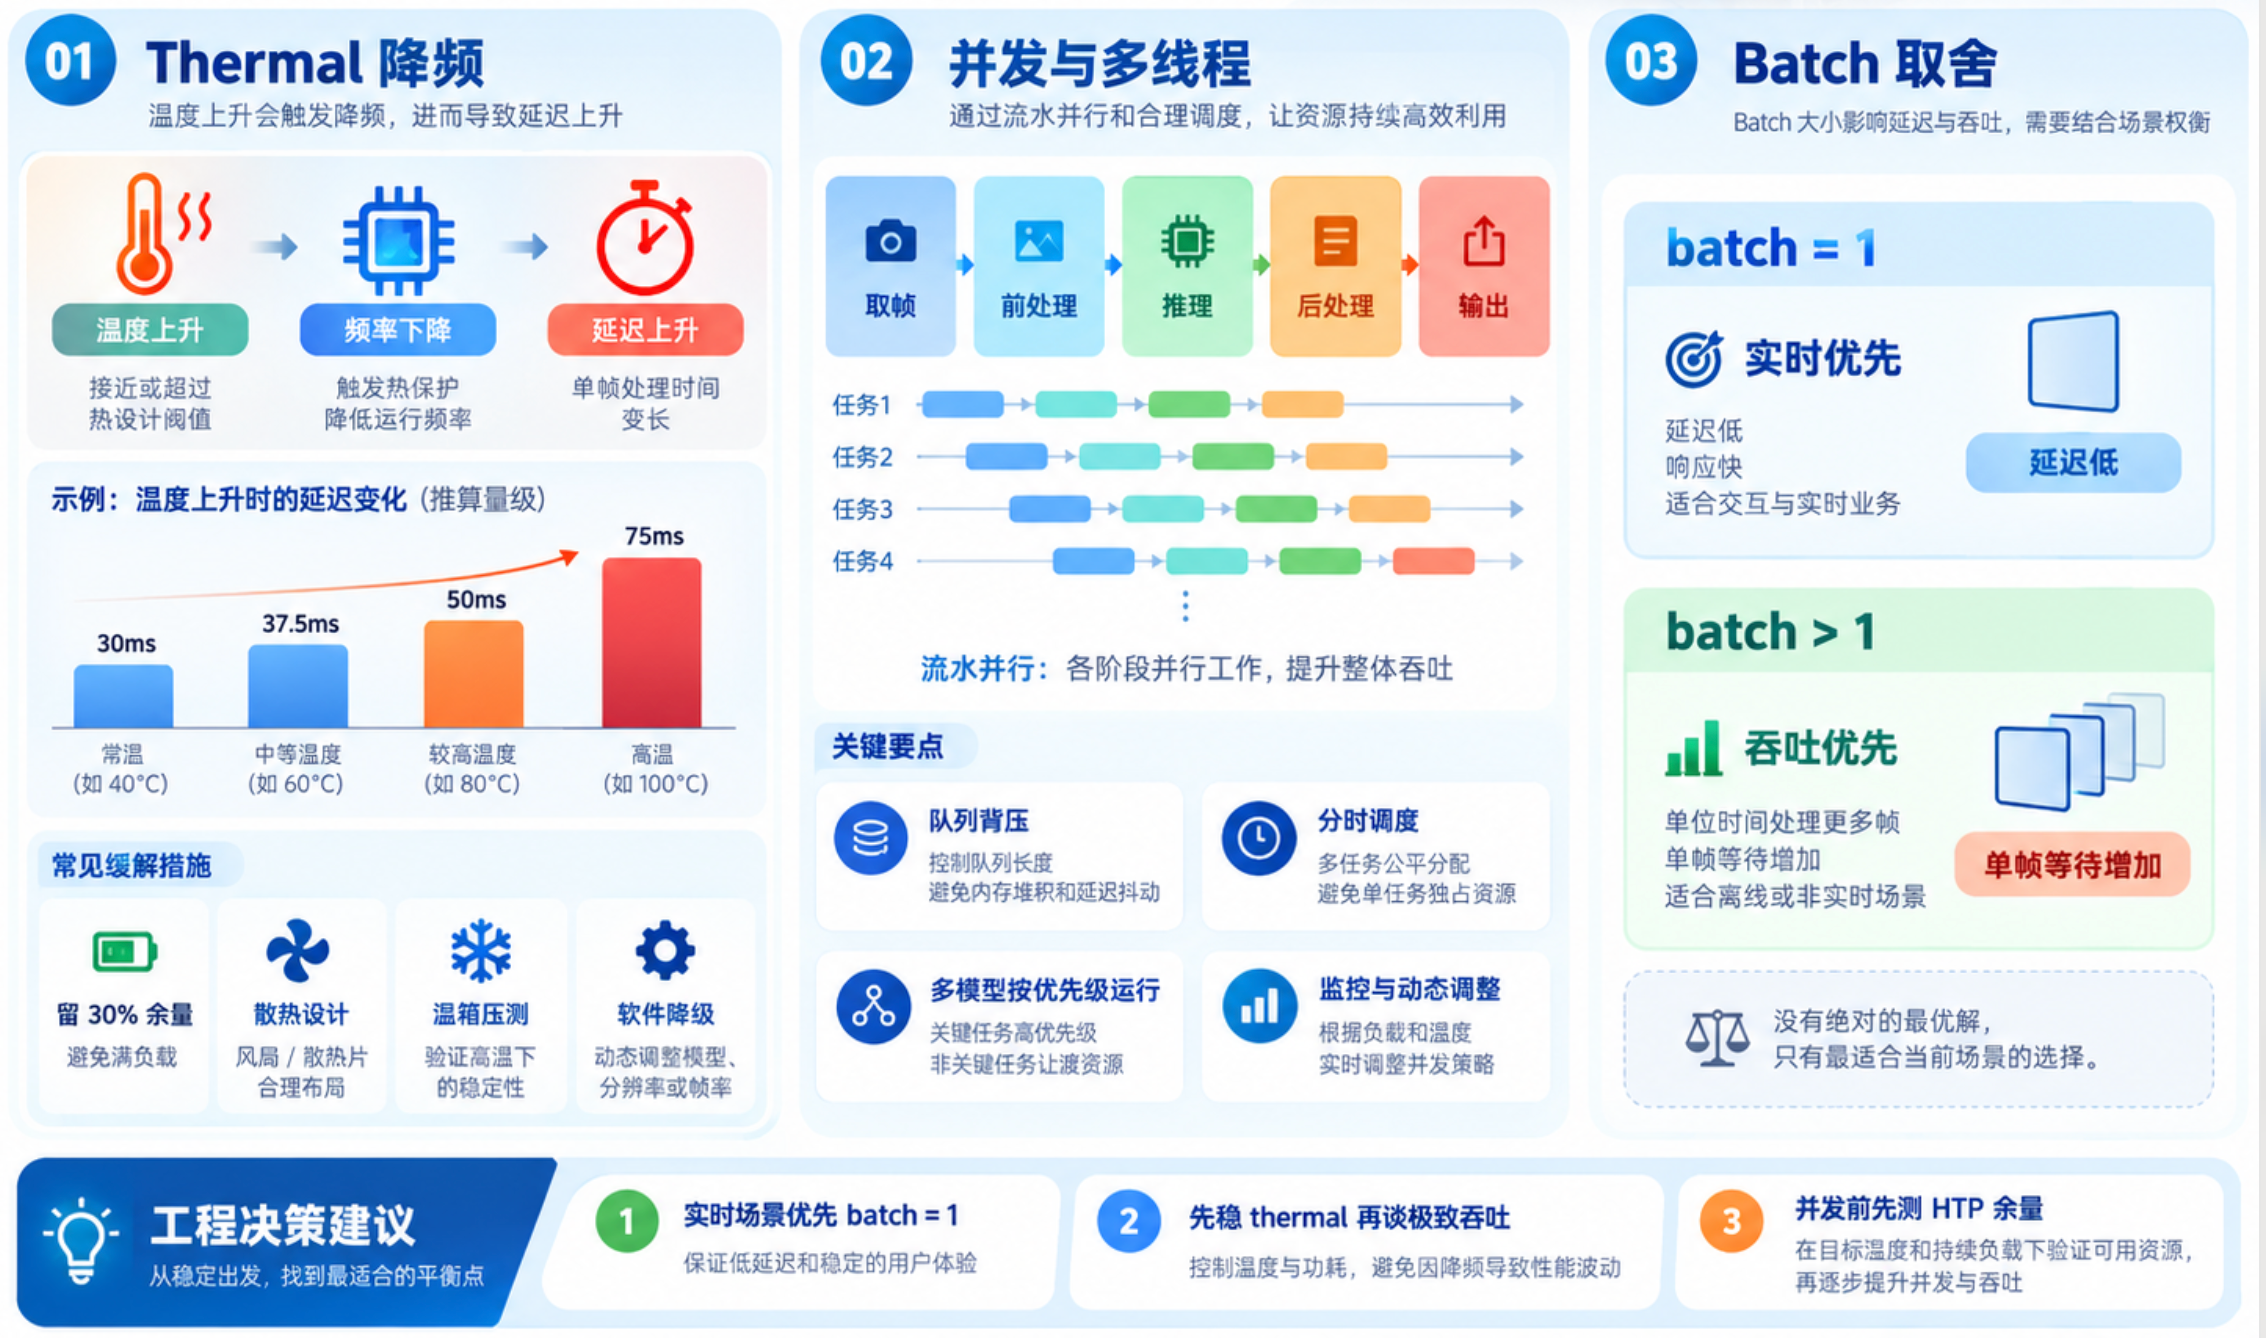
工程决策建议图
3.1 为什么边缘设备最怕热
手机可以烫手降频你无所谓,工业设备不行。边缘设备常装在无风扇、密闭、高温的环境里(电柜、车间、车顶)。SoC 持续满载 → 温度升 → 超过阈值 → thermal 降频(动态调低 CPU/NPU 频率以降温)→ 推理变慢 → 漏检/掉帧 → 现场故障。
[官方] 高通 SoC 内置温度监控与动态调频(thermal mitigation)机制,这是保护芯片的必需设计,但它的副作用就是"性能会随温度波动"。工程上不能假装它不存在,而要为它留余量。
3.2 thermal 降频的真实案例
一个真实(典型)案例:某视觉检测 demo 在空调房里跑得飞起(30ms/帧),搬到车间无风扇电柜里,前 20 分钟还行,之后温度过阈值开始降频,延迟逐渐爬到 90ms,检测开始漏检,产线报警。根因不是模型,是热设计余量不足 + 没做降频下的降级策略。
3.3 对策:功耗预算 / 散热 / 降频阈值
- 功耗预算留余量:设计阶段就按"峰值功耗 × 0.7"留 30% 余量,不让设备长期顶满跑(呼应第 09 讲 8.8)。
- 散热设计:导热垫、散热片、甚至小风扇;密闭环境考虑外壳导热。
- 降频阈值与策略:了解你板子的 thermal 阈值(官方资料),在软件层做"温度→降帧率/降分辨率"的平滑降级,而不是等系统硬降频才崩。
- 间歇负载:能间歇处理的任务(如巡检),用"采集一阵→推理一阵→休眠"替代持续满载。
3.4 降频前后延迟对比推算
# [推算] thermal 降频对端到端延迟的影响(量级示意,非实测)
def latency_under_throttle(base_ms, throttle_factor):
"""throttle_factor<1 表示频率被调低,实际耗时 = base / factor"""
return base_ms / throttle_factor
for f in [1.0, 0.8, 0.6, 0.4]:
print(f"降频系数 {f}: 单帧延迟 ≈ {latency_under_throttle(30, f):.1f} ms")
# 输出(推算): 1.0→30ms | 0.8→37.5 | 0.6→50 | 0.4→75 ms
[推算] 当降频到 0.4 倍频率,30ms 的推理变成 75ms,若你的延迟预算是 50ms,就会开始漏帧。这就是为什么余量必须提前留——等降频发生再补,往往来不及。
3.5 温箱测试:怎么做、怎么判
thermal 问题不能靠"摸着不烫"主观判断,要用温箱(thermal chamber)做定量化验证:
- 方法:把设备放进可控温箱,设定目标环境温度(如 50°C、60°C,模拟密闭电柜/车间工况),让它跑满你的真实负载(不是空载待机),持续数小时。
- 观测:记录温度曲线、各阶段 NPU 频率、端到端延迟、是否触发降频、降频后延迟是否超预算。
- 判定:在最高目标温度下,延迟仍需 ≤ 业务预算,且无宕机、无累积错误。不达标就回到 3.3 的对策(散热/余量/降级)。
[实测] 具体温箱设定温度、时长、判定阈值由你的产品规格定义,本讲只给方法框架,不替你定终值。很多团队跳过这步,结果现场一热就翻车——温箱压测是量产前的必答题,和"先点亮板子再谈 AI"(第 03 讲)一样,属于不可省略的地基。
四、并发、多线程与 batch 策略
4.1 多线程流水线
把"取帧 → 前处理 → 推理 → 后处理 → 输出"拆成多条流水线(呼应第 09 讲生产者-消费者)。好处:不同阶段并行,NPU 不用等前处理、后处理不用等 NPU。代价:队列缓冲要管好(背压/丢旧帧)。
4.2 多模型并发
机器人常要"检测 + 分割 + 位姿"。并发方式(见第 10 讲 3.3):串行(慢但简单)、并行(分时复用 HTP)。务必用 qnn-profile 实测各模型实占算力,再核定能否并发,不要拍脑袋。
4.3 batch 对吞吐的影响
batch>1 能提升吞吐(单位时间处理更多帧),但通常增加单帧延迟(要等凑够 batch)。这对"离线批量"友好,对"实时"不友好。
# [推算] batch 对吞吐与延迟的影响(量级示意)
def batch_effect(single_ms, batch, efficiency=0.85):
"""batch 推理总耗时 ≈ single_ms * batch / efficiency(有加速但不线性)"""
total = single_ms * batch / efficiency
return total, total / batch
for b in [1, 2, 4, 8]:
t, per = batch_effect(30, b)
print(f"batch={b}: 总 {t:.1f} ms, 单帧等效 {per:.1f} ms, 吞吐 {1000/per:.0f} fps")
# 输出(推算): 吞吐随 batch 升,但单帧等效延迟也升——实时场景要权衡
4.4 并发与 batch 决策
#mermaid-svg-A1nO7U5srtGFD3dD{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-A1nO7U5srtGFD3dD .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-A1nO7U5srtGFD3dD .error-icon{fill:#552222;}#mermaid-svg-A1nO7U5srtGFD3dD .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-A1nO7U5srtGFD3dD .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-A1nO7U5srtGFD3dD .marker{fill:#333333;stroke:#333333;}#mermaid-svg-A1nO7U5srtGFD3dD .marker.cross{stroke:#333333;}#mermaid-svg-A1nO7U5srtGFD3dD svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-A1nO7U5srtGFD3dD p{margin:0;}#mermaid-svg-A1nO7U5srtGFD3dD .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-A1nO7U5srtGFD3dD .cluster-label text{fill:#333;}#mermaid-svg-A1nO7U5srtGFD3dD .cluster-label span{color:#333;}#mermaid-svg-A1nO7U5srtGFD3dD .cluster-label span p{background-color:transparent;}#mermaid-svg-A1nO7U5srtGFD3dD .label text,#mermaid-svg-A1nO7U5srtGFD3dD span{fill:#333;color:#333;}#mermaid-svg-A1nO7U5srtGFD3dD .node rect,#mermaid-svg-A1nO7U5srtGFD3dD .node circle,#mermaid-svg-A1nO7U5srtGFD3dD .node ellipse,#mermaid-svg-A1nO7U5srtGFD3dD .node polygon,#mermaid-svg-A1nO7U5srtGFD3dD .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-A1nO7U5srtGFD3dD .rough-node .label text,#mermaid-svg-A1nO7U5srtGFD3dD .node .label text,#mermaid-svg-A1nO7U5srtGFD3dD .image-shape .label,#mermaid-svg-A1nO7U5srtGFD3dD .icon-shape .label{text-anchor:middle;}#mermaid-svg-A1nO7U5srtGFD3dD .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-A1nO7U5srtGFD3dD .rough-node .label,#mermaid-svg-A1nO7U5srtGFD3dD .node .label,#mermaid-svg-A1nO7U5srtGFD3dD .image-shape .label,#mermaid-svg-A1nO7U5srtGFD3dD .icon-shape .label{text-align:center;}#mermaid-svg-A1nO7U5srtGFD3dD .node.clickable{cursor:pointer;}#mermaid-svg-A1nO7U5srtGFD3dD .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-A1nO7U5srtGFD3dD .arrowheadPath{fill:#333333;}#mermaid-svg-A1nO7U5srtGFD3dD .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-A1nO7U5srtGFD3dD .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-A1nO7U5srtGFD3dD .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-A1nO7U5srtGFD3dD .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-A1nO7U5srtGFD3dD .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-A1nO7U5srtGFD3dD .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-A1nO7U5srtGFD3dD .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-A1nO7U5srtGFD3dD .cluster text{fill:#333;}#mermaid-svg-A1nO7U5srtGFD3dD .cluster span{color:#333;}#mermaid-svg-A1nO7U5srtGFD3dD div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-A1nO7U5srtGFD3dD .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-A1nO7U5srtGFD3dD rect.text{fill:none;stroke-width:0;}#mermaid-svg-A1nO7U5srtGFD3dD .icon-shape,#mermaid-svg-A1nO7U5srtGFD3dD .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-A1nO7U5srtGFD3dD .icon-shape p,#mermaid-svg-A1nO7U5srtGFD3dD .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-A1nO7U5srtGFD3dD .icon-shape .label rect,#mermaid-svg-A1nO7U5srtGFD3dD .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-A1nO7U5srtGFD3dD .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-A1nO7U5srtGFD3dD .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-A1nO7U5srtGFD3dD :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
实时
批量
请求类型
实时 or 批量?
batch=1 + 流水并行 + 留 thermal 余量
batch>1 提吞吐 + 允许更高延迟
4.5 并发配置实战:两模型分时复用 HTP
多模型并发时,HTP 是共享资源。一个稳妥的编排方式是用一个"推理调度器"串行喂不同模型,避免两个模型同时抢 HTP 导致上下文切换开销:
# [推算] 多模型分时调度示意(非抢占并发,而是排队分时)
import queue, threading
jobs = queue.Queue()
def scheduler():
while True:
model, frame = jobs.get()
det = model.run(frame) # 同一时刻只有一个模型在 HTP 上跑
dispatch(det)
# 检测节点、分割节点都把请求投入 jobs,由调度器串行执行
比起"两个进程各开一个 NPU session 互抢",排队分时往往更可控、延迟更可预测。是否真要并发,仍要以 qnn-profile 实测各模型实占算力后裁定(呼应 2.1)——并发不是默认选项,是"余量确实够"时的优化项。
五、模型轻量化
5.1 算子融合
许多框架会把连续的小算子(如 Conv+BN+ReLU)融合成一个,减少层间调度与读写。在 QNN 转换阶段(第 05 讲),编译器通常会做图优化与融合;你也可以在模型设计阶段主动用融合友好的结构。
5.2 剪枝与更小骨干
- 剪枝:去掉冗余通道/权重,模型变小变快,但要重训或微调,可能掉点(呼应第 06 讲精度纪律)。
- 更小骨干:YOLO-Nano、MobileNet 类轻量网络,用"小一点但够用"换大吞吐。选型时按第 02 讲"场景负载"匹配,别一上来就上最大模型。
5.3 输入分辨率权衡
检测精度随分辨率升,但算力随分辨率平方级涨。很多场景 640×640 就够,硬上 1280×1280 算力翻 4 倍。按业务最小够用分辨率定,是性价比最高的优化。
5.4 精度 vs 速度 权衡表
| 降输入分辨率 | 高(平方级) | 中 | 大目标/近距离 |
| 更小骨干 | 高 | 中 | 通用 |
| 算子融合 | 中 | 低 | 几乎必做 |
| 剪枝 | 中高 | 中高 | 有重训资源时 |
| INT8 量化 | 高 | 低-中 | 第 06 讲必做 |
5.5 量化与轻量化的协同
量化(第 06 讲)和轻量化不是二选一,而要协同:先选轻量骨干(结构轻)→ 再做 INT8 量化(表示轻)→ 最后算子融合(调度轻)。顺序也有讲究——结构优化在前,表示优化在后;若量化完再大改结构,容易前功尽弃。这套组合拳,往往能把一个"在 QCS6490 上跑不动"的模型,变成"流畅实时"的模型,而不必立刻升级到 QCS8550(呼应第 02 讲选型纪律:先用最小代价满足场景,别动不动就上更大 SoC)。
5.6 轻量化的边界:什么时候该换 SoC
轻量化不是万能药。当你已经做完:降分辨率到业务下限、换最小够用骨干、INT8 量化、消除 fallback 层、算子融合,但单模型实时性仍不达标,那就不是"模型没调好",而是"平台算力天花板到了"——此时继续榨模型收益递减,正确动作是升级 SoC(呼应第 02 讲选型逻辑):
- 犀牛派 A1(QCS6490,~12 TOPS)扛不住 → 看 QCS8550(~48+12 TOPS);
- 多路高分辨率视觉伺服 → 看 IQ-9075(~100 TOPS,12–16 路相机)。
判断标准很简单:先穷尽软件侧优化,再谈硬件升级。很多团队一慢就换更大 SoC,结果新平台照样被 fallback 层和带宽墙拖死——因为根因根本不是算力。反过来,该换不换,硬在 QCS6490 上跑本该 QCS8550 的负载,也是浪费人力。这条"软件优先、硬件兜底"的线,是全系列选型与调优的共同纪律。
以"双路 1080p 实时检测 + 分割"为例:在 QCS6490 上即便轻量化到极致,HTP 占用也会长期顶满、thermal 必降频;换 QCS8550 后同等负载只占约 40% HTP,余量充足、还可叠加更多模型。这个例子说明:当负载进入"旗舰 SoC 才从容"的区间,继续在入门 SoC 上硬撑是工程上的执念,不是理性——调优的尽头是选型,选型的起点是调优,二者本就是同一件事的两面。
六、量产迁移:从开发板到 OEM
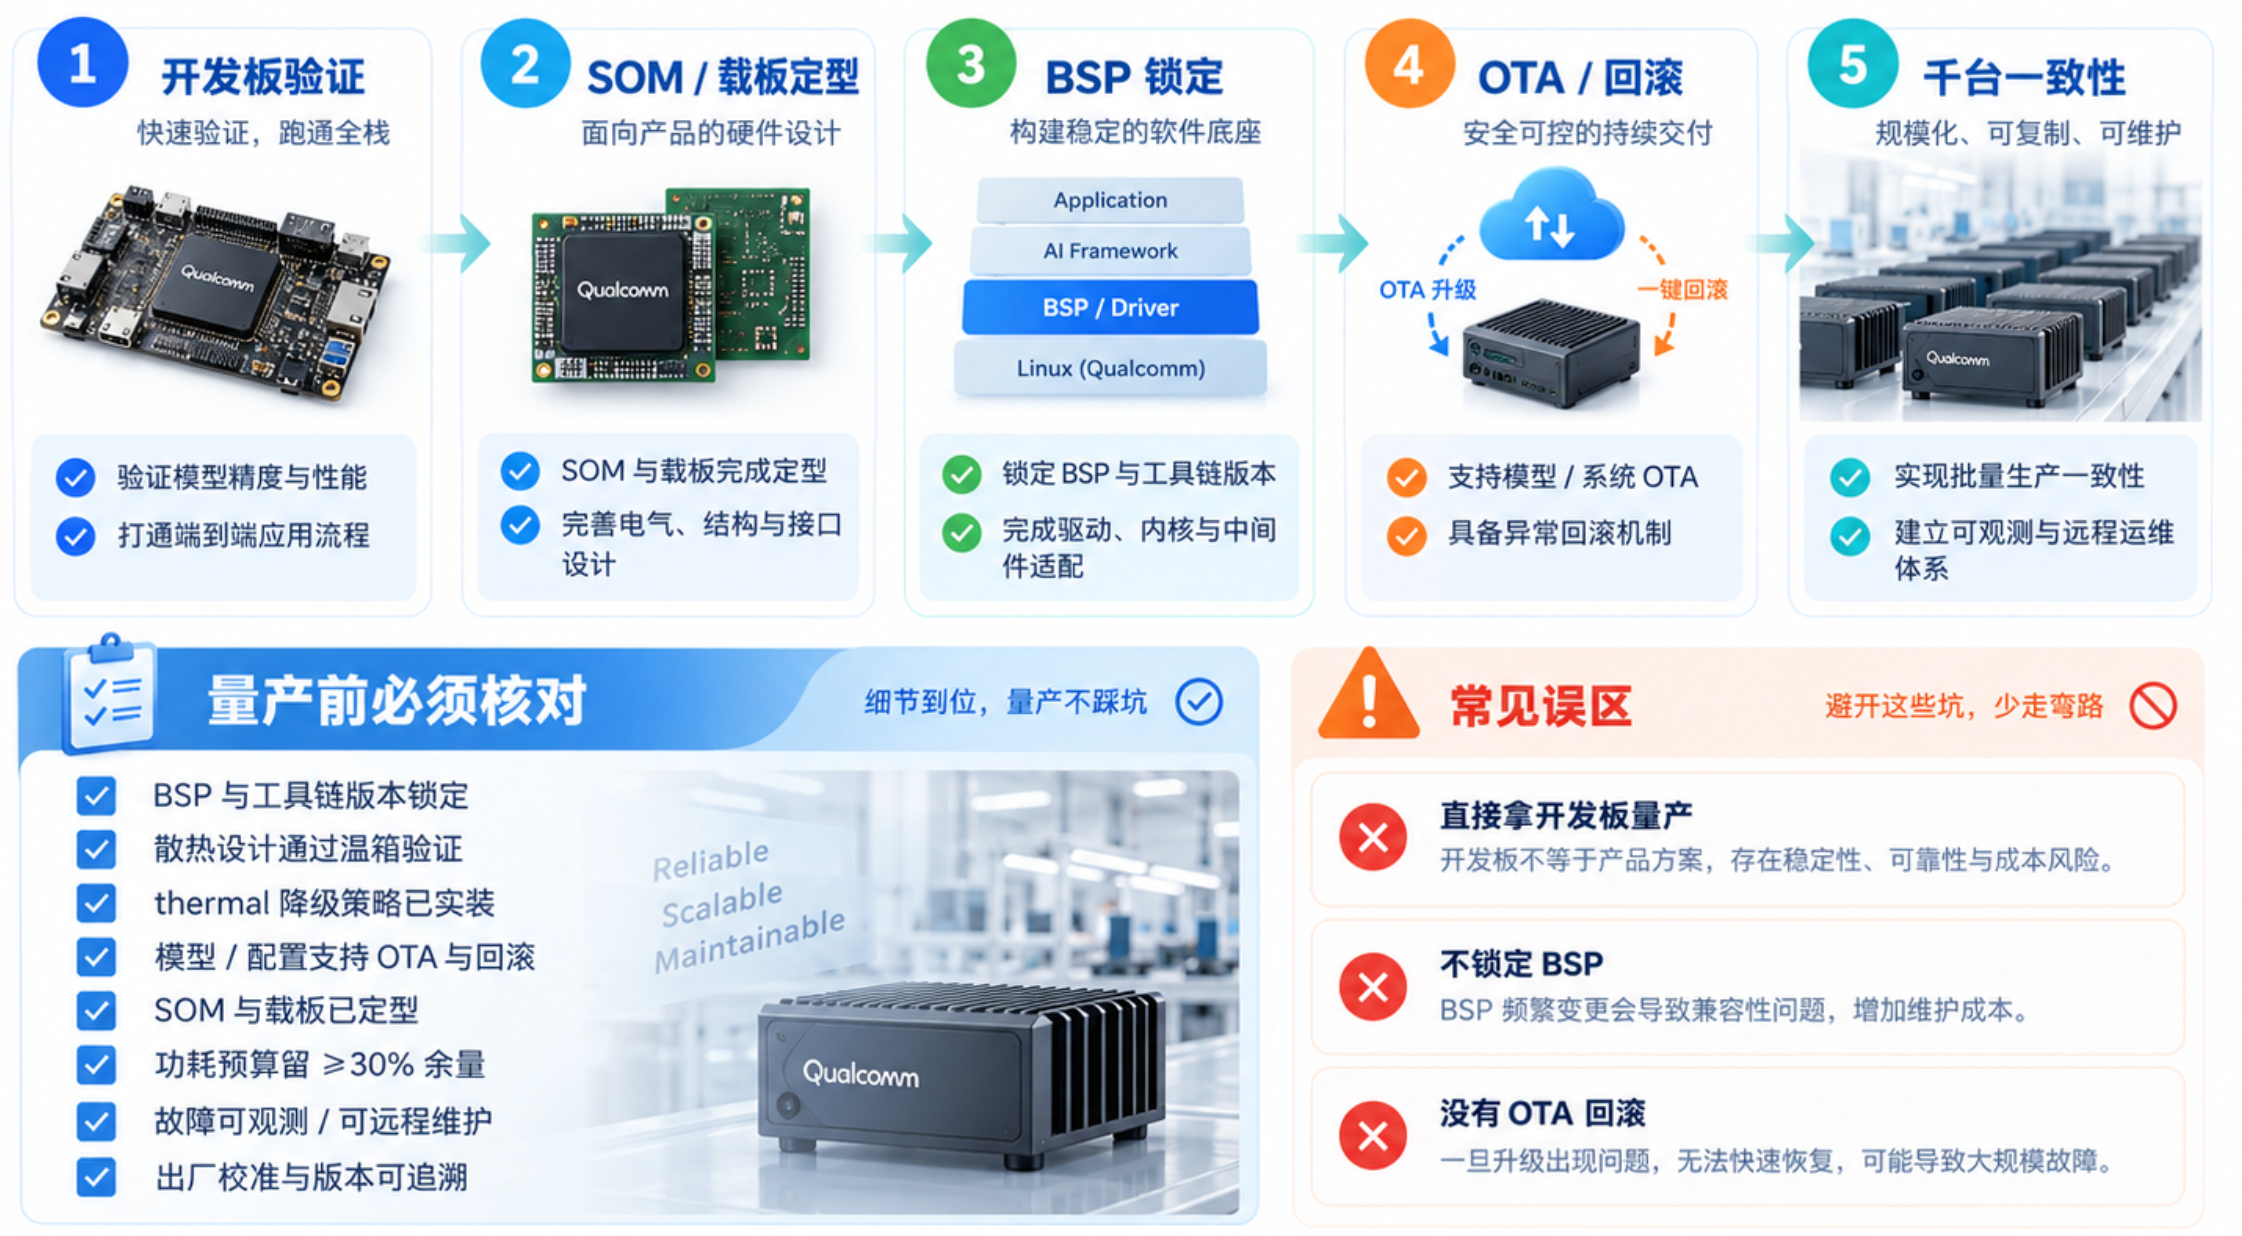
生产检测清单图
6.1 SOM vs 开发板
开发板(如犀牛派 A1)是"开发验证平台",尺寸、接口、成本都不适合直接塞进产品。**SOM(System on Module,系统级模块)**才是量产形态:把 SoC + 内存 + 基础电源做在小模块上,你只需设计载板(carrier board)。量产该用 SOM 而非裸开发板。
6.2 BSP 锁定
BSP(板级支持包)是连接硬件与系统的软件层。开发阶段你可能用"最新 BSP",但量产必须锁定一个经过验证的 BSP 版本——否则一次系统更新可能让模型跑不动或掉性能。BSP 版本和工具链版本(第 04 讲)必须配套管理。
术语纪律提示:BSP、SOM、散热片、外壳这些都是硬件物料(BOM)层面的概念,属于"硬件物料清单"范畴;模型、SDK、工具链版本属于技术栈(软件)。两者别混用——BOM 是硬件成本,技术栈是软件栈,这是全系列反复强调的术语纪律。
6.3 量产固件与 OTA
量产设备要能远程升级(OTA):模型更新、BSP 补丁、bug 修复都得能远程推送。这意味着你的模型、配置、节点(第 10 讲容器化)要设计成可独立下发、可回滚。没有 OTA 能力,千台设备的维护成本会压垮团队。
6.4 量产 checklist
- BSP 版本已锁定且与工具链配套
- SOM/载板定型,散热设计通过温箱验证
- thermal 降频下的降级策略已实装并压测
- 模型/配置可 OTA、可回滚
- 千台一致性:出厂校准、模型版本一致
- 功耗预算留 ≥30% 余量
- 故障可观测(日志/健康节点,第 10 讲运维层)
6.5 量产一致性:千台怎么保证一样
开发板调好一台容易,难的是"千台表现一致"。一致性来自三件事:
- 出厂校准:相机模组/传感器有个体差异,需在出厂做标定(白平衡、内参、增益等)。
- 版本固化:BSP、模型、配置全部锁定版本号,写入设备且可追溯。
- 老化筛选:高温老化中筛掉早期失效个体,把"出生就体弱"的设备挡在出厂前。
[推算] 一致性不是"每台都完美",而是"每台都在规格区间内、且可追溯到同一套固化版本"。这部分属于制造质量体系,本讲只点出它和前面工程工作的接口:你锁定的 BSP/模型版本(6.2/6.3),正是量产一致性的锚点——工程做得越规范,制造端越省心。
6.6 术语速查卡
- BSP(Board Support Package):板级支持包,连接硬件与系统软件,量产须锁定版本。
- SOM(System on Module):系统级模块,量产硬件形态,把 SoC + 内存 + 基础电源集成在小模块上。
- Thermal Throttling(thermal 降频):超温后动态降频保护芯片,副作用是性能波动。
- OTA(Over-The-Air):远程升级,量产设备必备,须可灰度、可回滚。
- Hotspot Layer(热点层):profile 中耗时占比最高的层,优化优先级最高。
- Fallback 层:不被 HTP 支持、被迫跑在 CPU/GPU 的层,常是性能黑洞。
七、调优 checklist 与量产清单(速查)
7.1 性能调优 checklist
- qnn-profile 逐层耗时已读,热点 TOP5 已优化
- fallback 到 CPU 的层已尽量消除或替换
- 零拷贝/硬件预处理已启用(减数据搬运)
- 多线程流水已搭,NPU 不空等
- batch 策略按实时/批量选定
- 模型已轻量化(分辨率/骨干/融合/量化)
7.2 生产化 checklist
- thermal 降频对策已实装,温箱压测通过
- 功耗预算留 ≥30% 余量
- BSP 锁定、SOM 定型
- OTA + 回滚能力具备
- 千台一致性方案就位
- 故障可观测、可远程维护
7.3 从开发板到量产的演进路径
把本讲和前面各讲串成一条"演进地图",能看清每阶段在收敛哪类风险:
#mermaid-svg-VnLjW1bCFfdiKhN9{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-VnLjW1bCFfdiKhN9 .error-icon{fill:#552222;}#mermaid-svg-VnLjW1bCFfdiKhN9 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-VnLjW1bCFfdiKhN9 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .marker.cross{stroke:#333333;}#mermaid-svg-VnLjW1bCFfdiKhN9 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-VnLjW1bCFfdiKhN9 p{margin:0;}#mermaid-svg-VnLjW1bCFfdiKhN9 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster-label text{fill:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster-label span{color:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster-label span p{background-color:transparent;}#mermaid-svg-VnLjW1bCFfdiKhN9 .label text,#mermaid-svg-VnLjW1bCFfdiKhN9 span{fill:#333;color:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .node rect,#mermaid-svg-VnLjW1bCFfdiKhN9 .node circle,#mermaid-svg-VnLjW1bCFfdiKhN9 .node ellipse,#mermaid-svg-VnLjW1bCFfdiKhN9 .node polygon,#mermaid-svg-VnLjW1bCFfdiKhN9 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .rough-node .label text,#mermaid-svg-VnLjW1bCFfdiKhN9 .node .label text,#mermaid-svg-VnLjW1bCFfdiKhN9 .image-shape .label,#mermaid-svg-VnLjW1bCFfdiKhN9 .icon-shape .label{text-anchor:middle;}#mermaid-svg-VnLjW1bCFfdiKhN9 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .rough-node .label,#mermaid-svg-VnLjW1bCFfdiKhN9 .node .label,#mermaid-svg-VnLjW1bCFfdiKhN9 .image-shape .label,#mermaid-svg-VnLjW1bCFfdiKhN9 .icon-shape .label{text-align:center;}#mermaid-svg-VnLjW1bCFfdiKhN9 .node.clickable{cursor:pointer;}#mermaid-svg-VnLjW1bCFfdiKhN9 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .arrowheadPath{fill:#333333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-VnLjW1bCFfdiKhN9 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-VnLjW1bCFfdiKhN9 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-VnLjW1bCFfdiKhN9 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster text{fill:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 .cluster span{color:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-VnLjW1bCFfdiKhN9 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-VnLjW1bCFfdiKhN9 rect.text{fill:none;stroke-width:0;}#mermaid-svg-VnLjW1bCFfdiKhN9 .icon-shape,#mermaid-svg-VnLjW1bCFfdiKhN9 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-VnLjW1bCFfdiKhN9 .icon-shape p,#mermaid-svg-VnLjW1bCFfdiKhN9 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-VnLjW1bCFfdiKhN9 .icon-shape .label rect,#mermaid-svg-VnLjW1bCFfdiKhN9 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-VnLjW1bCFfdiKhN9 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-VnLjW1bCFfdiKhN9 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-VnLjW1bCFfdiKhN9 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
开发板验证 第03-04讲
单模型跑通 第05-07讲
实时/媒体/机器人 第08-10讲
剖析+thermal+轻量化 本讲
锁定BSP/SOM/OTA 本讲
量产
每一阶段都在为下一阶段收敛风险:开发板阶段验证"能不能",实时阶段验证"快不快",本阶段验证"稳不稳、久不久、好不好造"。越往后,对一致性和可追溯的要求越高。这也解释了为什么 BSP 锁定、版本固化这些"枯燥"动作,是量产真正的分水岭——它们决定千台设备是不是"同一台设备的复制",还是"千台各跑各的"。
各阶段的交付物与验收标准可以这样对齐:
| 开发板验证(03–04) | 点亮板子、装好工具链 | NPU 节点可见、转换/量化/编译链路全通 |
| 单模型跑通(05–07) | context binary | HTP 上延迟达标(实测定数) |
| 实时/系统(08–10) | 相机/媒体栈/ROS2 节点 | 帧率、频率匹配、QoS 达标 |
| 调优(本讲前半) | profile 报告 + 降级策略 | 满载温箱压测通过、余量 ≥30% |
| 量产(本讲后半) | 锁定 BSP + SOM + OTA | 千台一致、可灰度、可回滚 |
八、坑点清单
8.1 只看单次延迟不看持续负载
症状:demo 快,量产慢。对策:做数小时满载压测,观察 thermal 曲线。
8.2 忽略 fallback 层
症状:NPU 利用率低却慢。对策:profile 看是否有大量层跑在 CPU。
8.3 把开发板直接当量产硬件
症状:产品体积/成本/可靠性全崩。对策:转 SOM + 载板,开发板只做验证。
8.4 BSP 不锁定
症状:一次更新后模型跑不动。对策:锁定验证过的 BSP 与工具链版本。
8.5 没有 OTA 与回滚
症状:千台设备bug只能人工刷。对策:设计可远程下发、可回滚的固件/模型。
8.6 精度与速度两头失
症状:量化+剪枝后掉点严重。对策:按第 06 讲纪律,校准集讲究、逐级验证。
8.7 盲目上最大模型
症状:算力不够、热炸。对策:按第 02 讲选型,最小够用分辨率与骨干。
8.8 把"玄学报错"变成可排查清单
边缘部署里大量"玄学"现象,本质都是可定位的工程问题。把它们列成对照表,能省下无数瞎调的时间:
| 跑着跑着越来越卡 | thermal 降频 | 留功耗余量 + 软件降级(3.3) |
| NPU 利用率很高却还是慢 | 大量层 fallback 到 CPU | profile 查 backend,替换不支持算子 |
| 偶尔漏检、时好时坏 | 跳帧 / 队列满丢帧 | 调队列深度、降相机频率或轻量化 |
| 升级系统后突然跑不动 | BSP / 工具链版本漂移 | 锁定版本(6.2),回滚验证 |
| 板子烫到降频但室温不高 | 密闭无散热设计 | 加导热/散热片,改间歇负载 |
| 多模型一起跑全变慢 | HTP 被并发抢占 | 分时调度(4.5),实测余量后再并发 |
这张表的价值不在"记住答案",而在建立一种习惯:任何异常先回到"功耗 / 热 / 带宽 / 版本"四件套去归因,而不是怀疑模型或运气。
九、FAQ
Q1:qnn-profile 给出的耗时和 qnn-net-run 的总耗时对不上? 正常。profile 是逐层细测(本身有开销),net-run 是端到端粗测;两者量级一致即可,精确定数以你选定的一种为准,并标注 [实测]。
Q2:thermal 降频能关掉吗? 强烈不建议。这是芯片保护机制,关掉可能永久损坏。正确做法是留余量 + 软件降级,而非硬扛。
Q3:降频后我的模型会出错吗? 模型计算本身不会"错",但延迟变长会导致漏帧/超时,表现为"检测漏了"。这是系统层失败,不是模型精度问题。
Q4:多模型并发到底要不要做? 看负载。若单模型已吃满 HTP,并发只会互相拖;若都有余量,并发能提利用率。用 profile 实测说话。
Q5:SOM 和开发板怎么选? 开发验证用开发板(犀牛派 A1 这类),量产用 SOM + 载板。开发板直接进产品,尺寸/成本/BOM 都不合适。
Q6:OTA 推送模型有风险吗? 有(推错版本全崩)。所以必须"可灰度 + 可回滚":先小批量推,验证 OK 再全量,出问题一键回滚。
Q7:轻量化从哪下手性价比最高? 通常是"降输入分辨率"和"用更小骨干",二者都不动模型结构就能拿大收益;算子融合编译器常自动做。
Q8:BOM 在这里指什么? 指硬件物料清单——SOM、载板、散热片、外壳、电源等硬件成本。模型/SDK 不算 BOM,那是技术栈(软件)。本讲谈"量产成本"时说的 BOM 就是这个硬件含义。
Q9:本讲和第 09/10 讲怎么衔接? 第 09 讲的队列缓冲、第 10 讲的频率匹配,都是为 thermal 波动预留弹性的手段;本讲把它们上升到"系统级余量与降级策略"。
Q10:thermal 余量留多少合适? 没有万能数。一般建议设计峰值功耗 ≥30% 余量(即只用到芯片可持续输出能力的 70%),再用温箱实测(3.5)确认在目标温度下不超预算。余量太小现场必翻车,太大浪费成本——以实测为准。
Q11:profile 显示全是 HTP 层但还是慢,怎么办? 那说明瓶颈不在 fallback,而在"数据搬运"或"层间等待"。优先查是否 zero-copy、前处理是否走了 ISP/硬件(第 08/09 讲),再考虑轻量化骨干。不要一慢就换更大 SoC,先榨干现有平台的优化空间。
Q12:本讲讲的这些,怎么和预算/SOP 挂钩? 把"thermal 余量、OTA 灰度、BSP 锁定、千台一致性"写进项目 SOP 与验收标准,而不是靠个人经验兜底。这些条目每一条都是可勾选、可审计的交付物——本讲的所有 checklist 直接能转成研发排期与测试用例,这也是"能跑"与"能交付"之间最实在的一道分水岭。
十、结论与下讲预告
本讲你实际搭起来的能力:从"实验室能出结果"走到"现场 7×24 扛得住、千台造得出"。你掌握了用 qnn-profile 定位热点、识别 fallback 层;理解了 thermal 降频这一边缘部署头号"玄学"的真身与对策;学会了并发/batch/轻量化的权衡;并看清了从开发板到 SOM、BSP 锁定、OTA 的量产迁移路径。这些能力加起来,正是把"demo"和"产品"区分开的那道工程护城河。
给团队的实施顺序建议:不要一上来就追求"最快"。正确的次序是:① 用 net-run 确认功能与基线延迟;② 用 profile 定位热点;③ 先消除 fallback 层、再做轻量化、最后才上并发/batch;④ 做温箱压测与 thermal 降级;⑤ 最后锁定 BSP/SOM/OTA 进入量产。前一步没稳,后一步都是空中楼阁——这套次序,和全系列"先正确、再优化、再量产"的方法论完全一致,也是本讲最想留给你的工程直觉。这套次序的底层逻辑只有一句:让每一步的产出都成为下一步可依赖的输入,而不是每一步都从零开始猜——这恰好是前面 11 讲一直在做的事:第 03 讲点亮板子是第 04 讲装工具链的输入,第 05–07 讲的 context binary 是第 08–10 讲系统的输入,本讲的量产检查单又是第 12 讲收官的输入。
核心一句话:从"能跑"到"能交付",靠的是剖析定位热点、为热留余量、用并发/batch/轻量化提速,最后把开发板换成锁定的 SOM 量产形态——工程化的最后一公里,往往比写模型更难也更重要。
下一讲(第 12 讲,收官) 我们用一个端到端案例把全 12 讲串成一条完整路径,给出 artifact 衔接链、五大坑上机检查单、系列知识地图与生态路线图。系列到这里就收口了。届时你会看到,本讲这叠 checklist 正是收官讲"artifact 衔接链"里压轴的一环。
本讲所有 profile 读数结构、thermal 系数、batch/延迟推算与代码,均为架构示意与量级估算;具体的工具字段名、thermal 阈值、BSP 版本与一切实测数值,务必在你的犀牛派 A1 真机上用 qnn-profile 与温箱实测确认,不要直接拿本讲的推算值当终值或当规格承诺。
同理,SOM/载板/散热片等硬件物料(BOM)的具体选型,也请以阿加犀/高通官方资料与你的结构工程师确认为准——本讲谈量产迁移给的是方法论与检查单,不是某一款物料的采购清单。把这份方法论和检查单用起来,比对某一两颗具体料号更有长期价值:因为换项目、换 SoC,方法不变,料号常变。这也是全系列反复强调"术语要分清、方法要沉淀"的用意所在。
参考链接
- Qualcomm 边缘 AI 与 Dragonwing 平台概述
- Qualcomm AI Hub(模型库与云端编译)
- Qualcomm 开发者文档入口
- QNN / AI Engine Direct 工具文档(以官网为准)