AI 时代,Rust 代码一定要既可靠又"地道"——当 AI 会写 Rust 之后,什么才是工程师的核心价值
一、引言:AI 编程时代的悖论
我们正处在一个奇特的时刻:写代码从来没有这么容易过,但写出好代码从来没有这么难甄别过。
大语言模型可以在几秒钟内生成一段能通过编译的 Rust 代码。它记得住所有权规则,背得下标准库 API,甚至能写出颇为复杂的泛型约束。然而,只要你稍微审视这些代码,就会发现一种熟悉的味道——那是 C++ 的味道,只不过换上了 Rust 的语法外衣。
这个问题在 AI 基础设施领域尤为致命。过去几年,AI 技术栈的重心正在悄悄迁移:模型训练和算法原型依然是 Python 的天下,但凡是触及生产落地的环节——推理引擎、向量数据库、Agent 沙箱、大规模数据处理——都在大规模地转向 Rust。这意味着什么?意味着 AI 生成的 Rust 代码,正在以前所未有的速度进入支撑大模型服务的关键路径。一段"能跑但不好"的代码,在原型阶段是技术债,在生产环境里就是稳定性事故。 
所以今天想聊清楚三个问题:
这三个问题的答案,恰好对应了大卫·德赖斯代尔(David Drysdale)在《Effective Rust:编写高质量 Rust 代码的 35 个有效方法》中反复强调的一个判断:Rust 的核心优势是把安全约束左移到编译阶段,而编译器能保证的只是"可靠"的下限,"地道"的上限依然取决于开发者对语言工程范式的理解。
Effective Rust:编写高质量Rust代码的35个有效方法
想写出安全、地道的高质量Rust代码,却被生命周期、trait用法、工程化规范难住?本书为你而来!O’Reilly经典系列重磅新作,作者提炼35个核心有效方法,从类型系统、trait设计到依赖管理、工具实操,全流程拆解Rust编程精髓。书中聚焦惯用法与内存安全,搭配编译器优化技巧与实战案例,不管你是有基础的Rust学习者,还是寻求进阶的开发者,都能快速夯实核心能力,写出规范、高效的工业级Rust代码! 本书是Rust编程进阶指南,面向有基础的学习者。第1章讲解类型系统,涵盖基本类型、枚举等及类型转换等技巧;第2章聚焦Traits,介绍标准库Traits及设计原则;第3章解析生命周期、借用检查器等核心概念;第4章探讨依赖项管理,包括语义化版本、可见性等;第5章介绍文档、宏、测试等工具使用;第6章涉及no_std环境、FFI交互等进阶内容。全书通过具体条款提供实用建议,帮助读者写出规范、高效的Rust代码。如果你是一名具备现有编译型语言经验的软件工程师,或者你在将Rust语法的基础理解转化为实际可运行的程序时遇到了困难,那么这本书正是为你量身打造的。本书聚焦于Rust与其他编译型语言之间的概念差异,并提供了程序员可轻松遵循的具体建议。通过学习本书,你将很快写出流畅的Rust代码,而非蹩脚的“C++翻译版”代码。 David Drysdale是Google的高级软件工程师,自2019年起便从事Rust相关工作,主要聚焦安全领域。他牵头用Rust重写了Android的硬件加密子系统,还主导了加密库Tink的Rust移植工作。他还涉足C/C++和Go语言开发,参与过Linux内核研发、移动视频会议应用开发等各类项目。 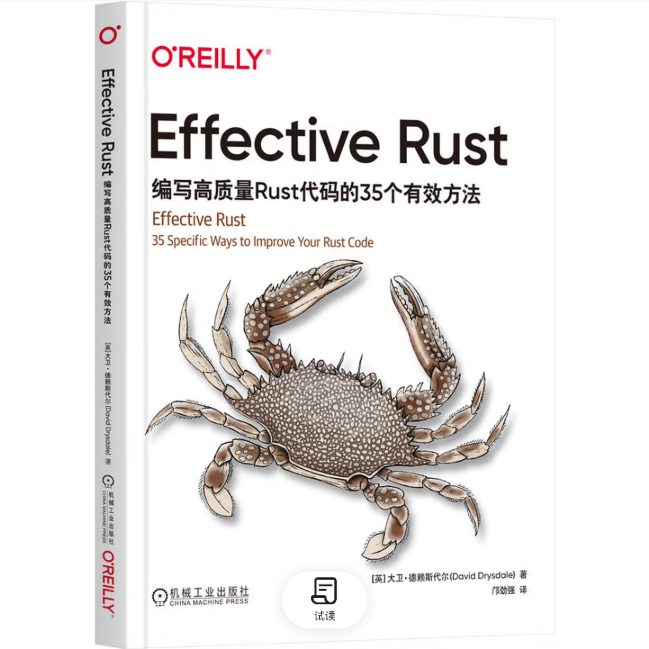
京东:https://item.jd.com/14642785.html 当当:https://product.dangdang.com/30012249.html
二、为什么 AI 基础设施选择了 Rust
2.1 Python 的辉煌与边界
Python 凭借简单易用的语法、无与伦比的生态(NumPy、PyTorch、HuggingFace Transformers),当之无愧地成为模型训练与算法原型的首选语言。"Python 写创意,C++ 写内核"曾是这个行业的默认分工。
但当 AI 项目从实验室原型走向生产落地,Python 的三个先天短板被急剧放大:
- 高并发场景下调度受限:GIL(全局解释器锁)让多线程形同虚设,asyncio 虽然缓解了 IO 密集场景,但 CPU 密集的推理调度依然捉襟见肘;
- 垃圾回收带来不可预测的延迟:推理服务对 P99 延迟极其敏感,一次 GC 停顿就可能让正在流式输出的 token 卡顿,用户感知到的就是"模型变卡了";
- 大规模内存操作极易引发内存泄漏与悬垂指针:当服务需要管理几十 GB 的模型权重、KV Cache 和并发请求时,靠开发者自觉管理内存,事故只是时间问题。
这三点直接造成大模型推理服务的抖动与稳定性下降——而这恰恰是生产环境最不能容忍的。
2.2 Rust 的进击:从边缘到核心
看看这几年 AI 基础设施的版图变化:
| HuggingFace | Tokenizer 库(tokenizers)与推理框架 Candle 均以 Rust 实现 |
| Qdrant | 高性能向量数据库,核心完全用 Rust 编写 |
| Polars | 取代 pandas 的大规模数据处理库,底层是 Rust |
| OpenAI | Rust 基金会白金会员,生产系统大量使用 Rust |
这个趋势不是偶然的时尚,而是技术必然。Rust 提供了四样 AI 生产环境最需要的东西:
2.3 一个被低估的巧合:Rust 天然适配 AI 辅助编程
还有一个有趣且常被低估的点:Rust 严格的编译器反馈闭环,天然适配 AI 辅助编程的工作流。
AI 生成代码最怕什么?怕错误发现得晚。Python 是动态类型语言,一个类型错误可能要等到运行到那一行才暴露;而 Rust 的编译器会把类型不匹配、生命周期冲突、借用违规在编译期一次性、精确地报出来,还附带上修改建议。
这形成了一个非常高效的闭环:
AI 生成代码 → 编译器报错 → 错误信息喂回 AI → AI 修正 → 再编译 → …
**编译器的报错信息,本质上成了 AI 修正代码的实时训练信号。**这也是为什么很多团队发现,用 AI 写 Rust 的"一次通过率"提升速度远快于写其他语言——因为反馈信号的质量高、噪声低。
但请注意这个闭环的一个隐藏缺陷:**编译器只能校验"可靠",无法校验"地道"。**AI 借助类型系统和借用检查可以快速收敛到"能编译",却很难自发收敛到"符合 Rust 工程规范"。这就引出了本文的核心矛盾。
三、AI 生成的 Rust:披着外衣的 C++
《Effective Rust》里有一个非常精辟的观察:大量开发者(如今应加上"大量 AI")写的 Rust,本质上是**“披着 Rust 外衣的 C++”**。具体表现为五种典型症状,我们逐一用代码对照来看。
3.1 症状一:大量显式 match,把 Option/Result 当可空指针用
AI 生成的代码里最常见的,就是把其他语言的 if (ptr != null) 思维直接翻译成嵌套 match:
// ❌ AI 式写法:把 Option 当可空指针层层解包
match users.get(user_id) {
Some(user) => match user.profile() {
Some(profile) => match profile.email() {
Some(email) => Some(email.clone()),
None => None,
},
None => None,
},
None => None,
}
这段代码语法完全正确、编译毫无问题——但它是 C 的思维。地道的 Rust 会用标准库的组合子把整条链压平:
// ✅ 地道写法:链式组合子,一眼看清数据流向
users
.get(user_id)
.and_then(User::profile)
.and_then(Profile::email)
.cloned()
Option 和 Result 不是"带类型标注的 NULL",而是一整套可组合的错误处理代数结构。map、and_then、unwrap_or_else、? 运算符共同构成了 Rust 错误处理的惯用法。AI 常写的嵌套 match 虽然"可靠",却把代码的可读性和可维护性拖回了三十年前。
3.2 症状二:滥用 unsafe,把 Rust 写成"带警告的 C"
AI 模型在训练语料中见过海量 C/C++ 代码,遇到性能问题时会下意识地掏出裸指针:
// ❌ AI 式写法:一整块 unsafe 把所有逻辑裹进去
unsafe {
let ptr = libc::malloc(size) as *mut u8;
// … 几十行业务逻辑混在 unsafe 块里
// 手动偏移指针、手动算长度、手动释放
libc::free(ptr as *mut c_void);
}
unsafe 块一旦变大,"这段代码为什么是安全的"就再也没人能回答了。地道的做法是把 unsafe 的范围压缩到最小,并封装成一个对外完全安全的抽象:
// ✅ 地道写法:unsafe 被封死在边界内,对外接口全 safe
pub struct Buffer {
ptr: NonNull<u8>,
len: usize,
}
impl Buffer {
pub fn new(size: usize) -> Option<Self> {
let layout = Layout::from_size_align(size, 1).ok()?;
let ptr = NonNull::new(unsafe { alloc(layout) })?; // unsafe 仅此一处
Some(Buffer { ptr, len: size })
}
}
impl Drop for Buffer {
fn drop(&mut self) {
unsafe { dealloc(self.ptr.as_ptr(), Layout::from_size_align(self.len, 1).unwrap()) }
}
}
// 使用方完全接触不到 unsafe:
let mut buf = Buffer::new(1024).expect("alloc failed");
《Effective Rust》给出的准则是:安全抽象的义务在于实现者——unsafe 代码的作者有责任维护其安全性不变量,而使用者应该在无需理解内部细节的前提下放心调用。这正是 Rust 标准库自身遵循的哲学。
3.3 症状三:不合理的生命周期标注
AI 生成的代码经常出现两种极端:要么到处写冗余的生命周期标注,要么为了绕过借用检查直接 clone() 或 'static 了事。生命周期的本质是编译期对引用有效性的证明,正确的心智模型是"让标注描述真实的引用关系",而不是"把借用检查器哄开心"。
3.4 症状四:混乱的可见性
pub 一把梭是 AI 生成库代码的重灾区。殊不知 Rust 的模块系统提供了极为细粒度的可见性控制(pub(crate)、pub(super)、pub(in path)),API 的暴露面越小,未来演进的自由度就越大。这一点在第四章依赖管理部分还会展开。
3.5 症状五:过度使用裸指针与索引循环
// ❌ AI 式写法:C 风格索引循环
let mut result = Vec::new();
for i in 0..data.len() {
if data[i] > threshold {
result.push(data[i] * 2);
}
}
// ✅ 地道写法:迭代器链,零成本抽象
let result: Vec<_> = data
.iter()
.filter(|&&x| x > threshold)
.map(|x| x * 2)
.collect();
迭代器不只是语法糖:它消灭了越界风险(不存在索引),让惰性求值成为可能,且最终编译出的机器码通常与手写循环一样快——这正是"零成本抽象"的含义:高层表达,底层性能,两者不必二选一。
四、思维范式的转变:Rust 不是"更快的 C++"
上面五种症状背后,是同一个根源:用 C/C++ 的心智模型写 Rust。好代码的评判标准从来不是"能不能跑通",而是"是否地道"。
Rust 与 C++ 最根本的差异在于:C++ 的安全靠约定和运行时检查,Rust 的安全靠类型系统在编译期完成证明。所以地道的 Rust 写法,核心是三个转变:
4.1 把运行时检查变成编译期约束
能放进类型里的信息,绝不放在注释里;能在编译期拦住的错误,绝不留给运行时。这就是 newtype 模式的价值:
// ❌ 裸类型:语义全靠注释,单位混用全靠自觉
fn transfer(amount: f64, from: Account, to: Account) { /* … */ }
// amount 是元还是分?可以是负数吗?编译器一概不知
// ✅ newtype:把语义编码进类型
struct Cents(i64); // 用整数避免浮点精度问题
impl Cents {
fn new(raw: i64) -> Option<Self> {
if raw < 0 { None } else { Some(Cents(raw)) }
}
}
fn transfer(amount: Cents, from: &Account, to: &Account) { /* … */ }
现在"元当分用"这类经典事故在编译期就不可能发生——两种类型不匹配,代码根本写不出来。类型系统成了永远不过时的文档和永远不会偷懒的测试。
4.2 把不变量交给构造器
复杂类型应该提供构造器,保证任何被创建出来的实例都处于合法状态:
pub struct HttpRequest {
url: Url, // 已验证的 URL,而非裸 String
method: Method, // 枚举,而非裸 String
timeout: Duration,
}
impl HttpRequest {
/// 失败的构造路径在入口处集中暴露
pub fn new(url: &str) -> Result<RequestBuilder, HttpError> {
Ok(RequestBuilder {
url: Url::parse(url)?,
method: Method::Get,
timeout: Duration::from_secs(30),
})
}
}
一旦"非法状态不可表示",一大类防御性检查代码就从代码库里消失了。
4.3 把资源回收交给 RAII
Rust 没有 finally,也不需要——Drop trait 就是 RAII 的载体:
struct TempDir(PathBuf);
impl Drop for TempDir {
fn drop(&mut self) {
// 无论正常返回、早退还是 panic,临时目录都会被清理
let _ = fs::remove_dir_all(&self.0);
}
}
文件句柄、锁、数据库连接、临时目录——所有"必须配对释放"的资源,都应该封装成实现 Drop 的类型。这是 Rust 标准库的日常,也应该是业务代码的日常。
五、从类型设计到跨语言边界:六个维度的工程实践
《Effective Rust》的 35 条准则分布在六大章节,本质上是一套完整的思维范式清单。下面按维度梳理其中对 AI 时代工程实践最有价值的部分。
5.1 类型系统:让编译器替你做代码评审
除了前文的 newtype 与构造器,还有两个高频实践:
- 用 Option/Result 链式调用替代手写 match(见 3.1 节);
- 多用迭代器替代显式循环,减少索引越界等运行时错误的发生面。
一个实用的经验法则:当你在 Rust 里写下一大段嵌套 match 或手写下标循环时,先停下来想想——标准库是不是已经有更地道的组合子了?
5.2 Trait 设计:抽象的代价与收益
Trait 是 Rust 实现抽象与多态的核心机制,但"用泛型还是用 trait 对象"是一个必须显式权衡的决策:
// 静态分发(泛型):编译期单态化,零开销,但代码膨胀、类型传染
fn process<T: Encoder>(enc: &T, data: &[u8]) -> Vec<u8> { enc.encode(data) }
// 动态分发(trait 对象):一次虚表跳转,换来异构集合的灵活性
let encoders: Vec<Box<dyn Encoder>> = vec![Box::new(Gzip), Box::new(Zstd)];
经验法则:**热点路径、内层抽象用泛型(静态分发);插件式架构、异构集合用 trait 对象(动态分发)。**此外,善用 trait 的默认方法实现,可以让库的使用者"开箱即用",只需在必要时覆写。
5.3 生命周期与 unsafe:最考验功力的部分
这是全书最核心、也是 AI 最容易失手的领域,四条实践准则:
还有一条反直觉但重要的准则:**拒绝盲目过度优化。**先写清晰的代码,用工具找到真实瓶颈,再针对性优化。Rust 的抽象成本足够低,多数时候"清晰的代码"恰好也是"足够快的代码"。
5.4 依赖管理:大型项目的隐形战场
面向大型项目与开源库时,依赖管理是长期成本最高的领域之一:
- 理解语义化版本(Semantic Versioning):Cargo.toml 里的 1.2.3 表示"接受 1.2.x 和 1.x.y 的更新",主版本号的含义要真正理解;
- 缩小 API 对外暴露范围:内部实现细节用 pub(crate),不要让实现类型泄漏到公共签名里——否则每改一次内部实现都是 breaking change;
- 摒弃通配符导入:
// ❌ use std::collections::*;
// 命名冲突、可读性差、升级后行为悄悄改变,全是隐患
// ✅ use std::collections::HashMap;
// 每一个符号的来源一目了然
- 谨慎地重新导出第三方类型:一旦你的公共 API 暴露了某依赖的类型,该依赖就变成了你 API 的一部分,升级它就是 breaking change;
- 管控依赖图:警惕不必要的依赖与特性(feature)膨胀,依赖越多,供应链风险与编译时间越失控。
5.5 工具链:让机器守住质量下限
Rust 生态的工具链是其工程体验的最佳部分,四件套值得写进团队规范:
5.6 no_std 与 FFI:进阶边界
最后两个进阶维度,恰恰与 AI 的"端侧化"趋势直接相关:
- no_std 兼容性:让库能在无标准库的环境(嵌入式、边缘设备)运行。编写库时尽量把核心逻辑做成 no_std 兼容(依赖 core/alloc),标准库功能作为可选层。随着大模型向边缘设备下沉,这一维度正在从"锦上添花"变成"刚需";
- FFI 安全:与 Python(PyO3)、C/C++ 交互时,优先使用 bindgen 自动生成绑定,减少手写声明的笔误;跨语言边界是内存安全最容易失守的地方——外部数据一律视为不可信,边界处做完整的校验与所有权交接。
六、AI 工程视角的分工:Python 验证创意,Rust 承载生产
把前面的分析拼起来,可以得到一个清晰的 AI 时代技术分工图景:
Python 负责快速验证算法创意,Rust 负责承载高可靠、高性能的生产底座。编译器帮我们挡住内存错误,但代码是否优雅、API 是否合理、依赖是否可控,依然需要开发者自己把控。
这个分工对工程师提出了新的能力要求。AI 可以替你写出第一版代码,但甄别 AI 生成代码的隐患这件事,AI 自己做不好,机器也替不了你。原因很朴素:
- 编译器只能证明代码"类型正确、内存安全",无法证明它"设计合理、惯用清晰";
- AI 的输出分布由训练语料决定,而高质量地道的 Rust 代码在语料中的占比天然偏低(Rust 社区文化重视代码评审,大量好代码沉淀在私有仓库里);
- "是否地道"的判断需要理解语言的设计哲学,而不是背诵规则——这正是人类工程师相对 AI 的比较优势所在。
由此,AI 时代的 Rust 工程师工作流可以总结为一个循环:
AI 生成初稿 → 编译器 + Clippy 机械拦截 → 人工评审"是否地道"
→ 要求 AI 按惯用法重写 → 沉淀为团队模式库 → 反哺下一轮生成
《Effective Rust》的 35 条准则,恰好就是这个循环里"人工评审"环节的 checklist——它定位为 “Rust 的第二本读物”:第一本教你语法,第二本教你思维。
七、结语:可靠交给编译器,地道留给自己
回到标题:AI 时代,Rust 代码一定要既可靠又"地道"。这两个词的分工值得再强调一次:
- 可靠(reliable)是下限:内存安全、无数据竞争、类型正确——这些 Rust 编译器已经替我们守住了大半,AI 也能借助编译器反馈闭环快速达到;
- 地道(idiomatic)是上限:newtype 的语义表达、组合子的优雅、API 边界的克制、unsafe 的封装纪律、依赖图的管控——这些没有任何编译器能检查,只能靠工程师对语言工程范式的理解。
AI 大规模落地的浪潮里,Rust 正在成为 AI 基础设施的钢筋骨架。而决定这套骨架质量的,不是 AI 生成代码的速度,而是每一位工程师甄别代码、重塑代码的功力。
让编译器负责可靠,让自己负责地道——这大概就是 AI 时代 Rust 工程师的价值坐标。