一、说明
在前面的内存分配器的分析说明中,对相关的主流的分配器进行了分析。其实当时也说过,在更早些时候,已经对一些具体的分配器如jemalloc等进行过源码层面的分析。毕竟在一些大的数据库软件或开源的框架中,都应用了这些内存分配器。
mimalloc作为一个较新的内存分配器,是2019年才由微软研究院推出的。早期只是一个为Lean和Koka而使用的,后面才逐渐成为了一个通用的高性能内存分配器。它的核心不再是单纯增加线程缓存,而是把空闲链表按mimalloc page分片,并进一步拆成当前线程释放链表和跨线程释放链表,使常见的分配/释放路径短、局部性好、共享热点少。在最新的v3中又用Arena、Page Map和真正的first-class heap改进了跨线程内存共享及堆遍历。
mimalloc特别适合大量中小对象、高并发、对象跨线程释放、长生命周期服务和语言运行时;但是否优于系统分配器、jemalloc或TCMalloc必须由真实业务压测决定。替换分配器会改变RSS、虚拟内存、回收时机、故障表现和动态链接行为,不能只看平均吞吐。
有过操作系统的内存管理经验的都知道,内存的分配和回收不只是一个通用的接口,它会对整体系统的性能和资源占用产生深远的影响。其面对的内存应用场景非常复杂,如内存分配对象的大小不同、是否复用、内存的内部和外部碎片、虚拟地址空间的管理、内存对齐、再分配以及内存的监视、内存分配的延迟、次数以及RSS等都需要考虑。特别是在多线程/进程下的内存处理更是复杂。这对于内存分配器来说,都是一个艰巨的挑战。
其面临的主要问题包括:
- 局部性:相近时间创建的对象尽量位于同一小片内存,降低cache/TLB miss
- 可扩展性:线程本地分配不经过全局锁,跨线程释放只在对象所属page上做原子操作
- 碎片处理:同尺寸对象集中到page;page变空后可尽快把物理页归还给OS
- 尾延迟:把维护工作分摊到周期性慢路径,并限制一次慢路径处理的工作量
- 可集成性:代码和数据结构相对紧凑,支持Linux、Windows、macOS、BSD、WASM等环境
- 安全与诊断:提供secure、debug、guarded、ASan、Valgrind和ETW构建方式
二、整体架构
mimalloc page和4KiB等OS内存页不是一回事。mimalloc page更接近其他分配器中的slab/superblock,它是一个处理size class对象的管理单元;而后者是操作系统虚拟内存管理单位。
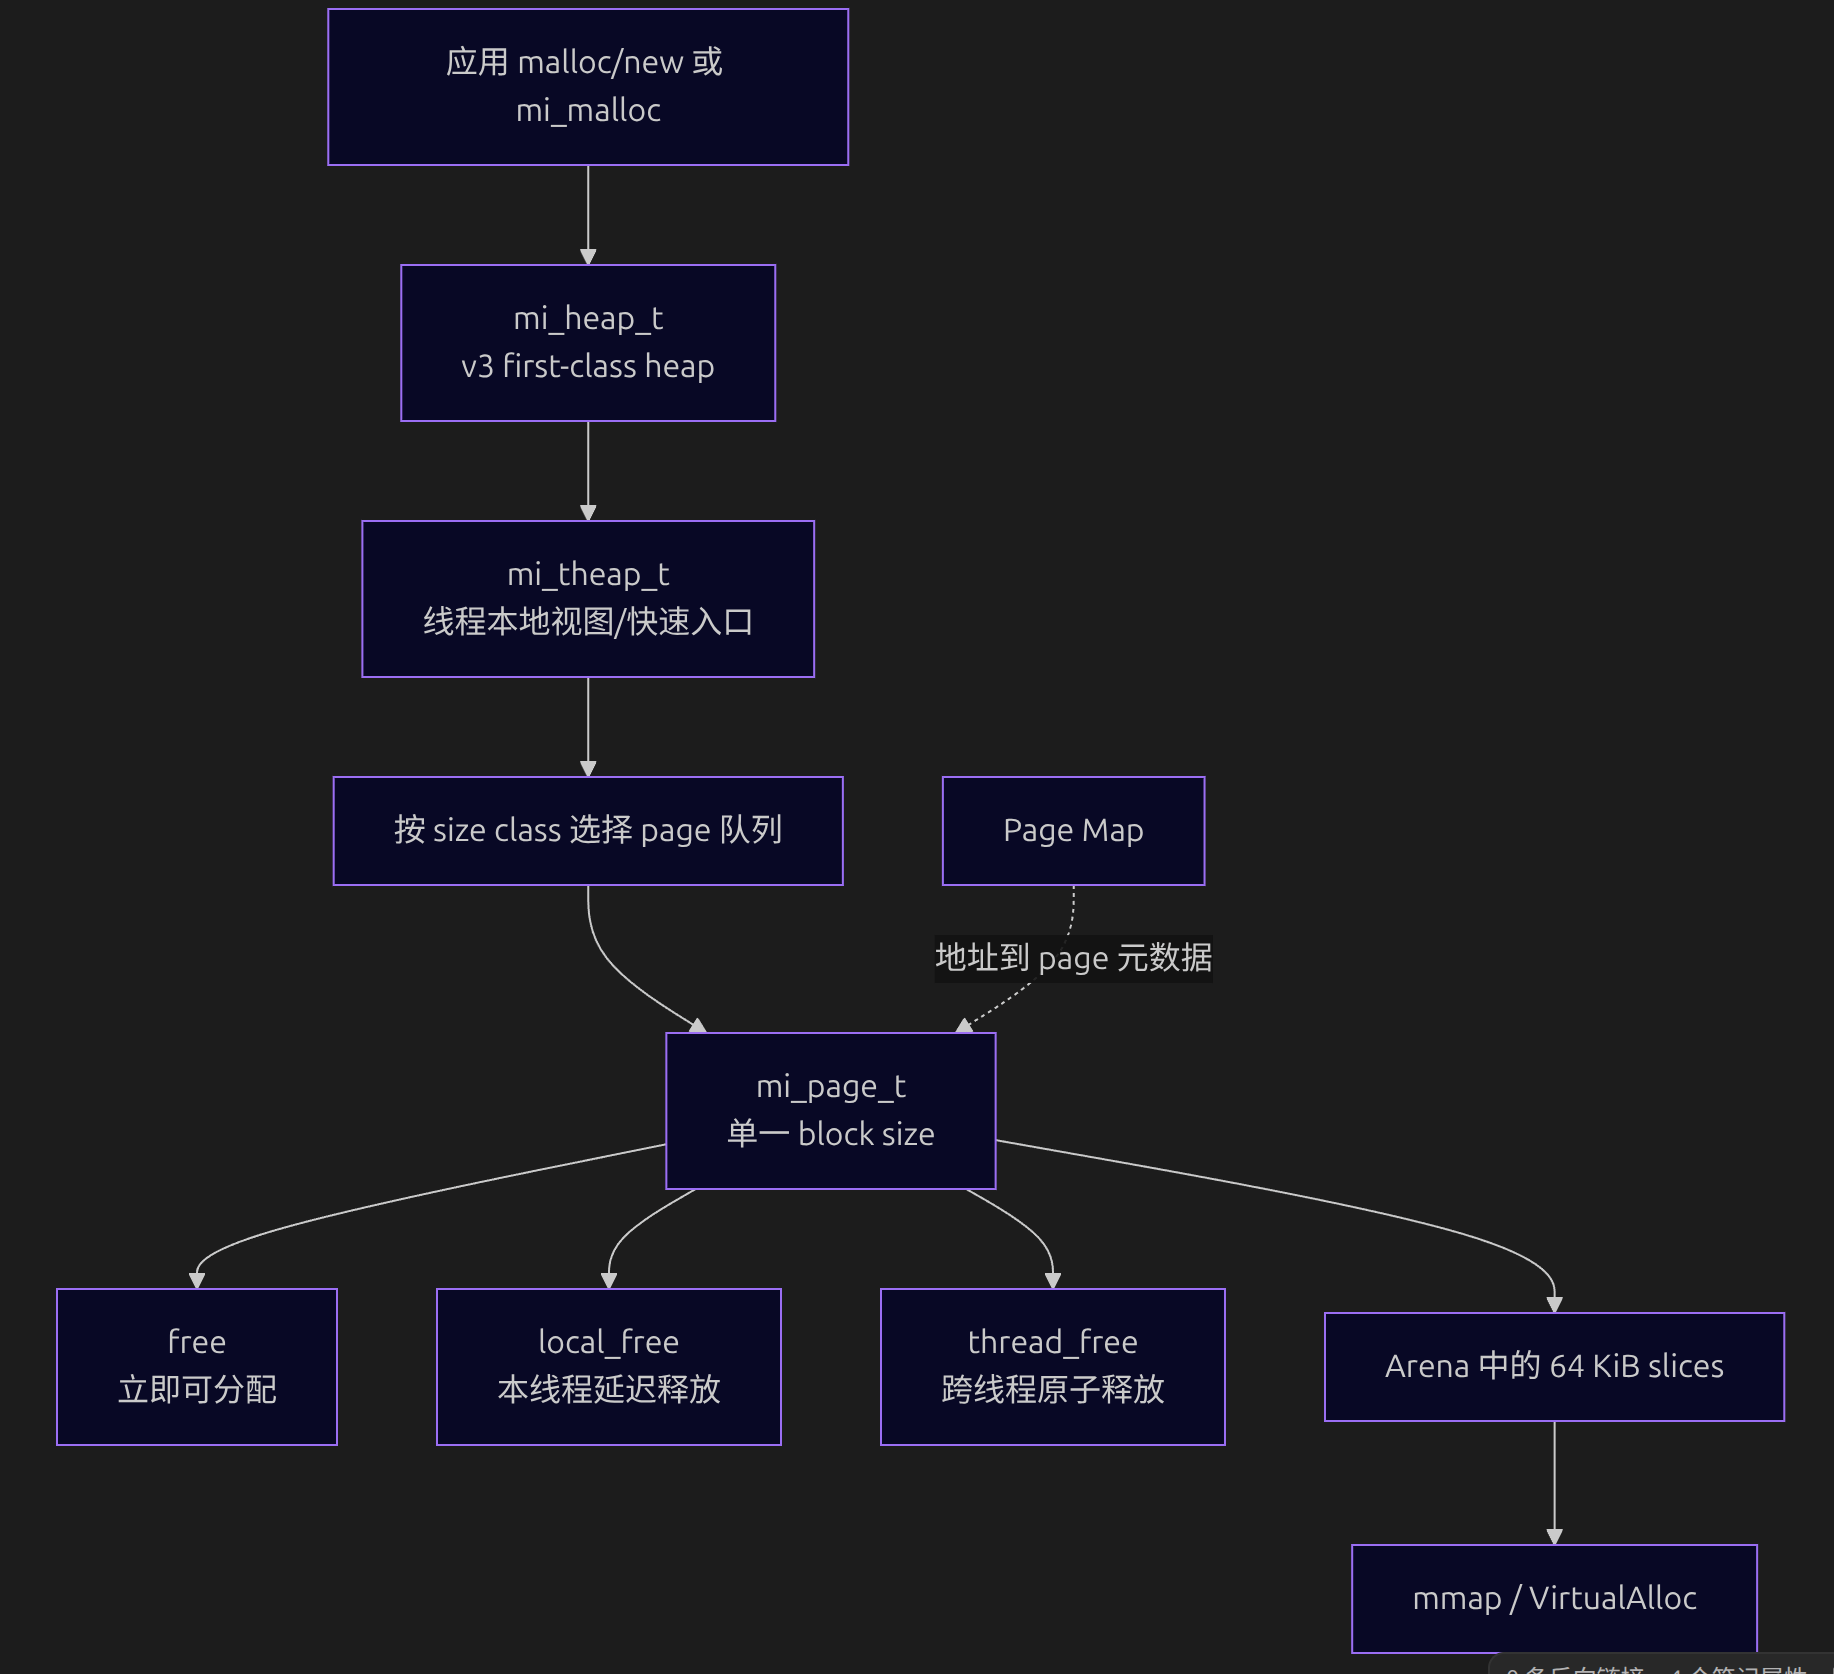
其主要的对象有:
| mi_subproc_t | 隔离一组heap和Arena | 高级接口,可用于进程内的独立解释器等场景 |
| mi_heap_t | first-class heap,拥有对象集合 | v3可从任意线程通过该heap分配,可整体销毁 |
| mi_theap_t | heap的线程本地分配状态 | 保存各size class的可用page队列,避免每次分配共享写入 |
| mi_page_t | 同一block size的对象页 | 常见大小为64 KiB、512 KiB或4MiB;具有多条空闲链表 |
| Arena | 从OS保留的大块虚拟地址区域 | 以64 KiB slice为基本单位,位图管理可用、提交和purge状态 |
| Page Map | 地址到mi_page_t元数据的映射 | 让free§能快速找到对象所属page;v3默认将元数据与对象区分离 |
在最新的v3源码中,64位平台默认有如下层级:
其中的size class按大约12.5%的指数间隔组织。源码中的MI_BIN_HUGE常量值为73,相关统计数组还包含0号索引,并另有full队列。因此,描述bin数量时需要区分普通尺寸类别、huge类别和full队列,不能只根据常量值直接判断总数。
三、核心原理
按page分片的空闲链表
在页管理中,传统的简化做法是“每个size class一条大空闲链表”。但这种方式存在一些问题,在长时间运行后,这条链表可能横跨很大的地址范围;连续创建一个逻辑数据结构时,其节点会散落在不同页上。为了解决这个问题,mimalloc将堆拆为多个page,每个page只管理一种block size,并拥有自己的空闲链表:
这样做有三个直接效果:
- 时间上相邻的分配更可能来自同一个page,改善空间局部性
- 空page更容易出现,从而可以整页purge
- 共享同步从全局链表分散到大量page,降低争用概率
这种机制被称为“free list sharding”,相关设计细节可参考mimalloc论文。
一个page上的三条空闲链表
在page上通过三类链表来应对不同的情况:
| free | page所属线程 | 分配快路径直接弹出block |
| local_free | page所属线程 | 本线程释放先进入此处,稍后批量并入free |
| thread_free | 其他线程 | 跨线程释放通过原子CAS推入,所属线程再批量接管 |
这就是multi-sharding。本线程释放不用原子指令;其他线程释放通常只需对目标page的thread_free做一次CAS。不同对象往往属于不同page,因此并发写入自然被分散。
local_free看似多绕一步,却很重要:它保证分配快路径经过固定数量的分配后会进入慢路径,形成temporal cadence(时间节拍)。慢路径借此摊销跨线程链表合并、空page回收、延迟释放回调和统计更新等工作,而无需在每次调用中检查所有状态。
分配路径
mimalloc针对不同大小的对象采用不同的分配路径。小对象分配路径为:
mi_malloc()-> _mi_theap_malloc_zero()-> mi_theap_xmalloc_small_zero_nonnull()-> mi_page_malloc_zero() (从page->free弹出块)
而通用路径则从:
mi_malloc()-> _mi_theap_malloc_zero()-> mi_theap_malloc_generic()-> _mi_malloc_generic()-> mi_malloc_generic_fallback()
小对象的快路径的本质是:TLS/theap定位、size class查表、从page的free链表弹出。由于不需要全局锁,所以才会更快。
而通用路径之所以慢,主要是执行:
- 合并local_free和free
- 原子的形式处理thread_free的批量合并
- 查找或申请新的页
- 触发延迟释放和心跳的回调
- 更新相关采样的状态和统计信息
mimalloc不在常规路径同时维护bump pointer和free list。它统一从预先初始化的free list分配,这样可减少一个难预测分支,也便于secure模式随机化初始顺序。
释放路径与跨线程释放
free§首先需要把任意对象地址映射回page元数据。v1/v2主要依靠对齐的segment和地址掩码;v3以Page Map为核心,并可利用对齐元数据优化常见路径。其处理路径为:
- 调用mi_free§,开始释放指针p指向的对象
- 由地址定位mi_page_t,根据p的地址反推出它所属的mi_page_t,也就是这个对象所在的页
- 判断当前线程是否拥有该page,检查当前线程是不是这个page的owner。如果是则直接压入local_free。这是线程本地释放路径,速度最快,通常无锁。否则用CAS压入thread_free。这是跨线程释放路径,需要保证并发安全
- 非owner路径处理:page是否可接管。压入thread_free后,判断该page是否已经没有当前owner,或者已经被标记为abandoned。可接管的情况下,当前线程原子取得ownership,并回收这些释放对象;不可接管的情况下,当前线程不直接回收,留给原owner后续批量collect
- 页面级判断:page是否可能全空。即无论是走local_free,还是接管回收,或者等待owner后续collect,都会继续判断该page是否可能变成全空。如果是则进入retire/purge/复用流程。也就是做页面回收、清理,或者缓存起来复用。否则继续保留该page
- 结束释放流程:对象释放完成,后续由mimalloc的页面管理策略继续处理。
v3把ownership状态和跨线程空闲链表编码在原子字段中。其他线程不仅能提交释放,还可在条件满足时接管abandoned page。线程退出或阻塞后,其部分使用的page因而不必永久困在线程私有缓存里。相比v2的thread-local segment,v3更强调page级共享和回收,这也是其在某些大型、多线程或线程频繁创建销毁的负载上降低内存占用的原因。
full page、retired page与abandoned page
- full page:没有可分配block,移入单独的full队列,避免慢路径每次线性扫描大量满页。跨线程第一次释放其中对象时,会通知所属分配状态把它重新变为候选page
- retired page:已经全空但短期保留在size class队列中,避免刚释放后马上又向Arena申请。倒计数到期后再真正退出队列
- abandoned page:线程结束或不再拥有的page。其他线程可回收它,降低线程缓存造成的内存滞留。
这些机制共同处理两个冲突目标:尽快释放物理内存,以及为即将到来的同尺寸分配保留热page
Arena、提交与purge
v3通常先向OS保留较大的Arena虚拟地址范围,再从Arena的层次位图中分配64 KiB slices组成mimalloc page。reserve、commit、RSS是不同概念:
- reserved:占用虚拟地址范围,不等于已使用同等物理内存
- committed:允许访问并由OS承诺后备存储
- RSS:当前真正驻留的物理页,受访问、回收策略和OS统计影响
page为空后,mimalloc通常保留虚拟地址范围,只对其中物理页执行purge:
- decommit模式在Linux常对应MADV_DONTNEED,RSS通常较快下降
- reset模式常对应MADV_FREE,OS可在压力下回收,但RSS不一定立即下降
因此“进程虚拟内存看起来很大”不必然是泄漏,而“RSS没有立刻下降”也不代表内存仍不可回收。应结合reserved/committed/RSS、mimalloc统计和业务存活对象判断。
Page Map与元数据分离
v3的Page Map将对象地址映射到mi_page_t。它带来:
- free、mi_usable_size和heap归属查询可快速找到page
- first-class heap的mi_heap_contains、mi_heap_of可做到常数时间查询
- 元数据可与用户对象区分离,减少线性溢出直接破坏allocator元数据的机会
- heap walk/GC不必扫描旧版segment结构中的大量无关内容
代价是额外的Page Map元数据、查询和提交策略。v3提供如MIMALLOC_PAGEMAP_COMMIT等高级选项,但除非定位特定地址空间/非法指针问题,不应在没有基准和源码理解的情况下修改。
四、特点、收益与代价
主要特点
| page级free-list sharding | 局部性好,空page更易形成 | 极端size分布仍可能有内部碎片 |
| 多级空闲链表 | 本地释放无原子操作,远程释放争用分散 | 跨线程内存不会在free后同步立刻完成全部维护 |
| 无全局锁的常见路径 | 多核扩展性和尾延迟更稳定 | OS调用、首次初始化等仍可能有高延迟 |
| eager/延迟purge可调 | 长期服务能在RSS与性能间取舍 | purge太积极增加缺页和清零成本;太迟则RSS较高 |
| first-class heap | 生命周期隔离、批量销毁、NUMA/自定义Arena | mi_heap_destroy后所有该heap指针立即失效 |
| secure/debug/guarded | 检测或缓解部分堆破坏 | 增加CPU、内存和VMA数量;不是完整漏洞防护方案 |
| 显式API与透明替换并存 | 新项目可精确控制,旧程序可低成本A/B | allocator边界混用可能产生跨堆释放问题 |
性能应如何理解
官方论文和基准显示mimalloc在大量测试上有较好的综合表现,尤其是小对象、对象在线程间迁移、分配线程与释放线程不对称等负载。但这些结果不能直接推导出某个线上服务一定更快:
- allocator时间可能只占服务总CPU的很小部分;
- 改善对象局部性带来的收益会因数据结构而异;
- RSS取决于存活对象分布、purge、THP、容器限制与内核版本;
- p50变好不代表p99/p999变好;
- LD_PRELOAD覆盖范围、第三方库和编译器优化会改变结果。
正确评价至少记录:吞吐、CPU、p50/p95/p99/p999、peak/steady RSS、page fault、上下文切换、分配速率、对象大小分布,以及稳定运行后的内存平台期。
与常见分配器的设计侧重对比
| glibc malloc | 系统默认、兼容性优先,多arena | 最低集成风险;多线程/碎片敏感负载可能值得替换测试 |
| jemalloc | 成熟的arena/tcache、丰富统计与调优 | 需要深入profiling、成熟生产生态时很有吸引力 |
| TCMalloc | per-CPU/per-thread cache与中央页堆 | Google技术栈、高吞吐服务常见,具体实现版本差异大 |
| mimalloc | page分片、多分片free list、紧凑实现、first-class heap | 跨线程释放、小对象、嵌入运行时和低摩擦A/B测试值得优先评估 |
| rpmalloc | 强调线程局部heap与低同步开销 | 线程归属清晰、追求轻量嵌入时可一并测试 |
这不是静态排名。应比较与目标操作系统、编译参数、真实trace和同等回收策略匹配的版本。
五、安全和诊断模式
mimalloc提供了以下安全与诊断机制:
Secure模式
可以通过下面的命令进入:
cmake -S mimalloc -B build/secure \\
-DCMAKE_BUILD_TYPE=Release \\
-DMI_SECURE=ON
cmake –build build/secure -j
主要缓解措施包括:
- allocator page/元数据guard page
- 每page密钥编码空闲链表指针,并检测链表破坏
- double-free和无效指针检查
- page内分配顺序及较大内存地址随机化
- 对象尾部padding/canary检查
-DMI_SECURE=FULL还会在每个mimalloc page末尾放guard page,代价更高,并可能显著增加Linux VMA数量。secure模式是缓解措施,不等价于内存安全语言,也不能防住所有UAF、越界写和任意写。
Debug与Guarded模式
cmake -S mimalloc -B build/debug \\
-DCMAKE_BUILD_TYPE=Debug \\
-DMI_DEBUG=INTERNAL
cmake –build build/debug -j
Debug构建默认启用更多断言、统计、padding、非法free检测,并启用guarded支持。Guarded模式按采样给对象尾部放OS guard page,可在发生越界时就触发异常,而不是等到free才发现:
MIMALLOC_GUARDED_SAMPLE_RATE=4000 \\
MIMALLOC_GUARDED_MIN=64 \\
MIMALLOC_GUARDED_MAX=4096 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc-debug.so \\
./server
排障时可把采样率设为1,但每个被保护对象至少需要额外guard page和对齐空间,通常不适合高分配率生产流量。MIMALLOC_GUARDED_PRECISE=1能捕捉1字节越界,但可能破坏C/C++最小对齐保证,必须谨慎。
ASan/Valgrind的集成方式
v3新CMake写法为:
# ASan
cmake -S mimalloc -B build/asan \\
-DCMAKE_BUILD_TYPE=Debug \\
-DMI_TRACK=ASAN
# Valgrind
cmake -S mimalloc -B build/valgrind \\
-DCMAKE_BUILD_TYPE=Debug \\
-DMI_TRACK=VALGRIND
如果有什么细节的问题,可参考相关的官方文档。
六、应用场景
与其他框架和库一样,mimalloc不可能适合所有应用场景,具体如下:
常见的应用场景
- 高并发RPC、网关、数据库周边服务,大量分配中小对象
- 生产者线程分配、消费者线程释放的队列/消息系统
- 编译器、解释器、GC/引用计数运行时
- 图、AST、请求上下文等“成组创建、成组销毁”的对象
- 线程池、线程频繁创建退出、旧allocator容易产生缓存滞留的应用
- 游戏、渲染、仿真等对长尾延迟敏感的native应用
- 无法改源码但能动态链接的ELF程序,可用LD_PRELOAD快速A/B
不建议使用的应用场景
- 几乎没有动态分配,或allocator CPU占比很低
- 对象主要是超大连续块,瓶颈在I/O、拷贝或OS page fault
- 静态链接程序、setuid/setgid程序或受限沙箱,预加载可能失效
- 插件ABI允许在A allocator中分配、在B allocator中释放
- 依赖glibc allocator私有行为、hook或特定malloc_usable_size语义
- fork后大量写入且使用2 MiB/1 GiB大页,可能触发昂贵的COW
- 极严的容器RSS限制但未调优THP/purge
- 已使用jemalloc/TCMalloc且有成熟调优与监控,替换成本大于可测收益
七、安装与构建
Linux从源码构建v3
固定release tag,避免生产构建随main3漂移:
git clone –branch v3.5.2 –depth 1 \\
https://github.com/microsoft/mimalloc.git
cmake -S mimalloc -B mimalloc/build/release \\
-DCMAKE_BUILD_TYPE=Release \\
-DCMAKE_INSTALL_PREFIX=/opt/mimalloc \\
-DMI_INSTALL_TOPLEVEL=ON \\
-DMI_BUILD_TESTS=OFF \\
-DMI_BUILD_SHARED=ON \\
-DMI_BUILD_STATIC=ON
cmake –build mimalloc/build/release -j
cmake –install mimalloc/build/release
典型产物为动态库、静态库和单一对象文件。若安装到非系统目录,运行时可使用完整路径、设置rpath,或配置动态链接器搜索路径;生产服务不建议依赖交互shell中偶然存在的LD_LIBRARY_PATH。
这里显式设置MI_INSTALL_TOPLEVEL=ON,因此头文件、静态库与CMake package都直接位于/opt/mimalloc的标准子目录。若保留默认的OFF,它们会安装到带版本号的目录以支持多版本并存,后续-I、静态链接和CMAKE_PREFIX_PATH需要使用实际安装路径。动态库始终安装到标准lib目录。
推荐的生产Release配置
cmake -S mimalloc -B mimalloc/build/prod \\
-DCMAKE_BUILD_TYPE=Release \\
-DCMAKE_INSTALL_PREFIX=/opt/mimalloc \\
-DMI_INSTALL_TOPLEVEL=ON \\
-DMI_BUILD_TESTS=OFF \\
-DMI_OVERRIDE=ON \\
-DMI_OPT_ARCH=OFF \\
-DMI_ALLOW_THP=DEFAULT
说明:
- MI_OVERRIDE=ON:构建标准malloc覆盖入口;只显式调用mi_*时也可以关闭
- MI_OPT_ARCH=ON:使用更具体的x64/ARM64/RISC-V指令,可能更快,但二进制在较老CPU/虚拟机上会illegal instruction。分发型二进制建议关闭或按机型分别构建
- MI_ALLOW_THP=DEFAULT:Linux v3.5默认趋向FULL,避免purge拆分THP,可能提高性能也可能提高RSS;容器内必须实测
- MI_FREE_IS_CHECKED=ON:检查传给mi_free的指针,适合边界复杂的全进程覆盖,代价是释放稍慢;secure模式默认开启
查看当前版本所有构建选项:
cmake -S mimalloc -B mimalloc/build/options -LAH
常用构建选项汇总:
| MI_BUILD_SHARED | 构建动态库 | LD_PRELOAD或动态链接时开启 |
| MI_BUILD_STATIC | 构建静态archive | 只需要动态库时关闭以减少产物 |
| MI_BUILD_OBJECT | 生成静态覆盖用mimalloc.o | 需要链接时覆盖才开启 |
| MI_BUILD_TESTS | 构建mimalloc自测程序 | CI可开启,发布构建通常关闭 |
| MI_OVERRIDE | 提供标准malloc/free覆盖符号 | 显式mi_* API项目可关闭 |
| MI_SECURE | OFF/ON/FULL安全缓解等级 | FULL成本较高,按威胁模型选择 |
| MI_GUARDED | 支持采样guard page | 排障或受控生产采样 |
| MI_TRACK | OFF/ASAN/VALGRIND/ETW工具集成 | 使用对应诊断工具时单独构建 |
| MI_OPT_ARCH | 启用特定CPU指令优化 | 同构机器可测试,通用发行包谨慎 |
| MI_ALLOW_THP | OFF/ON/FULL/DEFAULT | 结合RSS与尾延迟实测 |
| MI_INSTALL_TOPLEVEL | 使用标准顶层安装目录 | 单版本/opt安装便于使用;多版本并存可关闭 |
构建选项决定ABI、产物名称和运行行为,应随二进制一起记录;不要只记录运行时环境变量。
八、应用方式
一般来说,mimalloc的应用方式有以下几种:
LD_PRELOAD透明替换
先确认动态库实际路径:
find /opt/mimalloc -name 'libmimalloc.so*' -type f
运行:
MIMALLOC_VERBOSE=1 \\
MIMALLOC_SHOW_STATS=1 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./myserver –config server.yaml
验证标准分配符号确实来自mimalloc:
LD_DEBUG=bindings \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./myserver 2>&1 | grep -m 10 -i mimalloc
注意:
- LD_PRELOAD只适用于动态链接ELF程序;安全执行模式会忽略或限制它。
- 不要同时预加载多个提供malloc/free的allocator。
- 主程序和第三方.so之间传递对象时,必须确保分配与释放最终进入同一个allocator。
- 先在预发布环境使用MIMALLOC_VERBOSE=1验证,再关闭verbose做性能测试。
显式mi_* API
main.c:
int main(void) {
Data* dt = mi_calloc(1000, sizeof(Data));
if (dt == NULL) {
return 1;
}
// 其他处理
mi_free(dt);
mi_collect(true);
return 0;
}
直接编译:
cc -O2 main.c -o demo \\
-I/opt/mimalloc/include \\
-L/opt/mimalloc/lib -Wl,-rpath,/opt/mimalloc/lib \\
-lmimalloc
MIMALLOC_SHOW_STATS=1 ./demo
规则:谁用mi_malloc/mi_calloc/mi_realloc分配,谁就用mi_free释放。虽然全进程override时标准free通常也被重定向,但显式API的组件边界不应依赖这一偶然条件。
对齐分配使用mi_malloc_aligned(size, alignment)。注意它的参数顺序是“大小在前、对齐在后”,与aligned_alloc(alignment, size)不同:
#include <mimalloc.h>
#include <stdint.h>
int main(void) {
const size_t alignment = 64;
void* p = mi_malloc_aligned(4096, alignment);
if (p == NULL) return 1;
if (((uintptr_t)p % alignment) != 0) {
mi_free(p);
return 2;
}
mi_free(p);
return 0;
}
数组分配优先用mi_calloc(count, size)或mi_mallocn(count, size),由库检查乘法溢出,不要先在业务代码中无检查地计算count * size。
链接时全局覆盖
Unix-like系统可把构建生成的mimalloc.o放在最终链接命令前部,以覆盖标准接口:
cc -O2 mimalloc/build/release/mimalloc.o app.o worker.o -o app -pthread
单一对象文件比静态archive更容易优先解析malloc/free符号。当前CMake会在构建目录生成它,但默认不会由cmake –install安装;发布系统需要把它作为构建产物单独保存。另一种做法是在所有受控源文件中包含mimalloc-override.h,把调用宏重定向为mi_*;如果无法控制全部源文件,这种方式容易形成allocator混用,不推荐。
九、CMake项目配置
使用已安装的CMake package
假定mimalloc已安装到/opt/mimalloc:
cmake_minimum_required(VERSION 3.20)
project(mi_demo LANGUAGES C CXX)
find_package(mimalloc CONFIG REQUIRED)
add_executable(mi_demo main.cpp)
target_compile_features(mi_demo PRIVATE cxx_std_17)
# 动态库:
target_link_libraries(mi_demo PRIVATE mimalloc)
# 如需静态库,改为:
# target_link_libraries(mi_demo PRIVATE mimalloc-static)
配置与构建:
cmake -S . -B build \\
-DCMAKE_BUILD_TYPE=Release \\
-DCMAKE_PREFIX_PATH=/opt/mimalloc
cmake –build build -j
若运行时找不到.so,优先给安装包配置rpath或系统loader配置,而不是把LD_LIBRARY_PATH硬编码到所有用户环境。
作为源码子目录使用
适合把经过审核的mimalloc tag/commit固定在third_party/mimalloc:
project/
├── CMakeLists.txt
├── src/main.cpp
└── third_party/mimalloc/
只使用显式mi_* API、不覆盖标准malloc/free的配置:
cmake_minimum_required(VERSION 3.20)
project(example LANGUAGES C CXX)
set(MI_BUILD_TESTS OFF CACHE BOOL "" FORCE)
set(MI_BUILD_SHARED ON CACHE BOOL "" FORCE)
set(MI_BUILD_STATIC OFF CACHE BOOL "" FORCE)
set(MI_BUILD_OBJECT OFF CACHE BOOL "" FORCE)
set(MI_OVERRIDE OFF CACHE BOOL "" FORCE)
set(MI_SECURE OFF CACHE STRING "" FORCE)
add_subdirectory(third_party/mimalloc)
add_executable(example src/main.cpp)
target_compile_features(example PRIVATE cxx_std_17)
target_link_libraries(example PRIVATE mimalloc)
用CACHE … FORCE是为了让父项目明确控制第三方库构建。若同一个superbuild中其他组件也配置mimalloc,要集中定义这些选项,避免不同目录互相覆盖cache。
FetchContent
include(FetchContent)
set(MI_BUILD_TESTS OFF CACHE BOOL "" FORCE)
set(MI_BUILD_STATIC OFF CACHE BOOL "" FORCE)
set(MI_BUILD_OBJECT OFF CACHE BOOL "" FORCE)
set(MI_OVERRIDE OFF CACHE BOOL "" FORCE)
FetchContent_Declare(
mimalloc
GIT_REPOSITORY https://github.com/microsoft/mimalloc.git
GIT_TAG v3.5.2
GIT_SHALLOW TRUE
)
FetchContent_MakeAvailable(mimalloc)
add_executable(example src/main.cpp)
target_link_libraries(example PRIVATE mimalloc)
生产构建必须固定经过验证的release tag,安全要求更高时固定完整commit SHA并做依赖校验。不要跟随main3、dev3或浮动tag构建可发布产物。
测试例程
src/main.cpp:
int main() {
void* buffer = mi_malloc(1024 * 1024);
if (buffer == nullptr) return 1;
std::printf("allocated 1 MiB\\n");
mi_free(buffer);
mi_stats_print_out(nullptr, nullptr);
return 0;
}
构建和运行:
cmake -S . -B build -DCMAKE_BUILD_TYPE=Release
cmake –build build -j
MIMALLOC_SHOW_STATS=1 ./build/example
mi_stats_print_out主动打印调用时刻的allocator统计;MIMALLOC_SHOW_STATS=1通常在正常退出时打印。被信号强制终止或_exit时,退出统计可能来不及输出。
十、C++应用
在C++开发中,可以根据实际情况选择mimalloc内存分配器的接入方式:
全局覆盖new/delete
只在一个.cpp文件中包含:
// mimalloc_override.cpp
#include <mimalloc-new-delete.h>
其他源文件正常使用STL/new/delete,目标链接mimalloc。不要在多个翻译单元包含该头文件,否则可能发生重复定义。还应确认其他依赖没有再次定义全局operator new/delete。
只为特定容器指定allocator
#include <mimalloc.h>
#include <vector>
struct event {
int type;
double value;
};
int main() {
std::vector<event, mi_stl_allocator<event>> events;
events.push_back({1, 3.14});
return 0;
}
这种做法影响面小,适合库组件或渐进迁移。不过字符串、嵌套容器及从容器返回的对象仍需审查allocator传播语义。
跨模块和插件所有权
显式API与系统allocator可以在同一进程共存,前提是每个指针回到创建它的allocator。下面的写法在未确认全进程override时是错误的:
void* p1 = mi_malloc(100);
free(p1); // 错误:可能交给了系统allocator
void* p2 = malloc(100);
mi_free(p2); // 错误:可能不是mimalloc指针
共享库、插件和不同CRT之间不要暴露“由调用方猜测如何释放”的裸指针。由创建模块同时提供销毁函数:
extern "C" char* plugin_create_text();
extern "C" void plugin_free_text(char* p);
注意:
- C++全局new/delete覆盖头只出现在一个翻译单元
- Windows DLL间必须统一动态CRT与allocator,或严格执行模块内创建、模块内销毁
- 跨ABI返回STL容器、异常对象和含自定义allocator的类型风险更高
- 全局override成功后标准接口通常会统一重定向,但插件的私有allocator仍可能绕过它
- 对外API最好用opaque handle加专用destroy函数表达所有权
十一、参数设定与调优
运行时参数既可用环境变量,也可在进程初始化早期调用mi_option_set。环境变量名称通常为MIMALLOC_加大写选项名。
常用参数
| MIMALLOC_VERBOSE | 0/1 | 启动时打印版本、配置和统计,验证接入时开启 |
| MIMALLOC_SHOW_STATS | 0/1 | 退出时打印统计;异常退出未必能打印 |
| MIMALLOC_SHOW_ERRORS | 0/1 | 打印错误与警告,生产可开启 |
| MIMALLOC_PURGE_DELAY | v3默认约1000 ms | 0立即purge,-1禁用;在RSS与重用性能间取舍 |
| MIMALLOC_PURGE_DECOMMITS | 默认1 | 1更积极降低RSS;0 reset,通常更利于快速复用 |
| MIMALLOC_ARENA_EAGER_COMMIT | 默认2 | 2仅在overcommit系统eager commit;1强制启用 |
| MIMALLOC_ALLOW_THP | Linux v3.5常为2/FULL | 0关闭;2避免purge拆THP,性能可能好、RSS可能高 |
| MIMALLOC_USE_NUMA_NODES | 自动检测 | 虚拟机错误报告NUMA时可设1;不是绑核替代品 |
| MIMALLOC_ALLOW_LARGE_OS_PAGES | 默认关 | 尝试2/4 MiB大页;不可purge/共享,谨慎使用 |
| MIMALLOC_RESERVE_HUGE_OS_PAGES | 默认0 | 启动时预留N个1 GiB huge page,适合明确的大内存低延迟负载 |
打印当前实际选项:
MIMALLOC_VERBOSE=1 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./myserver –version
程序内设置:
#include <mimalloc.h>
int main(void) {
// 必须尽早设置,最好在创建线程和大量分配之前
mi_option_set(mi_option_purge_delay, 250);
mi_option_set_enabled(mi_option_show_errors, true);
mi_options_print();
// …
}
相关配置
通用服务:先用默认值,只开启错误日志。
MIMALLOC_SHOW_ERRORS=1 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./server
内存受限容器:更积极purge,并测试关闭THP。
MIMALLOC_PURGE_DELAY=100 \\
MIMALLOC_PURGE_DECOMMITS=1 \\
MIMALLOC_ALLOW_THP=0 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./server
这通常降低稳态RSS,但可能增加minor fault、清零成本和p99;不能未经压测直接上线。
低延迟大内存服务:减少purge干扰。
MIMALLOC_PURGE_DELAY=-1 \\
MIMALLOC_ALLOW_THP=2 \\
LD_PRELOAD=/opt/mimalloc/lib/libmimalloc.so \\
./server
这可能提高RSS,必须有足够内存余量。1 GiB huge page还需OS预留/权限,且与fork组合风险较高,不应作为通用默认配置。
十二、总结
mimalloc是一个较新的内存分配器,在实际应用中已经得到广泛验证。但内存分配器并不存在适用于所有场景的绝对最优方案。如果业务负载无法发挥mimalloc的优势,或者正好落入其不擅长的场景,就可能得不到预期收益。
工具的价值在于帮助开发者解决实际问题。是否采用mimalloc,应以真实业务负载下的性能、内存占用、稳定性和维护成本为依据。