上下文压缩与分层缓存:将 128k Token 上下文精炼至 4k 的前端中间件设计
大模型上下文窗口从 8k 飙升到 128k 甚至 1M 之后,很多前端同学在做 Agent 交互时开始变得“大手大脚”——把用户所有的交互历史、DOM 树快照、工具返回的几百行 JSON 全量往 prompt 里塞。
表面上看模型能吃得下,但只要拉一下生产网关的监控看板,就会发现两个致命瓶颈:第一是 TTFT(首字延迟)随着上下文长度线性甚至超线性上涨,30k 的上下文能让响应等待时间飙到 5 秒以上;第二是 Token 账单直接爆炸,每次简单的提问都要为几十轮前冗余的工具调用数据重复买单。
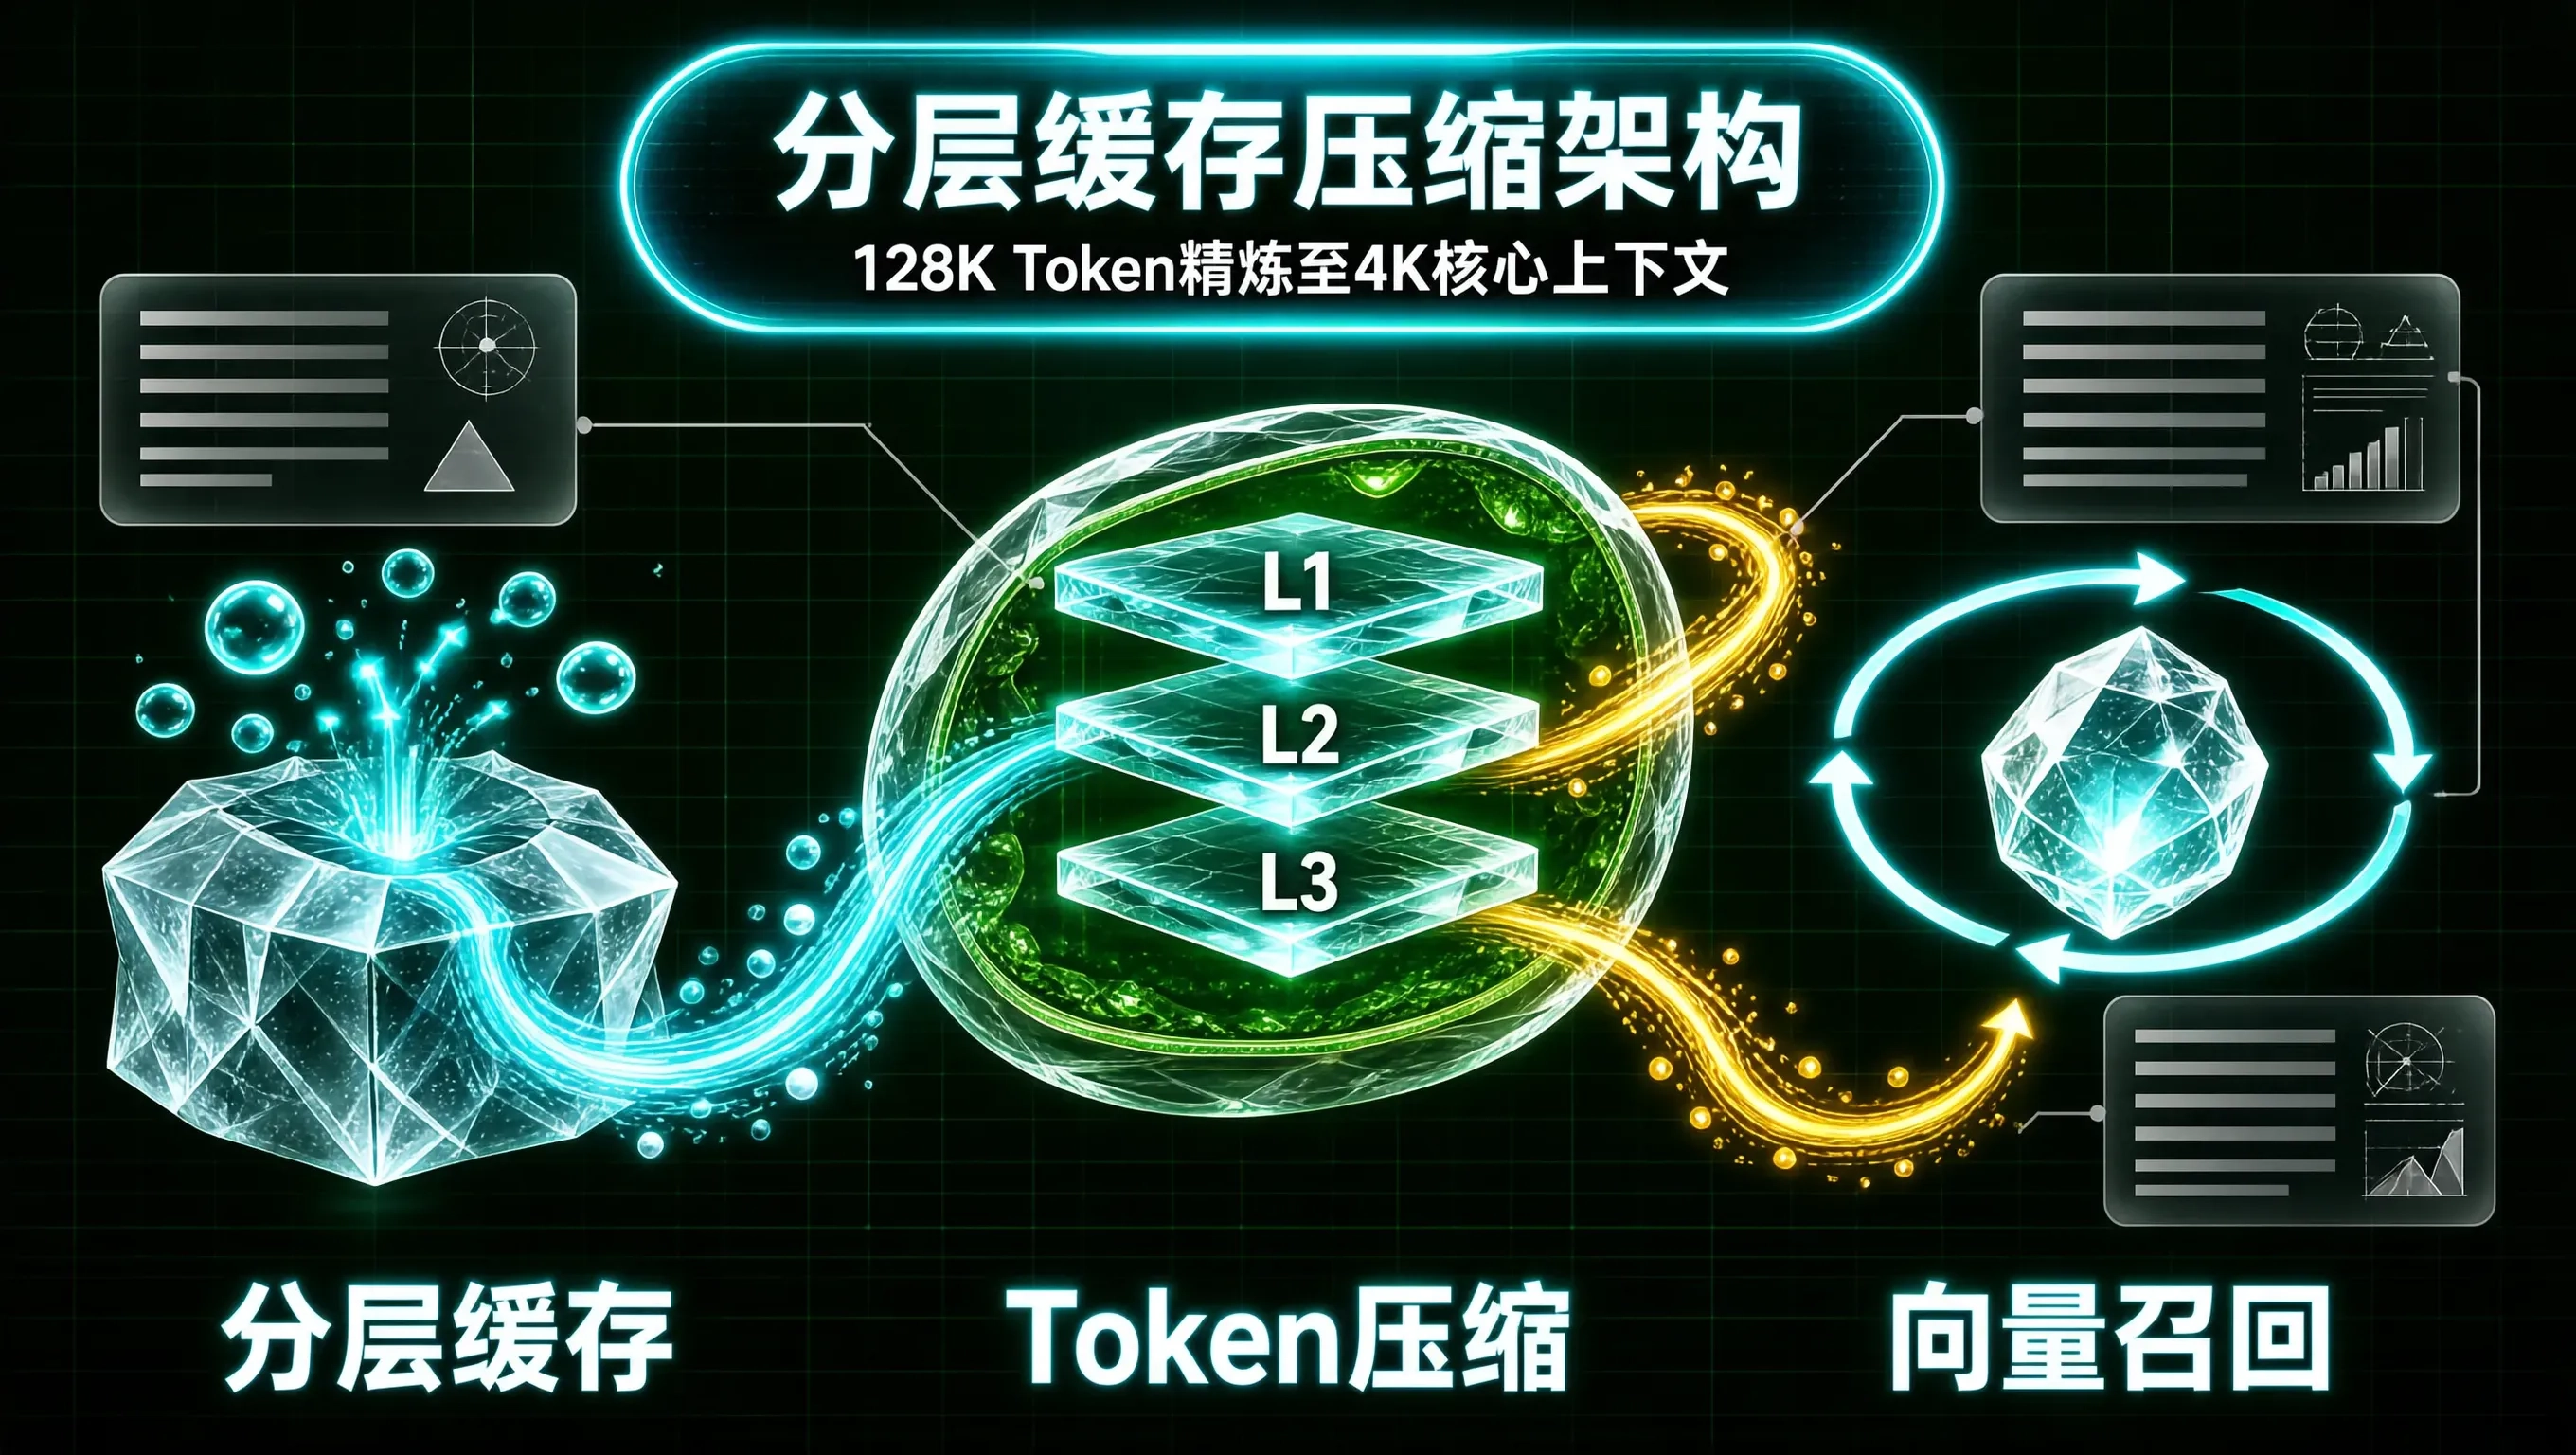
真正的生产级 Agent 编排,必须在客户端构建一套分层上下文缓存与压缩中间件,将动辄 128k 的全量历史精炼到 4k 以内的核心上下文,既保住了会话记忆的连贯性,又把首字延迟锁死在 500ms 黄金响应区间。
三层上下文缓存架构设计
为了兼顾记忆的时效性与深度,我们将客户端维护的上下文划分为三层存储模型:
┌─────────────────────────────────────────────────────────────┐
│ Agent Prompt 组装器 │
└─────────────────────────────────────────────────────────────┘
▲
┌──────────────────────┼──────────────────────┐
│ │ │
┌───────────────┐ ┌───────────────┐ ┌───────────────┐
│ L1: 活跃窗口 │ │ L2: 动态摘要 │ │ L3: 向量召回 │
│ (最近 3-5 轮) │ │ (事实状态矩阵)│ │ (按需 Top-K) │
│ [~2000 Tokens]│ │ [~800 Tokens] │ │ [~1200 Tokens]│
└───────────────┘ └───────────────┘ └───────────────┘
▲ ▲ ▲
└─────────────┬────────┴──────────────────────┘
│ (分流裁剪管道)
[ 用户实时输入 / 工具副作用 ]
精确 Token 估算与动态滑动窗口实现
在前端做上下文裁剪,绝对不能用简单的 message.length / 4 粗暴估算。中文、代码块以及 JSON 特殊字符的 Token 密度差异极大。我们可以引入轻量级的 WebAssembly 版 Tokenizer(如 tiktoken 精简版)在客户端实现毫秒级估算。
下面是基于 Zustand 思维构建的分层压缩中间件核心实现:
export interface ContextMessage {
id: string;
role: 'system' | 'user' | 'assistant' | 'tool';
content: string;
tokens: number;
timestamp: number;
metadata?: Record<string, any>;
}
export interface CompressionConfig {
maxTotalBudget: number; // 总 Token 上限,例如 4096
l1WindowBudget: number; // L1 活跃窗口预算,例如 2048
l2SummaryBudget: number; // L2 摘要预算,例如 1024
l3RecallBudget: number; // L3 召回预算,例如 1024
}
export class LayeredContextManager {
private l1Messages: ContextMessage[] = [];
private l2Summary: string = '';
private config: CompressionConfig;
constructor(config: CompressionConfig) {
this.config = config;
}
// 插入新消息并触发状态流转
public async pushMessage(msg: Omit<ContextMessage, 'id' | 'timestamp' | 'tokens'>): Promise<void> {
const tokens = this.estimateTokens(msg.content);
const newEntry: ContextMessage = {
…msg,
id: crypto.randomUUID(),
timestamp: Date.now(),
tokens,
};
this.l1Messages.push(newEntry);
await this.balanceLayers();
}
private estimateTokens(text: string): number {
// 采用中英文混合加权估算,生产环境可替换为 WASM tiktoken
const chineseChars = (text.match(/[\\u4e00-\\u9fa5]/g) || []).length;
const otherChars = text.length – chineseChars;
return Math.ceil(chineseChars * 0.7 + otherChars * 0.3);
}
private async balanceLayers(): Promise<void> {
let currentL1Tokens = this.l1Messages.reduce((sum, item) => sum + item.tokens, 0);
// 当 L1 超出预算时,将最旧的消息踢出并合入 L2 摘要
while (currentL1Tokens > this.config.l1WindowBudget && this.l1Messages.length > 2) {
const popped = this.l1Messages.shift();
if (!popped) break;
currentL1Tokens -= popped.tokens;
await this.integrateIntoSummary(popped);
}
}
private async integrateIntoSummary(evictedMsg: ContextMessage): Promise<void> {
// 增量提取关键实体与约束,更新事实状态表
const incrementalDelta = `[${evictedMsg.role}]: ${evictedMsg.content.slice(0, 80)}`;
this.l2Summary = this.l2Summary
? `${this.l2Summary} | ${incrementalDelta}`
: incrementalDelta;
// 保证 L2 摘要本身不超预算
if (this.estimateTokens(this.l2Summary) > this.config.l2SummaryBudget) {
this.l2Summary = this.l2Summary.slice(-this.config.l2SummaryBudget * 2);
}
}
public assembleContext(systemPrompt: string, recalledL3Content?: string): ContextMessage[] {
const contextList: ContextMessage[] = [];
// 1. 注入核心系统提示词
contextList.push({
id: 'sys',
role: 'system',
content: `${systemPrompt}\\n\\n[历史记忆摘要]:\\n${this.l2Summary || '无历史状态'}`,
tokens: this.estimateTokens(systemPrompt) + this.estimateTokens(this.l2Summary),
timestamp: 0,
});
// 2. 注入 L3 召回内容(如果存在)
if (recalledL3Content) {
contextList.push({
id: 'l3-recall',
role: 'system',
content: `[相关背景回溯]:\\n${recalledL3Content}`,
tokens: this.estimateTokens(recalledL3Content),
timestamp: 0,
});
}
// 3. 拼接 L1 活跃上下文
contextList.push(…this.l1Messages);
return contextList;
}
}
工具调用结果的高损压缩
在前端 Agent 编排中,最严重的 Token 浪费发生在工具调用(Tool Calls)上。例如前端请求一个商品列表或代码仓库 AST,服务端返回了包含 50 个字段的庞大 JSON 对象,单次调用就吃掉 8000 个 Token。
对工具返回值的压缩策略必须遵循“按需投影”原则:
export function compressToolResult(rawData: any, maxTokens: number = 300): string {
if (typeof rawData !== 'object' || rawData === null) {
return String(rawData).slice(0, maxTokens * 3);
}
if (Array.isArray(rawData)) {
const sample = rawData.slice(0, 3);
const summary = {
totalCount: rawData.length,
sampleItems: sample,
hasMore: rawData.length > 3
};
return JSON.stringify(summary);
}
// 深度对象过滤空字段
const pruned: Record<string, any> = {};
for (const [key, value] of Object.entries(rawData)) {
if (value !== undefined && value !== null && value !== '') {
pruned[key] = typeof value === 'object' ? '[Nested Object]' : value;
}
}
return JSON.stringify(pruned);
}
生产落地的权衡与反思
在千万级 PV 的前端 Agent 项目中实施分层缓存机制后,必须警惕两类边际效应:
- 过度摘要导致的上下文丢失:如果 L2 摘要管道提炼得过于激进,模型容易遗忘用户在 10 轮前提出的全局约束(例如“全部使用 TypeScript 严苛模式,不要写 any”)。因此,全局强约束必须固定挂载在 System Prompt 的静态前缀中,不能参与 L1/L2 的滚动淘汰。
- 并发状态竞争:当用户连续发送多条消息或打断流式输出时,本地状态机的 pushMessage 必须通过 Promise 队列做严格的互斥锁保护,防止滑动窗口裁剪出现计数不同步。
把上下文管理当作内存分页与二级缓存来设计,不仅能极大压降服务端的调用成本,更从根本上保障了复杂 Agent 在浏览器端交互的极致丝滑度。