一、流式响应的基础形态
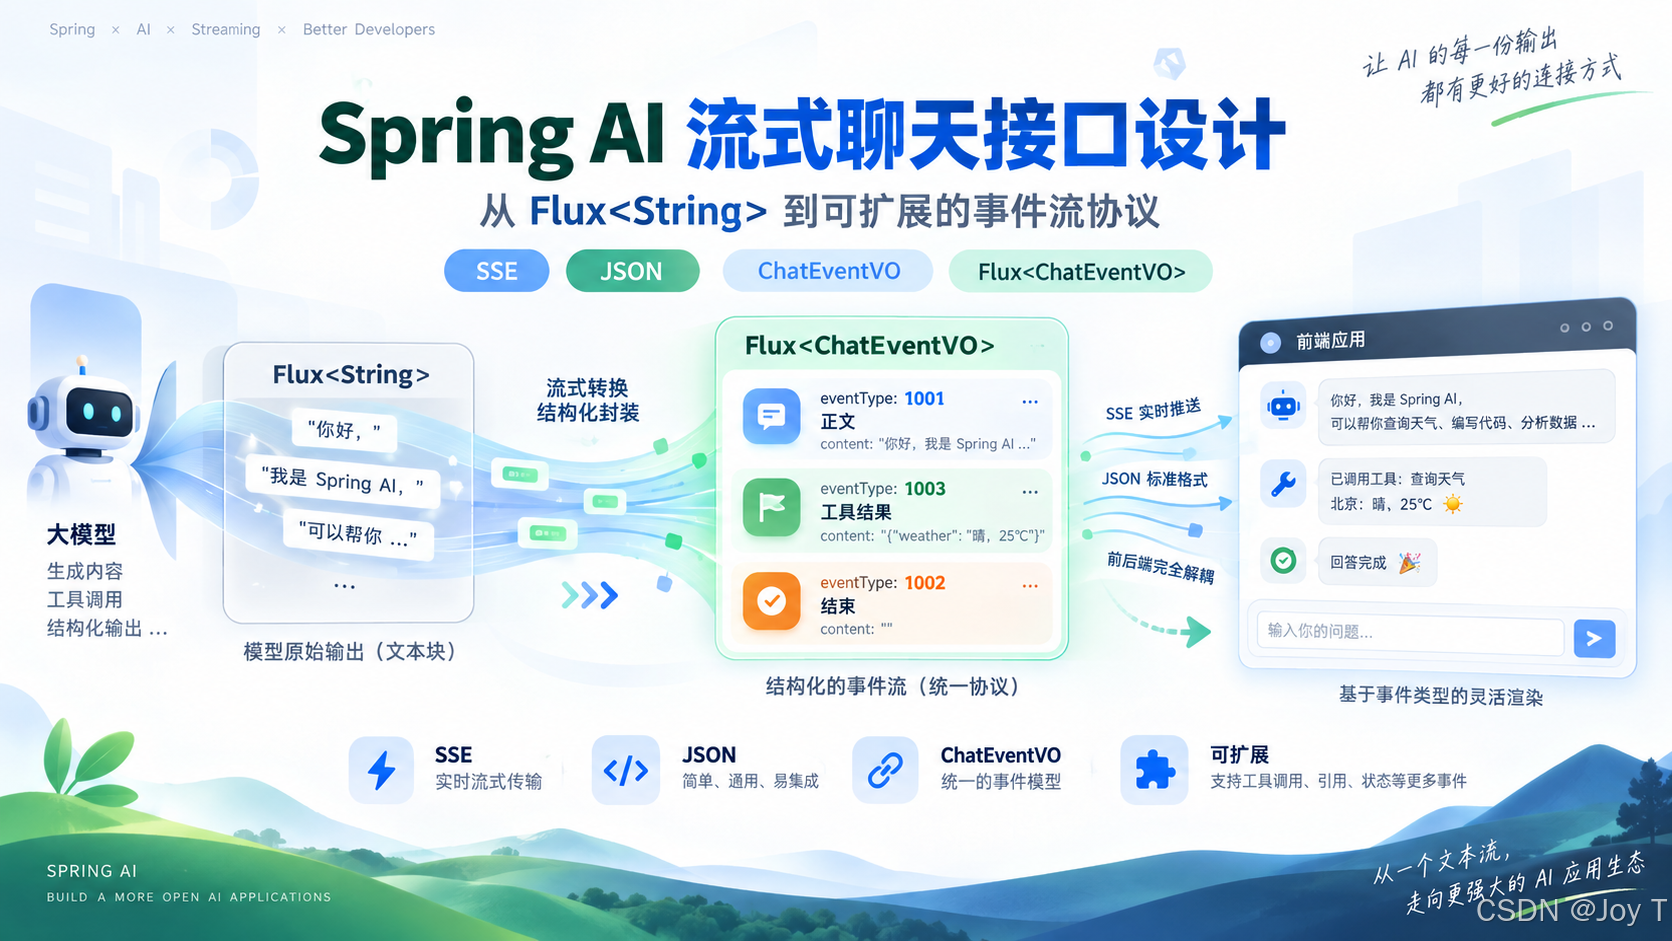
Spring AI 构建聊天接口时,最直接的实现方式是让模型返回 Flux<String>,再由前端持续接收并追加显示。对于普通文本问答,这种方式已经能够形成接近 ChatGPT 的实时输出效果,因此非常适合作为第一版实现。
Flux 是 Reactor 框架中的核心响应式类型,代表一个可以异步发出 0 到 N 个元素的流。它支持背压机制,允许订阅者控制数据接收速度,避免生产速度过快导致内存溢出。在 Spring AI 的流式接口中,模型输出正是通过 Flux<String> 逐段推送,前端订阅后即可持续接收并实时渲染。
理解 Flux 的关键在于:它描述的是数据随时间到达的过程,而不是一次性返回的完整结果。订阅者通过 subscribe() 开始接收数据,并可以针对每个元素、错误和完成信号分别定义处理逻辑。这种模型天然适合聊天场景——模型生成一段文字就推送一段,用户无需等待全部生成完毕。
真正的问题会在内容复杂以后出现。模型 Provider 返回的 chunk 只是增量数据片段,它并不保证一个 chunk 恰好对应一句话、一行代码或一个完整 Markdown 结构。代码围栏、列表、表格甚至一个单词,都可能被拆分到多个 chunk 中。前端如果把每个 chunk 当作独立文本立即解析,代码高亮、换行和 Markdown 状态就可能出现异常。
因此,流式接口首先需要建立一个基本认识:Flux<String> 表示的是传输过程中的增量数据流,chunk 的边界属于传输过程,而不是业务语义边界。
二、纯文本协议的扩展瓶颈
当聊天接口只负责输出模型正文时,字符串流已经足够。业务能力增加以后,后端还需要传递生成结束、异常信息、Tool 执行结果、引用来源和前端卡片等数据。此时所有内容继续使用 String,就会让前端失去明确的类型判断依据。
一种简单但扩展性较差的方法,是约定 "END"、"[ERROR]" 等特殊字符串。随着事件类型增加,这种方案很快会出现冲突和维护困难。前端既需要判断内容本身,又需要识别协议标记,模型如果恰好生成相同字符串,还可能造成误判。
更稳定的方式,是在应用层建立统一事件结构。例如课程中采用 eventType + eventData 的形式:
/**
* 聊天事件统一封装对象
* 用于在 SSE 流式传输中承载不同类型的业务数据
*/
public class ChatEventVO {
/** 事件类型:1001-模型正文,1002-生成结束,1003-业务结构化数据 */
private Integer eventType;
/** 事件携带的具体数据,可以是文本、对象或任意业务结构 */
private Object eventData;
}
其中可以约定 1001 表示模型正文,1002 表示生成结束,1003 表示业务结构化数据。前端收到事件后,只需要根据 eventType 选择对应处理逻辑,正文与控制信号由此完成分离。
三、SSE 与业务事件协议的分层
SSE 和 JSON 在这里承担的是两个不同层次的职责。SSE 负责维持 HTTP 长连接,并连续向客户端发送事件;JSON 或 Java VO 负责描述每一个事件内部包含什么业务信息。
可以把一次返回理解成两层结构:
// SSE 事件流结构示意
// 每个事件内部都可以序列化为统一的 ChatEventVO
SSE
├── content event // 模型正文事件
├── content event // 模型正文事件
├── business event // 业务数据事件
└── done event // 生成结束事件
其中每一个 Event 内部都可以序列化为统一的 ChatEventVO。模型生成一段文字时创建正文事件,Tool 查询到课程数据时创建业务事件,整个生成过程结束后再增加完成事件。
这种设计使后端输出从“不断发送字符串”转变为“不断发送具有明确语义的事件”。以后增加 tool_start、tool_result、citation、error 等类型时,只需要扩展事件定义,不需要重新设计整个接口。
四、Flux 中的事件组合机制
在 Reactor 中,Flux 可以承载任意对象类型。因此,当模型原始流完成转换后,可以得到:
// 将模型输出的原始文本流转换为统一的事件流
// 每个文本片段都被包装为 eventType=1001(模型正文)的事件对象
Flux<ChatEventVO> contentFlux = modelFlux
.map(text -> ChatEventVO.builder()
.eventType(1001) // 标记为模型正文事件
.eventData(text) // 携带当前文本片段
.build()); // 构建事件对象
ChatEventVO.builder().build() 最终生成的是一个普通 Java 对象,而 Flux.just(event) 只是把这个对象包装成一个仅包含单个元素的 Flux。它和 Flux.just("hello") 的本质完全相同,只是泛型类型不同。
因此,不同阶段产生的事件可以继续按照顺序连接:
// 按顺序拼接多个事件流:
// 1. 先发送模型正文事件流
// 2. 再发送业务卡片事件(如课程信息)
// 3. 最后发送生成结束事件
return contentFlux
.concatWith(Flux.just(cardEvent)) // 追加业务数据事件
.concatWith(Flux.just(doneEvent)); // 追加完成事件
最终的输出顺序就是模型正文、业务数据和结束事件。这里的关键并不在 Flux.just() 这个 API,而在于后端已经把不同来源的数据统一成了同一种事件模型。